Fizgig 9.2, MOSS-Image LoRA 학습을 20분으로 단축
Fizgig 9.2는 PyTorch 2.15와 더 빠른 Muon 스텝으로 전환했습니다. RTX 5090에서 MOSS-Image LoRA가 49분 대신 20분에 학습되고, 메모리는 3분의 1로 줄어듭니다. LoRA는 ComfyUI에서 로드됩니다.
Fizgig 9.2는 11월 8일에 출시되어 모든 학습 실행을 더 빠르고 가볍게 만들었으며, 특히 MOSS-Image에서 두드러집니다. RTX 5090에서 MOSS-Image LoRA(94장, 배치 1, Muon, 70 에포크)는 이제 49분 대신 약 20분에 완료되며, 유사도 점수는 같거나 더 좋게 나왔습니다(릴리스 노트).
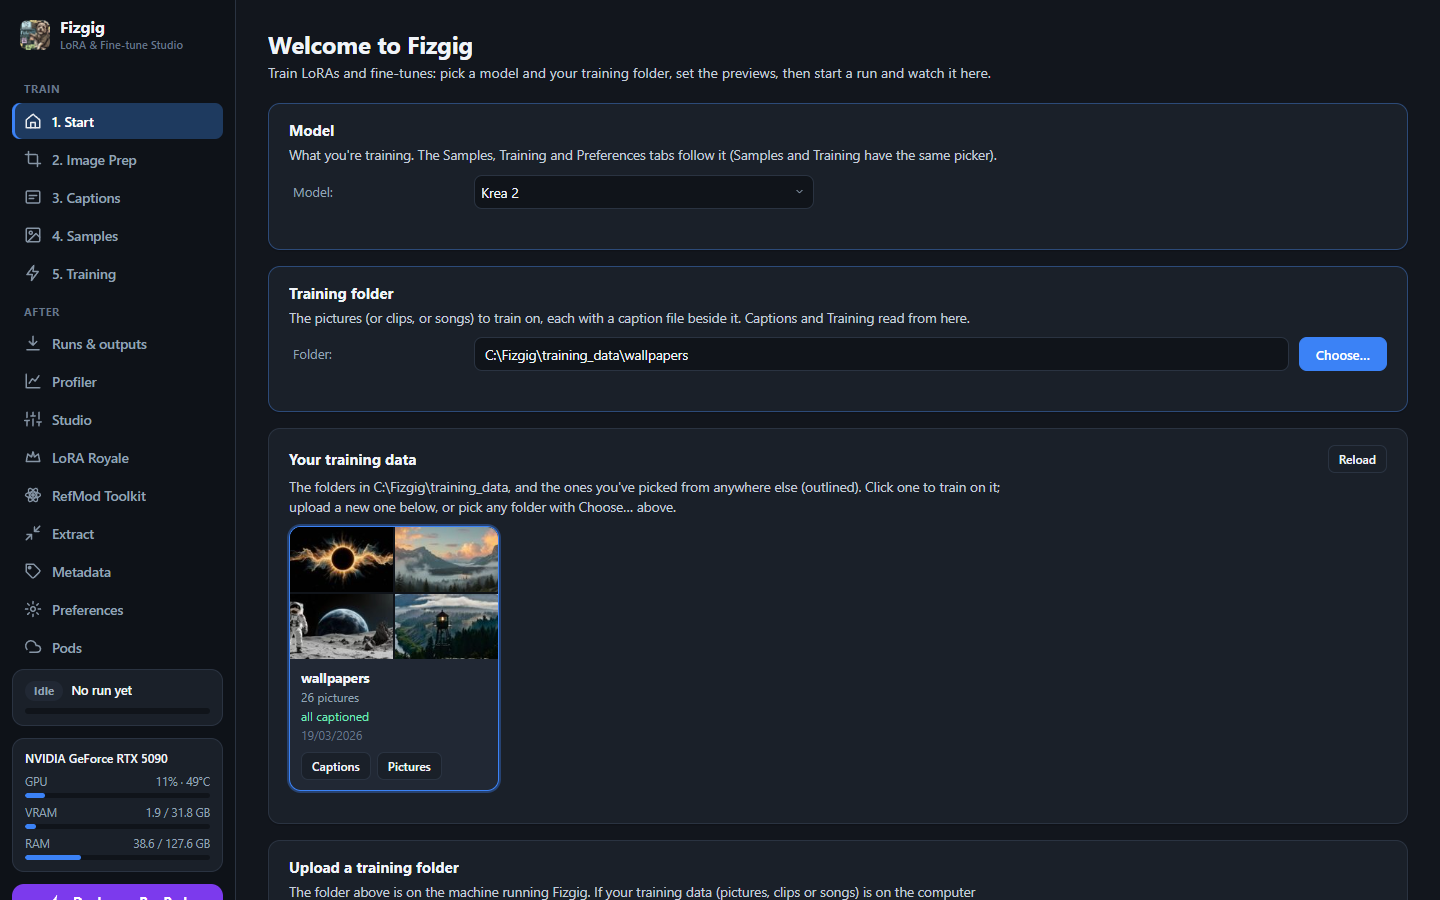
Fizgig의 시작 탭. 트레이너가 독립적으로 실행된 후 ComfyUI/models/loras/에 사용할 kohya 형식 LoRA를 저장합니다.
수치
| RTX 5090에서의 MOSS-Image LoRA | 9.2 이전 | 9.2 |
|---|---|---|
| 94장, 배치 1, Muon, 70 에포크 | 49분 | 약 20분 |
| 메모리, 배치 3, gradient checkpointing | 21.7 GB | 7.1 GB |
배치 3에서 트레이너는 이제 같은 그래픽 카드에서 OneTrainer의 스텝당 1.07초에 필적하면서 메모리는 더 적게 사용합니다(7.4 GB 대신 6.9 GB). 따라서 배치 실행은 타협이 아닌 실용적인 선택지가 되었습니다.
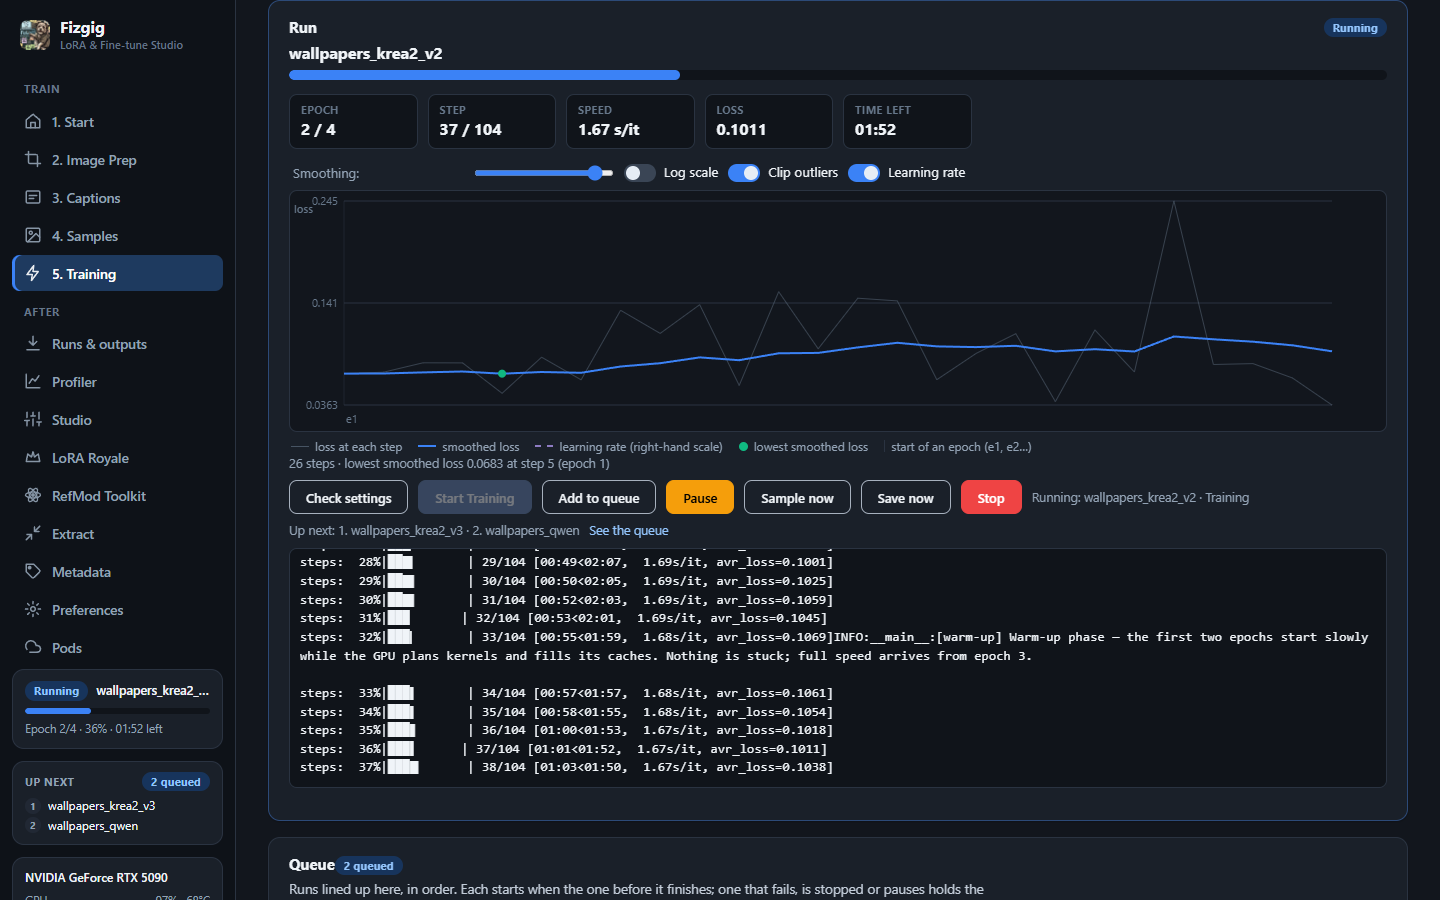
학습 탭에서 실행 중인 모습. 사이드바에 실행 대기열이 표시됩니다.
변경 사항
- PyTorch 2.15. gradient checkpointing을 켜면 메모리가 크게 줄어듭니다. 배치 1에서 Krea 2는 22.9 GB에서 14.9 GB로 감소합니다. 16 GB 노트북 4090에서는 Fibo 2.0이 22% 더 빠르게 학습되고, Klein은 13%, Krea 2는 11% 더 빠릅니다.
- 더 빠른 Muon 스텝. 이제 LoRA의 행렬을 하나씩 처리하지 않고 함께 처리합니다. 12배 빨라졌고 결과는 동일합니다. LoKR 학습은 모든 모델에서 4~6배 빠릅니다.
- 더 빠른 배치. 길이가 다른 캡션이 더 이상 어텐션을 느리게 만들지 않습니다. MOSS-Image에서 스텝이 18% 빨라지고, Krea 2에서 12%, Qwen-Image 2.1에서 9% 빨라집니다.
MOSS-Image Turbo Train
버전 9.2.5에는 실험적인 MOSS-Image Turbo Train 프리셋이 추가되었습니다. Fast 프리셋(rank 16, 0.25 MP, Muon)에 2e-4에서 4e-4 사이로 동작하는 Adaptive LR을 적용하고, 이미지별 추적을 통해 각 사진이 자체적인 속도를 갖습니다. 긴 학습을 시작하기 전에 LoRA가 어떤 결과물이 될 수 있는지 빠르게 확인하는 방법이며, 좋은 데이터셋에서는 충분히 쓸 만합니다.
MOSS-Image용 프리셋도 새로운 Clean-end 공유 설정 30:7:60:8:3으로 이동했습니다. 7 에포크까지는 거의 깨끗한 이미지로 스텝의 30%를 진행하고, 8 에포크부터는 60%를 진행합니다. 저장된 설정에는 이전 스케줄이 유지되므로 프리셋을 다시 로드해야 새로운 스케줄이 적용됩니다.
업데이트
업데이트는 PyTorch 2.15(약 3 GB)를 다운로드하며 Python 3.11 이상이 필요합니다. NVIDIA 드라이버는 CUDA 13을 지원해야 하므로 580 이상 버전이 필요합니다. 업데이트 후 Fizgig가 GPU를 인식하지 못하면 드라이버를 업데이트하세요. AMD에서는 번들 ROCm PyTorch가 변경되지 않으며, 대여한 포드는 재시작 후 새 버전을 적용합니다.
.safetensors 파일입니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.