P-H3-Image, ComfyUI에서 pDMD LoRA로 2스텝 실행
pDMD 2스텝 LoRA로 P-H3-Image를 8 MP에서 8스텝에서 2스텝으로 줄입니다. 파일 하나와 바로 쓸 수 있는 ComfyUI 워크플로만 있으면 되고 커스텀 노드도 필요 없으며, 이미지 한 장당 약 2.9초입니다.
 |  |
|---|---|
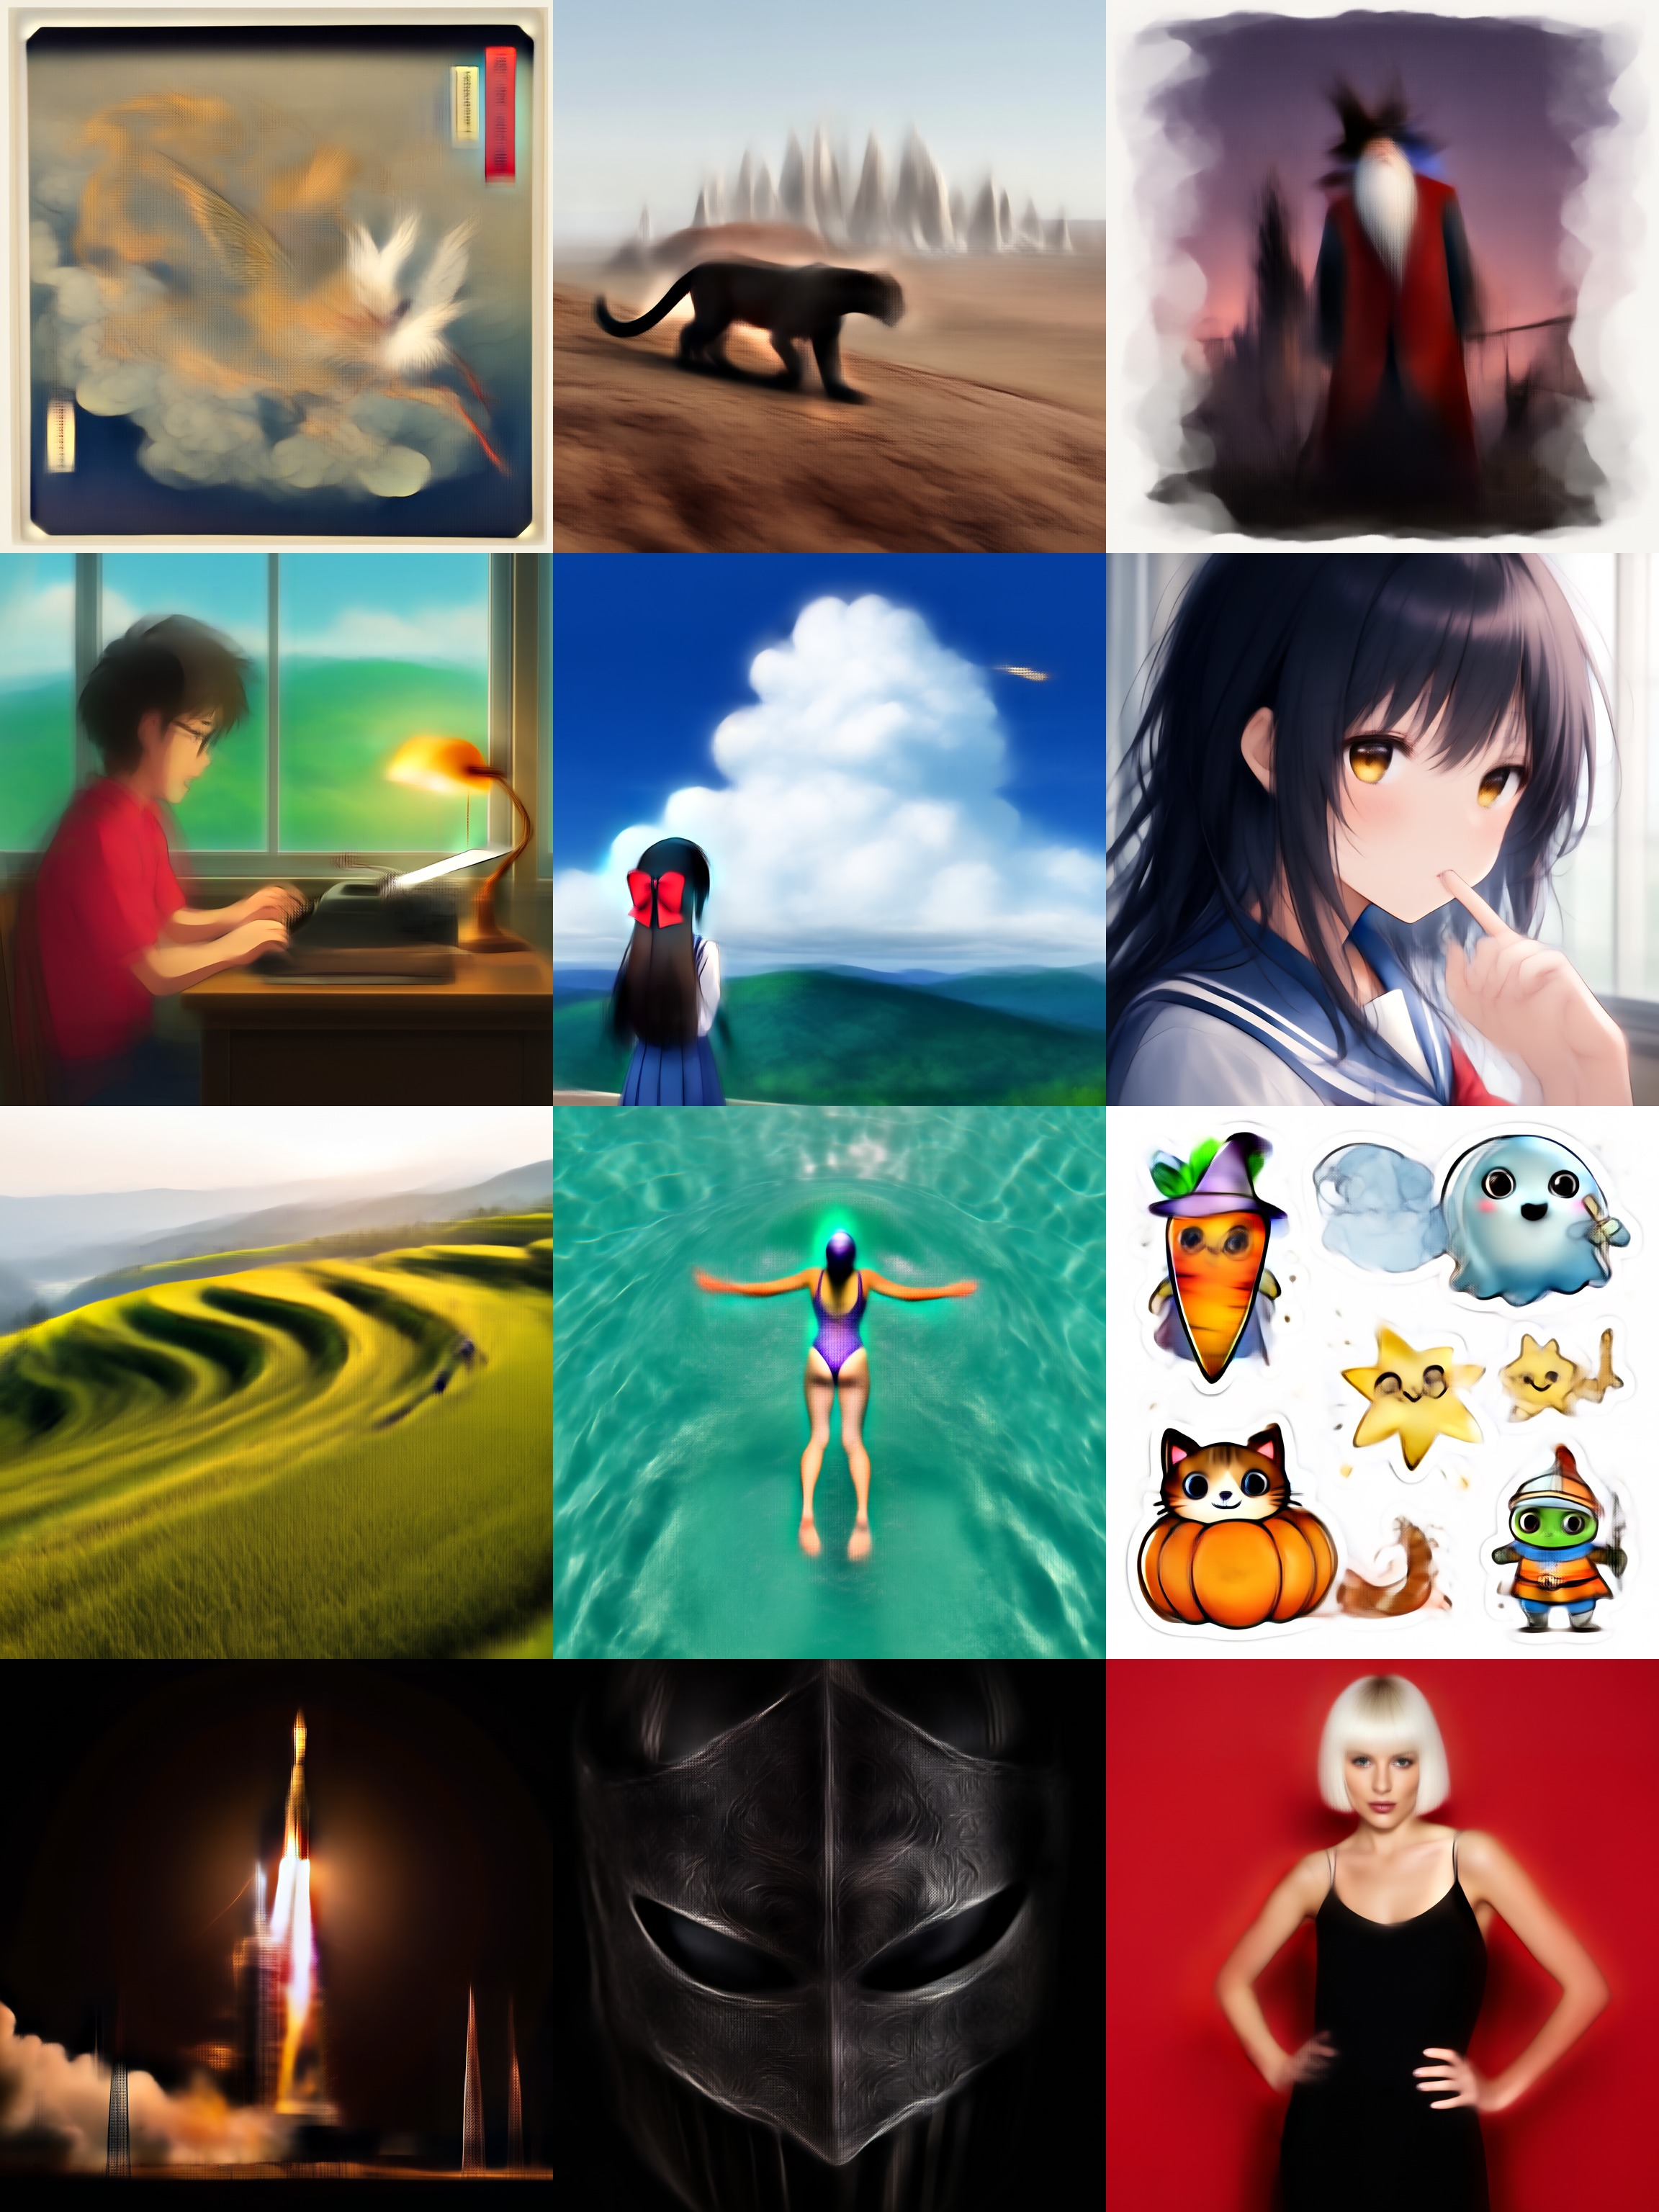
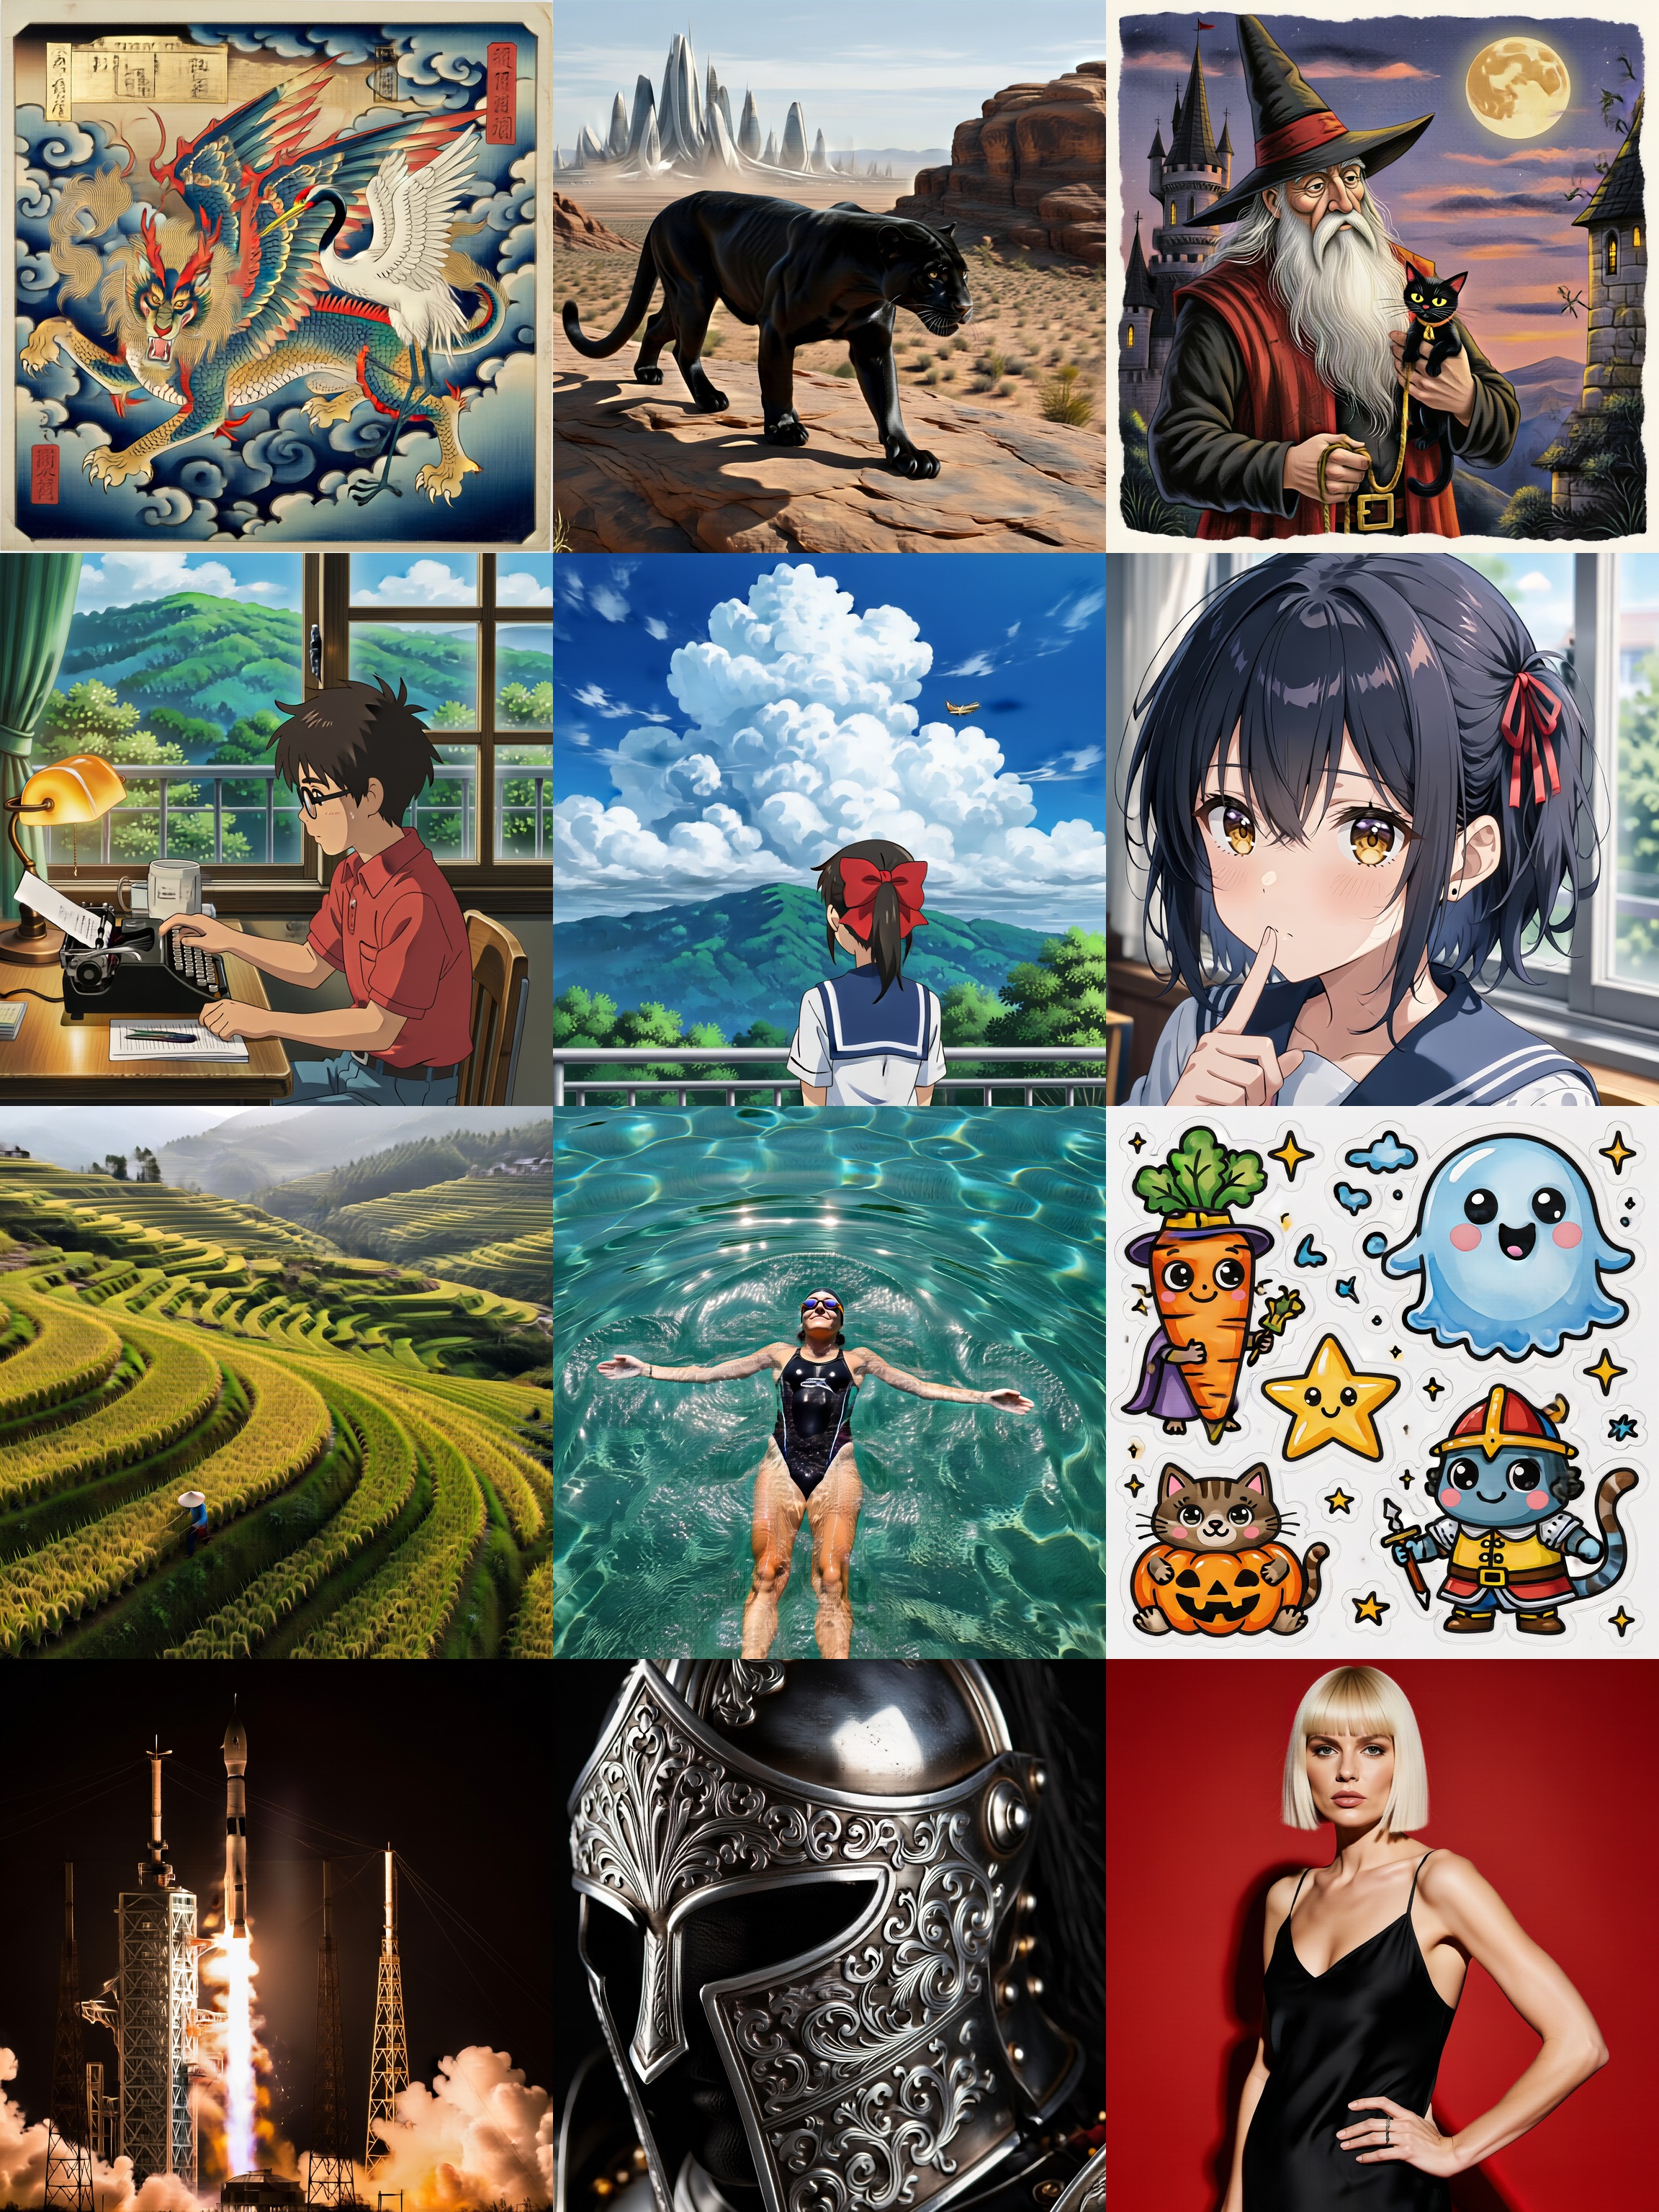
| 기본 모델, 2스텝 | pDMD LoRA 사용, 2스텝 |
프롬프트 12개, 2스텝, shift 12, 시드 3, 작성자 저장소에서 2912 x 2912로 렌더링. LoRA가 없으면 2스텝에서는 모델이 아직 디노이즈 중간 단계에 머뭅니다.
실행 방법
- P-H3-Image-Comfy에 따라 P-H3-Image를 설정하고 ComfyUI를 최신 master로 업데이트하세요.
- LoRA를
ComfyUI/models/loras/로 다운로드하세요:hf download akhaliq/p-h3-image-pdmd-2step minimax_h3_pdmd_2nfe_comfyui.safetensors --local-dir ComfyUI/models/loras - 아래 워크플로를 여세요. 기본 8스텝 그래프에서 바뀌는 점은 두 가지입니다. 확산 모델 로드와 샘플러 사이에 강도 1.0의 LoRA 로드 (실행 건너뛰기, 모델 전용) 를 넣고, 8스텝 ManualSigmas 그리드 대신
simple기반 기본 스케줄러를 2스텝, flow shift 12로 설정합니다.euler, 기본 가이드를 유지하고 CFG는 사용하지 않습니다.
2, 3, 4스텝에서 텍스트 기반 이미지 생성과 단일 이미지 편집을 위한 브라우저 데모도 있습니다.
2, 3, 4스텝
| 스텝 | 결과 |
|---|---|
| 2 | 사용 가능: 선명하고 일관성 있지만 8스텝 베이스라인과 구성이 달라지고, 그래픽 프롬프트에서는 가짜 텍스트를 만들어낼 수 있음 |
| 3 | 안전한 중간 설정 |
| 4 | 베이스라인에 가장 가까우며, 인용 텍스트와 평면 그래픽에 적합 |
이 LoRA는 pDMD 2-NFE 어댑터입니다(동일한 312개 모듈에 rank 128, alpha 128, bf16, 업스트림 릴리스에서 수정 없이 가져옴). H3 비디오 모델용으로 증류되었으며, 여기서는 대신 P-H3-Image의 이미지 트랜스포머에 병합됩니다.
선택적 디테일 패스
위에 Regenerate-2K 리파이너를 얹으면 실제 디테일이 더해집니다. 2 MP 초안을 2스텝으로 렌더링하고, 2배 업스케일한 뒤, 리파이너 LoRA와 sigma 0.7로 Euler 3스텝을 돌려 8 MP에서 재생성합니다. 작성자 측정 기준으로 전체 이미지 한 장당 약 7초이며, 순수 8스텝 베이스라인보다 약 1.7배 빠릅니다. 인물 사진에는 0.5를 사용하세요. 얼굴은 더 잘 유지되지만 디테일은 줄어듭니다.
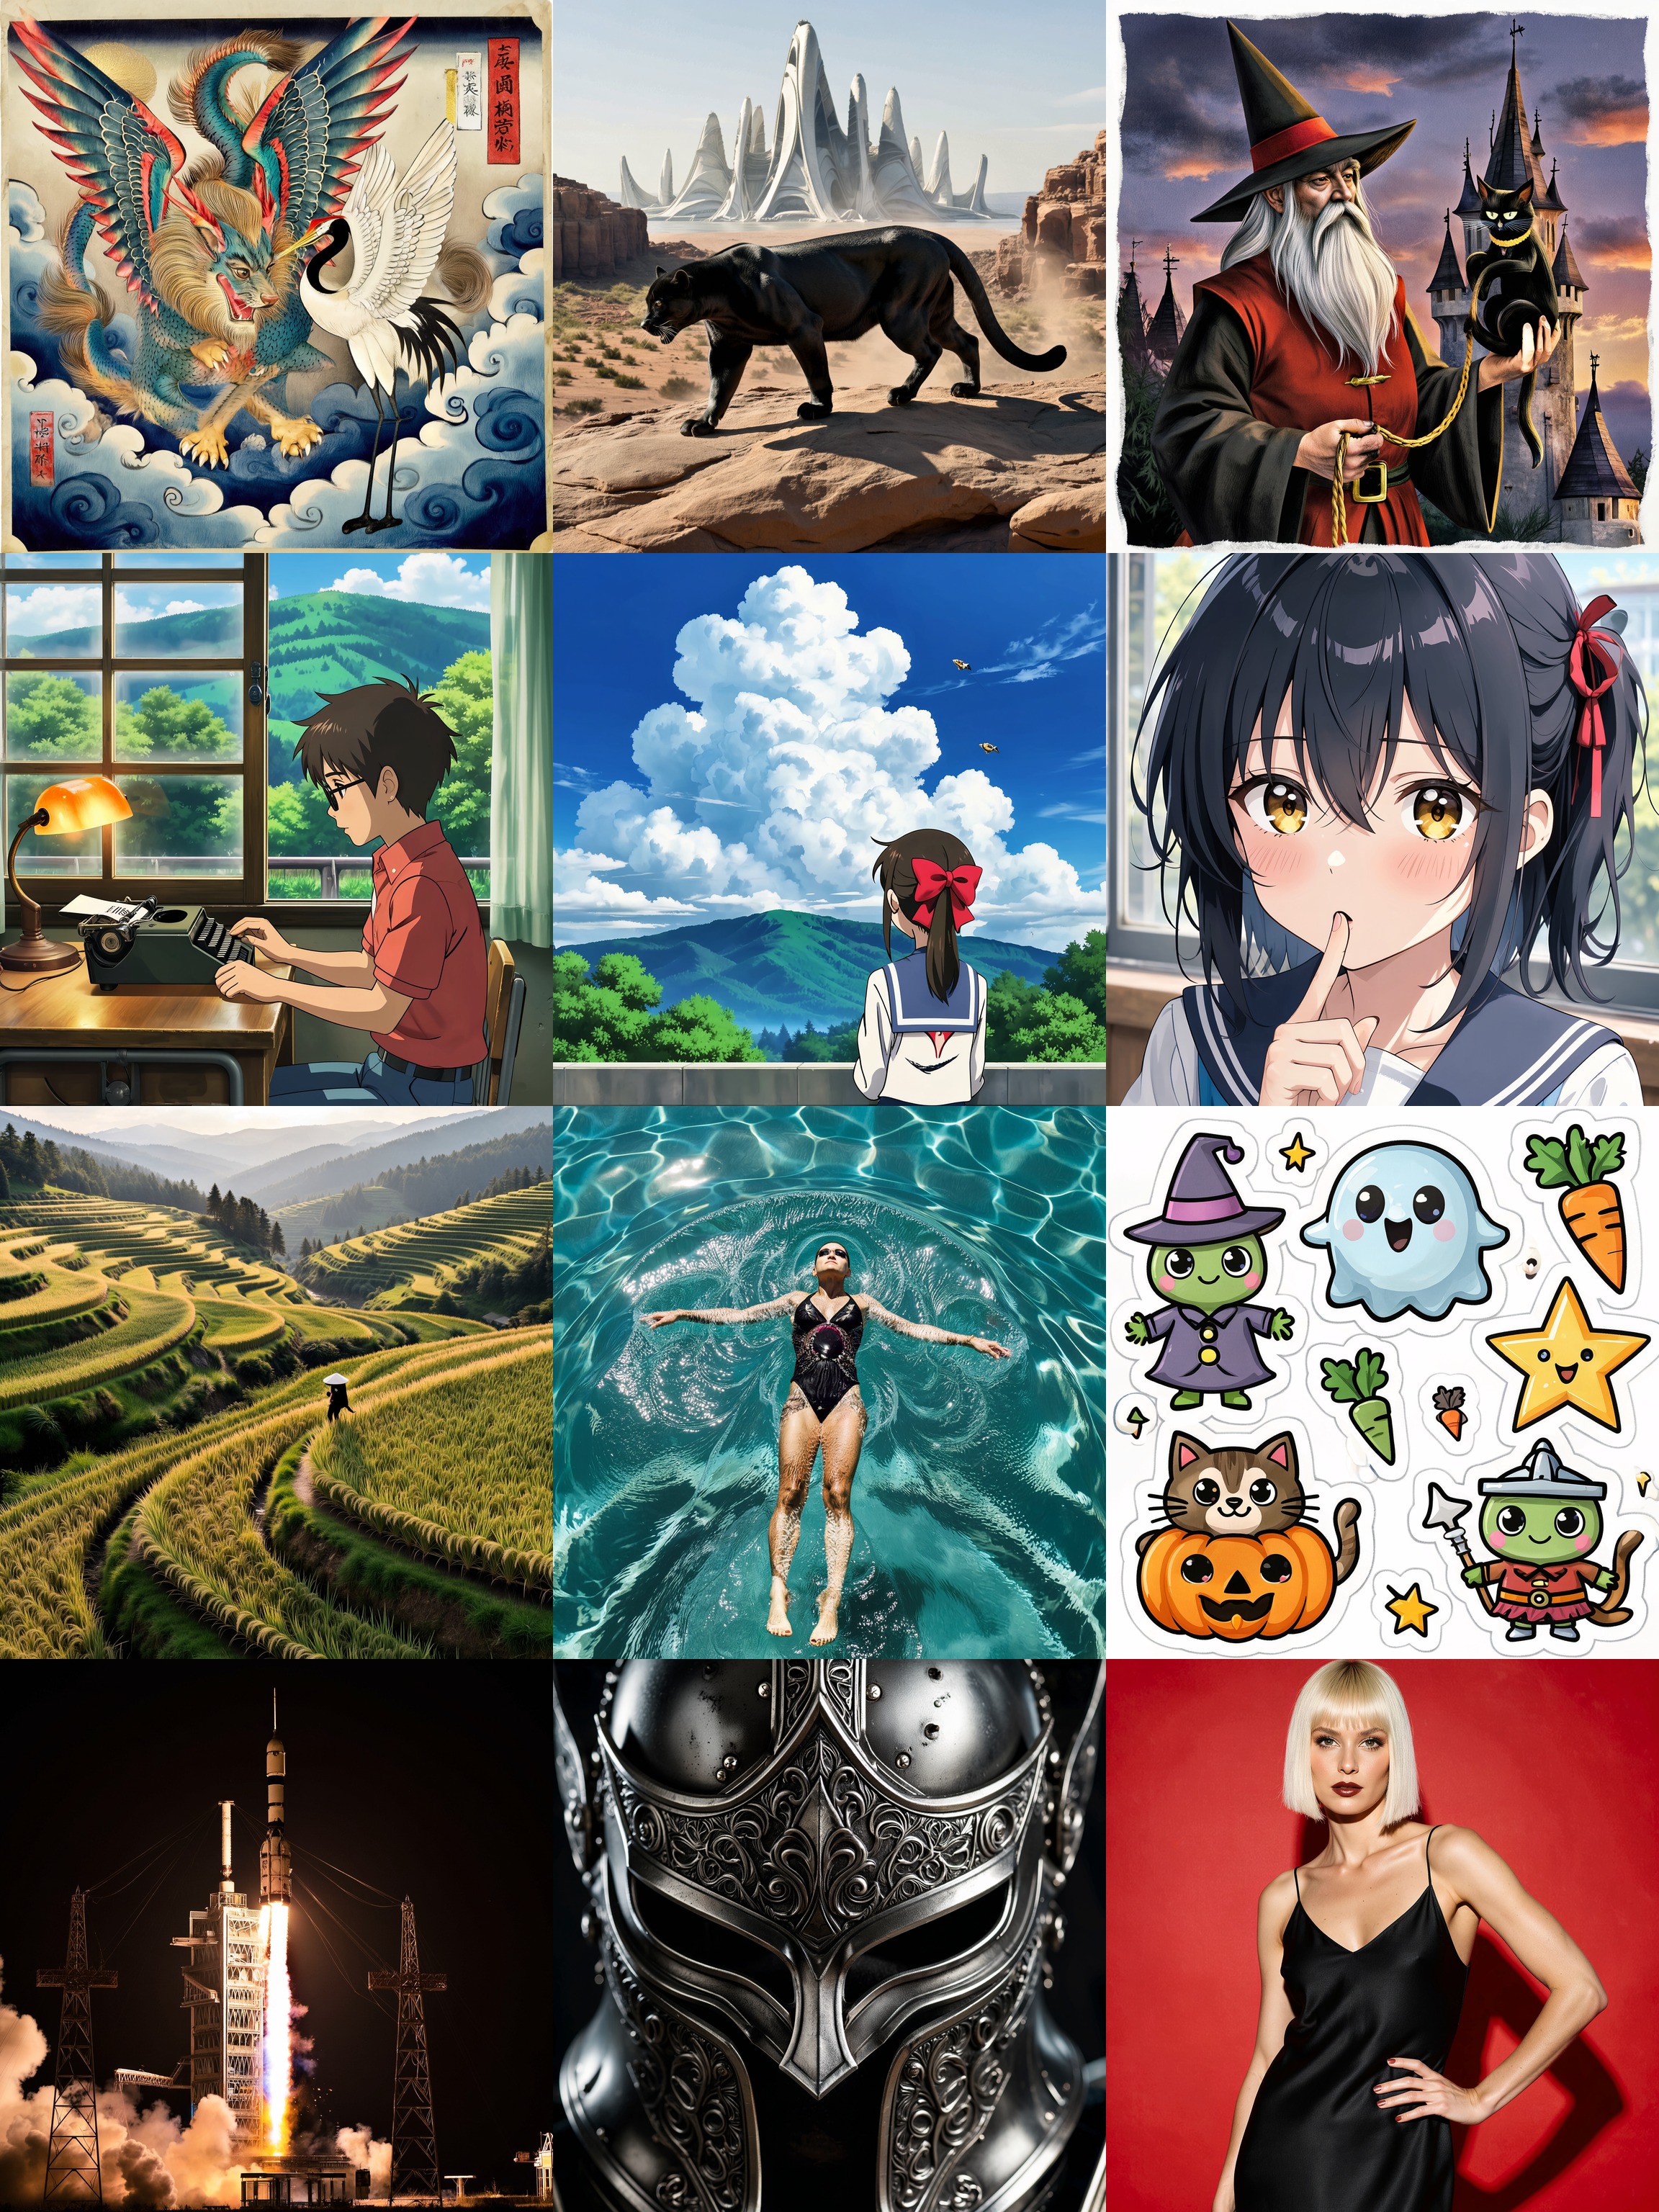
2스텝 초안에 sigma 0.7로 Regenerate-2K 패스를 적용한 결과, 동일한 프롬프트 12개.
VRAM 사용량은 변하지 않습니다. LoRA는 로드 시 병합되므로 bf16 세트는 프롬프트 업샘플러 없이 약 83 GB, ComfyUI의 컴포넌트 오프로드를 사용하면 약 76 GB가 필요합니다.
제공 항목
- LoRA, 워크플로, 비교 그리드: akhaliq/p-h3-image-pdmd-2step
- 데모 Space: akhaliq/p-h3-image-2step
- 베이스 모델: PrunaAI/P-H3-Image, ComfyUI 파일은 P-H3-Image-Comfy 참고
- 방법 및 논문: PDMD, arXiv 2609.35768
댓글
GitHub로 로그인하고 토론에 참여하세요.