Viggle Remake: 두 개의 H3 LoRA로 모든 영상을 재촬영하는 ComfyUI 워크플로
Viggle Remake는 기존 영상을 재캐스팅하거나 편집하기 위한 오픈 MiniMax H3 LoRA 쌍입니다. 1~4개의 프레임을 칠하고 사운드트랙은 유지하며, ComfyUI에서 12GB 환경까지 실행할 수 있습니다.
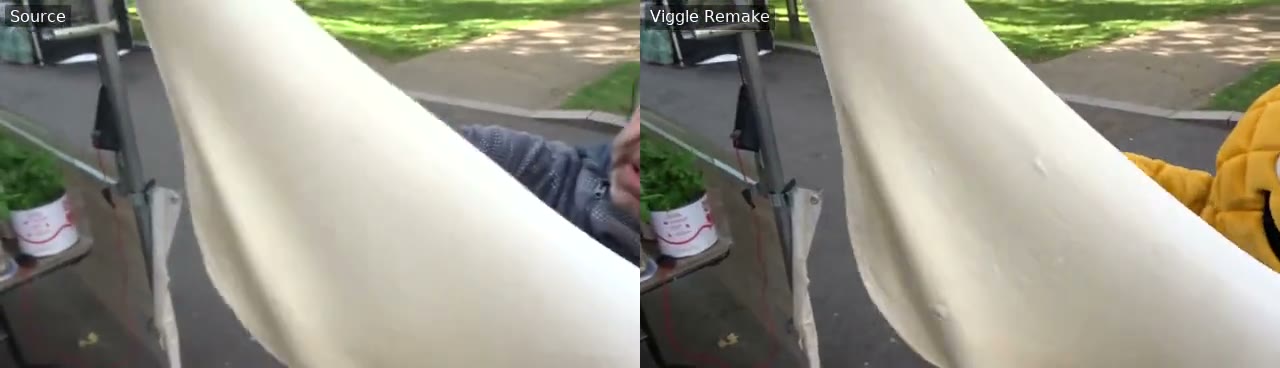
왼쪽: 원본 클립. 오른쪽: 파인애플 마스코트만 재캐스팅되고 모션과 카메라, 타이밍은 그대로인 같은 숏.
Viggle은 8월 말 Viggle-Animate 이후 이 방향으로 개발을 이어왔습니다. 당시에는 고도로 증류된 H3 ref2va 파인튜닝 위에서 다시 칠한 프레임 하나로 숏 속 캐릭터를 교체했습니다. Remake는 모델 카드에서 그때 예고한 "Viggle-Animate v2"라고 부르는 것으로, 두 가지 점에서 달라졌습니다. 파인튜닝이 아니라 기본 H3 트랜스포머 위에 올린 LoRA이고, 사람 외의 요소까지 편집합니다.
두 가지 모드
두 모드 모두 소스 클립과 1~4개의 참조 이미지를 입력으로 받으며, 프롬프트에서는 <Picture 1>부터 <Picture 4>로 지칭합니다. 참조 이미지는 클립에서 뽑은 프레임 위에 직접 칠하거나 처음부터 그리면 되고, 각 이미지는 자신을 그린 소스 프레임에 고정할 수 있습니다.
- **
swap**은 사람과 캐릭터를 교체하며, 한 명 또는 여러 명을 동시에 처리합니다. - **
edit**은 나머지 전부를 담당합니다. 객체 교체, 제거, 삽입, 배경·날씨·조명 변경 등입니다.
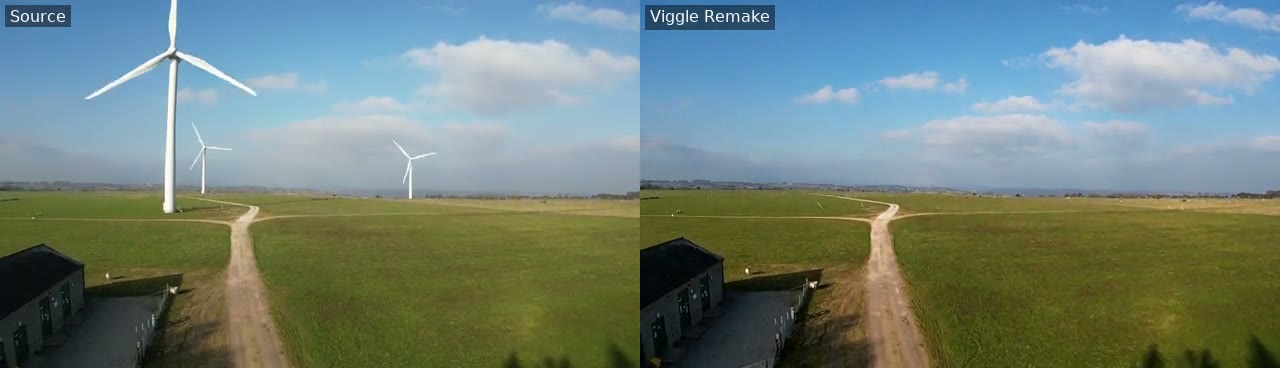
카메라 무빙과 나머지 플레이트는 그대로 둔 채 숏에서 객체를 제거하는 edit LoRA.
정체성은 얼굴 인코더나 세그멘테이션 마스크가 아니라 칠한 프레임에서 나옵니다. 그래서 이 파이프라인에는 포즈 추정이나 트래킹이 필요 없고, 동시에 모델 카드가 동의 여부를 확인할 수 없다고 분명히 밝히는 이유이기도 합니다. 정체성이 결정되는 유일한 지점은 여러분이 그리는 그림이기 때문입니다.
기술적으로 무엇인가
각 모드는 H3의 FL2VA 트랜스포머 302개 선형 레이어에 적용된 rank 256, alpha 256의 PEFT LoRA이며, bf16으로 저장되고 네 개의 proj_in / proj_out 텐서는 fp32입니다. 베이스 모델의 다른 부분은 전혀 바뀌지 않으며, LoRA는 로드 시점에 적용되는 델타일 뿐입니다. 저장소에는 같은 가중치를 ComfyUI 레이어 이름으로 다시 패킹한 파일, int8 및 GGUF로 병합한 트랜스포머, inference/sample.py의 참조 샘플러도 함께 제공됩니다.
사운드는 생성되는 것이 아니라 그대로 전달됩니다. 출력은 소스 클립의 사운드트랙을 유지하므로 무음 소스는 무음 결과를 낳고, 오디오 인코딩은 끝부분에 패딩이 들어갑니다. ComfyUI의 기본 오디오 인코딩이 트랙을 양 끝에서 800샘플 블록 단위로 잘라내기 때문에 영상 대비 최대 400샘플까지 어긋날 수 있기 때문입니다.
ComfyUI 경로
ComfyUI는 H3를 네이티브로 실행하므로, 노드 팩은 기본 노드와 다르게 동작해야 하는 네 가지 부분만 담당합니다. ComfyUI 0.42.0에서 테스트된 세 개의 노드를 추가합니다.
- Viggle Remake Conditioning: 소스 프레임, 오디오, 최대 네 개의 참조, 핀 프레임, 프롬프트를 입력으로 받습니다.
- Viggle Remake Keyframe Until: 고정된 참조를 샘플링 범위의 지정된 비율까지 키프레임으로 변환합니다.
- Viggle Remake Noise: 시드에 대한 참조 샘플러의 시작 노이즈를 재현합니다.
그래프의 나머지는 기본 노드로 구성됩니다. LoraLoaderBypassModelOnly, BasicGuider, euler를 쓰는 KSamplerSelect, ManualSigmas, SamplerCustomAdvanced, 두 번의 VAE 디코드, 24 fps의 Create Video입니다.
속도가 아니라 출력을 바꾸는 설정이 하나 있어 다시 강조할 만합니다. 일반 LoraLoaderModelOnly는 LoRA를 bf16 가중치에 병합하는데, bf16에서는 업데이트의 상당 부분이 반올림으로 사라집니다. 프로젝트 측정에 따르면 어텐션과 MLP 레이어에서 업데이트의 3773퍼센트만 살아남고, swap 예제의 병합 렌더는 선명도가 7퍼센트 떨어집니다(24.7 dB 대비 21.2 dB). 3퍼센트 더 걸립니다.LoraLoaderBypassModelOnly는 LoRA를 별도 분기로 유지하며, 렌더당 시간이 2
| swap | edit | |
|---|---|---|
| LoRA | viggle_remake_swap_comfyui.safetensors | viggle_remake_edit_comfyui.safetensors |
| ManualSigmas | 1.0, 0.990476, 0.965243, 0.923077, 0.8, 0.631579, 0.0 | 1.0, 0.983607, 0.96, 0.923077, 0.857143, 0.705882, 0.0 |
더 작은 GPU: int8과 GGUF
bf16 경로는 80GB 카드 한 장과 약 144GB의 베이스 모델을 요구합니다. 그보다 작은 환경에서는 각 모드가 LoRA를 fp32로 병합한 뒤 양자화한 단일 트랜스포머 파일로 제공되며, 그래프에서 베이스 확산 모델과 LoRA 로더를 모두 대체합니다.
| 파일 | 크기 | 로더 |
|---|---|---|
int8/viggle_remake_{swap,edit}_pruned_int8_convrot.safetensors | 21.0 GB | Load Diffusion Model (core) |
gguf/*-Q8_0.gguf | 22.3 GB | Unet Loader (GGUF) |
gguf/*-Q6_K.gguf | 17.6 GB | Unet Loader (GGUF) |
gguf/*-Q4_K_M.gguf | 14.3 GB | Unet Loader (GGUF) |
프로젝트의 GPU 표는 226프레임, 고정 참조 2개로 edit 예제를 측정한 결과입니다.
- 12GB:
--reserve-vram 8과 함께 Q4_K_M 또는 Q8_0. int8은 124프레임까지만 실행됩니다. - 16GB: 832x480에서 int8.
--reserve-vram 6과 함께 Q4_K_M 또는 Q6_K. 1280x736에서는--reserve-vram 10과 124프레임으로 Q4_K_M. - 24GB: 832x480에서 int8 또는 Q4_K_M. 1280x736에서는
--reserve-vram 20과 함께 Q4_K_M 또는 Q8_0. - 32~80GB: 832x480에서는 int8 또는 Q8_0를 여유 있게. 1280x736에서는 int8 파일이 48GB 및 80GB 카드에서 226프레임 시 메모리가 부족해지며, Q8_0는 예약 메모리를 두면 24GB에서도 들어갑니다.
bf16 + LoRA 기준 대비 품질을 모든 프레임의 PSNR로 측정하면 다음과 같습니다. int8은 swap 27.2 dB, edit 46.8 dB이고 Q8_0은 26.9와 49.8, Q6_K는 24.6과 44.6, Q4_K_M은 20.6과 38.3입니다. swap 열은 편차가 큽니다. 동일한 bf16 가중치를 조금 다르게 한 번 더 반올림하는 것만으로도 해당 렌더가 29.6 dB로 이동하므로, 여기서의 몇 dB 차이는 포맷 순위가 아닙니다.
속도
B200 한 장, 832x480, 226프레임, 고정 참조 2개 조건에서 모델 로딩이 끝난 뒤 ComfyUI는 렌더당 약 95초가 걸리며, 6스텝 기준 스텝당 약 13.5초로 sample.py의 약 58초와 대비됩니다. 로딩을 포함한 첫 렌더는 2.53분 걸립니다. 1280x736에서는 스텝당 6472초, 렌더당 510~585초입니다. 프로젝트는 B200만 측정했다고 명시하고 있으며, 소비자용 카드는 더 느릴 것입니다.
한계
- 한 번의 렌더는 90~345프레임(
17n+5, 24 fps) 윈도를 처리합니다. 프로젝트는 약 12초 분량인 294프레임까지를 권장하며, 더 긴 영상은 MCP 서버가 숏 경계에서 잘라 만든 윈도들로 처리됩니다. - 6개 섹션으로 구성된 H3 프롬프트가 필수이며, 타임스탬프가 프레임 수와 일치해야 합니다.
- 칠한 프레임이 정체성과 외형을 결정하며, 고정된 프레임은 해당 프레임의 구도까지 고정합니다.
- 알려진 실패 사례: 긴 원테이크에 등장하는 비인간형 캐릭터, 미세 디테일의 작은 아티팩트, 핀 없이 멀티 숏 클립을 렌더할 때 시간축이 밀리는 숏.
ComfyUI 워크플로에 포함된 swap 예제: 226프레임, 12번과 184번 프레임에 고정된 참조 2개.
edit 예제: 팬과 조명은 그대로인 채 터빈만 플레이트에서 사라집니다.
배포 및 이용
가중치, LoRA, int8 및 GGUF 파일, 노드 팩, 워크플로는 Hugging Face에 있으며 COMFYUI.md, PROMPTING.md, MODIFICATIONS.md도 함께 제공됩니다. 저장소 전체는 약 210GB이므로 ComfyUI 가이드는 comfyui/와 examples/inputs/ 하위 집합만 다운로드합니다. 2026년 11월 4일에 공개되어 같은 날 @viggleai가 발표했으며, 모델 카드에는 다른 편집 모델과의 벤치마크가 없으므로 위 수치는 모두 프로젝트 자체 측정값입니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.