P-H3-Image: ComfyUI에서 MiniMax H3 이미지 생성 지원
PrunaAI의 P-H3-Image는 CFG 없이 8스텝으로 8 MP 이미지를 렌더링하며, 최대 8개의 참조 이미지로 편집합니다. ComfyUI는 출시 당일 네이티브 지원을 추가했습니다.
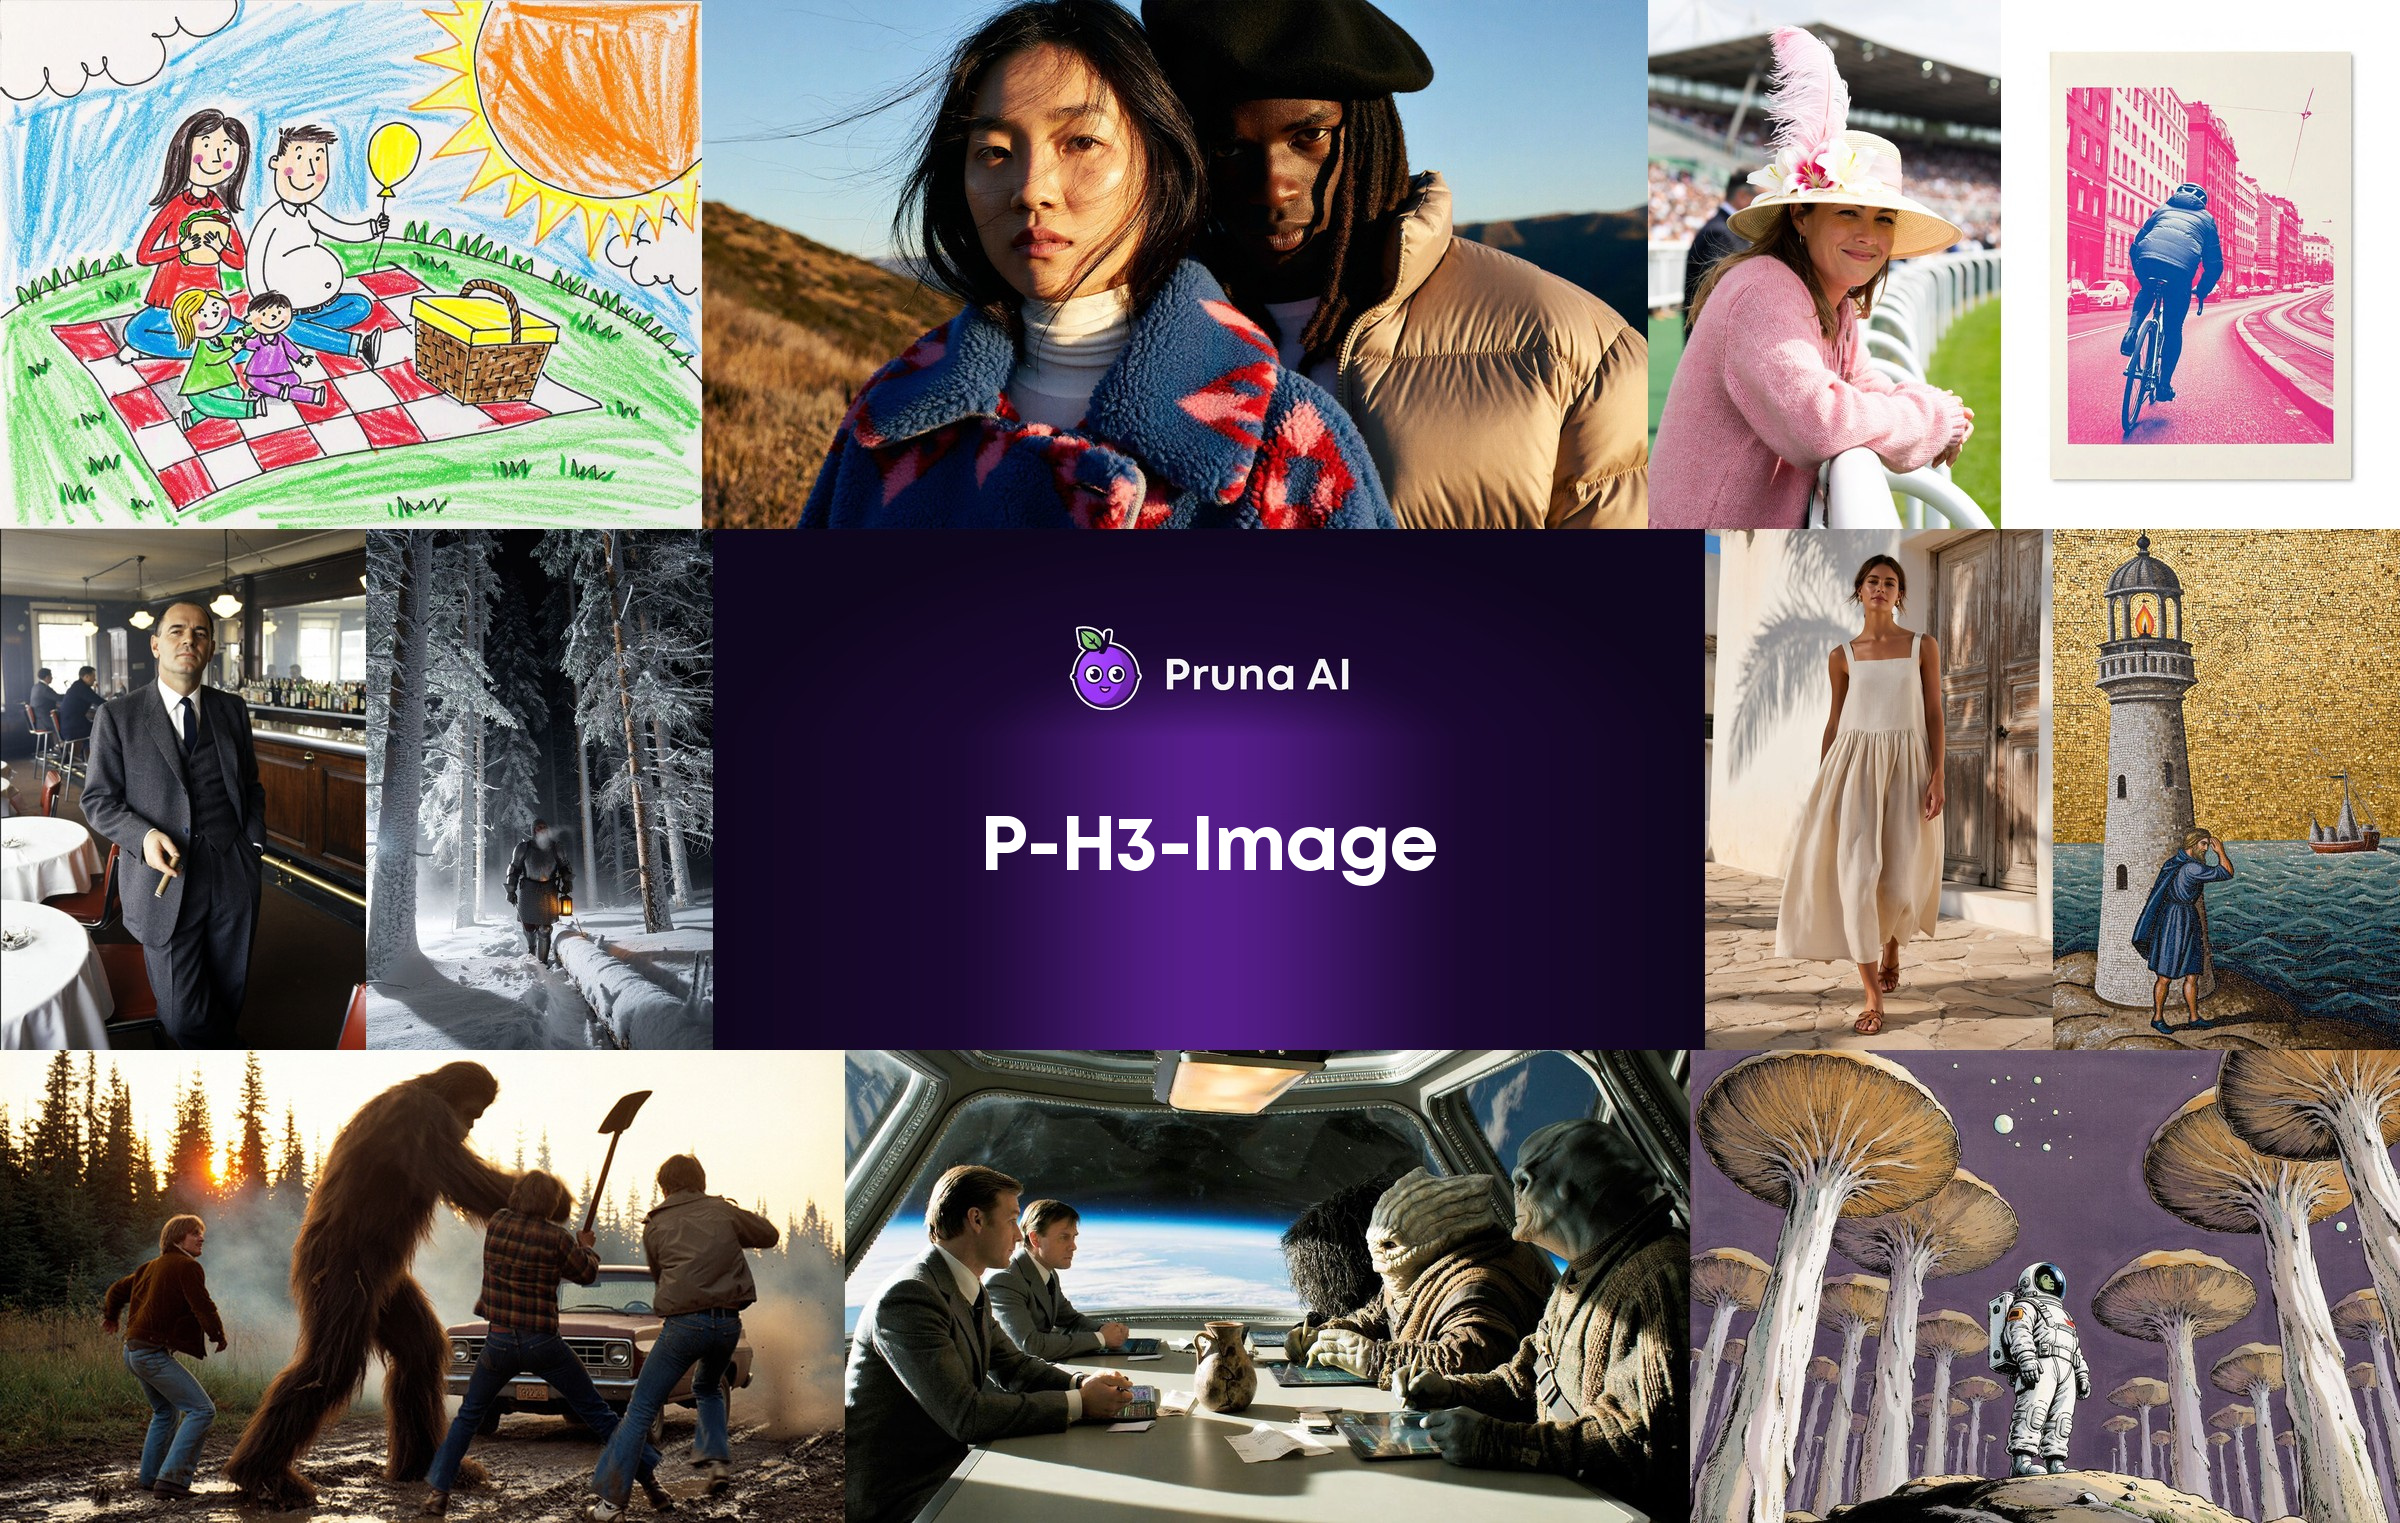
공식 모델 카드의 샘플입니다. 모델 카드는 P-H3-Image를 포토리얼리즘, 필름 및 에디토리얼 룩, 짧은 인용 텍스트가 들어간 그래픽 스타일에 적합한 모델로 소개합니다.
이 모델은 무엇인가
이번 릴리스는 4B 텍스트 인코더, VAE, 별도의 프롬프트 업샘플러를 갖춘 33.1B 파라미터 트랜스포머이며, bf16 기준 100 GB입니다. 새로운 아키텍처가 아니라 MiniMax H3의 파인튜닝이므로 H3의 VAE와 어텐션 스택을 그대로 물려받고, 학습 예산은 비디오 대신 정지 이미지에 사용했습니다.
| 작업 | 텍스트 기반 이미지 생성, 1~8개의 입력 이미지로 편집 |
| 샘플링 | 8스텝, CFG 또는 네거티브 프롬프트 없음 |
| 해상도 | 텍스트 기반 이미지 생성 8 MP, 편집 4 또는 8 MP |
| 프롬프트 업샘플러 | 포함됨, 기본 활성화, Qwen3.5-9B 기반 |
| 가중치 | 33.1B 트랜스포머, 4B 텍스트 인코더, VAE, 프롬프트 업샘플러 |
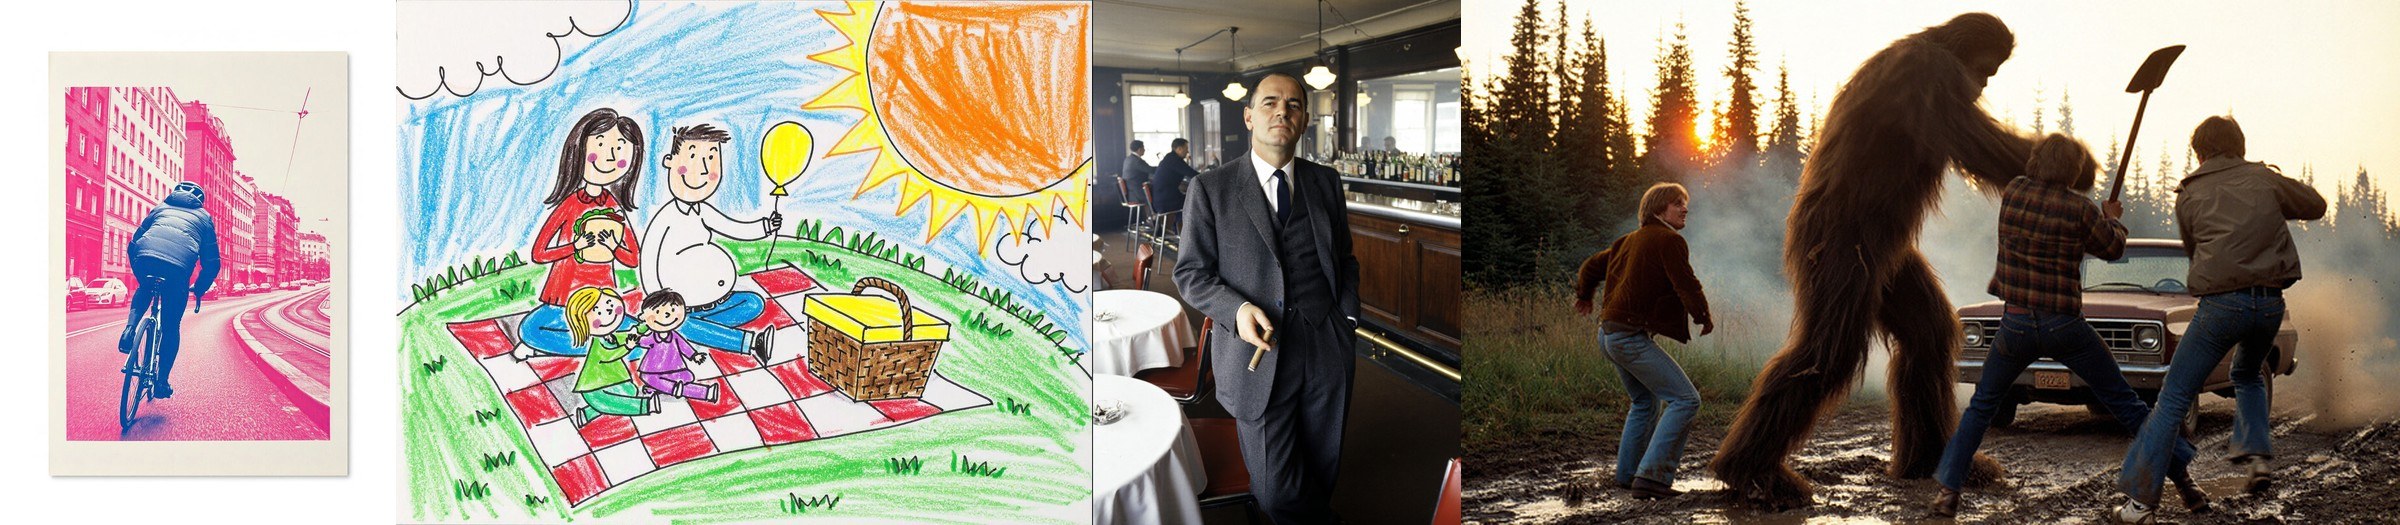
8 MP로 렌더링한 모델 카드의 스타일 커버리지입니다.
출시 당일 네이티브 ComfyUI 지원
ComfyUI는 2026-11-03에 PR 17506(CORE-697)에서 PH3Image 지원을 병합했으며, 이는 PrunaAI가 가중치에 update-for-launch 리비전을 푸시한 바로 그날입니다. Comfy-Org/workflow_templates의 두 공식 템플릿 모두 minComfyUIVersion: 0.44.0을 지정하고 있어, 그보다 오래된 릴리스에서는 템플릿을 열 수 없습니다.
그래프는 내장 노드만 사용합니다. 확산 모델 로드가 체크포인트를 불러오고, MiniMax H3 Sigma Shift는 두 shift 모두 1.0으로 실행되며, 타입 minimax의 CLIP 로드가 텍스트 인코더를 불러오고, 새로운 p-h3-image 조건화 노드가 프롬프트와 이미지를 조건화 및 이미지 latent로 변환합니다. 샘플링은 8스텝 그리드의 ManualSigmas를 기본 가이드와 euler를 사용하는 샘플러 커스텀 고급으로 연결하며, CFG와 네거티브 프롬프트는 없습니다. 선택적 LoRA는 LoRA 로드 (모델 전용) 로 불러옵니다.
어떤 파일을 다운로드해야 하나
PrunaAI/P-H3-Image-Comfy는 ComfyUI의 네이티브 형식으로 가중치를 미러링하며, 각 구성 요소를 하나의 행에서 가져오기만 하면 정밀도를 자유롭게 조합할 수 있습니다. MiniMax H3 자체는 143 GB의 가중치이며, 가장 작은 P-H3-Image 세트는 20 GB 다운로드에 8 MP에서 최대 21 GB VRAM을 사용합니다.
| 구성 요소 | 폴더 | bf16 | int8 | w4a8 |
|---|---|---|---|---|
| 확산 모델 | diffusion_models/ | 40.5 GB | 21.2 GB | 13.4 GB |
| 텍스트 인코더 | text_encoders/ | 9.1 GB | 5.1 GB | 3.6 GB |
| 프롬프트 업샘플러 | text_encoders/ | 19.3 GB | 9.7 GB | 6.7 GB |
| VAE | vae/ | 5.6 GB | 3.1 GB | 없음 |
| 세트 | 다운로드 | 8 MP에서 최대 VRAM |
|---|---|---|
| bf16 | 55 GB | 56 GB |
| int8 | 30 GB | 31 GB |
| w4a8 + int8 VAE | 20 GB | 21 GB |
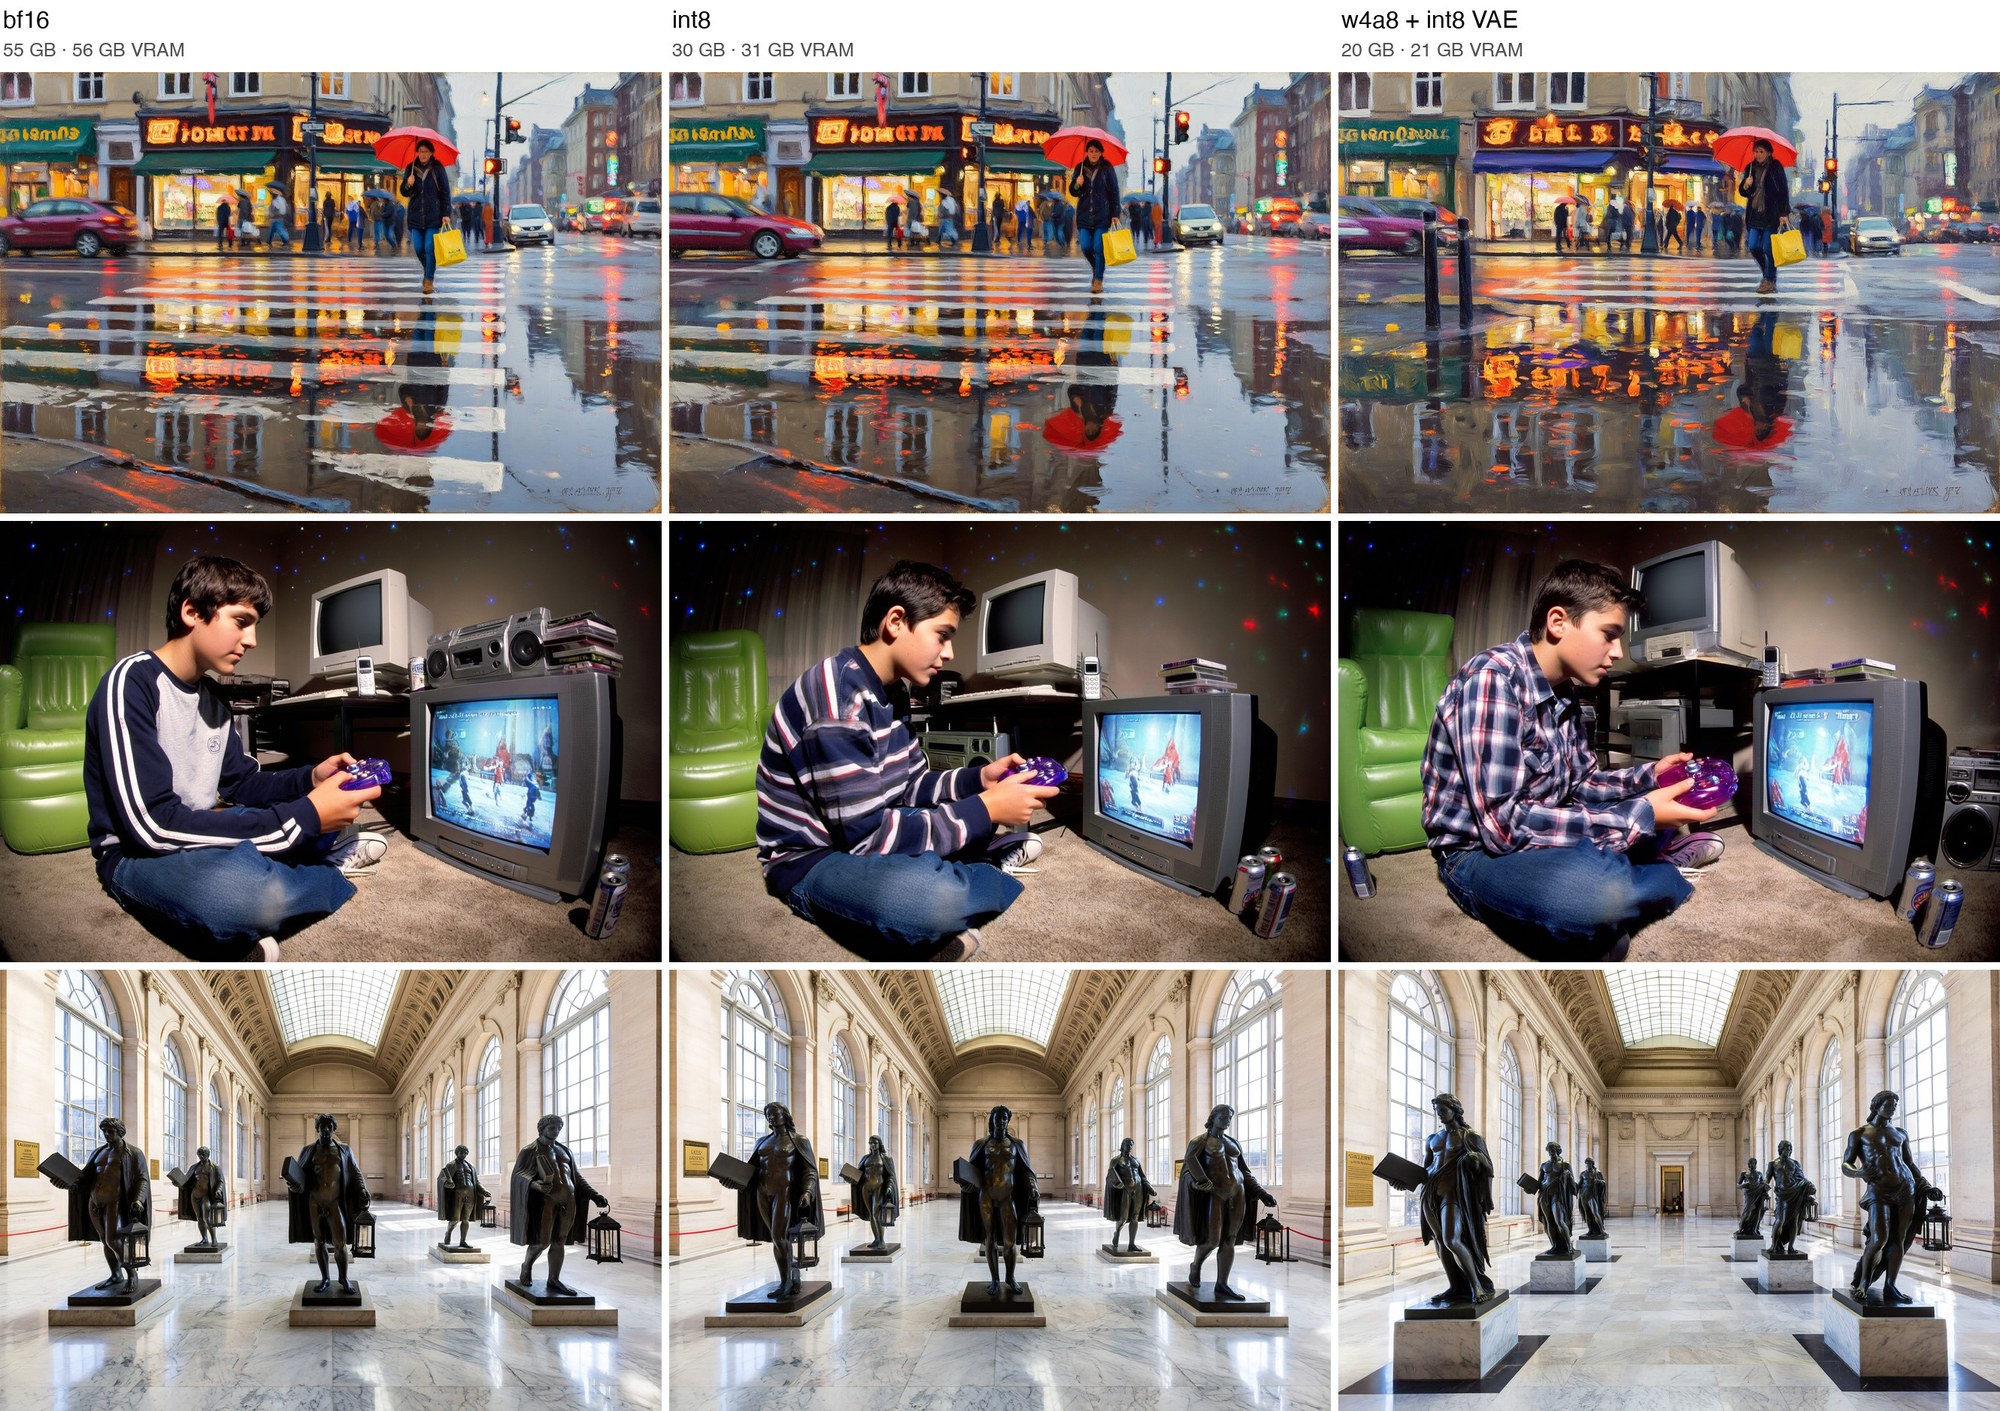
8 MP에서 동일한 프롬프트와 시드로 만든 bf16, int8, w4a8 결과이며, 각 헤더에 다운로드 크기와 최대 VRAM이 표시됩니다.
int8 파일은 bf16에 매우 가깝고, 흔히 거의 픽셀 단위로 일치합니다. w4a8은 품질을 유지하지만 세부 정보가 더 많이 움직이고 때로는 구도까지 달라집니다. 둘 다 ComfyUI 자체 양자화 형식입니다. int8은 이상치에 대해 그룹화된 Hadamard 회전을 적용하고 행별 스케일을 저장하며 활성화는 즉석에서 양자화하고, w4a8은 4비트 가중치를 16단계 코드북에 올리고 입력 16개당 FP8 스케일을 사용하며 민감한 레이어는 int8로 유지합니다. 둘 다 캘리브레이션 데이터가 필요 없고, 모두 NVIDIA Ampere 이상 및 AMD RDNA3/4용 comfy-kitchen의 INT8 커널에서 실행됩니다.
loras/에는 2.0 GB LoRA도 있어, 전체 체크포인트 대신 자신의 MiniMax H3 가중치에 같은 동작을 적용할 수 있습니다. 저장소의 워크플로 네 개 중 두 개가 이 LoRA를 중심으로 구성되어 있습니다.
프롬프트 업샘플러는 모델의 일부입니다
P-H3-Image는 짧은 요청보다 길고 구체적인 프롬프트를 훨씬 잘 렌더링하므로, 모든 예제 워크플로가 먼저 업샘플러를 실행합니다. ComfyUI에서 이것 역시 커스텀 노드가 아닙니다. 타입 minimax의 CLIP 로드와 그리디 디코딩을 사용하는 텍스트 생성으로 구성되므로, 같은 요청은 항상 같은 프롬프트를 만들어 냅니다.
텍스트 기반 이미지 생성에서는 텍스트 포맷이 Aspect ratio: 1:1과 Request: ...를 두 줄로 조합하고 thinking을 켭니다. 편집에서는 이미지마다 <Picture N> 블록을 작성하며, image_1은 1 MP이고 참조 이미지는 이미지 배치를 통해 그 크기로 패딩됩니다. 프롬프트 업샘플러 사용 스위치를 false로 설정하면 요청이 그대로 모델로 전달됩니다.
업샘플러는 확산 모델보다 먼저 실행되고, P-H3-Image가 메모리를 필요로 할 때 ComfyUI가 이를 VRAM 밖으로 옮기며, 출력이 캐시되어 요청이나 이미지가 바뀔 때만 다시 실행됩니다. bf16 업샘플러가 19.3 GB, 약 21 GB VRAM으로 권장됩니다.
최대 8개 이미지로 편집
편집은 변경할 이미지를 image_1로 두고 최대 7개의 참조 이미지를 추가하며, 이미지 배치와 조건화 노드에서 같은 순서로 배치하고 업샘플러 입력에는 각각 <Picture N> 블록을 넣습니다. 요청에서 이들을 원하는 방식으로 지칭할 수 있으므로 "두 번째 사진의 모자"는 두 번째 이미지로 해석됩니다. Picture 1만 편집되고 나머지는 컨텍스트입니다.
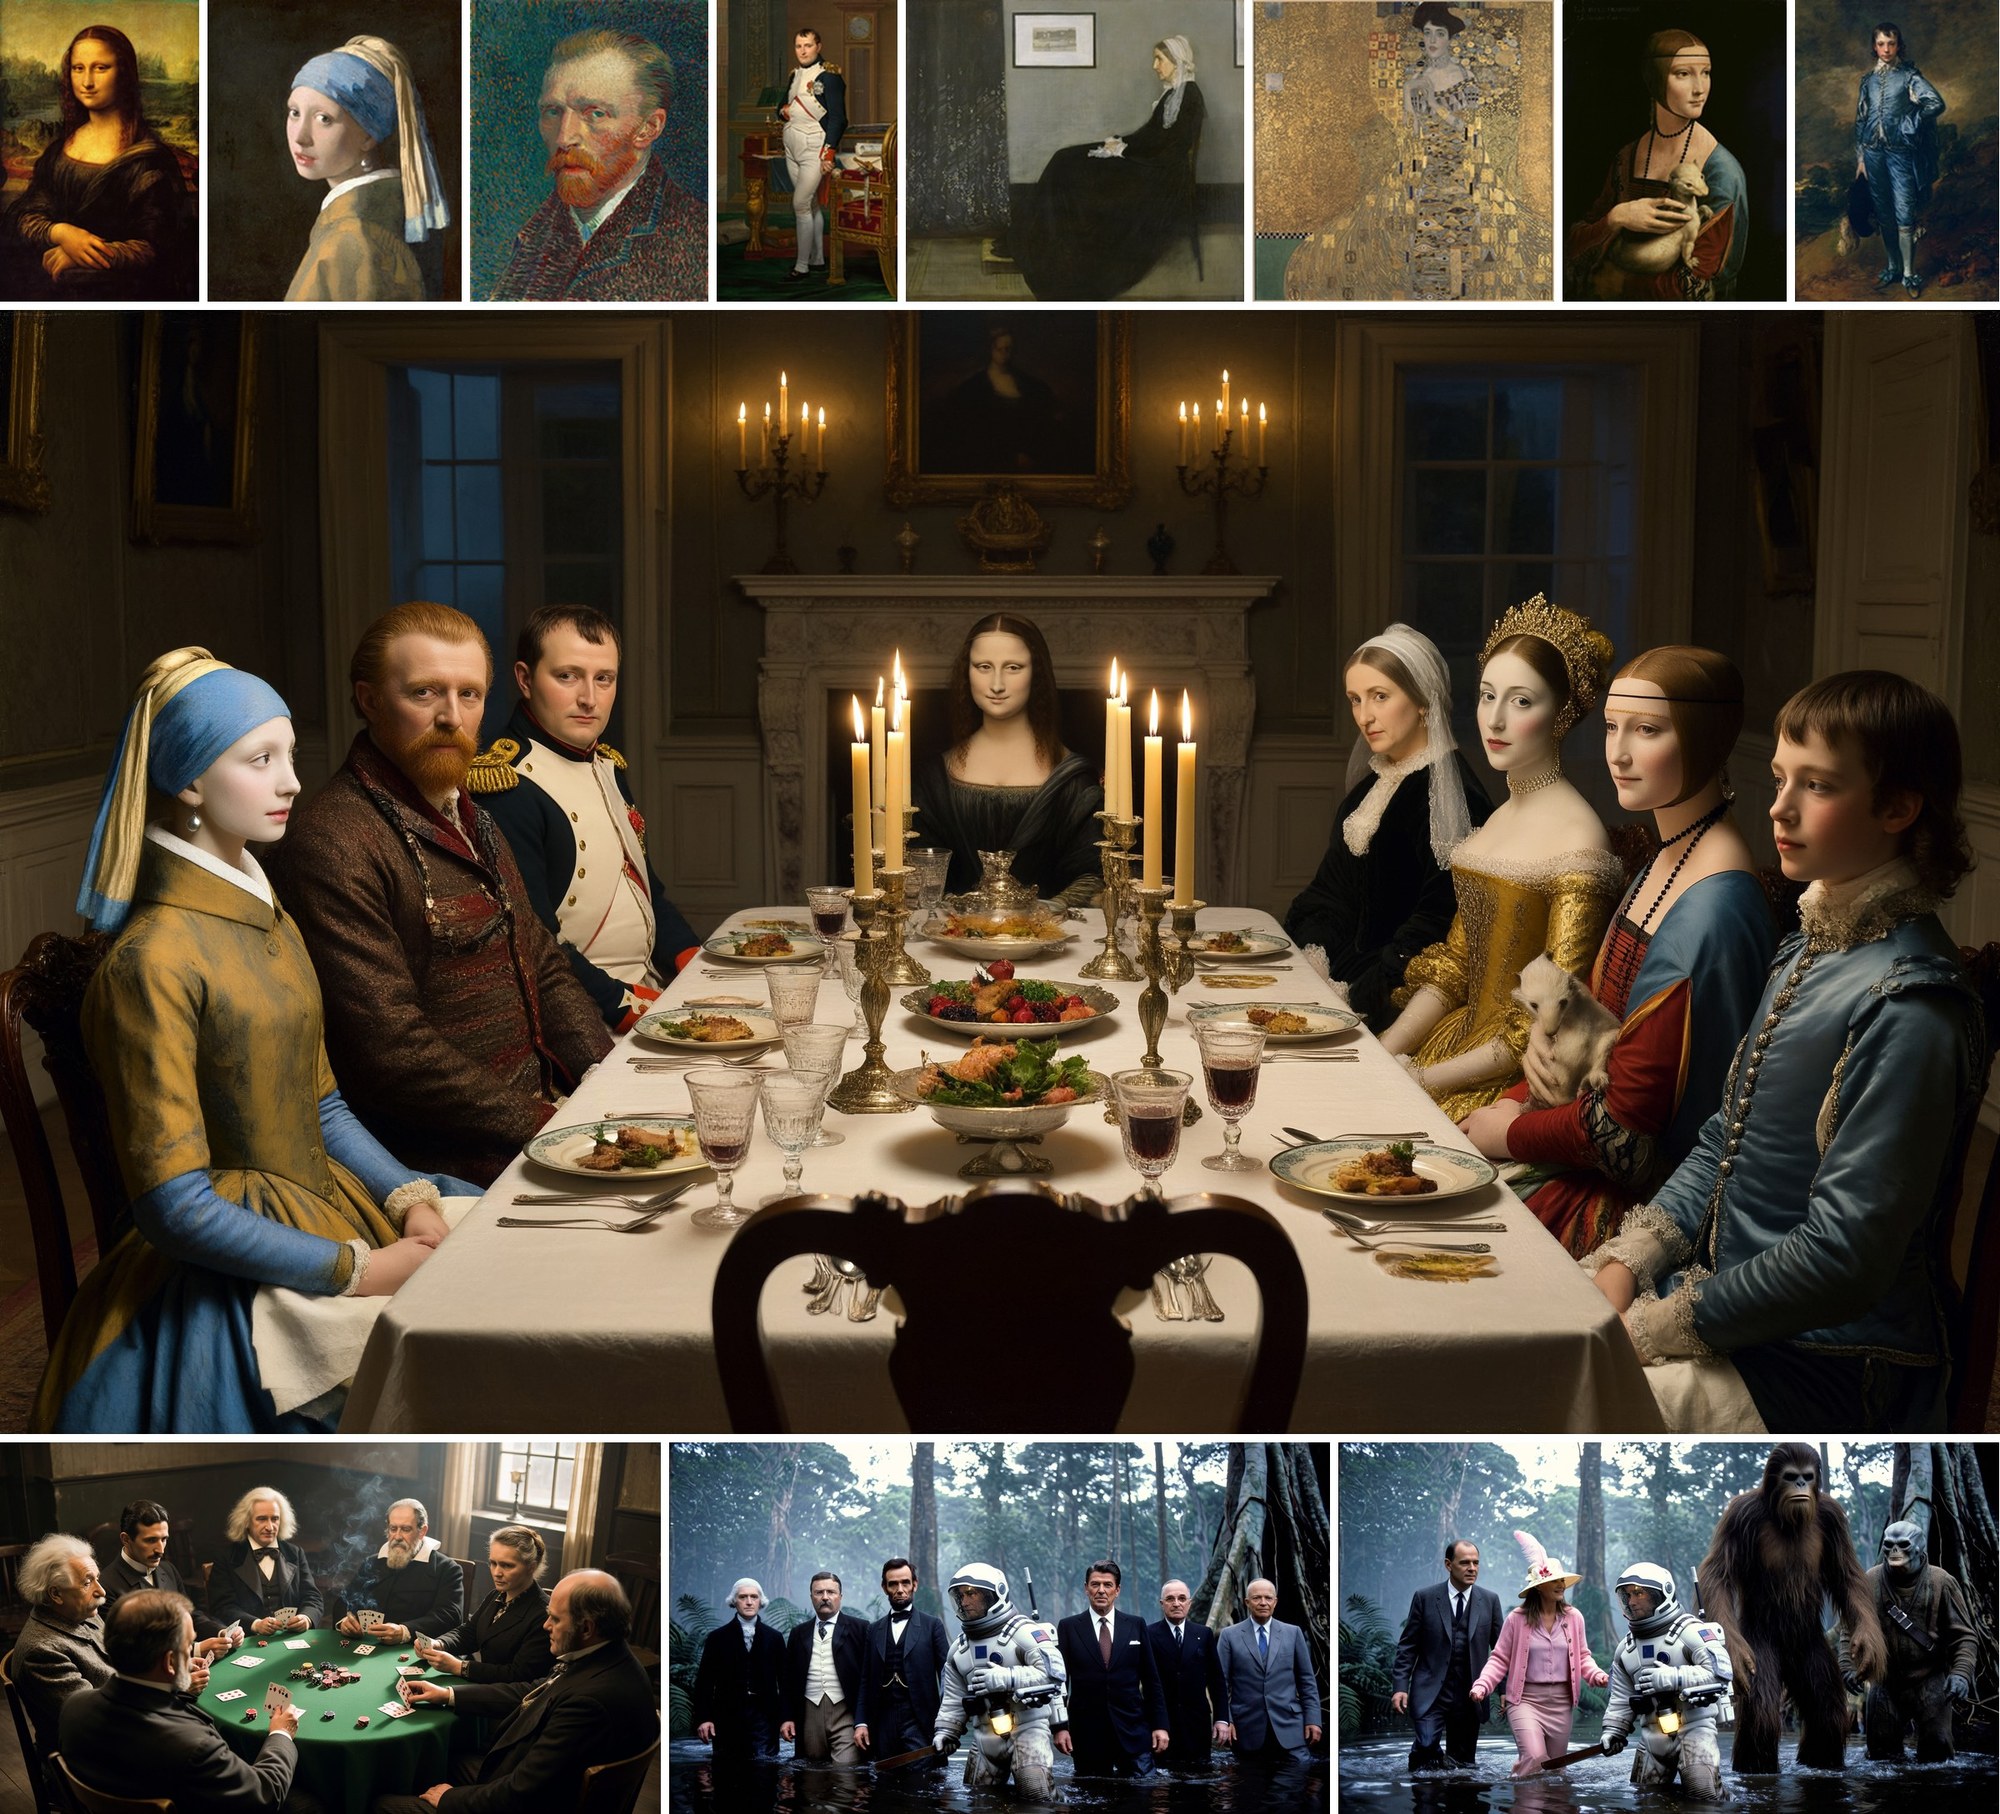
여덟 개의 퍼블릭 도메인 인물 사진과, 한 번의 요청으로 P-H3-Image가 그것들을 조합해 만든 디너 파티 장면입니다.
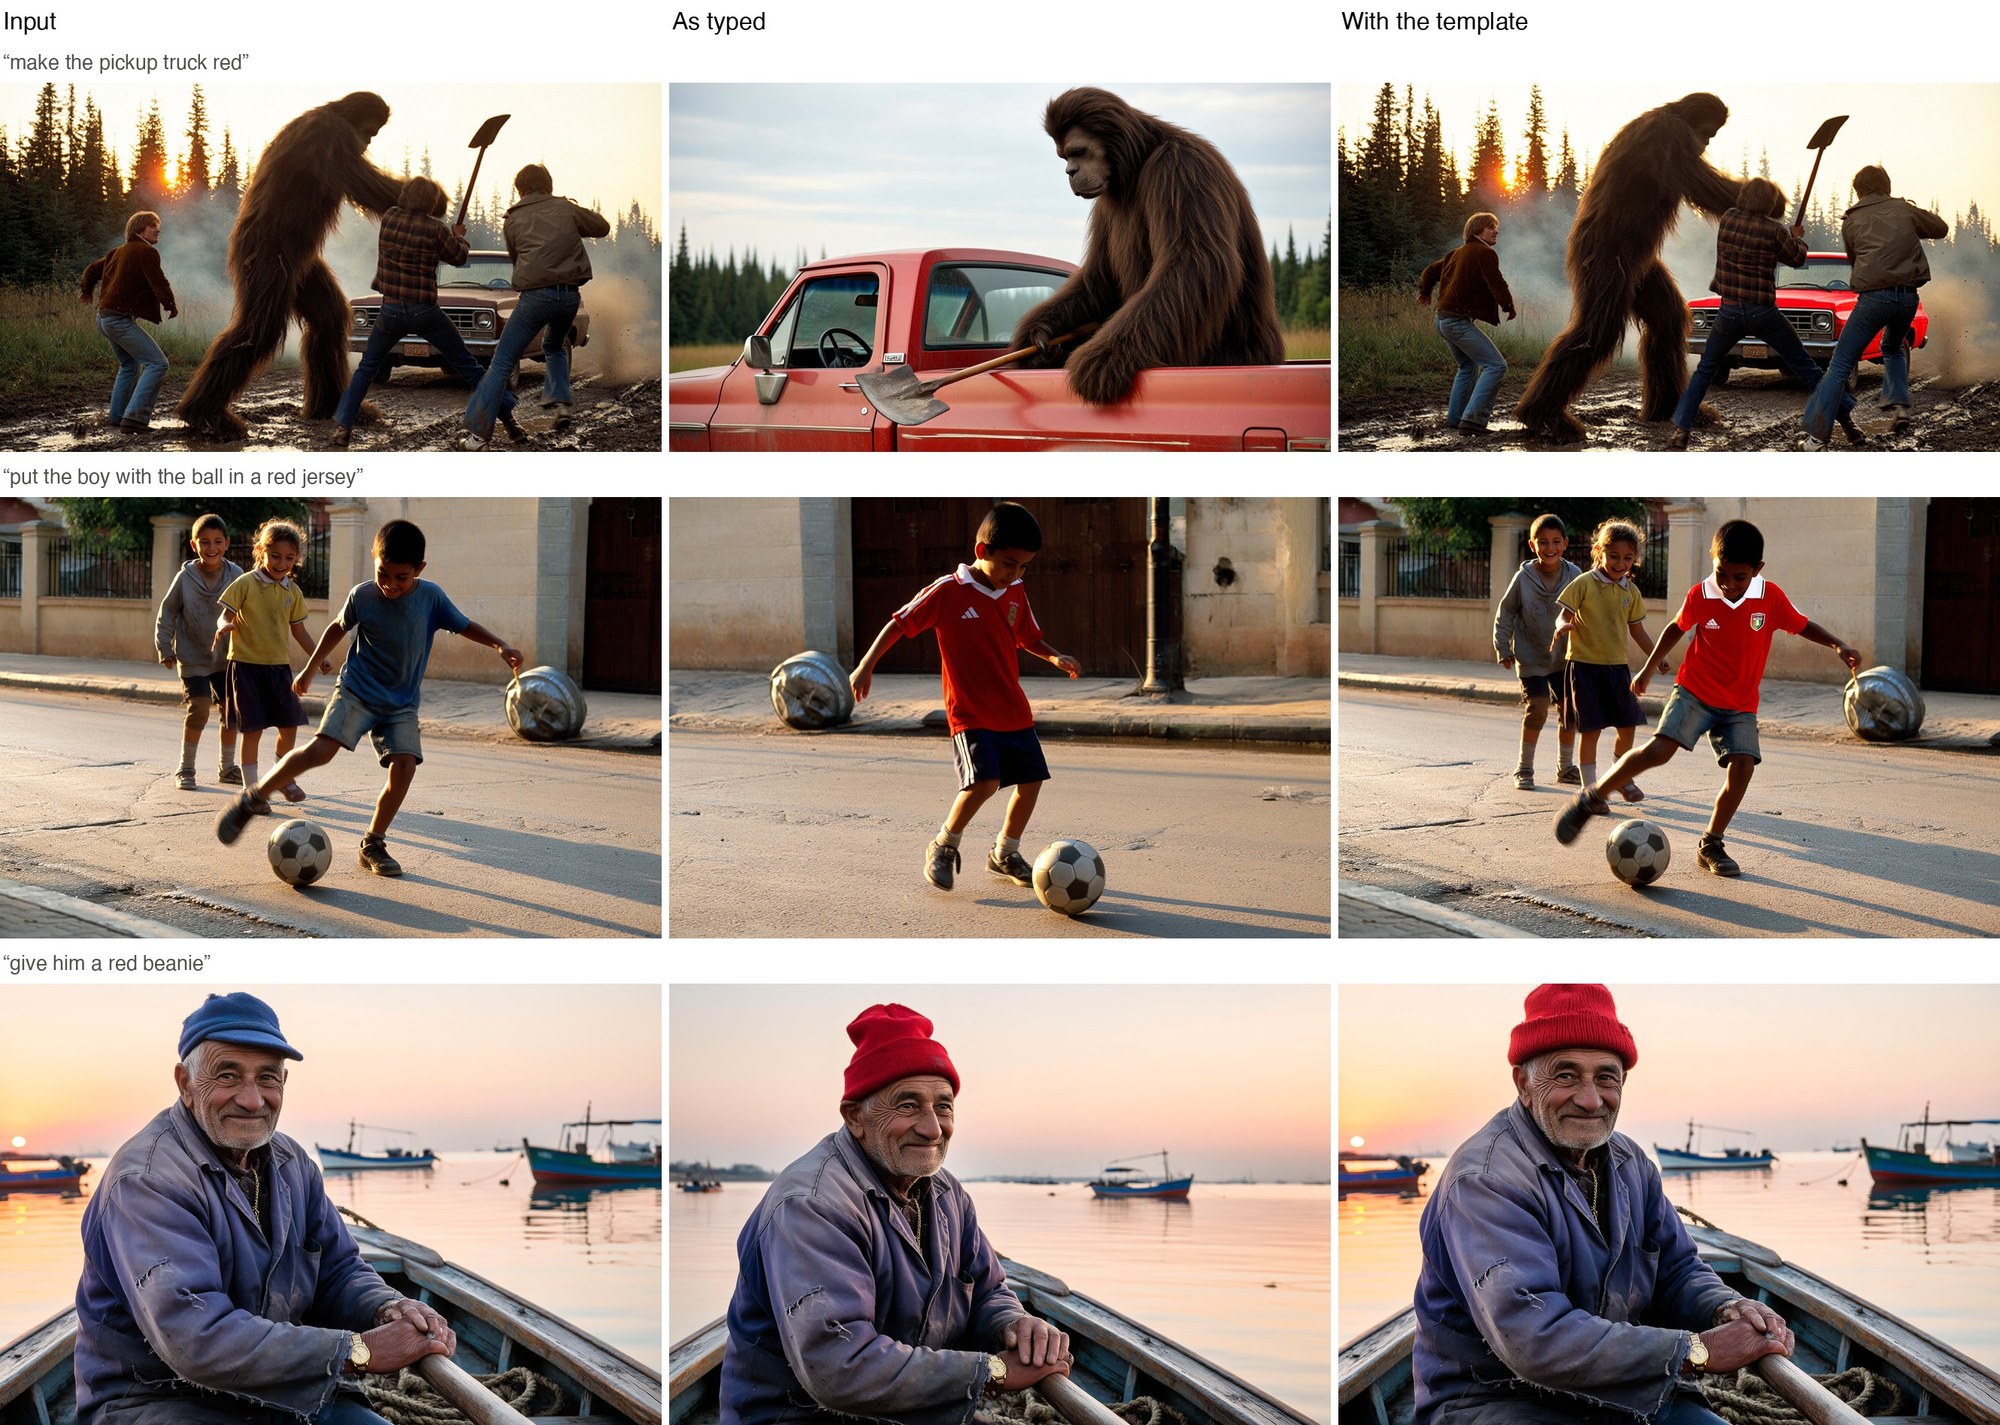
공식 모델 카드의 편집 출력입니다.
8 MP가 기준 동작점입니다
이 모델은 8 MP로 학습되었고, 모델 카드는 2 MP와 4 MP가 더 나쁘며 아티팩트가 얼굴, 손, 작은 디테일에서 가장 잘 보인다고 분명히 밝힙니다. 기본 텍스트 기반 이미지 생성 크기는 2912 x 2912이며, 각 변은 32의 배수로 반올림됩니다.
| 종횡비 | 8 MP (너비 x 높이) | 4 MP, 편집용 |
|---|---|---|
| 1:1 | 2912 x 2912 | 2048 x 2048 |
| 4:3 | 3360 x 2496 | 2368 x 1760 |
| 3:4 | 2496 x 3360 | 1760 x 2368 |
| 3:2 | 3552 x 2368 | 2496 x 1664 |
| 2:3 | 2368 x 3552 | 1664 x 2496 |
| 16:9 | 3872 x 2176 | 2720 x 1536 |
| 9:16 | 2176 x 3872 | 1536 x 2720 |
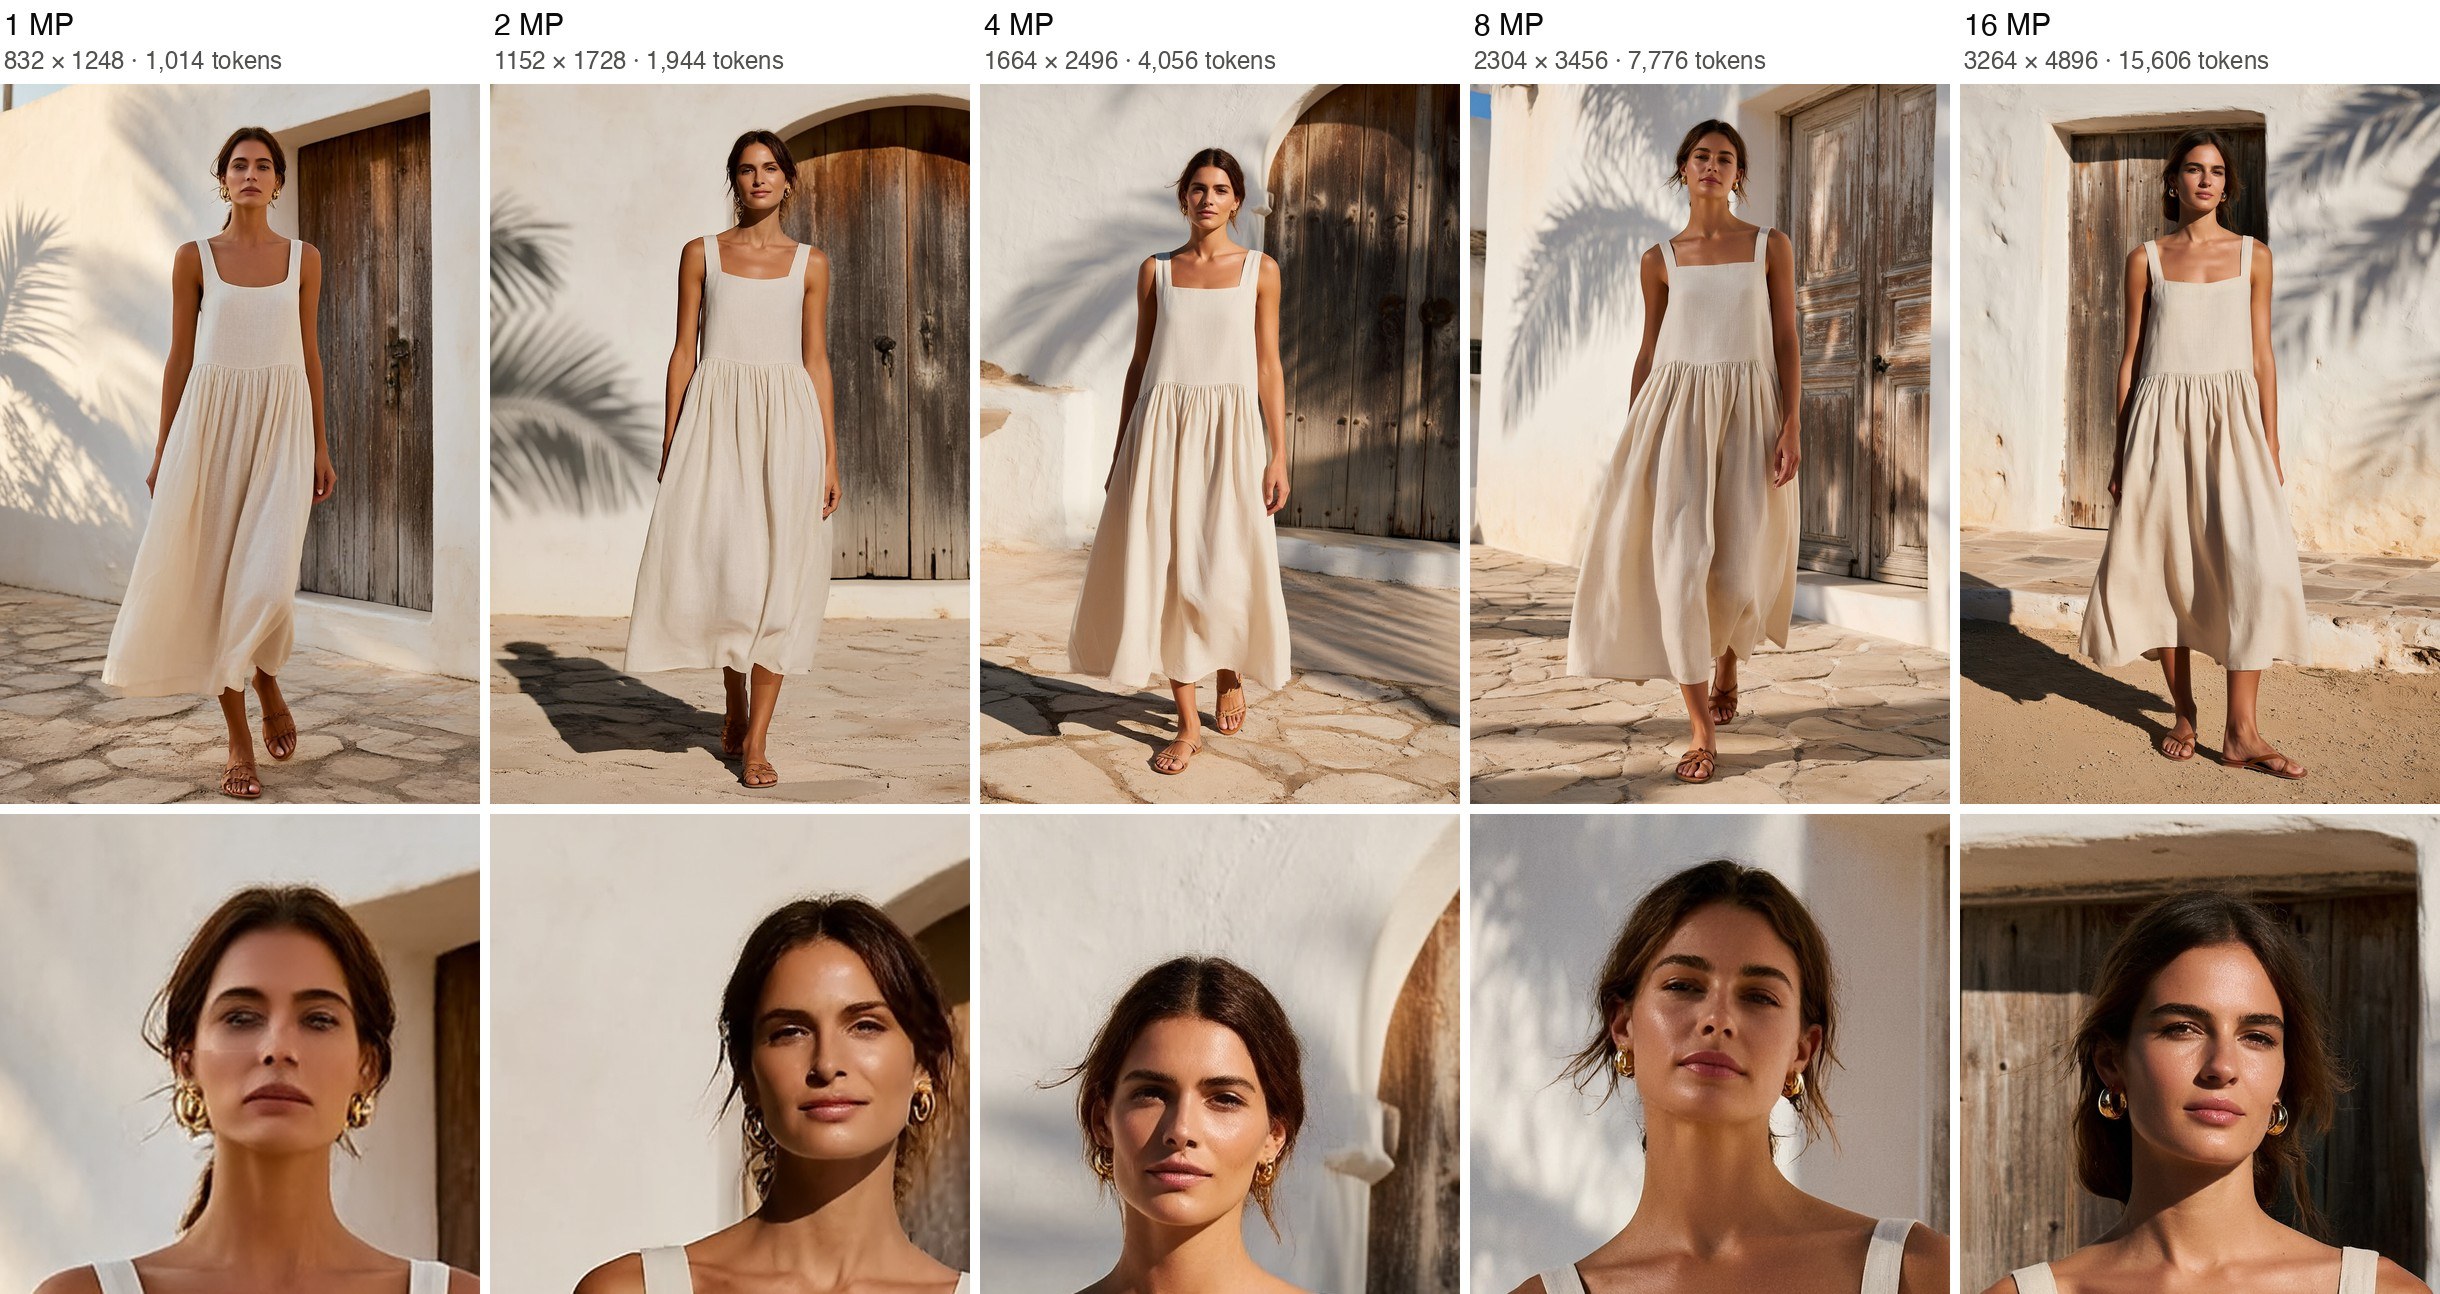
1 MP부터 16 MP까지 동일한 프롬프트와 시드로 생성하고 얼굴을 확대한 결과입니다. 1 MP에서는 피부가 매끄럽고 왁스처럼 보이지만, 8 MP부터는 텍스처와 잔머리, 귀걸이가 드러납니다.
너비와 높이를 명시하지 않은 편집은 Picture 1의 크기로 생성되며 최소 4 MP까지 확대됩니다. 두 크기를 전달하면 캔버스 크기가 바뀔 뿐, 그 안의 이미지는 바뀌지 않습니다.
사용 가능 경로
- 가중치 및 diffusers 파이프라인: PrunaAI/P-H3-Image
- ComfyUI 파일 및 워크플로: PrunaAI/P-H3-Image-Comfy
- 브라우저 데모: Hugging Face Spaces의 PrunaAI/P-H3-Image
- ComfyUI 지원: PR 17506, v0.44.0에 포함
댓글
GitHub로 로그인하고 토론에 참여하세요.