ComfyUI SPEED, 이제 이미지 모델까지 가속: MiniMax H3 전용 아님
ComfyUI-SPEED가 KSampler 형태 노드를 추가해 MOSS Image와 Krea 2에서도 점진적 해상도 샘플링이 동작하며, 모델별 캘리브레이션과 새로운 타이밍 수치를 제공합니다.
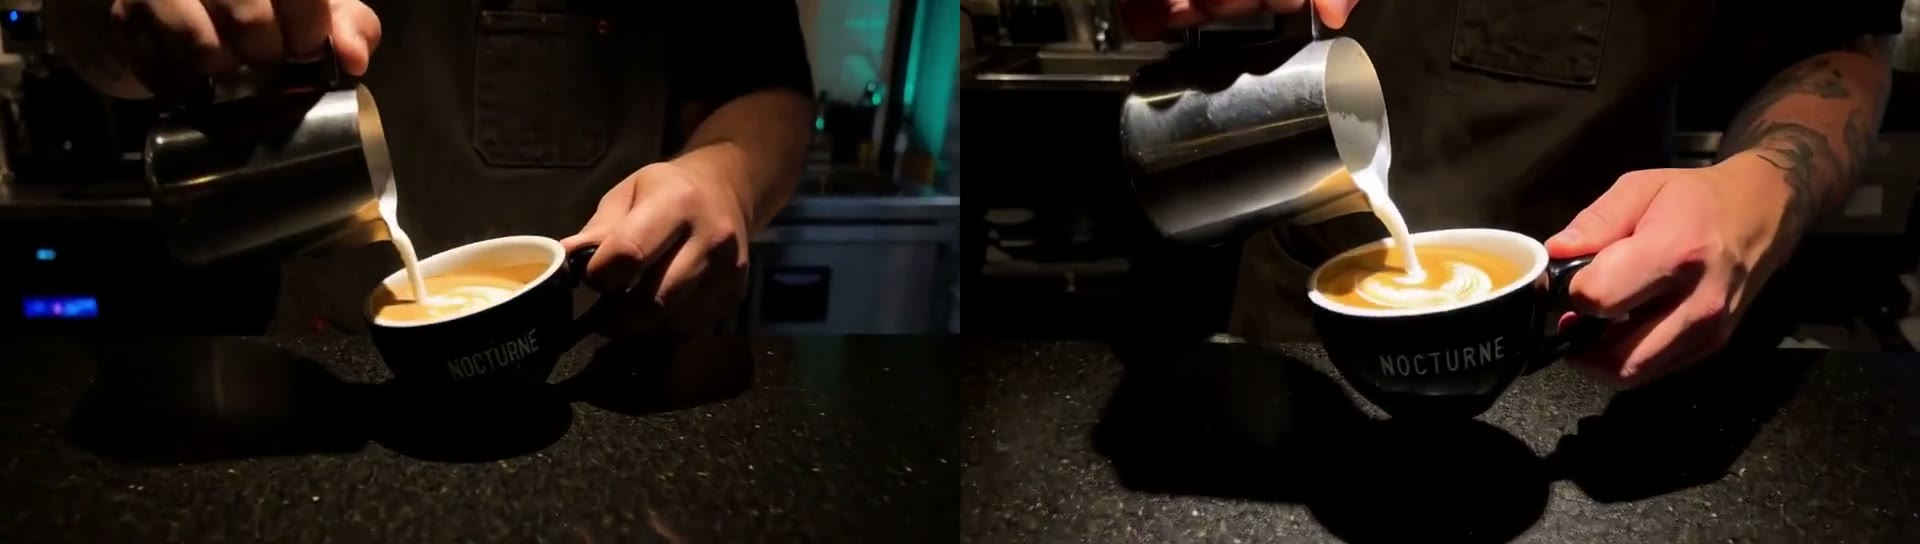
동일한 시드와 프롬프트, Modal L40S에서 5초 960x544 클립. 왼쪽: 일반 샘플링 288초. 오른쪽: 허용치 0.05, 4단계 SPEED 182초.
팩이 하는 일
SPEED는 스탠퍼드의 Howard Xiao, Brian Chao, Lior Yariv, Gordon Wetzstein이 작성한 Spectral Progressive Diffusion for Efficient Image and Video Generation에서 나왔습니다. 그 바탕에 있는 관찰은 이것입니다. diffusion 모델은 대략 저주파에서 고주파로 이미지를 만들어 가므로, 초기 디노이징 스텝은 모델이 아직 해결하지 못한 주파수 대역이 지배합니다. 그 스텝들을 전체 해상도에서 실행하면 연산의 대부분이 노이즈에 쓰입니다.
팩은 이를 재학습 없이 ComfyUI에 적용합니다. 실행은 더 작은 그리드에서 시작하고, 디테일이 중요해지기 시작하면 잠재 데이터를 더 큰 그리드로 키웁니다. stages가 사다리를 고릅니다. 2단계는 0.5에서 1.0, 3단계는 0.33에서 0.66, 1.0, 4단계는 0.25에서 0.5, 0.75, 1.0으로 진행합니다. Tolerance (Delta), noise_amplitude, noise_decay_exponent가 각 전환이 몇 번째 스텝에서 일어나는지 결정하며, 허용치가 작을수록 전환이 늦어집니다. 더 안전하지만 느립니다.
MiniMax H3는 비디오 스트림이 어느 단계에 있든 오디오 스트림을 항상 전체 해상도로 유지합니다.
이름 바꾸기로 달라진 점
저장소가 StanLukuvka/ComfyUI-MiniMax-H3-SPEED에서 StanLukuvka/ComfyUI-SPEED로 바뀌었고, 변경 로그는 이 내용을 2.0.0으로 묶습니다. 팩이 아직 H3 전용이던 시절, 이 사이트는 V2 샘플러 세트를 다뤘습니다.
- 두 계열, 여섯 개 노드.
SPEED KSampler,SPEED KSampler (Manual),SPEED KSampler Sigma Harvest는 ComfyUI 자체 KSampler처럼model, 조건화,latent_image를 받고 노이즈, 가이드, 샘플러, 시그마 스케줄을 내부에서 구성합니다. 고급 계열은 MiniMax H3를 위한 SamplerCustomAdvanced 배선을 유지합니다. - flow 이미지 모델. MOSS Image와 Krea 2는 KSampler 노드로 실행됩니다. 팩은 EPS나 v-prediction 체크포인트 같은 비-flow 모델을 샘플러와 Harvest 모두에서 오류와 함께 거부합니다.
- 이미지 기반 이미지 생성.
denoise는 KSampler에서처럼 동작합니다. 첫 단계는 인코딩된 이미지를 해당 단계 크기로 축소한 것에서 시작하고, Automatic은 단축된 스케줄이 이미 지나간 거친 단계를 건너뜁니다. - 편집 모델의 참조 잠재 데이터.
reference_latents를 받는 편집 모델(예: Flux 3 Klein)은 예전에 거친 단계에서 참조 이미지의 왼쪽 위 모서리만 보았습니다. 이제 KSampler 노드는 각 단계마다 참조 잠재 데이터의 크기를 조정하고 마지막 단계에서 복원합니다. - 기본값이 내장되어 있지 않습니다.
noise_amplitude와noise_decay_exponent는 이제 0에서 시작하며, Harvest 캘리브레이션을 실행하기 전까지 오류로 중단됩니다. Euler를 쓰는 기본 H3의 경우 README에 참조 값 35.4213과 1.0126이 나와 있습니다. - 이름이 바뀐 노드. 이전
MiniMaxH3*ID는 지원 중단된 하위 클래스로 계속 등록되어 있어, 저장된 워크플로가 여전히 로드되고 한 번에 한 노드씩 교체할 수 있습니다.
Sigma Harvest는 모델별 캘리브레이션이 일어나는 곳입니다. SPEED 체인 없이 전체 해상도에서 샘플러와 스케줄을 한 번 실행하고, 잔차의 파워가 주파수에 따라 어떻게 감소하는지 측정한 뒤 P(ω) = A·|ω|^-β를 피팅합니다. 그다음 Automatic이 이 피팅으로 각 단계 경계를 계산하고, Harvest는 r²와 health 레이블(r² 0.7 이상이면 good, 0.4면 fair, 그다음 weak, suspect, invalid)을 보고해 피팅을 신뢰할 만한지 알려줍니다.
측정된 속도 향상
새로운 H3 근거 자료는 이전 10초 클립을 960x544의 5초 라떼 아트 붓기 클립으로 교체했으며, Modal L40S에서 Harvest 캘리브레이션 한 번(A 35.4213, β 1.0126)으로 실행했습니다. 허용치 0.01과 0.05 세션에서 일반 샘플링은 288초, 0.005 세션에서는 276초가 걸렸고, 각 속도 향상은 해당 세션을 기준으로 측정했습니다.
| 허용치 | 2단계 | 3단계 | 4단계 |
|---|---|---|---|
| 0.005 | 238초 (1.16x) | 236초 (1.17x) | 227초 (1.22x) |
| 0.010 | 238초 (1.21x) | 226초 (1.27x) | 224초 (1.29x) |
| 0.050 | 206초 (1.40x) | 194초 (1.48x) | 182초 (1.58x) |
같은 쌍을 나란히 재생한 모습. 왼쪽이 일반 샘플링, 오른쪽이 허용치 0.05, 4단계 SPEED입니다.
작성자는 열 개의 H3 클립 중 색 번쩍임이 발생한 클립이 없고, 붓기 동작과 라떼 아트, 레터링이 모든 실행에서 유지된다고 보고합니다. 이는 같은 저장소가 RTX 5080에서 이전 H3 클립에 대해 보고한 2.41배보다 낮은 수치이므로, 배수는 방법의 속성이 아니라 클립과 GPU, 캘리브레이션의 속성으로 보아야 합니다.
이미지 스틸은 실행 시간이 훨씬 짧고 수치도 더 작습니다.
| 모델 | 기본 | Automatic, 3단계, 허용치 0.05 | Manual, 0.5x에서 절반 스텝 |
|---|---|---|---|
| MOSS Image, 1344x768, 20스텝, CFG 5 | 22초 | 18초 (1.26x) | 14초 (1.54x) |
| Krea 2 raw, fp8, 1216x832, 52스텝, CFG 3.5 | 283초 | 215초 (1.31x) | 183초 (1.55x) |
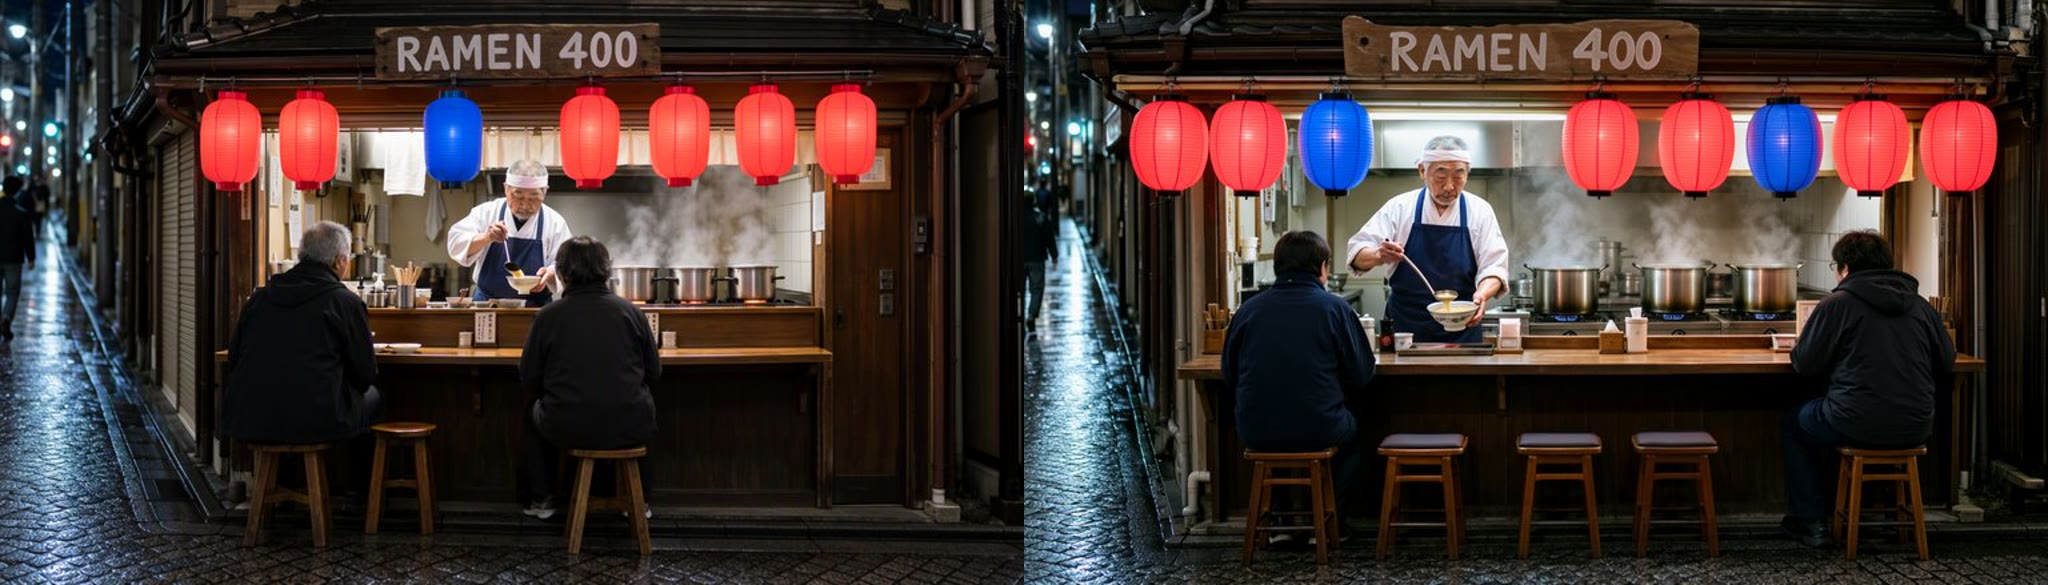
MOSS Image 1344x768, 동일한 시드와 프롬프트. 왼쪽: 기본 22초. 오른쪽: SPEED 3단계 18초.
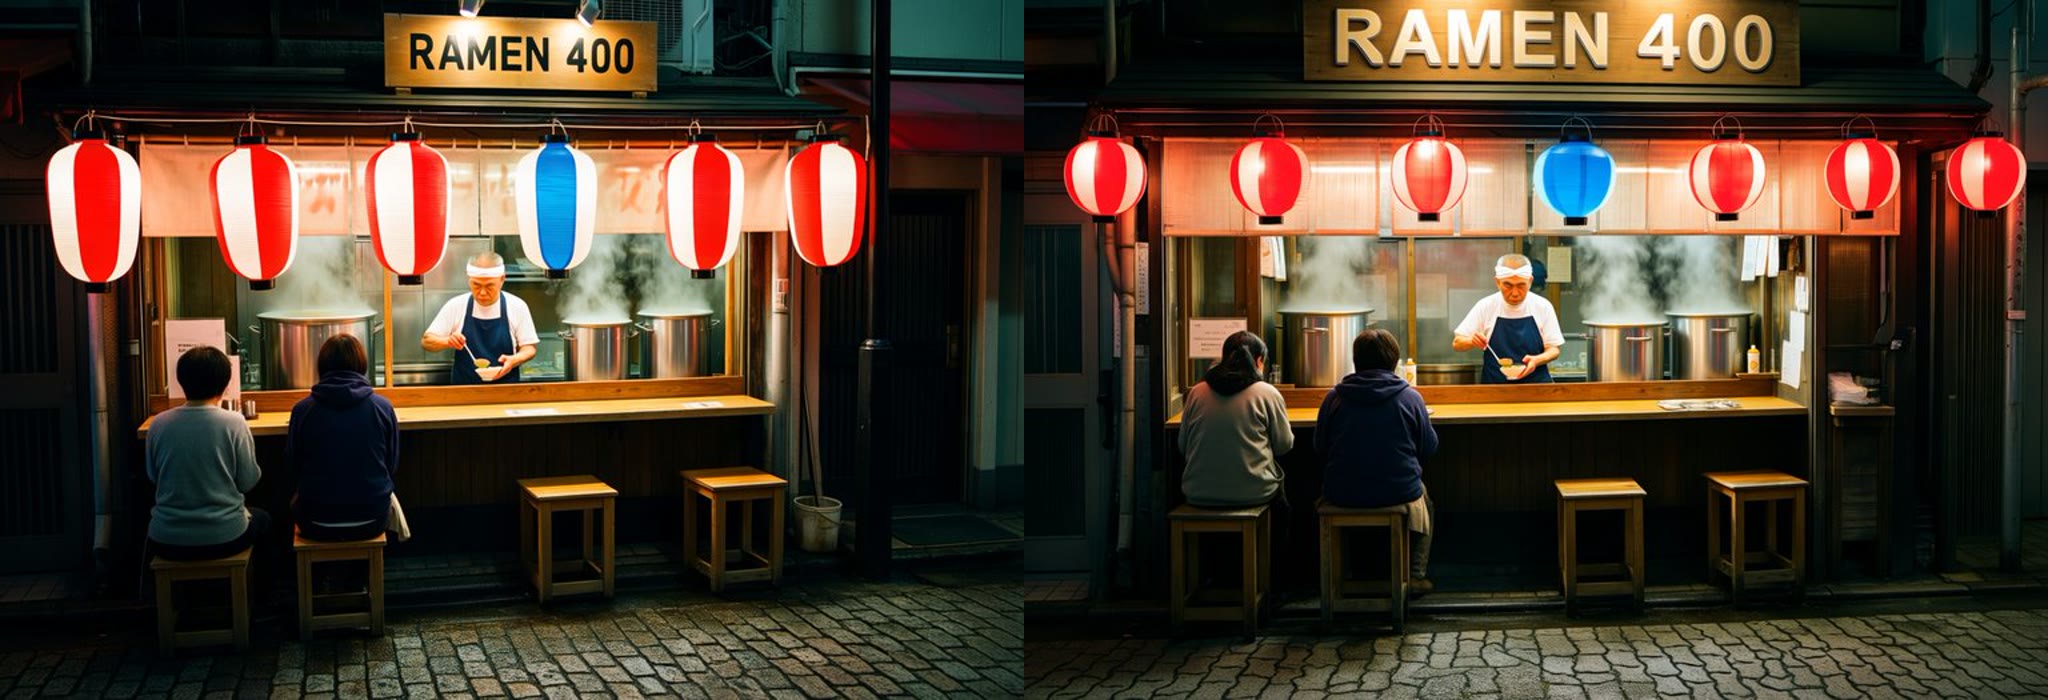
Krea 2 1216x832, 52스텝. 왼쪽: 기본 283초. 오른쪽: SPEED 3단계 215초. 작성자는 Krea 2 수치가 13GB 모델을 8GB 카드에서 실행한 단일 측정이라 수십 초 단위로 달라진다고 밝혔습니다.
허용치 0.005에서는 수확된 경계가 이미지 스케줄의 처음 몇 스텝 안에 들어가 거의 절약되지 않으므로, 이미지 워크플로는 0.05를 사용합니다.
구도 대 속도
noise_policy는 각 전환에서 추가 고주파 디테일이 어디서 오는지 결정합니다. coupled_full_grid는 일반 SamplerCustomAdvanced 실행이 사용할 노이즈 필드를 재사용하므로 같은 시드가 같은 구도를 유지하며, H3 클립에서는 510%만 절약했습니다. 30%를 절약했습니다.direct_coarse는 자체적으로 채움을 생성합니다. 주어진 시드에서 그림이 바뀌며, 같은 클립에서 15
워크플로
저장소에는 예제 그래프 세 개가 포함되어 있으며, 각 그래프는 하나의 로더 세트 위에 Harvest, Automatic, Manual 노드를 모두 갖추고 Automatic만 활성화되어 있습니다.
H3 그래프는 고급 노드를 Euler, 20스텝의 simple 스케줄링, 3단계, 허용치 0.005로 실행합니다. 두 이미지 그래프는 KSampler 노드를 Euler와 함께 MOSS Image는 20스텝, Krea 2는 52스텝으로 실행하며, 3단계와 허용치 0.05를 사용합니다.
제한 사항
- 샘플러와 Harvest 모두 flow(CONST) 이미지 모델만 허용합니다.
noise_mask와 마스크된 디노이징은 지원되지 않습니다.- 고급 노드에서
latent_image는 비어 있는 상태로 시작해야 합니다. 이미지 기반 비디오 생성은 H3 키프레임 조건화를 통해 이루어지며, 팩이 크기를 조정하고 복원합니다. - 각 단계는 별도의 샘플러 호출이므로, 다단계 샘플러는 해상도가 바뀔 때마다 히스토리를 재시작합니다. 모든 단계에 최소 2스텝을 배정하세요.
- 일부 샘플러는 여전히 H3에서 오작동합니다.
dpm_fast와dpm_adaptive는 디노이징을 완료하지 못하고,uni_pc는 한 단계에 스텝이 하나만 배정되면 깨집니다.
사용 가능 위치
- 노드 팩: StanLukuvka/ComfyUI-SPEED
- 논문: Spectral Progressive Diffusion
- 워크플로:
workflows/ - 근거 자료 및 원본 클립:
evidence/
이 글을 작성할 당시 저장소는 110개의 스타를 받았습니다. 발표는 r/StableDiffusion에서 이루어졌으며, 작성 시점까지 이미지 모델 수치에 대한 독립적인 재현 결과는 게시되지 않았습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.