Anima RGBA: ComfyUI에서 Anima에 실제 알파 채널 부여하기
Anima RGBA는 4채널 Qwen-Image VAE와 Anima LoRA를 결합해 커스텀 노드 없이 투명 PNG를 렌더링하며, 홀드아웃 세트에서 알파 MAE 0.0027을 기록합니다.
transparent background를 넣으면 VAE Decode가 순수 RGB와 알파를 반환하고 Save Image가 이를 RGBA PNG로 저장합니다. 커스텀 노드는 필요 없습니다.
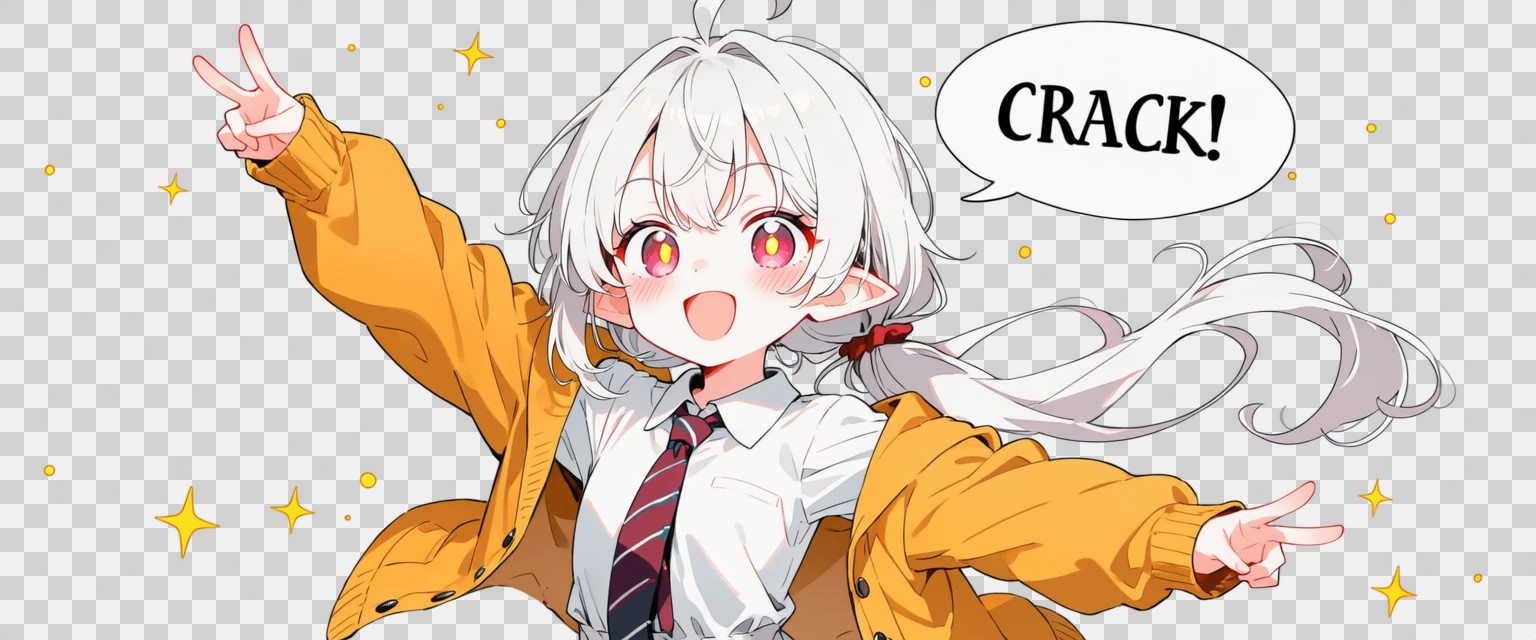
RGBA VAE와 LoRA로 생성한 이미지를 체커보드 위에 표시한 모습.
Anima는 3채널로 디코딩하는 Qwen-Image VAE를 사용합니다. 따라서 모델에 투명 배경을 요청하면, 모델이 빈 배경이라고 상상하도록 지시받은 배경 위에 피사체를 그리게 되고, 누끼는 이후 매팅(matting) 단계에서 처리됩니다. RGBA VAE는 이 과정을 디코더 안으로 옮깁니다. 마지막 레이어가 3채널 대신 4채널을 갖는 것뿐입니다.
3채널 VAE를 4채널로 바꾸는 방법
이 방식은 이름보다 훨씬 단순합니다. VAE는 1/8 해상도에서 16채널 잠재 데이터를 유지하므로 Anima의 잠재 공간은 전혀 바뀌지 않습니다. 인코더는 흰색 위에 합성한 RGB와 알파 채널을 입력받고, 디코더는 미리 곱하지 않은 순수 RGB와 알파를 출력합니다.
나머지는 초기화가 처리합니다. 3채널 가중치는 복사되고, 새 알파 입력 열은 0에서 시작하며, 새 알파 출력 행은 편향 +1과 함께 0에서 시작합니다. 따라서 학습 전에는 모델이 원본 VAE를 그대로 재현하고 모든 것을 불투명하게 디코딩합니다. 이후 학습은 동일한 흰색 합성에 대해 새 인코더를 고정된 원본의 잠재 데이터 쪽으로 끌어당깁니다. 이렇게 하면 잠재 공간이 Anima가 이미 작동하는 위치에 유지되고, LoRA는 작은 알파 잔차만 학습하면 됩니다.
흰색 위 합성은 의도적인 선택입니다. 알파가 0인 곳에서는 RGB가 정의되지 않으며, 흰색 합성은 Anima가 투명 배경 프롬프트에 대해 이미 그리는 방식이므로 RGBA 잠재 데이터가 베이스 모델이 생성하는 잠재 데이터에 가깝게 유지됩니다. 측정된 드리프트는 잠재 표준편차 단위로 RMS 거리 0.058이며, 이는 1시그마의 약 6%에 해당하고, LoRA가 메우는 격차가 바로 이것입니다.
수치로 본 결과
VAE는 512 px 크롭에서 배치 4로 12,000 스텝 동안 학습되었습니다. 무작위 단색 배경에 대한 L1 합성 손실, LPIPS 0.2, 알파 L1, 알파 Sobel 기울기 항, 그리고 원본 인코더 대비 참조 잠재 데이터 MSE를 사용했습니다. 각 배치의 15%는 정규화용 불투명 이미지였습니다. 512 px의 투명 이미지 200장과 불투명 이미지 50장으로 구성된 홀드아웃 세트(모두 학습에 사용되지 않음)에서 측정한 결과는 다음과 같습니다.
| 지표 | 값 |
|---|---|
| 알파 MAE | 0.0027 (약 0.7 / 255) |
| 알파 RMSE | 0.0157 (약 4 / 255, 모서리에 집중) |
| 흰색 위 합성 PSNR | 34.94 dB |
| 검정색 위 합성 PSNR | 33.17 dB |
| 불투명 PSNR, 원본 Qwen-Image VAE | 34.26 dB |
| 불투명 PSNR, Anima RGBA VAE | 34.74 dB |
불투명 재구성은 약간 나빠진 것이 아니라 원본보다 약간 더 좋습니다. 이것이 유용한 결과입니다. VAE를 교체해도 일반 이미지에서는 손실이 없습니다.
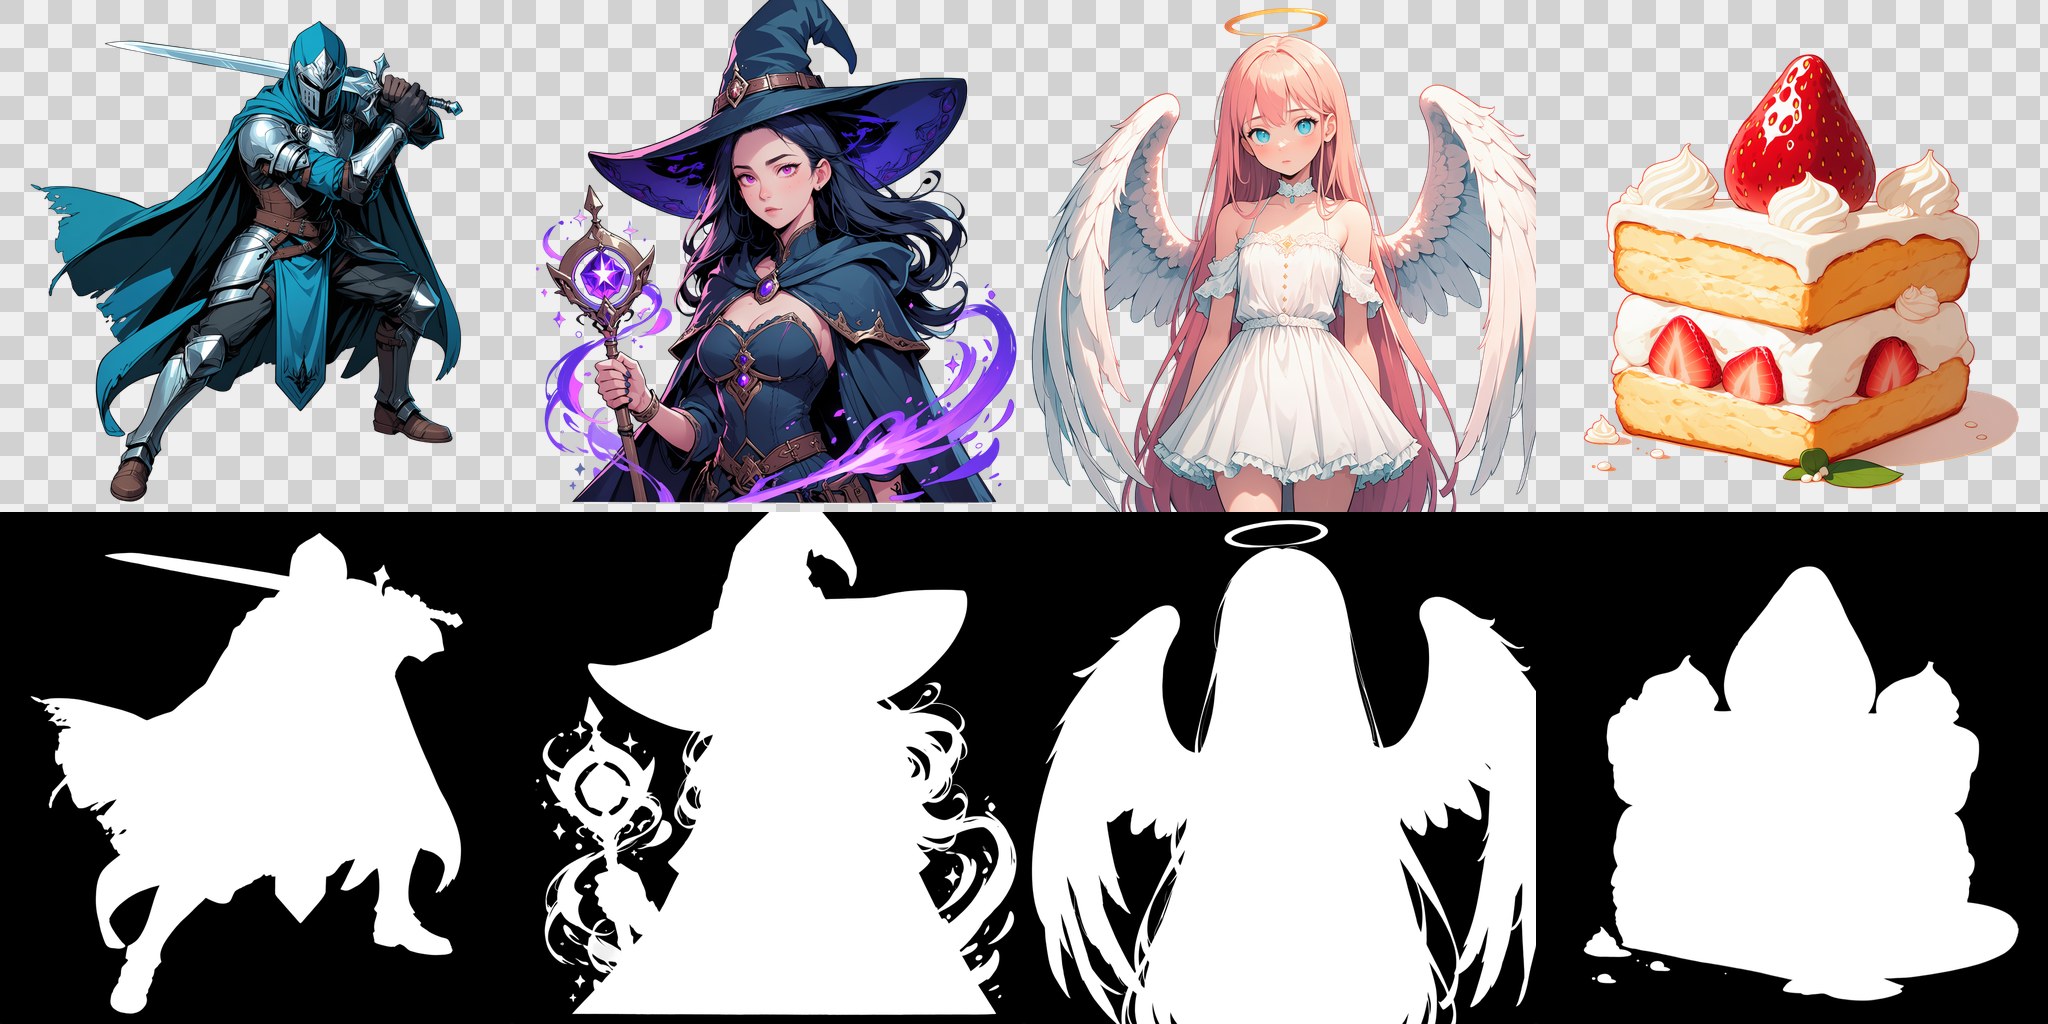
윗줄: 체커보드 위에 표시한 RGBA 출력. 아랫줄: 알파 채널만 따로 표시한 모습.
LoRA가 여전히 필요한 이유
LoRA가 없어도 VAE는 알파 채널을 생성하지만, 흐릿합니다. 베이스 모델의 잠재 데이터가 새 디코더가 기대하는 값과 대략적으로만 일치하기 때문에 캐릭터와 흰색 의상이 부분적으로 투명하게 나옵니다. LoRA는 이 VAE의 잠재 데이터로 랭크 32, 25,000 스텝 동안 18,426장의 이미지로 학습되었으며, Qwen3 텍스트 인코더와 LLM 어댑터는 고정했습니다. 투명 이미지에는 transparent background와 isolated on a transparent background라는 두 가지 트리거 문구를 번갈아 캡션으로 붙였고, 불투명 정규화 이미지에는 트리거를 붙이지 않았습니다.
모델 카드의 테스트 표는 1024 x 1024에서 8개 프롬프트와 2개 시드로 측정한 것으로, 설정을 바꿀 때 어떤 일이 일어나는지 보여줍니다.
| LoRA 강도 | 트리거 가중치 | 투명 | 반투명 픽셀 |
|---|---|---|---|
| 없음 | 1.0 | 16 / 16 | 12.8% |
| 1.0 | 1.0 | 16 / 16 | 0.9% |
| 1.2 | 1.0 | 16 / 16 | 1.0% |
| 1.5 | 1.0 | 16 / 16 | 1.4% |
| 1.0 | 1.2 | 16 / 16 | 0.9% |
| 1.0 | 1.5 | 16 / 16 | 0.9% |
모든 설정에서 투명한 결과가 나오므로, 중요한 수치는 원치 않는 반투명 픽셀의 비율입니다. LoRA가 없을 때 12.8%인 반면 기본값에서는 0.9%입니다. LoRA를 1.5로 올리면 도움이 되지 않고 피사체 주변에 반투명 잔여물과 연기가 추가됩니다. 반대로 트리거 가중치를 올리면 이미지와 알파가 거의 변하지 않습니다. 이는 일반적인 직관과 반대이며, 모델 카드에서도 직접 이렇게 말합니다. LoRA 강도가 아니라 트리거 가중치를 올리라고요.
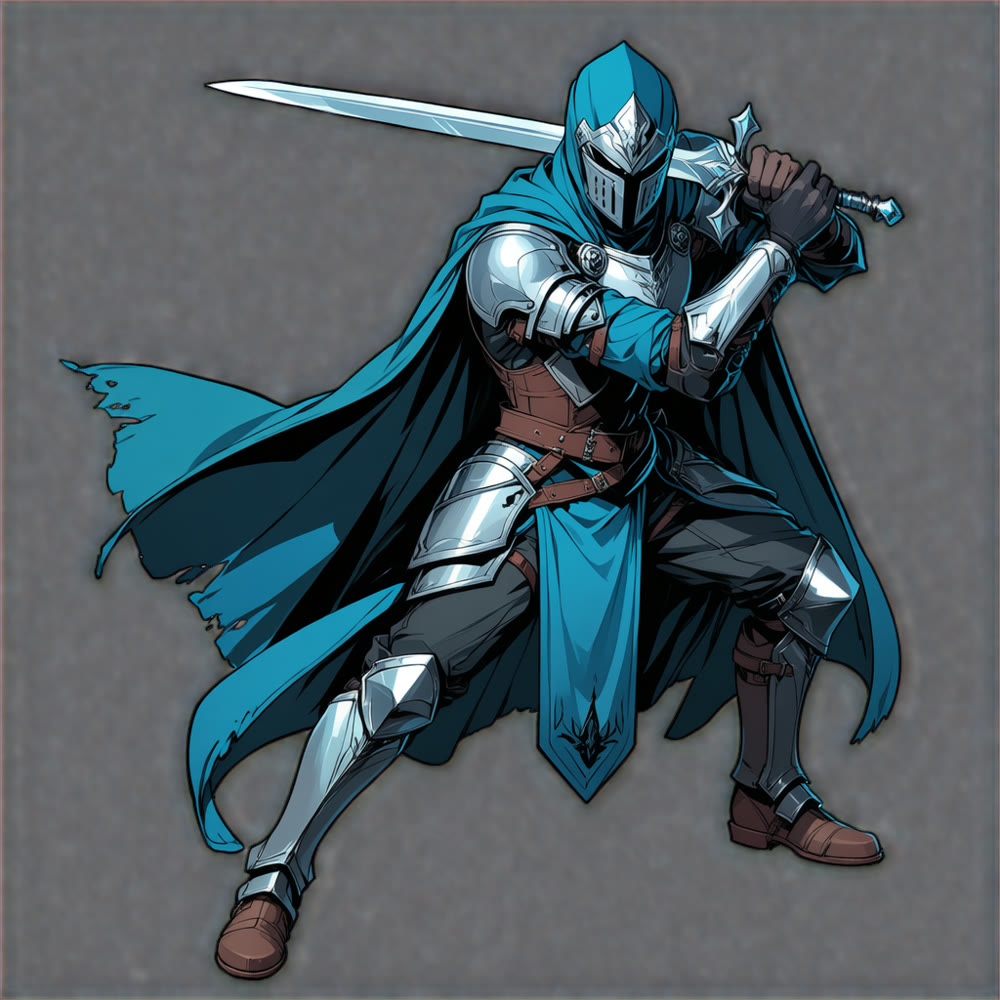
LoRA 1.0, 30 스텝, CFG 4.5, simple을 사용한 er_sde로 생성한 전신 캐릭터.
부족한 부분
VAE는 512 px 크롭으로 학습되었고 더 높은 해상도에서도 디코딩하지만, 머리카락 가닥, 유리, 연기처럼 미세한 반투명 디테일이 가장 취약한 영역입니다. 생성되는 알파는 대부분 이진값에 가까워서, 비치는 의상은 보통 불투명하게 나옵니다. 프레임을 가득 채우는 클로즈업은 불투명한 흰색 배경이 남는 경우가 있으며, 다른 LoRA를 함께 쌓았을 때 더 자주 발생합니다. 이 VAE는 Anima가 그리는 애니메이션 및 일러스트 콘텐츠를 위해 만들어졌습니다.
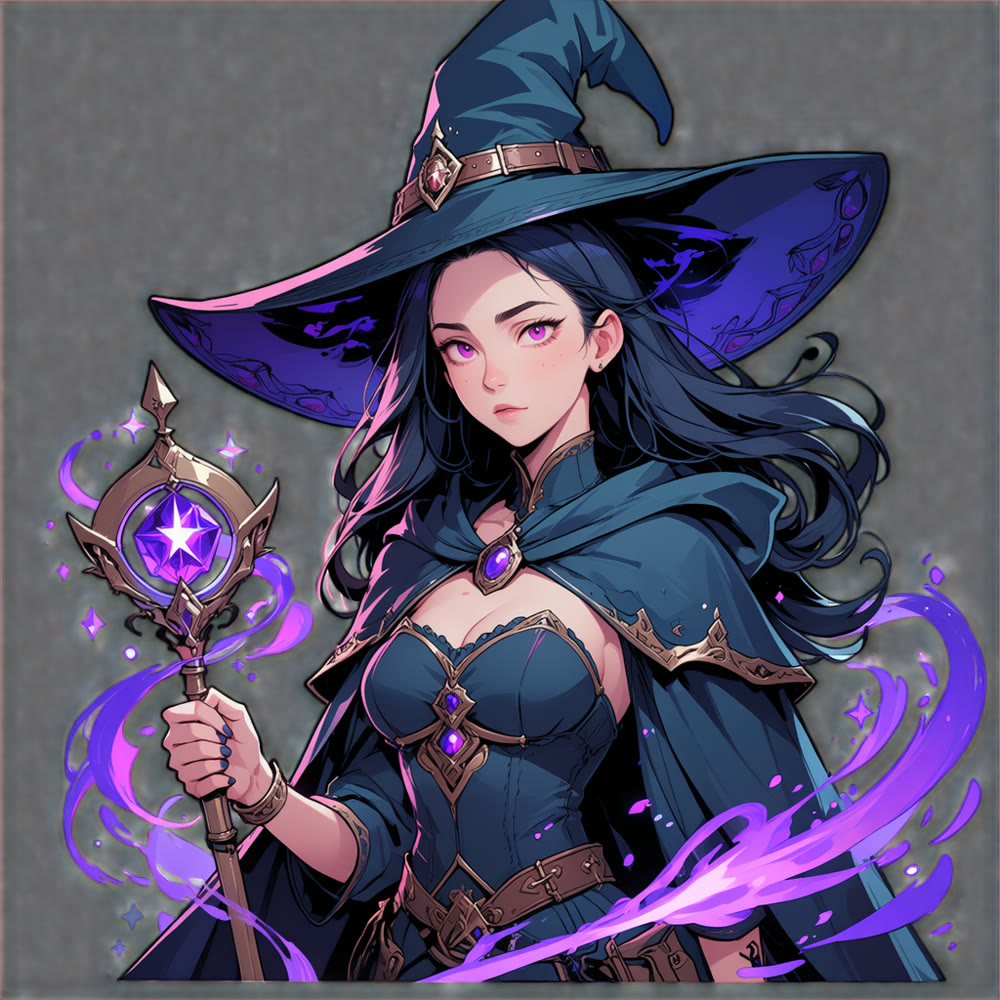
같은 조리법을 다른 피사체에 적용한 결과로, 모자와 지팡이까지 알파가 유지됩니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.