Krea 2 Turbo 3단계 Distill LoRA: 8단계 교사 모델보다 뛰어난 디테일
rank-64 LoRA가 Krea 2 Turbo를 cfg 1.0에서 8단계에서 3단계로 줄이며, 미세 텍스처가 교사 모델의 1.11배로 측정되었습니다. 기본 노드만으로 구성된 ComfyUI 워크플로도 함께 제공됩니다.
Krea 2 Turbo를 8단계에서 4단계로 줄이고 다시 2단계까지 내렸던 같은 작성자가 이제 그 사이를 메웠습니다. 이 어댑터는 모델을 3단계로 실행하며, 디노이징 속도가 약 2.6배 빨라집니다(1024x1024, float16, 텍스트 인코딩과 VAE 디코드 제외 기준 65.4초에서 24.9초로 단축). 동시에 작성자의 테스트 프롬프트 22개에서 미세 텍스처가 8단계 교사 모델의 1.11배로 측정되었으며, 4단계 어댑터는 1.04배였습니다. 기본 Turbo를 3단계로 돌리면 0.58배에 그치는데, 이 LoRA가 바로 그 격차를 메웁니다.
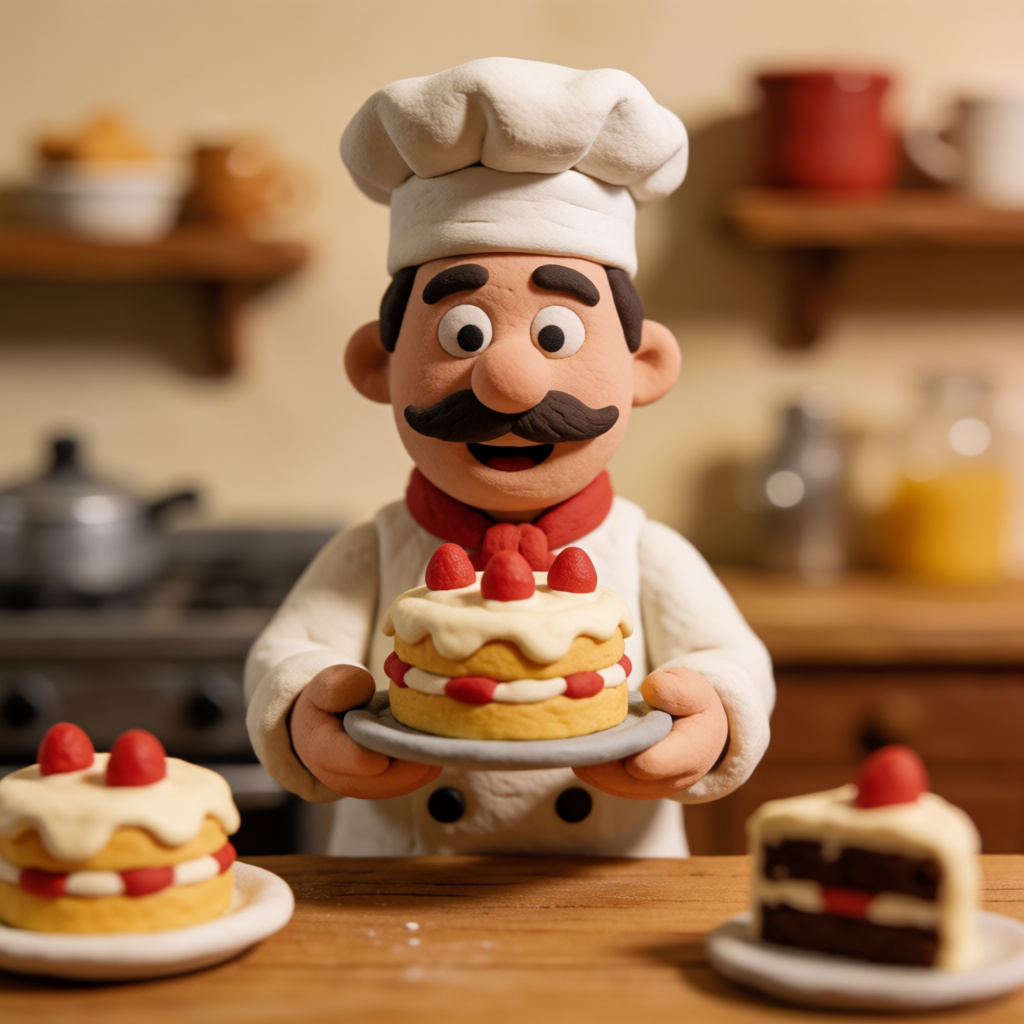 | 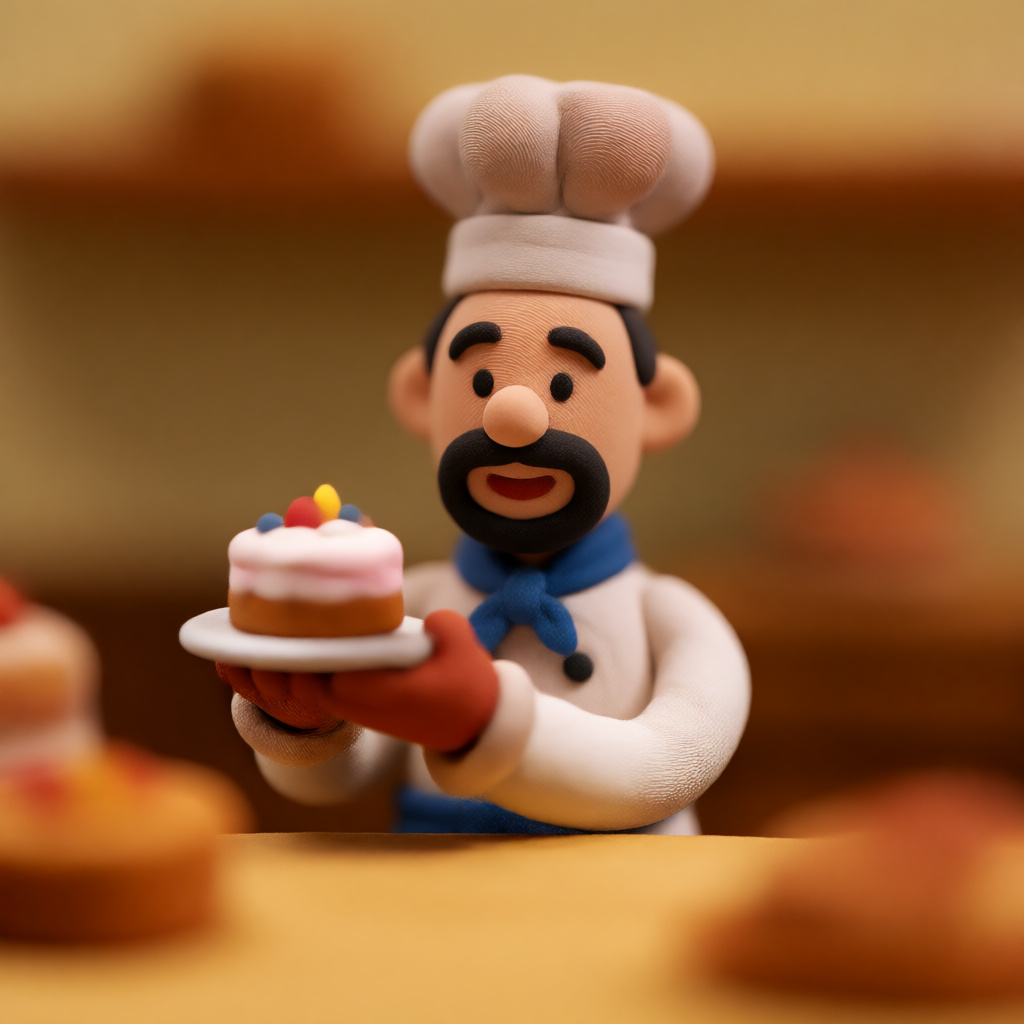 | 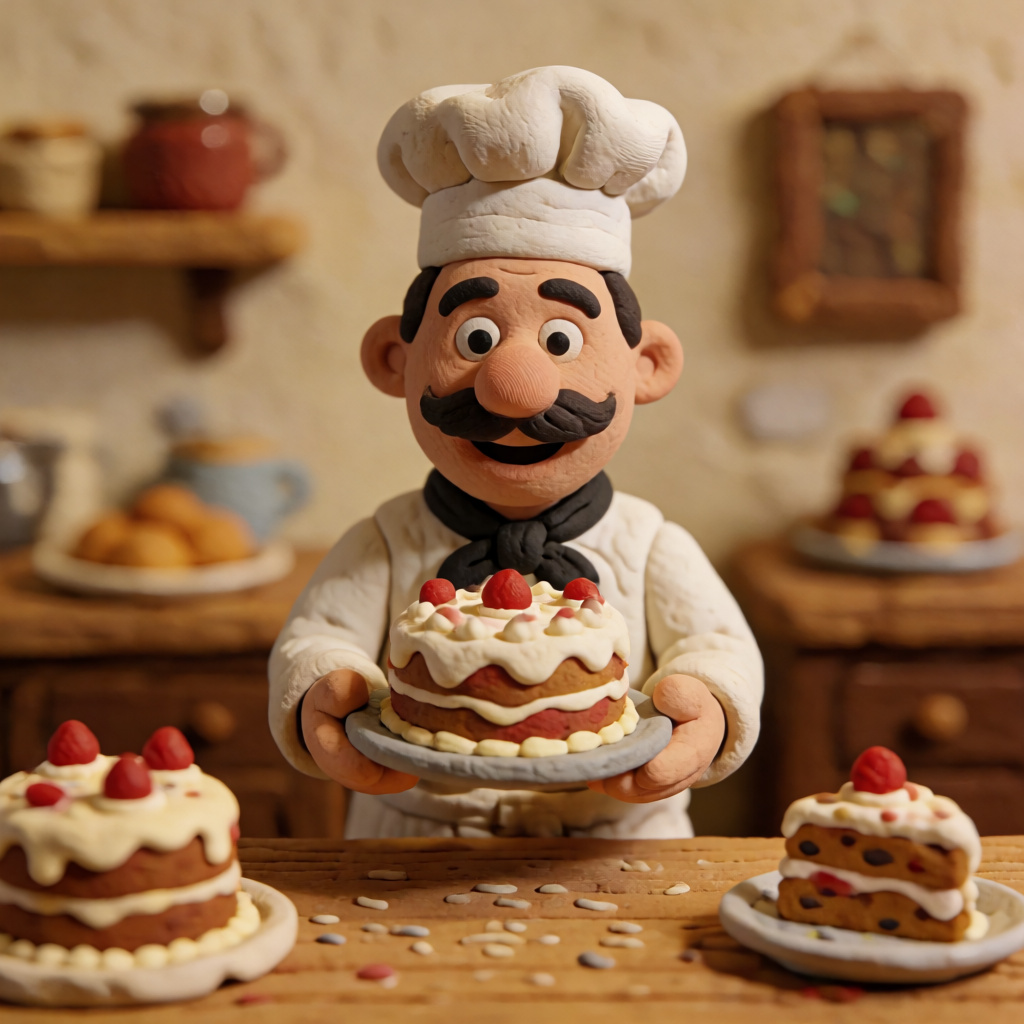 |
|---|---|---|
| Turbo 8단계: 품질 기준선 | LoRA 없이 3단계: 흐릿하고 평평함 | LoRA와 함께 3단계: 디테일 복원 |
이 프로젝트는 아직 학습 중입니다. 현재 공유된 체크포인트는 chk00030000으로, 마지막 600개 샘플에서 학습률을 0까지 어닐링한 안정된 가중치에서 가져온 것이며, 작성자는 추가 체크포인트를 예상하고 있습니다. 저장소의 두 가중치 파일은 diffusers와 ComfyUI 키 이름으로 같은 체크포인트를 담고 있습니다.
Turbo 자체 스케줄로 3단계 실행
학생 모델은 Turbo 자체의 3단계 시그마 [1.0, 0.8633, 0.6123]로 세 번의 호출을 수행하며, 모델의 표준 mu 값 1.15를 쓰고 가이드는 적용하지 않습니다. 학습은 공개된 4단계 어댑터의 가중치에서 시작해 그 형태를 유지했습니다. 즉 동일한 228개 모듈에 rank 64를 적용했습니다. 약 30,000개 샘플을 11개 해상도(512x768부터 1440x1440, 1824x1024까지)에서 기록된 교사 모델 궤적으로부터 추출했습니다.
이전 어댑터들과 다른 점이 두 가지 있습니다. 기본 모델을 단일 H100/H200에서 bf16으로 실행했습니다(4단계와 2단계 프로젝트는 가중치 전용 int8 기본 모델을 대상으로 RTX 3090 한 장에서 학습했습니다). 30,000개 샘플에 약 91시간이 걸렸습니다. 또한 목적 함수는 여전히 궤적 모방이 아니라 분포 매칭입니다. 학생 모델은 동결된 기본 모델 자체의 중간 네트워크 특징 위에 올라탄 8개의 크리틱으로 평가되며, 이들은 아티팩트, 실제 사진다움, 첫 호출의 레이아웃, 콘텐츠, 프롬프트 일치도, 레터링, 큰 얼굴, 그리고 세 번의 호출 전체 롤아웃을 다룹니다. 교사 모델의 정확한 경로가 아니라 교사 모델이 그럴듯하게 만들어낼 결과에 맞추는 것이, 3단계가 흐릿함과 이중 윤곽으로 평균화되는 것을 막아줍니다.
측정된 대역도 이와 일치합니다. 미세 텍스처는 교사 모델의 1.11배, 16픽셀과 8픽셀 대역은 각각 1.10배와 1.12배이며, 색상은 교사 모델과 같은 수준입니다.
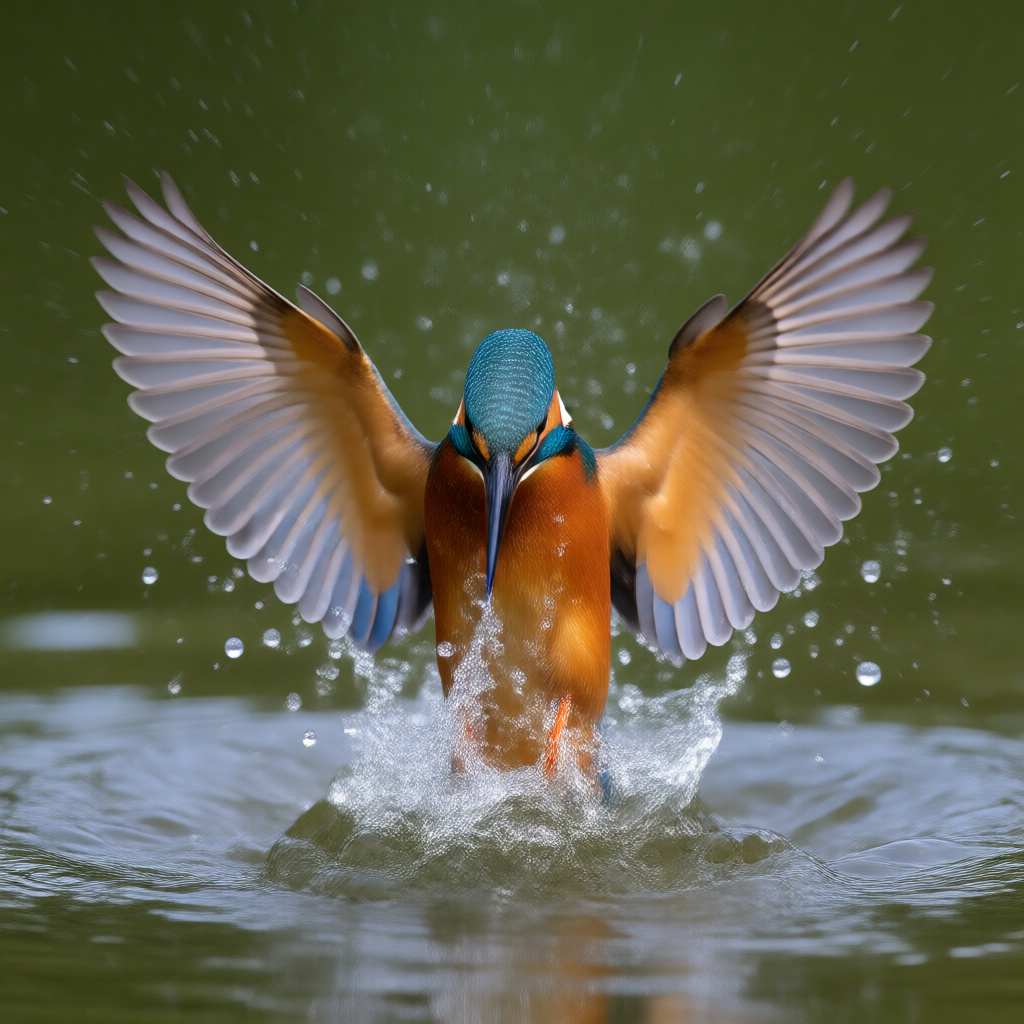
어댑터 없이 kingfisher 프롬프트로 3단계 실행한 Turbo. 같은 시드와 프롬프트로 LoRA를 적용한 결과가 커버 이미지입니다.
무엇을 내주고 얻는가
작성자는 얻는 것과 함께 비용도 공개했으며, 교체하기 전에 읽어볼 만합니다:
- 4단계 어댑터보다 교사 모델의 그림에서 더 멀어짐: 거리는 0.401 대 0.320, 디테일 일치도는 0.26 대 0.39입니다. 3단계는 같은 노이즈에서 출발하는 더 짧은 경로이므로, 같은 시드라도 8단계 렌더링과 구도, 자세, 작은 요소가 달라질 수 있습니다. 교사 모델의 이미지는 재현 대상이 아니라 품질 참조입니다.
- 교사 모델보다 강한 텍스처: 평평한 영역의 그레인이 교사 모델의 1.57배로, 이전 릴리스의 1.29배에서 올라갔습니다. 수채화 용지, 피부 모공, 필름 그레인이 더 뚜렷하게 보이며, strength를 1.0 아래로 낮추면 부드러워집니다.
- 희미한 이중 윤곽이 머리카락, 빗줄기, 가는 팔다리에서 나타나며, 768x1024와 1024x768에서 가장 많습니다. 고스팅 지수는 교사 모델의 1.14배로, 4단계 어댑터의 1.02배보다 높습니다.
- 군중 속 작은 얼굴은 모든 소수 단계 어댑터의 약점으로 남습니다.
유효한 LoRA strength 범위는 1.0 주변에서 좁습니다. 3단계에서는 거친 호출을 완성된 이미지로 바꾸는 작업 전체를 어댑터가 담당하기 때문입니다. 속도보다 교사 모델 자체 렌더링과의 근접성이 중요하다면 4단계 어댑터가 더 나은 도구입니다.
ComfyUI 사용법
저장소에는 ComfyUI 키 이름으로 저장된 krea2_turbo_3step_rank_64_lora_comfyui.safetensors와, 기본 노드만으로 구성된 워크플로 krea2_turbo_3step_lora_t2i.json이 포함되어 있습니다.
| 파일 | 넣을 위치 |
|---|---|
krea2_turbo_3step_rank_64_lora_comfyui.safetensors | ComfyUI/models/loras/ |
krea2_turbo_bf16.safetensors (Comfy-Org/Krea-2에서) | ComfyUI/models/diffusion_models/ |
qwen3vl_4b_bf16.safetensors (같은 저장소) | ComfyUI/models/text_encoders/ |
qwen_image_vae.safetensors (같은 저장소) | ComfyUI/models/vae/ |
설정: steps 3, cfg 1.0, 샘플러 euler / simple, LoRA strength 1.0.
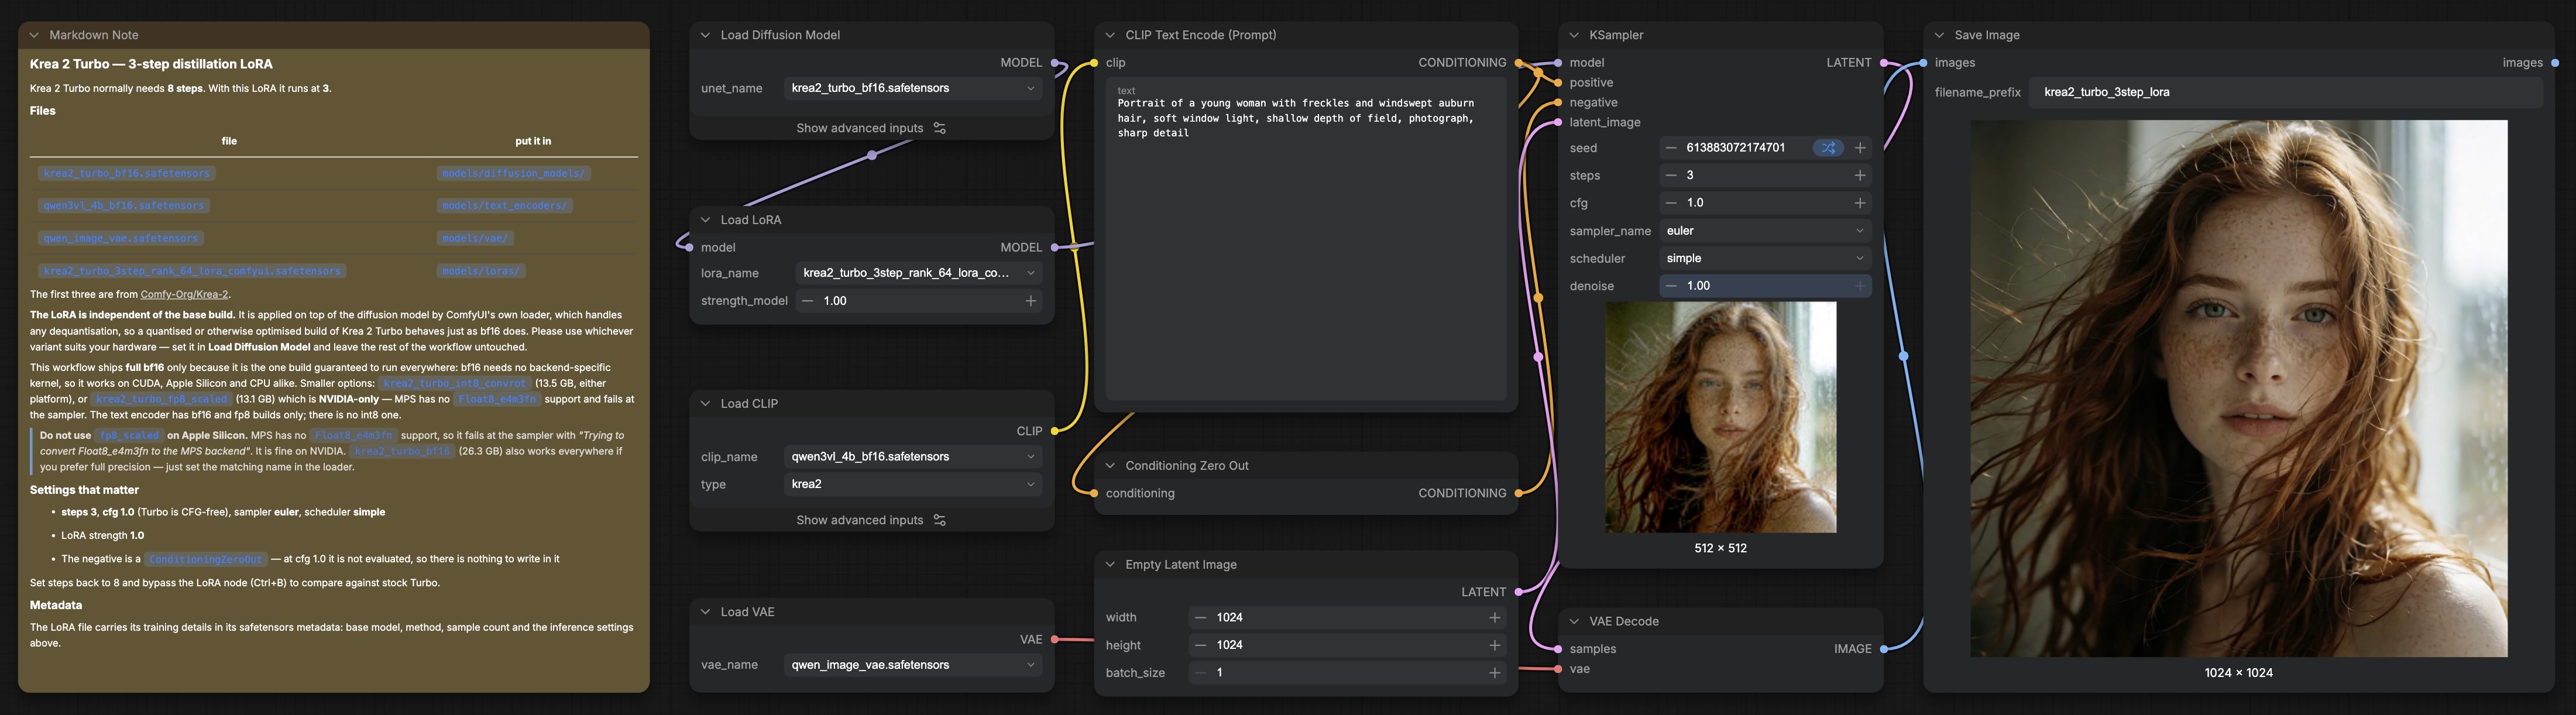
함께 제공되는 워크플로: Krea 2 Turbo에 3단계 LoRA를 더한 구성으로, 기본 노드만 사용합니다.
guidance_scale=0.0은 같은 설정을 diffusers 방식으로 표기한 것입니다.
모델 카드에서 온 주의 사항이 두 가지 있습니다. 양자화된 기본 모델은 메모리를 얻는 대신 디테일을 내줍니다. Comfy Cloud의 4비트(nvfp4) Turbo에서는 어댑터의 미세 텍스처가 완전한 bf16 렌더링보다 약 5분의 1 수준으로 측정되었습니다. 그리고 Apple Silicon에서는 fp8_scaled 빌드가 로드되지 않는데, MPS에 Float8_e4m3fn이 없기 때문입니다. 저장소에는 같은 LoRA를 작성자의 LVNodes Krea 2 MLX 노드로 실행하는 별도의 MLX 워크플로가 있습니다.
덤으로 아키텍처를 공유하는 Krea 2 Raw에서도 로드됩니다. Raw를 13단계, CFG 3.5로 실행하면 Raw의 구성을 유지하면서 해당 단계 수에서 Raw가 놓치는 디테일을 더해줍니다. 작성자는 이것이 학습되지 않은 영역이며 지원되는 모드가 아니라고 분명히 밝히고 있습니다.
제공 현황
- Hugging Face: lvladikov/Krea2-Turbo-Distill-3step-LoRA. 비교 시트 22장과 전체 학습 기록이
DETAILED-README.md에 있습니다. - 4단계 LoRA는 Turbo의 8단계 출력에 더 가까운 선택지로 남아 있고, 2단계 LoRA는 미리보기용 선택지입니다.
- 위의 모든 측정값은 작성자가 테스트 프롬프트 22개로 직접 측정한 것이며, 모델 카드에는 알려진 문제가 발생 빈도 순으로 정리되어 있습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.