Primal VAE: Flux latent 형태에 맞춘 2x 다운샘플링
Ostris가 Primal VAE를 공개했습니다. 약 8,000만 파라미터 규모의 오토인코더 두 종으로, 2배 다운샘플링만 수행하고 8배 patchify는 DiT에 맡기며, 스케일링 계수나 시프트 계수를 사용하지 않습니다.
2x1은 2배 다운샘플링해 1개 채널로, 2x2는 2개 채널로 만듭니다.
대부분의 최신 VAE는 이미지를 8배 압축한 뒤, 측정된 스케일링 계수나 시프트 계수, 또는 배치 정규화 통계로 다시 스케일링해야 하는 latent를 diffusion 모델에 넘깁니다. Primal VAE는 다른 길을 갑니다: VAE는 2배 공간 축소만 수행하고, 나머지 4배는 DiT 자체의 patchify 단계가 제공합니다. 2배 해상도의 1채널 latent를 4방향으로 patchify하면 8배 해상도에서 16채널이 되어 Flux.1 VAE가 만드는 것과 같은 형태가 됩니다. 2채널 변형은 8배 해상도에서 32채널이 되어 Flux.2 VAE 형태가 됩니다.
| 모델 | latent | patch 4 | 동일한 형태 |
|---|---|---|---|
2x1 | 1 ch @ 2x | 16 ch @ 8x | Flux.1 VAE (16 ch @ 8x) |
2x2 | 2 ch @ 2x | 32 ch @ 8x | Flux.2 VAE (32 ch @ 8x) |
두 체크포인트 모두 약 8,000만 파라미터이며, 이미지 변의 길이는 16의 배수여야 합니다.
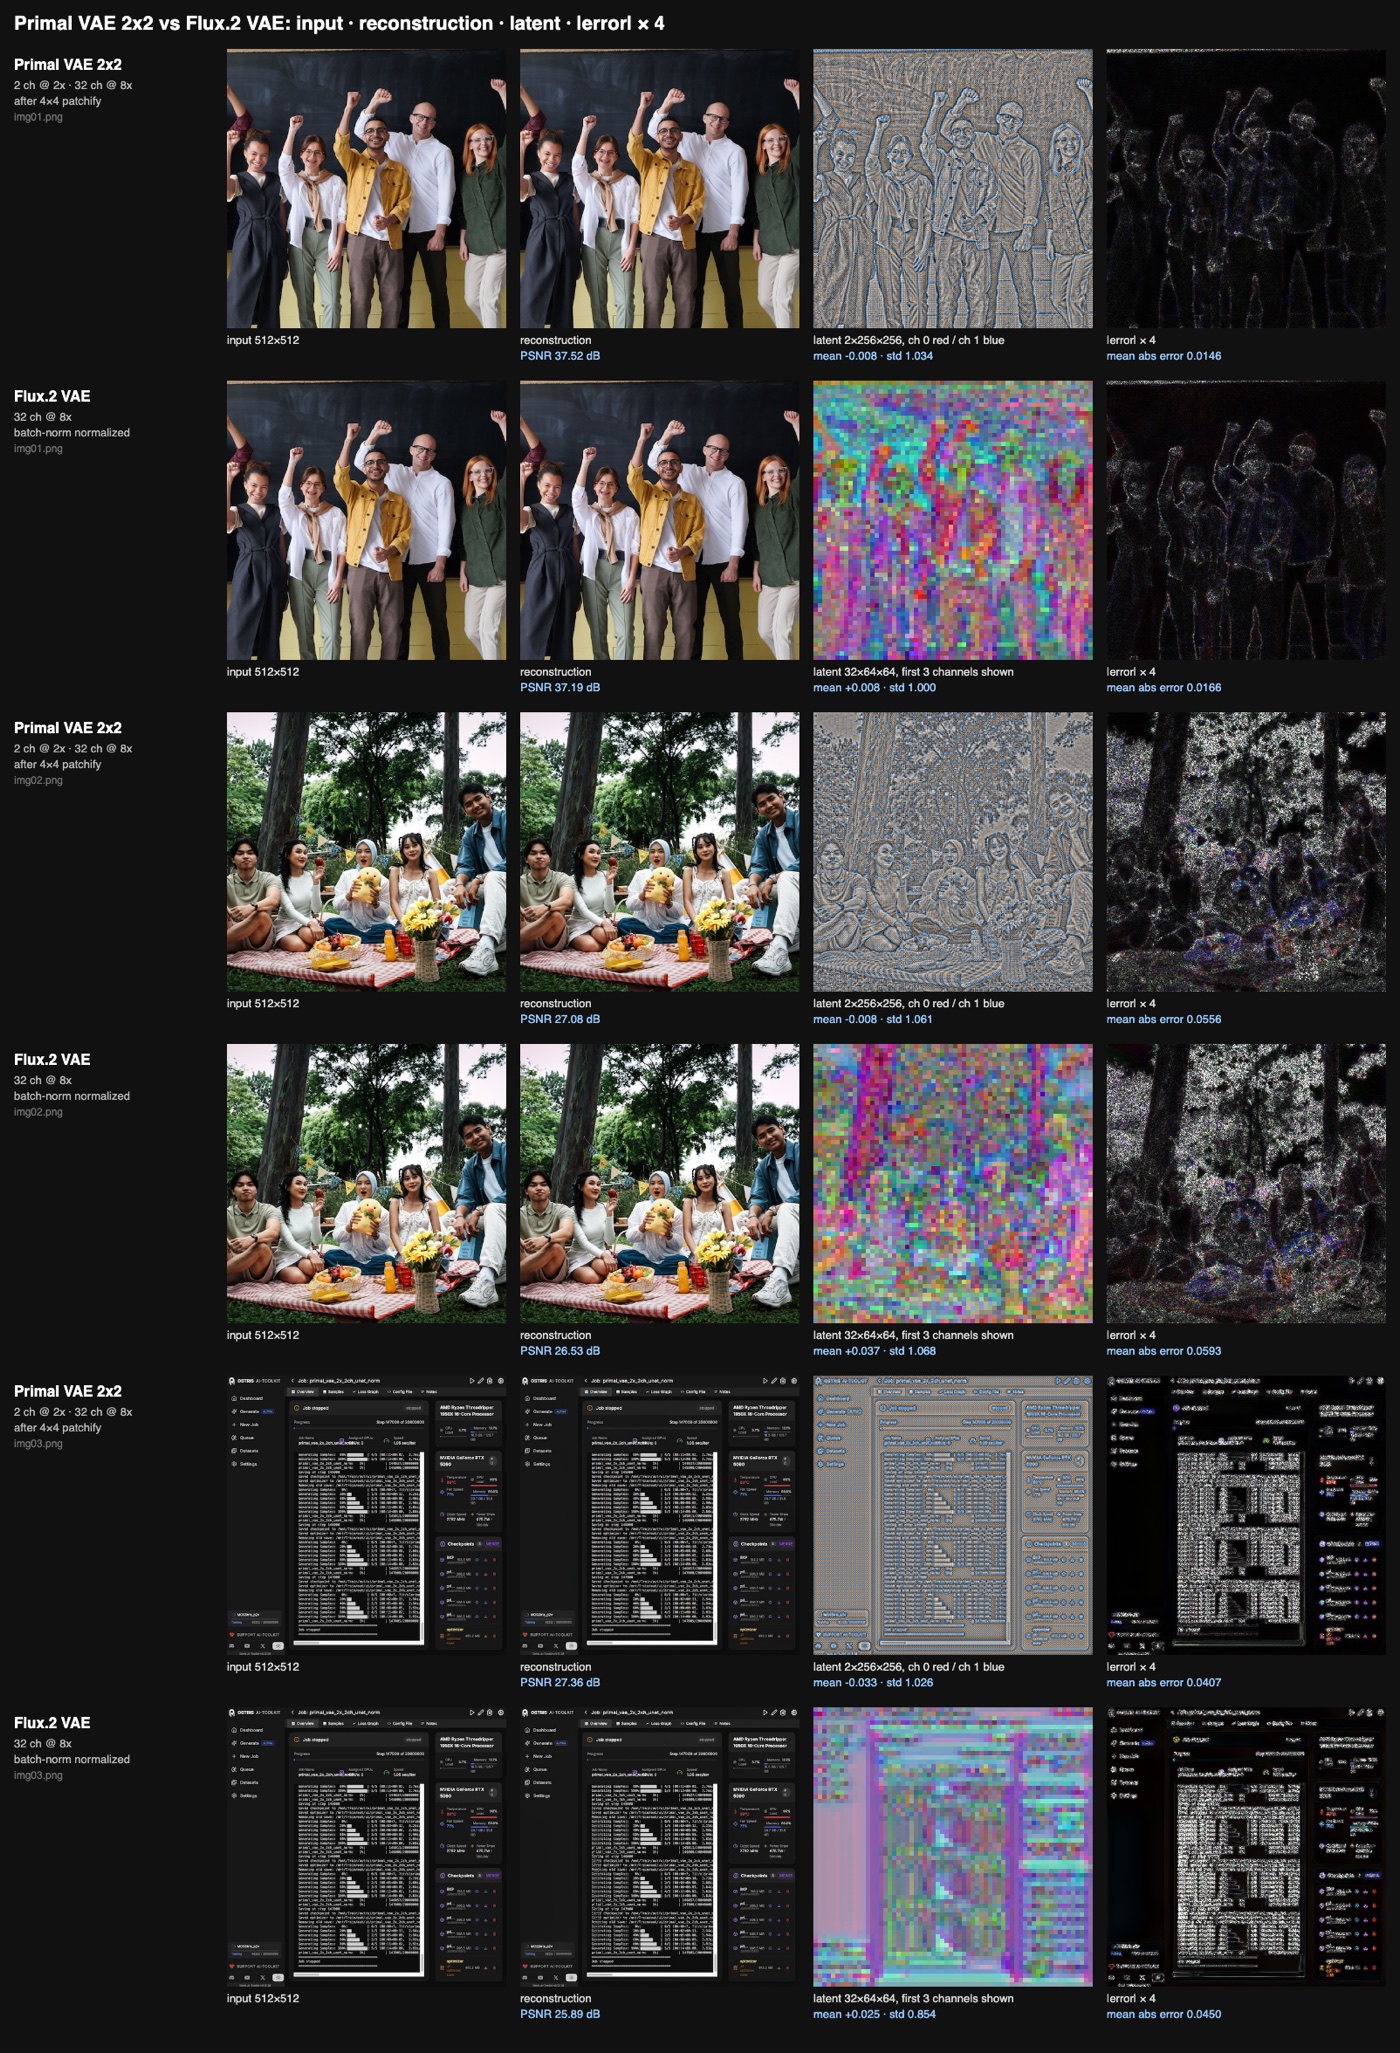
각 행은 입력, 재구성, latent, |error| x 4입니다. 모든 Primal VAE 행 아래에는 동일한 latent 레이아웃을 가진 Flux VAE가 같은 이미지로 놓입니다. latent는 3 시그마로 표시되며, 2채널 latent는 채널 0을 빨간색, 채널 1을 파란색으로 표현합니다.
저장소에 있는 512 px 이미지 세 장의 재구성 품질(dB):
| 이미지 | Primal 2x1 | Flux.1 VAE | Primal 2x2 | Flux.2 VAE |
|---|---|---|---|---|
| img01 (인물, 스튜디오) | 32.1 | 35.7 | 37.5 | 37.2 |
| img02 (피크닉, 나뭇잎) | 22.0 | 24.2 | 27.1 | 26.5 |
| img03 (UI 스크린샷) | 21.3 | 24.7 | 27.4 | 25.9 |
작성자는 세 장의 이미지와 PSNR은 벤치마크가 아니며, KL VAE는 사후 분포 노이즈 때문에 결정론적 VAE가 치르지 않는 재구성 비용을 치른다고 분명히 밝힙니다. 2x2 변형은 8x8 픽셀 블록당 32개 값이라는 동일한 정보 예산에서 Flux.2 VAE와 같거나 능가합니다. 2x1 변형은 텍스처가 많은 콘텐츠에서 Flux.1 VAE에 뒤처집니다: 2배 해상도의 1채널은 여유 없는 12:1 축소이며, 2x2 실행의 절반에도 못 미치는 학습 스텝(62k 대 147k)만 받았습니다.
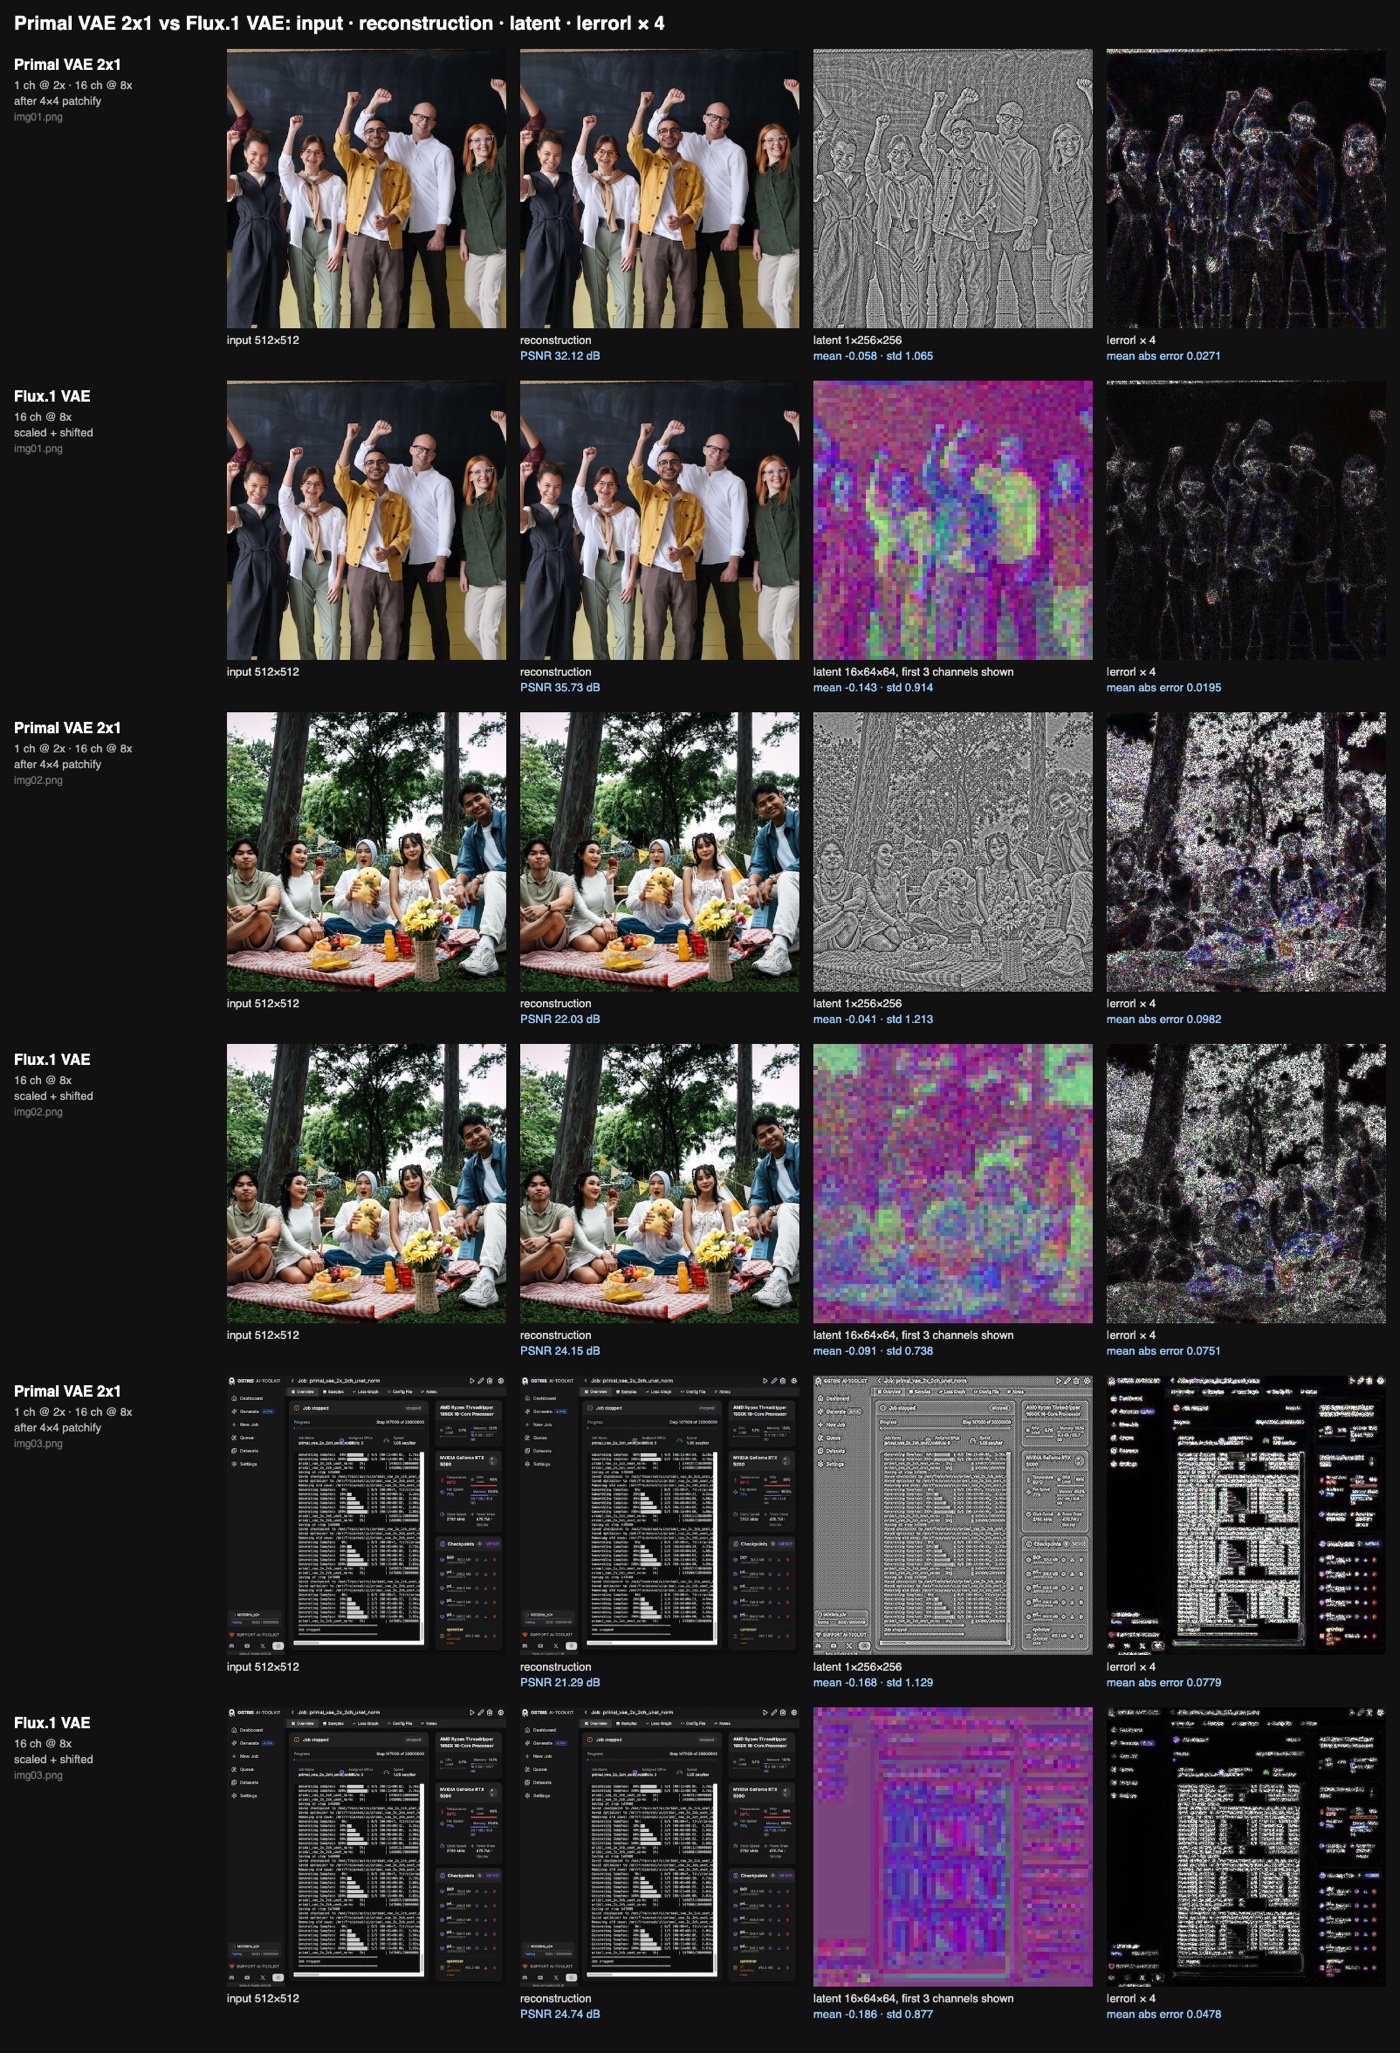
1채널 비교입니다. 단일 채널 latent는 회색으로 표시되며, 이미지별 표준편차는 여전히 1.07에서 1.21로 흔들리는데, 마지막 9k 스텝 동안에만 이미지별 정규화를 받았기 때문입니다.
아키텍처
두 변형은 동일한 네트워크이며 출력 채널만 다릅니다:
- 입력은
pixel_unshuffle(2)를 거치므로 RGB가 절반 해상도의 12채널이 됩니다. 모든 연산은 latent 해상도 이하에서 실행되어, latent가 이미지의 공간적으로 정직한 맵으로 유지됩니다. - 인코더와 디코더는 이미지 크기의 1/2, 1/4, 1/8, 1/16 네 단계, 너비 96 / 192 / 384 / 384, dilation이 1, 2, 4를 순환하는 잔차 블록으로 구성된 대칭 컨볼루션 U-Net입니다.
- 정규화는 각 위치에서 채널에 대한 RMSNorm입니다. 공간 통계도 어텐션도 없으므로, 타일은 약간의 겹침이 주어지면 전체 이미지와 동일하게 인코딩 및 디코딩됩니다.
- 인코더는 1 또는 2채널로 가는 단순한 3x3 컨볼루션으로 끝납니다. 사후 분포도, KL 항도, 양자화 컨볼루션도 없습니다.
latent를 노이즈와 정렬된 상태로 유지하기
diffusion 모델은 가우시안 노이즈에 대해 학습되므로, latent 역시 이미 가우시안 노이즈처럼 보여야 합니다. KL 항을 추가하고 나중에 스케일링 계수를 측정하는 대신, 통계를 인코더 출력에 대한 손실에 직접 반영합니다:
- 모멘트 손실:
mean^2 + (std - 1)^2에 가중치 0.1을 적용하며, 이미지별·채널별로 계산합니다. 따라서 데이터셋 평균이 아니라 모든 이미지가 평균 0, 표준편차 1로 나옵니다. - 가우시안 순서 통계 손실: 각 이미지와 채널의 latent 값을 정렬해 같은 크기의 표준 정규분포 기대 순서 통계와 매칭하며, Blom 근사를 사용합니다. 처음 두 모멘트가 아니라 분포 전체의 형태를 고정하므로, 단색 회색 이미지도 상수가 아닌 노이즈에 가까운 값으로 인코딩됩니다.
그 덕분에 스케일링 계수도, 시프트 계수도, latent 정규화도 함께 다닐 필요가 없으며, 인코딩은 분포 대신 일반 텐서를 반환합니다: encode는 .latent_dist도 샘플링 단계도 없이 [B, 1, H/2, W/2]를 반환합니다.
학습
재구성은 MAE 0.5와 LPIPS 1.0, 그리고 로그 크기 2D 스펙트럼에 대한 L1 항 0.1로 구성되며, 이 항은 정확한 위상을 요구하지 않고 고주파 에너지를 끌어올립니다. 그 위에 latent를 더 확산시키기 쉽게 만드는 여러 기법이 있습니다:
- EQ-VAE에서 가져온 latent 뒤집기와 회전: 스텝의 50%에서 latent를 뒤집거나 90도 회전하고, 동일하게 변환된 이미지에 대해 디코딩합니다. 따라서 latent는 임의의 코드가 아니라 이미지의 그림이어야 합니다.
- 노이즈가 섞인 디코드: 스텝의 20%에서 디코더가
z + sigma * noise를 받습니다.sigma는 이미지별로U(0, 0.5)에서 추출하며, 디코더는 여전히 깨끗한 이미지를 재구성해야 하므로 확산 오류를 견디는 법을 배웁니다. - 이미지의 5%는 임의의 단색으로 교체됩니다. 평탄한 영역이 이미지별 정규화된 latent에게는 어려운 경우이기 때문입니다.
- 2x1 변형은 마지막 9k 스텝을 critic과 함께 보냈습니다: 동결된 SigLIP2 NaFlex ViT가 실제 이미지와 재구성 이미지의 4, 8, 12번 레이어에서 원본 해상도의 패치 특징을 제공하고, 작은 스펙트럼 정규화 컨볼루션 헤드가 힌지 손실과 R1로 학습하며, 디코더는 가중치 0.1의 생성자 항을 받습니다. 2x2는 critic 없이 학습되었습니다.
공개된 가중치 파일은 변경되지 않은 학습 체크포인트이며 fp32입니다. 추론을 위해 torch_dtype=torch.bfloat16으로 로딩하면 약 0.05 dB의 손실이 발생합니다.
사용 가능성
Primal VAE는 아직 ComfyUI 내부에서 사용할 수 없습니다. 커스텀 VAE 로더 노드도, Comfy-Org 재패키징도, 코어 지원도 없습니다: 저장소는 trust_remote_code=True와 함께 diffusers AutoModel 구현(modeling_primal_vae.py 및 config.json)을 제공하며, 문서화된 경로는 AutoModel.from_pretrained("ostris/primal_vae", variant="2x1")에 이어 patchify / unpatchify로 Flux.1 또는 Flux.2 토큰 레이아웃에 도달하는 것입니다.
10월 31일에 열린 저장소 논의에서는 ComfyUI에서 실행할 수 있는지 직접 묻고 있으며, 아직 작동하는 답변은 없습니다. 별도의 커뮤니티 논의에서는 GPU 또는 CPU에서의 로컬 추론을 위한 단일 파일 Rust 빌드를 제공합니다.
그 외의 모든 것은 Python 영역에 남습니다: vae.encode(x)는 latent를 반환하고, vae.patchify(latent, compression=8)은 이를 Flux.1 형태 또는 Flux.2 형태의 토큰으로 바꾸며, vae.decode(vae.unpatchify(tokens))가 이를 되돌립니다. 어느 쪽에도 스케일링이나 시프트가 적용되지 않습니다. 아키텍처는 텐서 형태에서 읽어오므로, ai-toolkit에서 내보낸 파인튜닝은 weights_name="my_finetune.safetensors"로 로딩할 수 있습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.