Pika H3 Flex, MiniMax H3를 6단계 ComfyUI LoRA로 변환
Pika가 MiniMax H3를 포스트 학습해 6단계 모델 Pika H3 Flex로 만들었습니다. 두 개의 ComfyUI LoRA, 세 가지 공식 템플릿, 12개 참조 제어와 함께 제공됩니다.
Pika H3 Flex는 Pika가 MiniMax H3를 포스트 학습한 버전입니다. 동일한 33B 옴니 모델을 자체 오디오-비디오 코퍼스로 재학습하고, 50단계 teacher에서 6 샘플링 단계로 증류한 뒤 보상 학습과 선호 최적화로 다듬었습니다. Pika는 가중치를 Hugging Face에 공개하고 추론 패키지를 GitHub에 오픈소스로 공개했으며, 2026년 10월 29일 기술 문서와 출시 포스트를 함께 게시했습니다.
ComfyUI에서 중요한 점은 Flex가 새로운 아키텍처가 아니라는 것입니다. 네이티브 MiniMax H3 모듈 레이아웃을 그대로 따르는 두 개의 LoRA 어댑터로 제공되므로, 이미 보유한 H3 베이스 위에 기본 LoraLoaderModelOnly 노드로 로드할 수 있으며, 템플릿 라이브러리에 세 가지 공식 템플릿 워크플로가 포함되어 있습니다.
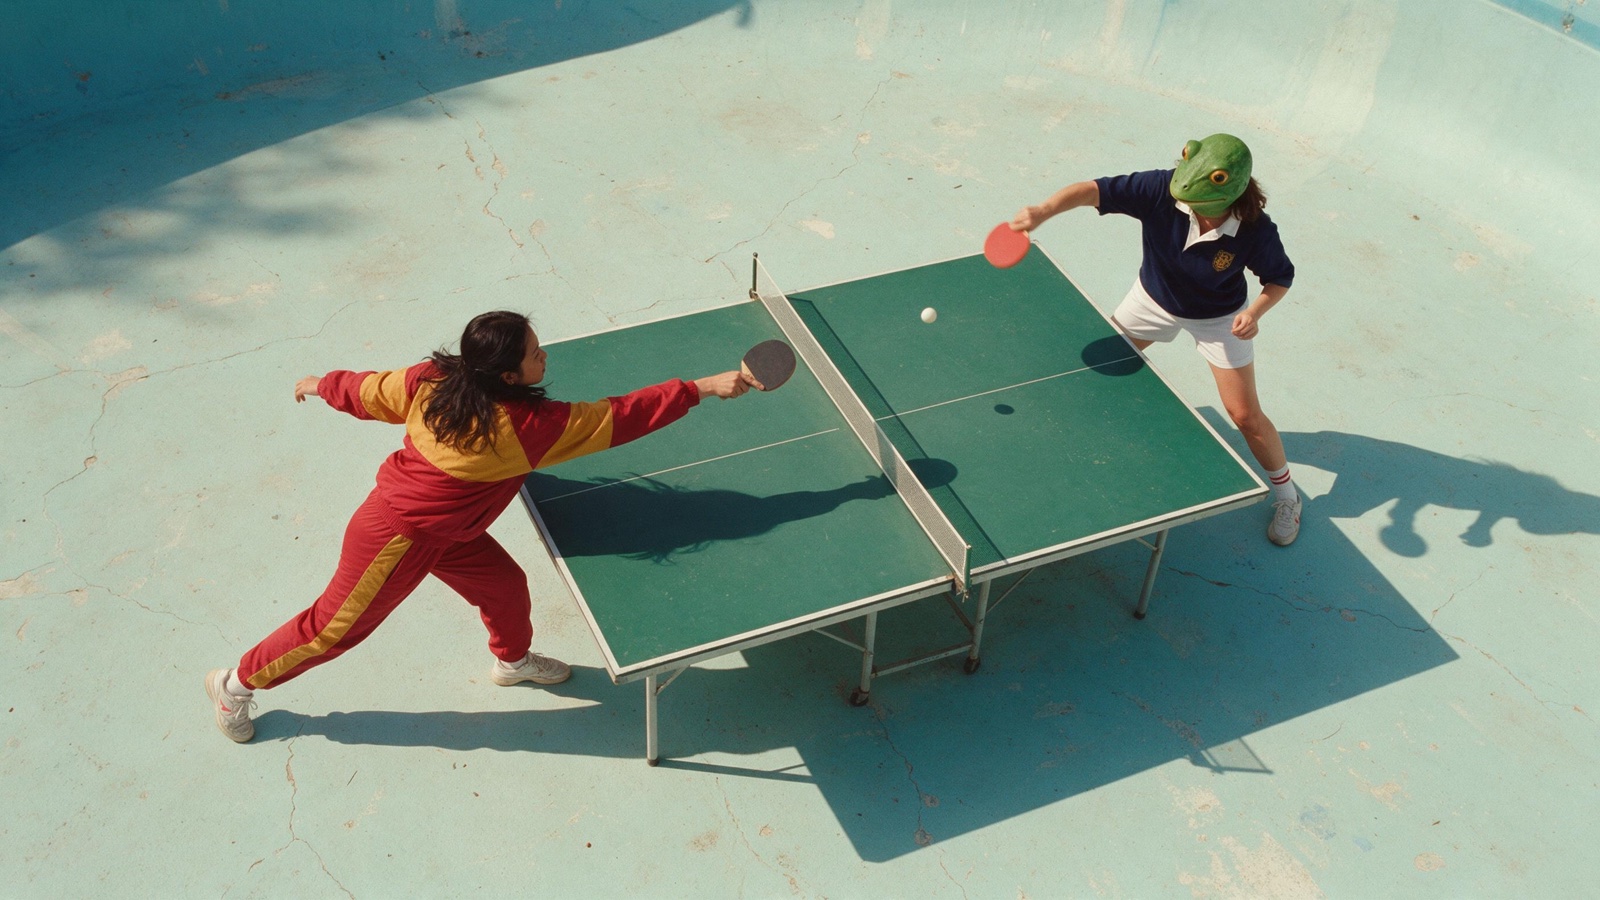 | 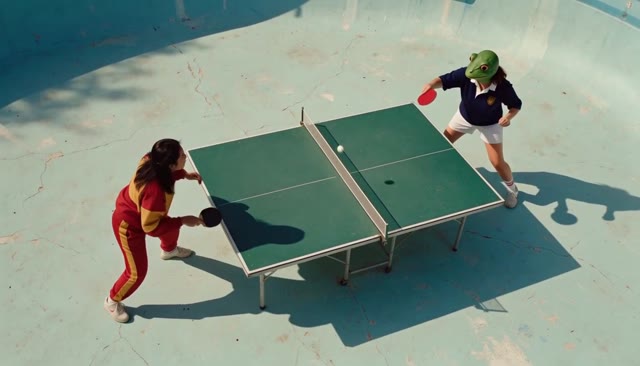 |
|---|---|
| 첫 프레임 참조 | 6단계 출력의 한 프레임 |
탁구 데모: 스틸 이미지 한 장을 입력하고, 프롬프트로 15초 테이크 안에 다섯 가지 카메라 무브(오버헤드, 크레인 다운, 휩 팬, 180도 오빗, 로 돌리)를 요청합니다. 출처: Pika H3 Flex 모델 카드
생성된 사운드트랙이 포함된 전체 카메라 랠리 클립으로, 모델 저장소에 있는 Pika의 쇼케이스 세트에서 가져왔습니다.
두 개의 어댑터, 하나의 6단계 스케줄
Flex는 H3의 두 조건화 경로를 베이스 모델의 분리 방식과 동일하게 별도 어댑터로 나눕니다.
| 어댑터 | 조건화 대상 | 작업 |
|---|---|---|
| FL2VA | 텍스트, 선택적으로 첫 프레임 및/또는 마지막 프레임 | 텍스트 투 비디오(T2V), 첫 프레임(I2V), 마지막 프레임, 첫 프레임과 마지막 프레임 |
| Ref2VA | 텍스트, 순서가 지정된 이미지, 비디오, 오디오 참조 | 참조 투 비디오, 모션 전이, 캐릭터 교체, 참조 기반 편집 |
Ref2VA는 최대 이미지 9개, 비디오 3개, 독립 오디오 클립 3개, 즉 총 12개의 참조 파일을 받으며, 최소 한 개의 이미지 또는 비디오가 필요합니다. 각 참조 비디오와 독립 오디오 클립은 2~15초 길이여야 하고, 이 두 그룹 각각의 합산 길이는 15초로 제한됩니다. 비디오에 포함된 사운드트랙은 해당 비디오에 그대로 속하며 별도 오디오 파일로 계산되지 않습니다.
출력은 11가지 화면 비율에 걸쳐 네이티브 480p 또는 768p, 24 fps이며, 32 kHz 스테레오 오디오가 파일에 믹스되고, 요청 길이는 5~15초입니다. H3의 프레임 그리드가 이를 올림 처리하므로 5초 요청은 124 프레임, 15초 요청은 362 프레임을 반환합니다.
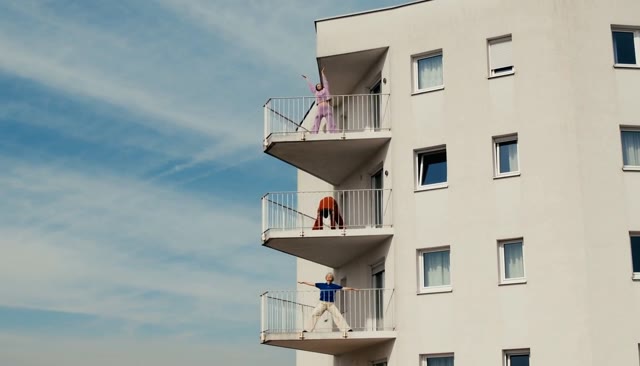
하나의 프롬프트로 층층이 쌓인 발코니 위의 서로 다른 세 인물을 오빗, 푸시인, 수직 붐, 리버스 오빗으로 컷 없이 연출합니다.
ComfyUI 릴리스
세 가지 템플릿이 ComfyUI 템플릿 라이브러리의 Video 항목에 포함되어 있습니다: video_pika_h3_flex_t2v.json, video_pika_h3_flex_fl2va.json, video_pika_h3_flex_ref2va.json이며, 모두 ComfyUI 튜토리얼 페이지에 문서화되어 있습니다. 각 템플릿은 pruned int8 H3 diffusion 모델을 해당 어댑터와 짝지어 Pika가 공개한 스케줄을 실행합니다: ManualSigmas와 BasicGuider를 통한 CFG 1.0의 LCM 샘플러를 사용하며 어댑터 강도는 1.0으로 고정됩니다.
템플릿을 로드하지 않고 직접 그래프를 구성한다면 두 가지 세부 정보가 중요합니다.
- 시그마 그리드는 checkpoint 계약의 일부입니다. Pika의 매니페스트에는 노트
1000/750/500/250/100/40/0, 비디오 시프트 12, 오디오 시프트 3, 그리고 새로운 중간 노이즈가 나열되어 있습니다. 일반 샘플러에서 6단계를 고르는 것만으로는 이 계약을 재현할 수 없습니다. - 두 번째 가속 LoRA를 중첩하지 마세요. 어댑터는 이미 6단계로 증류되어 있으며, 튜토리얼은 위에 turbo나 Lightning LoRA를 추가하면 출력이 깨진다고 명시합니다.
커넥터는 새로운 checkpoint가 아닌 일반적인 BF16 변환본입니다. 일반 모듈은 rank 128을 유지하지만, 융합된 Q/K/V 프로젝션은 rank 384로 병합되었고, 변환 과정에서 SwiGLU 절반의 순서를 네이티브 H3 레이아웃에 맞게 재배치했습니다. Pika 자체 어댑터 readme는 파일 무결성과 tensor 변환은 검증했지만 업로드 과정에서 ComfyUI 엔드투엔드 렌더는 검증하지 않았다고 분명히 밝히고 있습니다. 참조 추론 패키지와 다소 차이가 있을 수 있습니다.
#pika-h3-flex-early의 초기 체험 보고서도 이에 부합합니다. 테스터 NebSH는 6단계 960x544 패스를 잠재 데이터 업스케일과 4단계 1920x1088 패스에 연결해 2560x1440 결과물을 3분 17초에 얻었으며, WAS는 4단계에서 멀리 있는 새 같은 고주파 디테일에 팝핑 현상이 나타난다고 검토 대상으로 표시하며 6단계를 유지할 것을 권했습니다.
Pika가 6단계에 도달한 방법
기술 심층 분석은 공개된 가이드 증류 H3 위에 세 단계의 포스트 학습을 설명합니다.
- 지도 미세 조정: 생성과 편집 작업을 아우르며 미학적으로 선별된 자체 오디오-비디오 데이터셋으로 학습하며, 여전히 teacher의 50단계를 사용합니다.
- Projected Distribution Matching Distillation(PDMD, Wang et al. 2026)으로 샘플링을 50단계에서 6단계로 줄입니다. Pika는 자사 실행에서 표준 DMD가 불안정했고 PDMD가 더 안정적으로 학습되며 출력 품질도 더 좋았다고 보고합니다.
- 증류 후 보상 학습: ReFL(미학과 선명도)과 DPO(지시 준수, 사실성, 시각적 품질)를 각각 별도 LoRA로 학습한 뒤 하나의 어댑터로 병합하여, 결합된 동작이 추가 샘플링 단계를 요구하지 않도록 했습니다.
나머지는 별도의 서빙 스택이 처리합니다: 타임스텝에 따라 캐시되는 AdaLN 프로젝션, 융합 커널, FlashAttention-4, 압축 통신을 사용하는 블록 희소 어텐션입니다. 8개의 B300 GPU에서 5초 768p 오디오 포함 기준, 전체 추론이 3.409초에서 2.129초로 단축되어 1.60배 속도 향상을 얻었으며 checkpoint와 6단계 스케줄은 고정했습니다.
숫자가 말해주는 것과 말해주지 않는 것
Pika는 동일한 프롬프트 세트로 768p에서 공식 MiniMax H3, Fal H3 Max, HeyGen Video(품질)와 Flex를 비교 평가했고, 다섯 가지 시각 및 오디오 품질 지표 모두에서 가장 높은 점수를 보고합니다.
| 지표 | Pika H3 Flex | MiniMax H3 | Fal H3 Max |
|---|---|---|---|
| 비디오 기술 품질 | 12.3 | 11.7 | 10.6 |
| 비디오 미학 | 5.41 | 5.28 | 5.00 |
| 오디오 미학 | 7.02 | 6.85 | 6.89 |
| 오디오-비디오 정렬 | 0.212 | 0.208 | 0.216 |
오디오-비디오 및 텍스트-비디오 정렬은 비교 대상과 대체로 비슷한 수준이며, 수치는 Pika 자체 평가입니다. Pika의 블라인드 페어와이즈 연구에서 Flex는 텍스트 및 이미지 조건화 생성에서 인체 해부, 복잡한 구도, 오디오 동기화에서 앞서고, 참조 조건화 생성에서는 시각적 스타일, 프레이밍, 카메라 무브에서 앞섭니다. Pika는 또한 물리, 다중 장면 서사, 조명과 재질, 액션이 많은 참조 작업에서는 다른 시스템이 여전히 선호된다고 밝힙니다.
지금까지의 커뮤니티 A/B는 규모가 작지만, 공짜 점심이라기보다는 쓸 만한 6단계 모델이라는 점과 일관됩니다. Kijai는 동일한 T2V 예제 프롬프트를 DMAD와 Flex로 각각 6단계씩 실행해 DMAD가 해당 사례에서 실패했다고 보고했고, djbfilmz는 6단계 Flex와 어댑터 없이 20단계로 실행한 결과를 비교하며 Flex로 반복 작업을 하고 최종본은 20단계 전체 렌더로 뽑겠다고 말했습니다. 튜토리얼 자체의 주장은 단일 카드에서 약 1분에 5초 1344x768 클립을 만드는 것입니다.
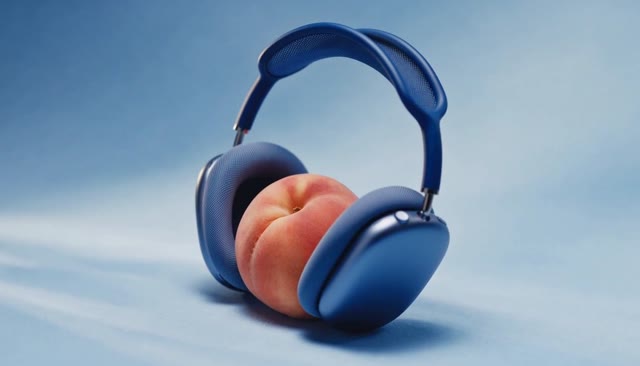 |  |
|---|---|
| 멀티 숏 제품 필름 | 캐릭터 및 환경 참조와 모션 클립 |
쇼케이스 사례 두 가지: 제품 참조 하나로 만든 9숏 광고, 그리고 안무는 비디오에서 가져오고 정체성과 스타일은 스틸 이미지 두 장에서 가져오는 모션 전이입니다.
사용 가능 여부
저장소에는 Pika 추론 패키지용 FP32 어댑터 두 개(fl2va/adapter.safetensors, ref2va/adapter.safetensors, 각 2.77 GB), comfy/loras/ 아래의 BF16 ComfyUI 변환본(각 1.96 GB), 그리고 Pika에 따르면 총 약 210 GB인 Diffusers 형식 H3 베이스 구성 요소가 있습니다. 각 ComfyUI 템플릿은 필요한 transformer 파티션만 로드합니다.
Pika의 호스팅 확장 프로그램은 다운로드 범위에 포함되지 않습니다: 768p 초안에서의 1080p, 2K, 4K 업샘플링, 다섯 개의 분리 오디오 스템(대사, 스코어, SFX, 폴리, 앰비언스), 프롬프트 향상, 가속 서빙 스택은 모두 API 기능입니다. 로컬 오픈 가중치 추론은 480p와 768p를 지원합니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.