Qwen-Image 2.1을 2스텝으로: CFG 1에서 동작하는 DMD2 LoRA
DMD2 증류 LoRA로 Qwen-Image 2.1의 텍스트 기반 이미지 생성과 다중 참조 편집을 CFG 1에서 2스텝으로 실행합니다. 라이브 Space 데모와 Banodoco 테스트 보고서도 확인할 수 있습니다.
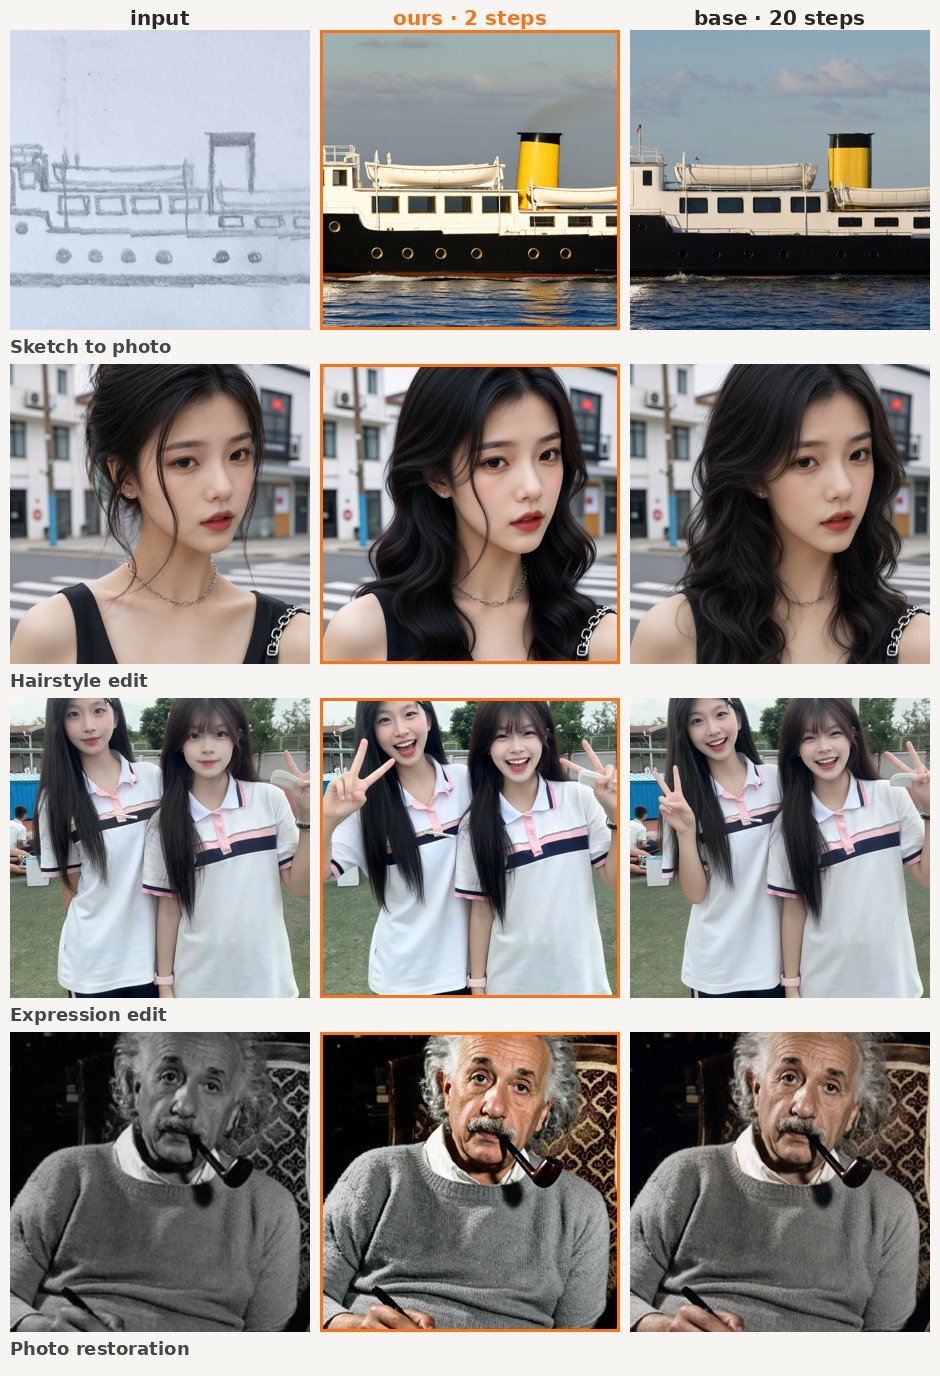
스케치에서 사진으로, 헤어스타일, 표정, 사진 복원. 입력, 프롬프트, 시드는 동일합니다. 각 행은 입력, 2스텝 LoRA, 20스텝 베이스 모델 순서입니다.
2스텝이 다른 단계인 이유
Qwen-Image 2.1은 40스텝으로 출시되었고, 지금까지 공개된 가속 모델은 8스텝(Alibaba 자체 Turbo checkpoint)과 4스텝(LightX2V의 Lightning LoRA)입니다. 이 어댑터는 그 범위의 하한을 목표로 하며, 스케줄은 권장 사항이 아니라 고정입니다:
| 설정 | 값 |
|---|---|
| 스텝 | 2 |
| 시그마 스케줄 | [1.0, 0.5], 고정 |
| CFG | 1 (true_cfg_scale=1.0) |
| LoRA rank / 알파 | 32 / 32 |
| 적용 모듈 | 어텐션만: to_q, to_k, to_v, to_out.0 |
| 파일 크기 | 64 MB (256 텐서) |
카드에는 이 LoRA가 바로 그 시그마 쌍으로 학습되었다고 명시되어 있어, 스케줄러를 use_dynamic_shifting=False와 shift=1.0으로 고정해야 합니다. 동적 시프팅을 켜두면 해상도별로 시그마가 재조정되어, 어댑터가 증류된 경로로 더 이상 샘플링하지 않게 됩니다.
어텐션만 적용한 것도 의도된 선택입니다. 카드에 따르면 이 방식은 피드포워드 블록까지 적용하는 것보다 편집 시 입력 이미지를 더 충실히 보존하며, 이 모델을 위한 이전의 몇 스텝 어댑터들은 대부분의 예산을 피드포워드 블록에 썼습니다.
학습 방식
DMD2(Distribution Matching Distillation)를 on-policy 분포 매칭과 티처 CFG 가이드로 학습했으며, 목적 함수에 회귀 손실과 GAN 손실은 없습니다. 학습은 단일 H100에서 약 1 MP의 다양한 종횡비 크롭으로 2,000스텝 진행되었고, 이는 데모가 사용하는 해상도 범위와 일치합니다. 카드가 비교 기준으로 삼는 20스텝 티처는 모델의 기본값인 40스텝이 아닙니다.
2스텝에서 유지되는 것
편집과 다중 참조 구성 모두 계속 동작합니다. Qwen-Image 2.1은 조건 이미지 목록을 받고 프롬프트는 이를 위치로 참조하므로, 2스텝 실행에서도 "Picture 1의 고양이를 Picture 2의 해변에 배치" 같은 프롬프트가 단일 참조로 붕괴되지 않고 해석됩니다:
image = pipe(
    prompt="Place the cat from Picture 1 on the beach from Picture 2.",
    image=[cat, beach],
    num_inference_steps=2,
    sigmas=[1.0, 0.5],
    true_cfg_scale=1.0,
).images[0]
텍스트에서 이미지로 생성은 image 인자만 빼면 동일한 호출입니다. 알파 채널은 어댑터가 아니라 베이스 모델에서 오기 때문에 RGBA 출력은 변경되지 않습니다.
작성자의 데모 Space인 Qwen Image 2.1 Realtime은 동일한 스케줄을 라이브 인터페이스로 제공합니다. 실시간 모드는 프롬프트가 바뀔 때마다 갱신되는 512px 결과를 스트리밍하고, 전체 품질 모드는 1024와 1536으로 전환됩니다.
커뮤니티 실행 결과
Banodoco #qwen-image 채널에서 테스터들은 네이티브 Qwen-Image 2.1 노드 위에 이 어댑터를 올려 ComfyUI에서 실행하고 스텝 비교 결과를 게시했습니다. RuneX는 2스텝 헤드 스왑이 동작하며 1스텝을 추가하면 약간 더 좋아진다고 보고했고, 이는 Euler, ER-SDE, LCM 샘플러 전반에서 나타났습니다. patientx는 2, 3, 4스텝을 연속으로 측정해 3스텝은 "실제 결과에 매우 가깝다", 4스텝은 사용 가능, 8스텝은 퇴보라고 평가했으며, 모델 로딩이 대부분을 차지하기 때문에 총 실행 시간은 2스텝과 4스텝 사이에서 거의 변하지 않았습니다.
ComfyUI에서의 유일한 걸림돌은 이름 지정입니다. safetensors는 diffusers/PEFT 형식으로 저장되어 transformer.transformer_blocks.N.attn.to_q.lora.down.weight와 이에 대응하는 .lora.up 텐서를 사용하는 반면, ComfyUI 로더는 transformer_blocks.N부터 시작하는 모델 자체 파라미터 이름으로 키를 매핑합니다. 로더가 매핑하기 전에 앞의 transformer.를 제거해야 하며, 그렇지 않으면 키가 매핑되지 않았다고 보고하고 LoRA는 아무 효과도 없습니다.
사용 가능 여부
LoRA 가중치: Hugging Face의 linoyts/Qwen-Image-2.1-DMD2-2steps. 베이스 모델: Qwen/Qwen-Image-2.1. 데모: Qwen Image 2.1 Realtime.
댓글
GitHub로 로그인하고 토론에 참여하세요.