Hy-Nomas: Tencent Hunyuan의 인터랙티브 월드 모델
Tencent Hunyuan이 텍스트와 카메라 제어로 720p 영상을 생성하는 8단계 인터랙티브 월드 모델 Hy-Nomas를 공개했습니다. ComfyUI 포트도 이미 나와 있습니다.
Hy-Nomas는 Tencent Hunyuan의 인터랙티브 월드 모델입니다. 세계를 설명하면 모델이 계속 생성하는 동안 텍스트 지침과 카메라 무브로 계속 조종할 수 있습니다. 팀은 2026년 10월 21일 가중치, 추론 코드, 학습 및 데이터 주석 코드를 공개했으며(tencent/Hy-Nomas | GitHub), 온라인 데모와 전용 벤치마크도 함께 내놓았습니다. ComfyUI용 커뮤니티 포트는 하루 뒤에 등장했습니다.
이 릴리스는 아직 카운터에서 초기 단계입니다. 작성 시점 기준 Hugging Face 좋아요 21개, GitHub 스타 21개입니다. 아래 내용은 모두 모델 카드, 저장소, 공식 갤러리에서 나온 것이며 서드파티 테스트 결과가 아닙니다.
하나의 세계, 세그먼트 단위로 생성
Hy-Nomas는 프레임이 아니라 비디오 세그먼트 단위로 오토리그레시브하게 동작합니다. 각 세그먼트는 모델의 압축된 잠재 공간에서 가우시안 노이즈로부터 디노이즈되며, 그 이전에 생성된 모든 세그먼트의 키/값 캐시에 어텐션합니다. 현재 턴의 프롬프트, 카메라 궤적, 그리고 해당 캐시가 유일한 입력이며, 세그먼트 간 어텐션이 인과적이므로 세그먼트를 생성할 때 미래 세그먼트가 필요하지 않습니다.
증류된 구성은 텍스트 및 카메라 가이드 1.0에서 Euler ODE 솔버로 8번의 디노이징 단계를 실행하고 24 FPS로 720 × 1280을 출력합니다. 세그먼트 길이는 프롬프트 파일에서 결정됩니다. JSON 요청에는 시작 및 종료 타임스탬프가 있는 segments, 도입부를 위한 visual_description_long, 이후 각 턴을 위한 description_change, 그리고 자체 타임스탬프가 있는 contained_actions가 나열됩니다. inference.video_length=event를 설정하면 해당 이벤트 시간에서 세그먼트 길이를 도출합니다.
공식 갤러리는 더 긴 실행에서 이것이 어떻게 작동하는지 보여줍니다. 다음은 12초짜리 텍스트 전용 턴 5개로 구성된 60초 클립 clockwork-flight이며, CG 스타일에 3인칭 추적 카메라를 사용했습니다.
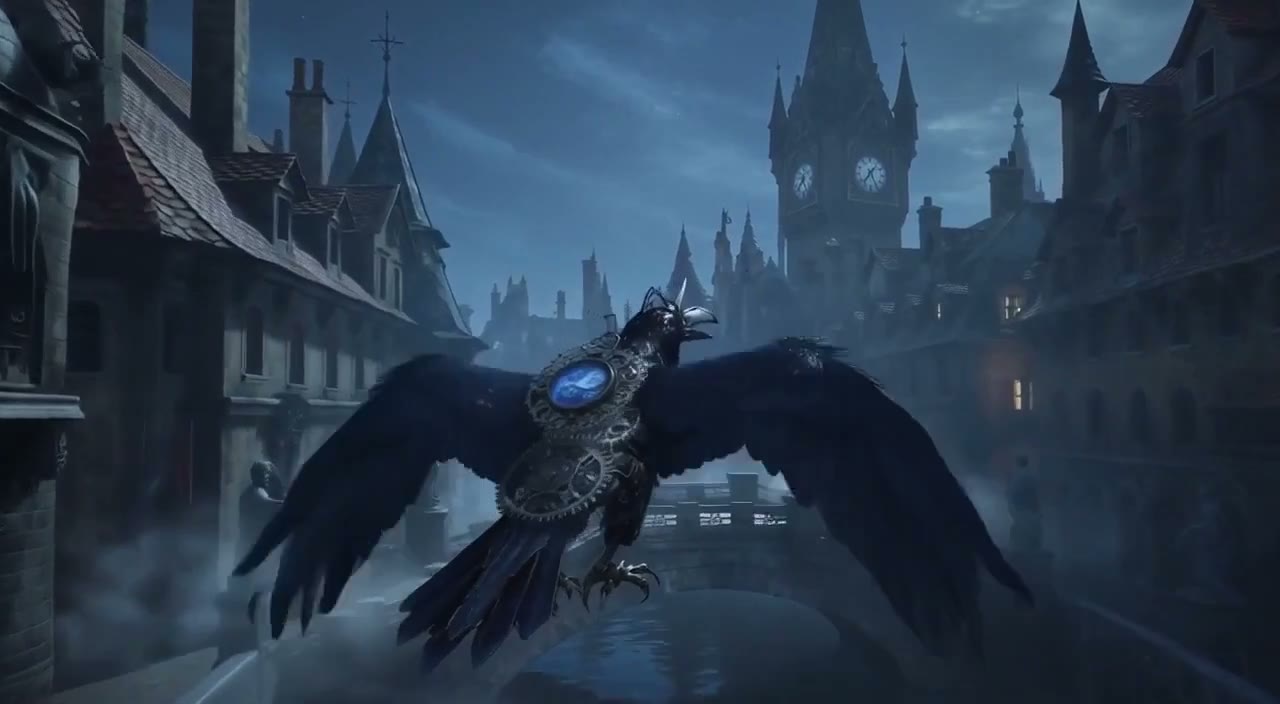 | 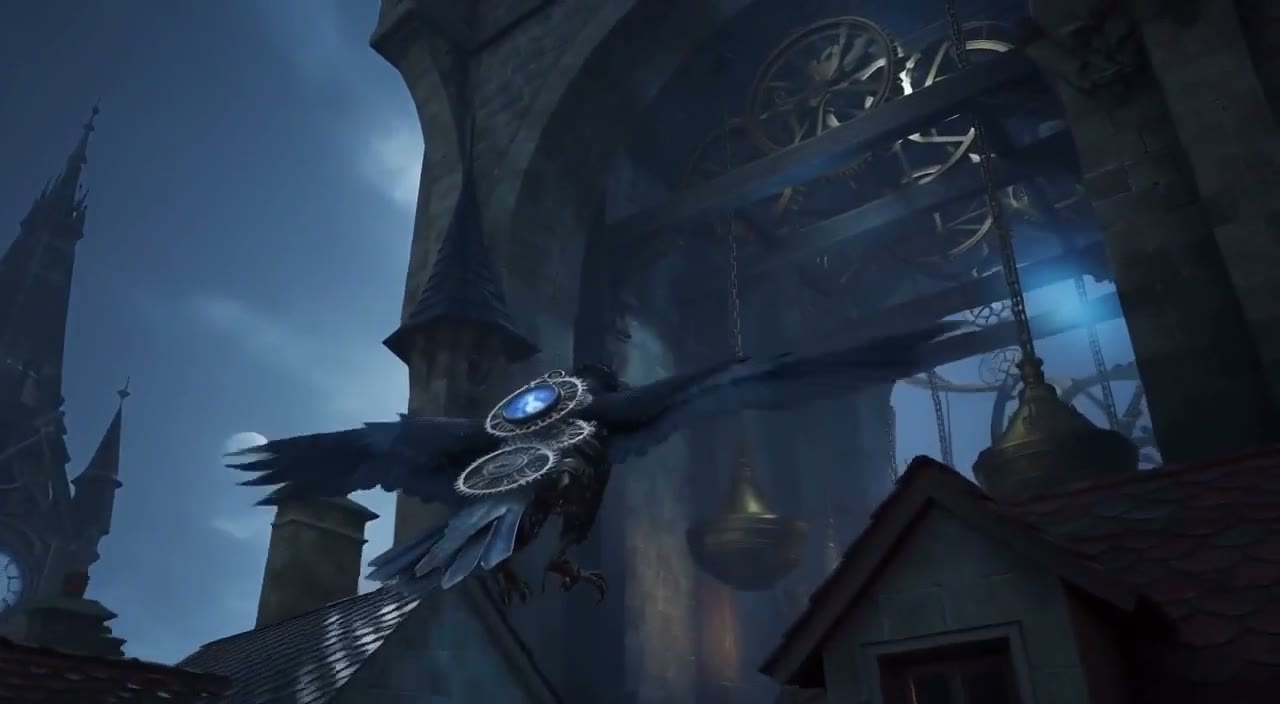 | 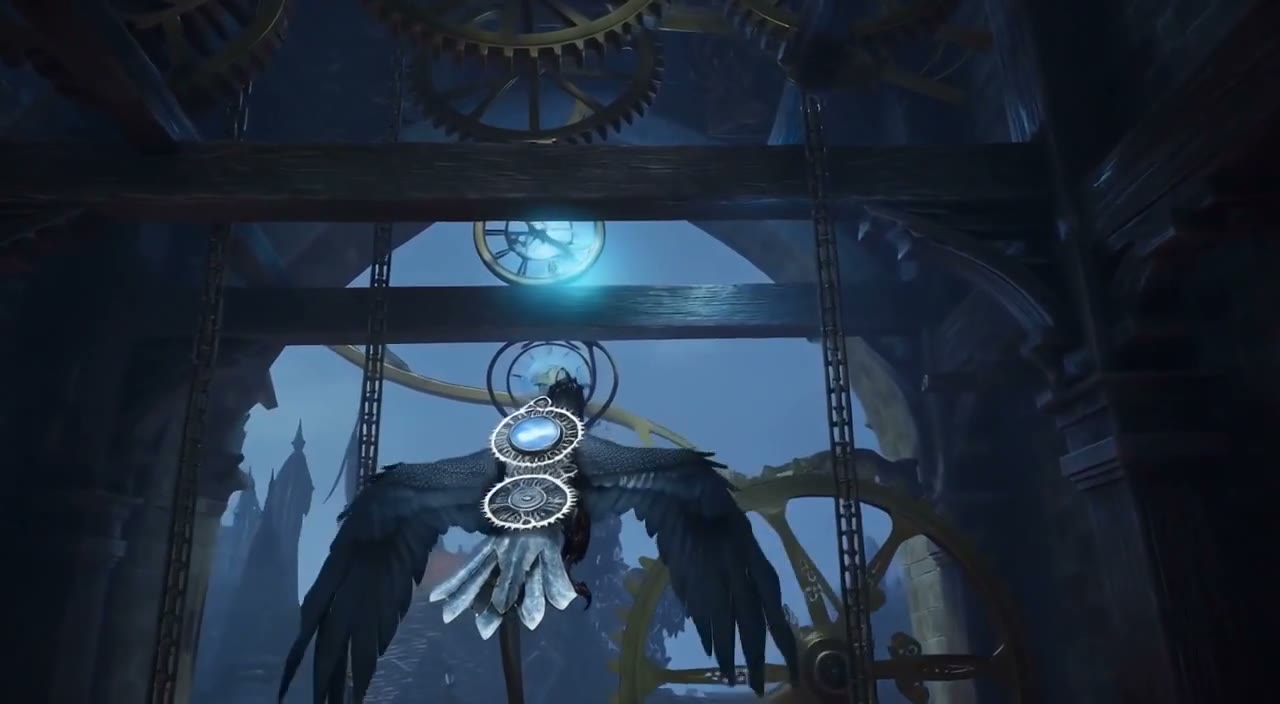 |
|---|---|---|
| 1초: "기계 새가 지붕 위를 날고, 앞쪽에는 높은 첨탑이 있습니다." | 30초: "새가 아치를 돌아 탑 내부의 기어와 구조물을 향해 갑니다." | 48초: "새가 탑 내부의 머리 위 기어와 푸른 빛 아래에서 움직입니다." |
동일한 클립 중 새가 시계탑으로 들어가는 턴의 6초 발췌. Tencent Hunyuan 제작, 공식 갤러리에서 캡처.
일급 입력으로서의 카메라 제어
카메라 움직임은 프롬프트 제안이 아니라 별도의 조건화 경로입니다. 궤적 파일에는 [N, 4, 4] 형태의 카메라-월드 행렬 c2ws와 [N, 3, 3] 형태의 내부 파라미터가 담기며, 모델은 외부 파라미터를 정규화하고 이를 비디오 프레임 4개 단위로 그룹화한 뒤 각 그룹을 64차원 입력으로 평탄화합니다. 비디오 토큰은 모든 이중 스트림 블록에서 크로스 어텐션을 통해 이 입력을 쿼리합니다. 두 가지 스케일이 제어를 노출합니다. trajectory_translation_scale의 기본값은 1.0이고 trajectory_rotation_scale은 2.5입니다.
텍스트와 카메라는 한 번의 실행 안에서 번갈아 사용할 수도 있습니다. 갤러리는 샘플을 스타일(실사 영상, CG, 비디오 게임, 애니메이션 및 애니메)과 시점(1인칭, 3인칭 추적, 3인칭 관찰자)으로 구분하며, 데모에서는 WASD와 화살표 키를 누르거나 마우스를 드래그해 생성된 세계를 이동할 수 있고, 이 이동은 24 FPS로 기록되어 다음 턴에서 재생됩니다.
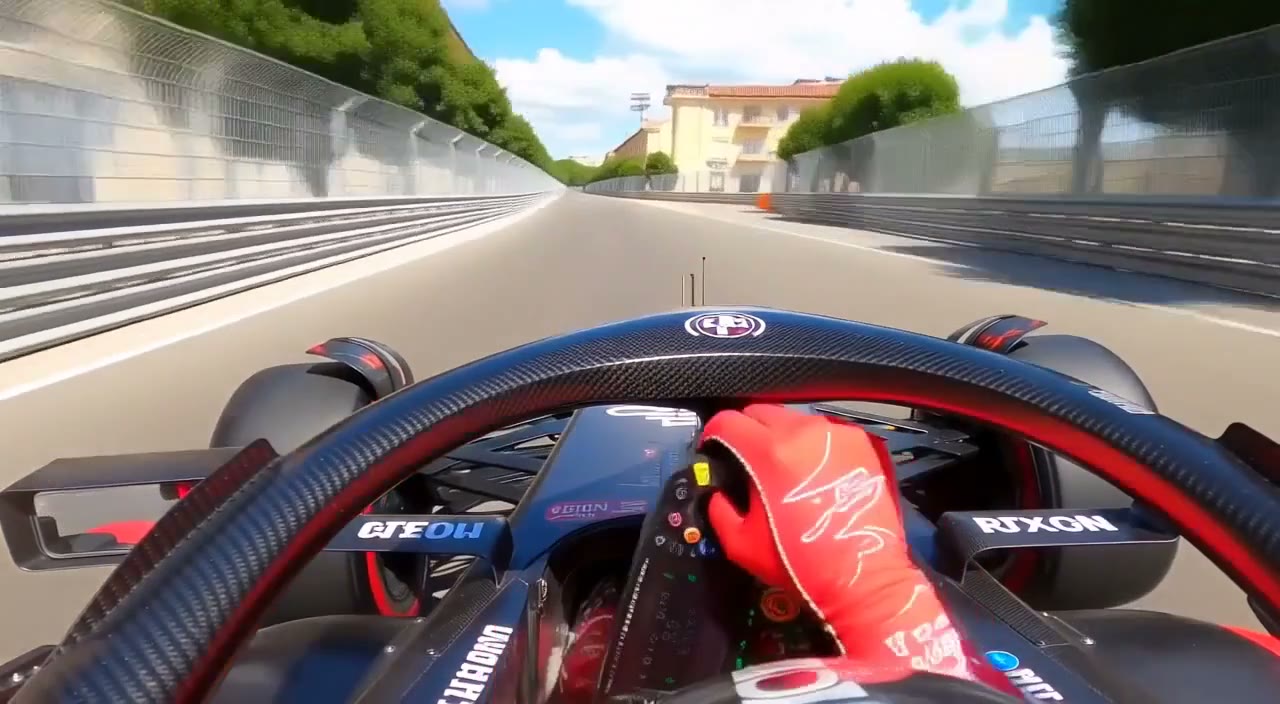
갤러리의 1인칭 샘플 circuit-drive: 레이싱 콕핏 안에서 바라본 시가지 서킷. Tencent Hunyuan 제작.
모델 내부
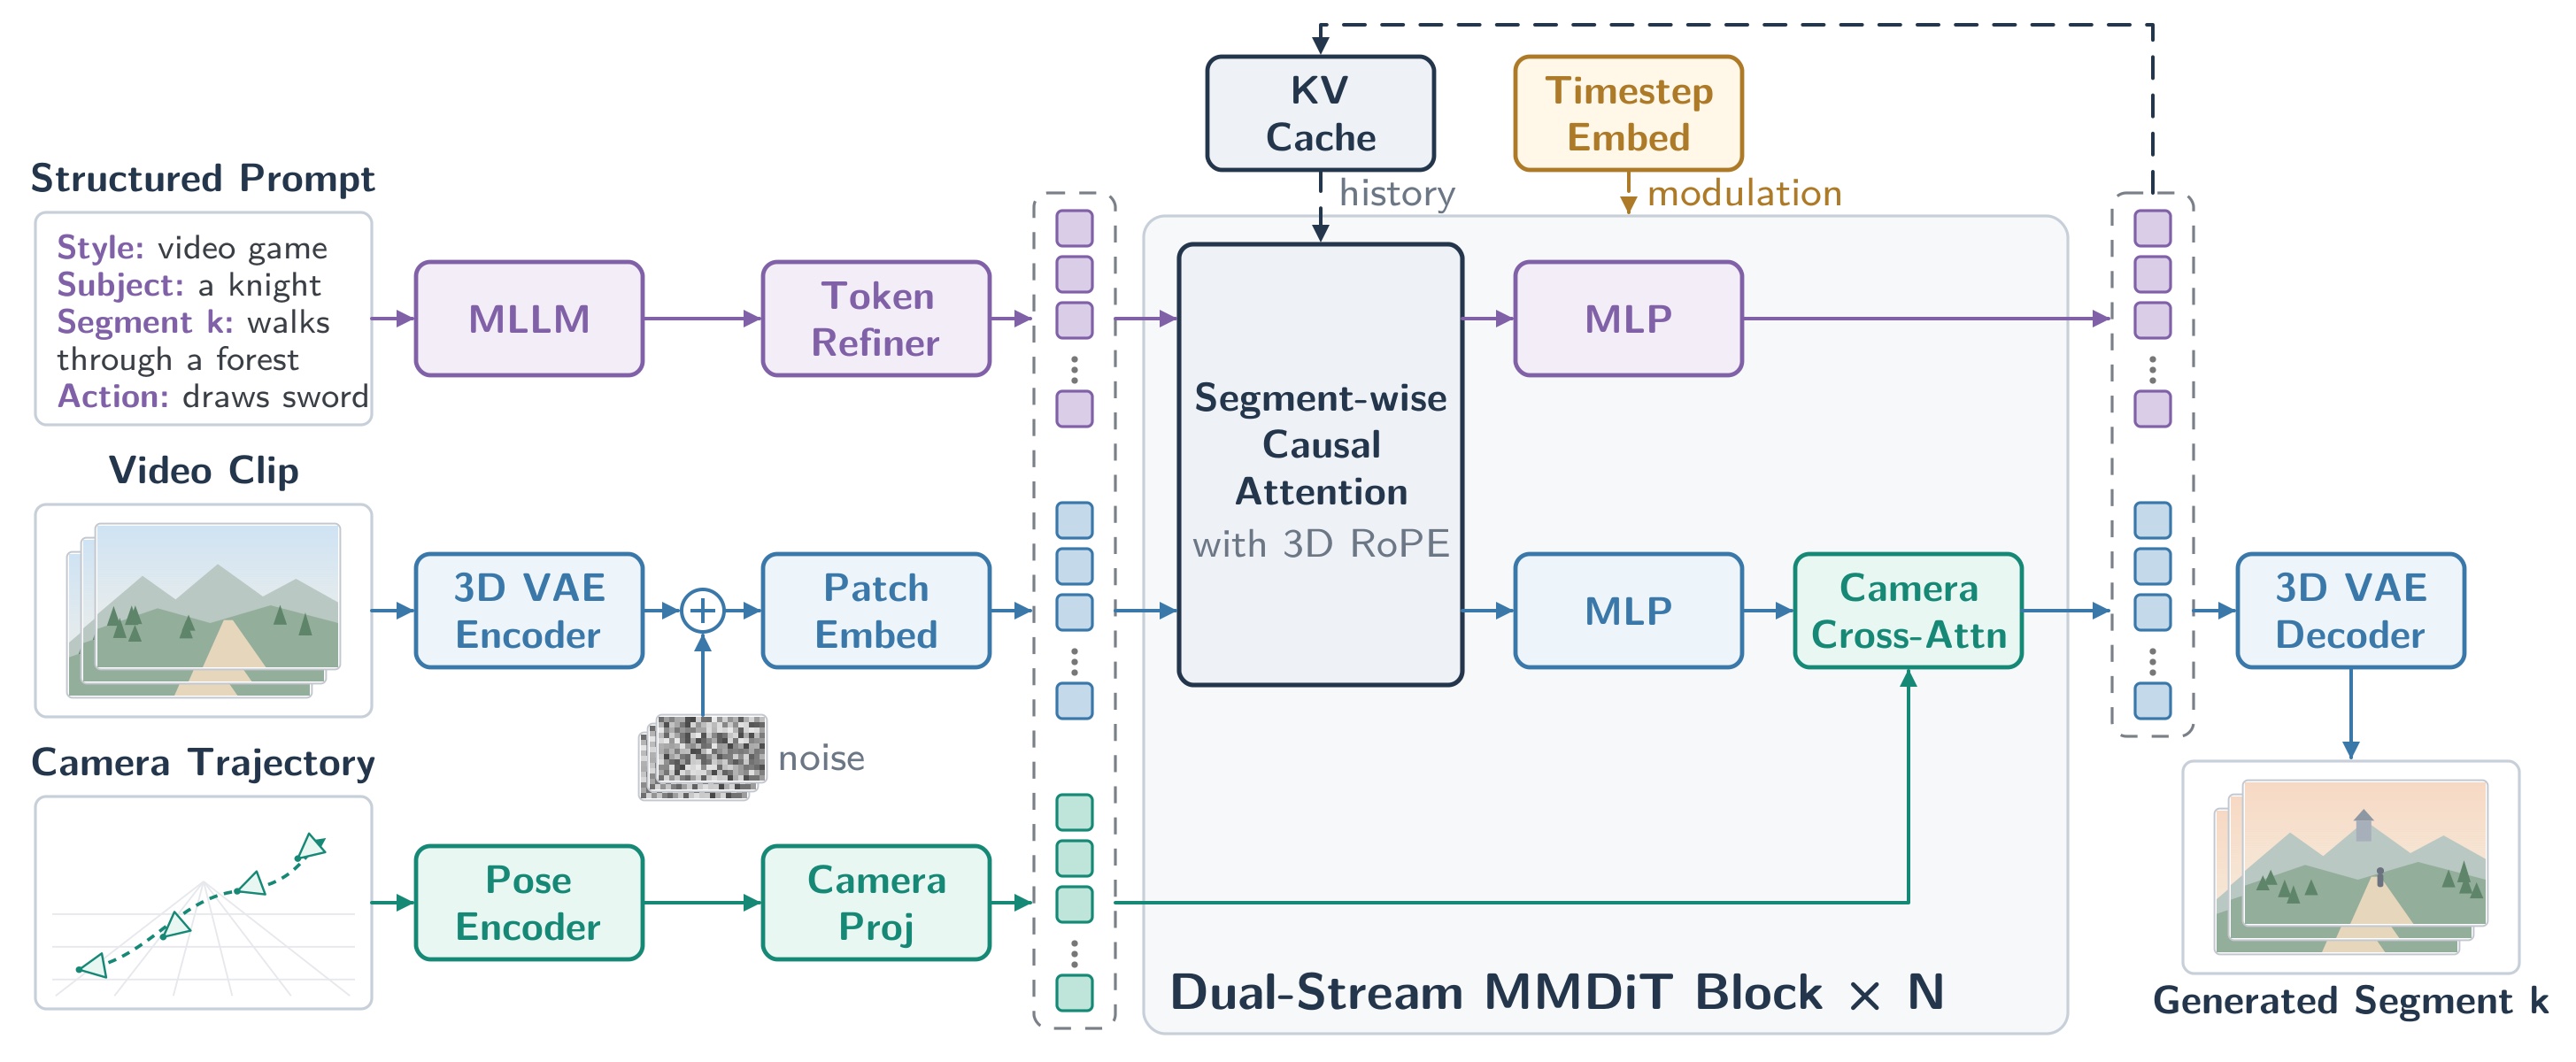
릴리스 저장소의 프레임워크 다이어그램. 텍스트, 비디오 잠재 데이터, 카메라 궤적이 이중 스트림 MMDiT 블록으로 입력됩니다.
| 속성 | 구성 |
|---|---|
| 백본 | 이중 스트림 MMDiT 블록 54개, 단일 스트림 블록 없음 |
| 히든 크기 | 2,048, 128차원 헤드 16개 |
| 피드포워드 | 4× 확장, 중간 크기 8,192 |
| 잠재 데이터 | 입출력 32채널, 패치 1 × 1 × 1 |
| 위치 인코딩 | 3D RoPE, 크기 [16, 56, 56], 세타 256 |
| 텍스트 조건화 | Qwen2.5-VL-7B-Instruct 히든 상태 3,584차원, 2레이어 토큰 리파이너 |
| 카메라 조건화 | 이중 스트림 블록의 크로스 어텐션을 통한 외부 파라미터 임베딩 |
| 예측 | 플로우 속도, Euler ODE 샘플링 |
비디오는 DCAE-V f32t4c32 잠재 데이터에 담깁니다. 32채널이며 각 방향으로 32× 공간 압축, 4× 시간 압축을 적용합니다. 디코딩은 36개 레이어, 4,096차원 히든 크기, 32개 쿼리 헤드, 8개 KV 헤드를 갖춘 파인튜닝된 PixelUMM 디코더가 담당하며, 잠재 프레임 10개 단위의 시간 창에 5프레임 겹침을 두고 4 × 16 × 16 튜블릿으로 RGB를 재구성합니다. 이 디코딩은 단일 단계이며 DiT의 8번 디노이징 단계와는 별개입니다.
단일 4090 구성
참조 구성은 하나의 추론 그룹을 8방향 시퀀스 병렬 처리와 분산 디코딩으로 8개 GPU에 분산합니다. 두 번째 구성은 단일 RTX 4090을 대상으로 하며, 변경 사항은 모두 메모리 관리에 관한 것입니다.
- DiT 가중치와 캐시된 키·값은 INT8로 저장되지만 선형 레이어와 어텐션은 여전히 BF16으로 계산합니다.
- PixelUMM 디코더는 CUTLASS 커널을 통해 FP8로 실행되고, DiT는 FlexAttention을 사용합니다.
- 텍스트 인코더, DiT, 디코더는 각자의 단계에서 GPU로 옮겨지고 이후 CPU로 오프로드됩니다.
- GPU 히스토리는
temporal_context로 샘플링된 잠재 프레임 18개로 제한되며, 더 오래된 히스토리는 시스템 RAM에 보관됩니다.
모델 카드는 트레이드오프를 분명히 밝힙니다. 시스템 RAM이 오프로드된 모델과 계속 늘어나는 히스토리 아카이브를 담아야 하고, CPU에서 GPU로의 전송이 지연을 더하며, 히스토리 예산이 현재 세그먼트의 메모리를 제한하지는 않습니다. 세그먼트별 소요 시간은 공개되지 않았으므로 작성 시점 기준 4090에서의 속도는 검증되지 않았습니다.
LoRA 파인튜닝과 프롬프트 서비스
릴리스에는 두 가지 어댑터가 포함됩니다. Cinematic LoRA는 호환되는 플로팅 포인트 DiT를 위한 선택적 시각 품질 어댑터로 제공되며, Robotics LoRA는 RealSource-World 로봇 팔 데이터셋으로 학습되어 증류된 DiT에 병합함으로써 생성된 세계에서의 시뮬레이션 조작을 강화하는 용도입니다. INT8 로더는 추론 시점에 별도 LoRA를 로드할 수 없으므로 어댑터 작업은 BF16 또는 FP32 가중치를 통해 이루어집니다.
저장소에는 파인튜닝 경로도 포함되어 있습니다. SFT 데이터 준비, 긴 시퀀스를 위한 오프라인 시퀀스 패킹, 그다음 학습과 병합 순서입니다. 웹 데모에는 한 가지 필수 의존성이 있는데, 사용자 지침을 구조화된 생성 프롬프트로 바꿔 주는 별도 서비스 Nomas-PE입니다. 오프라인 추론은 준비된 프롬프트 파일을 읽으면 되므로 이를 건너뛸 수 있습니다. 미리 빌드된 Docker 이미지(hynomasoss/hynomasoss:cu130)에는 PyTorch, FlashAttention, MagiAttention이 포함되어 있어 CUDA 커널을 직접 빌드할 필요가 없습니다.
Hy-Nomas-Bench
모델과 함께 팀은 Hy-Nomas-Bench를 공개했습니다. 280개 테스트 케이스로 구성된 4개 벤치마크로, 다중 턴 자유 형식 텍스트 상호작용, 카메라 내비게이션, 텍스트와 카메라 제어의 교차, 공간 기억을 다룹니다. 데이터셋에는 구조화된 프롬프트, 상호작용 시퀀스, 키보드 타임라인, 참조 카메라 궤적이 포함되어 있어 단일 클립이 아니라 긴 생성 실행 전반의 일관성을 평가하는 데 활용할 수 있습니다.
사용 가능성
이 릴리스에는 ComfyUI 네이티브 지원이 없습니다. 코어 노드도, Comfy-Org 재패키징도 없습니다. 공식 경로는 Docker 이미지가 포함된 GitHub 저장소와 호스팅되는 인터랙티브 데모입니다.
ComfyUI의 경우 커뮤니티 포트 Nynxz/ComfyUI-HyNomas가 10월 23일 등장했으며, 변환된 가중치는 nynxz/Hy-Nomas에 있습니다.
| 파일 | 폴더 | 크기 |
|---|---|---|
nomas_dit_distilled_int8_convrot.safetensors | models/diffusion_models | 9.0 GB, INT8 ConvRot |
nomas_dit_distilled_bf16.safetensors | models/diffusion_models | 17.1 GB, LoRA 병합용 베이스 |
nomas_pixelumm_vae_bf16.safetensors | models/vae | 15.8 GB, PixelUMM 디코더 및 DCAE-V 인코더 |
이 포트는 기본 확산 모델 로드 노드로 DiT를, CLIP 로드 노드로 텍스트 인코더를 로드하며, Comfy-Org/Qwen-Image_ComfyUI의 qwen_image 타입에 해당하는 ComfyUI 자체 qwen_2.5_vl_7b.safetensors를 사용합니다. 디코더는 VAE 로드 노드로 불러오므로 커스텀 커널이 필요하지 않습니다. 작성자는 RTX 5090에서 INT8 체크포인트와 1280 × 704 해상도로 3초 턴을 생성하는 데 약 21초, 여기에 창마다 약 4초의 디코딩이 더해진다고 보고합니다. 이 수치는 이틀도 되지 않은 포트에서 한 사용자가 측정한 값으로 간주하고, 공식 구성의 4090 목표치와는 분리해 두는 것이 좋습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.