MiniMax H3 캐릭터 스왑 v1.1: 80 MB LoRA, 더 나아진 유사도
Alissonerdx가 80 MB 동적 랭크 SVD 추출 방식으로 유사도를 높인 MiniMax H3 캐릭터 스왑 v1.1과 두 가지 ComfyUI 워크플로를 공개했습니다. 그중 하나는 네이티브 노드만 사용합니다.
이 저장소는 10월 초 v1.0을 다룬 H3 캐릭터 스왑 및 라이브 월페이퍼 LoRA를 올린 곳과 동일하며, 작성 시점 기준 약 458개의 좋아요와 144,700회 다운로드를 기록하고 있습니다. 팩의 모든 어댑터는 H3의 ref2va 가중치로 학습되었고 동일한 조건화 방식을 사용합니다. 소스 클립은 느슨한 비디오 참조가 아니라 정렬된 가이드 격자 형태로 MiniMaxH3AddGuide를 통해 주입됩니다.
v1.1은 작업 자체를 바꾸지 않습니다. body_swap: 트리거를 사용하는 동일한 가이드 기반 바디 스왑이며, 이번 릴리스의 핵심은 v1.0에 대한 한 가지 불만, 즉 교체된 캐릭터가 참조 이미지와 충분히 닮지 않는다는 점입니다.
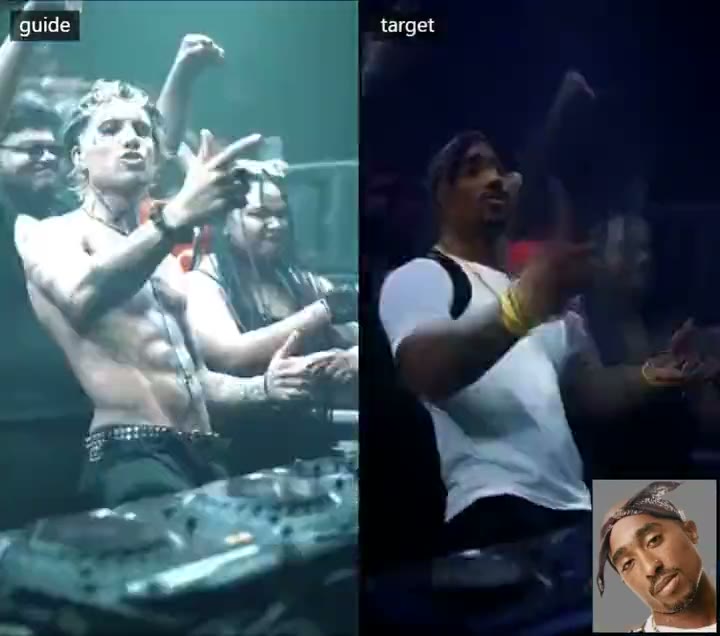
작성자의 v1.1 테스트에서 가이드와 대상을 비교한 클립의 한 프레임.
v1.1에서 달라진 점
작성자는 이번 릴리스를 위해 새 어댑터를 재학습하지 않았습니다. v1.1은 v1.1 학습 실행에서 뽑아낸 80 MB SVD 추출이며, Frobenius 노름 에너지 분석을 통해 레이어마다 동적 랭크가 선택됩니다. 208개 레이어 각각은 자체 에너지의 95%를 담는 가장 작은 랭크를 유지하는데, 이는 랭크 4에서 34 사이에 분포하며 중앙값은 7입니다. 덕분에 파일은 v1.0의 랭크 64 체크포인트보다 약 8배 작으면서도 유사도 점수는 더 높습니다. 따라서 참조가 얼굴, 머리카락, 신체, 의상에 더 가깝게 적용되고, 가이드는 여전히 장면과 카메라, 연기를 제공합니다.
| 체크포인트 | 크기 | 설명 |
|---|---|---|
minimax_h3_character_swap_v1.1_ref2va_fro | 80 MB | 레이어별 동적 랭크(4~34, 중앙값 7), 권장 릴리스 |
minimax_h3_character_swap_v1.0_ref2va_r64_gl | 620 MB | 랭크 64, 이전 릴리스이며 나란히 비교할 수 있도록 유지 |
가이드는 강도 1.0을 요구하며, 이는 작성자가 밝힌 공개 규칙이기도 합니다. 1.0에서 작동하지 않는 LoRA는 공개하지 않습니다.
작성자는 릴리스가 진행 중이던 시점에 세 가지 랭크 비교를 게시했습니다. 첫 번째는 에너지 분석으로 추출한 랭크를 사용하고, 두 번째는 v1.1을 뒷받침하는 두 학습 단계를 혼합하며, 세 번째는 전체 가이드 대 대상 비교입니다.
Frobenius 에너지 기반 랭크 추출. v1.1에 실제로 적용된 방식입니다.
v1.1을 뒷받침하는 두 학습 단계를 결합한 혼합 랭크 테스트.
가이드와 스왑된 출력을 나란히 비교한 클립.
두 가지 v1.1 워크플로
v1.1에는 새로운 그래프 두 개가 포함되어 있으며, 둘 중 무엇을 고를지는 대부분 클립 길이로 결정됩니다.
| 워크플로 | 사용 요소 |
|---|---|
| Shot Planner | ComfyUI-BFSNodes 1.113.0 이상. 긴 비디오를 샷 단위로 나누고, 각 샷을 렌더링한 뒤 이어 붙이며, 참조와 {details}는 플래너에서 설명되고, 그래프가 나란히 비교하는 결과물을 만듭니다. |
| 네이티브 노드만 사용 | Generate Text가 참조 이미지를 보고 전체 프롬프트를 작성한 다음, MiniMax H3 Reference to Video와 Add Guide가 클립 하나를 렌더링합니다. 커뮤니티 노드 팩이 필요 없습니다. |
둘 다 DMD 터보 LoRA로 8스텝으로 실행되며, LMS 샤프니스 LoRA와 1280×704 잠재 데이터 업스케일러를 추가하는 선택적 2차 패스를 갖추고 있습니다. 각 워크플로에는 로드하는 모든 모델의 다운로드 링크가 담긴 노트가 있고, 모델 로더는 저장 당시의 폴더 이름을 그대로 유지하므로 파일이 기타 위치에 있다면 각 로더를 다시 선택해야 합니다.
프롬프트 템플릿
캐릭터 설명은 참조가 얼마나 유지될지를 결정하는 부분입니다. 이제 가이드에 고정 템플릿이 포함되어 있습니다. 한 줄로 사용하고 {details}만 참조 캐릭터에 대한 쉼표 구분 설명으로 교체하되, 성별부터 시작하십시오.
body_swap: subject_definitions: <Subject 1> is the {details} shown in <Picture 1>, whose identity, face, head, hair or fur, skin, body shape, proportions and clothing define the character in the target video. The guide video provides the scene and the performance: its background, environment, lighting, camera, framing, body pose, hand and arm movement, head rotation, gaze direction, lip movement and facial expression, frame by frame; only the main subject of the guide video is replaced: its face, hair, body and clothing become <Subject 1>. summary: [video generation + reference] Replace the guide subject with <Subject 1>, keeping the scene, camera and the complete motion and performance of the guide video. detailed_description: [Shot 1] <Subject 1> takes the exact place of the guide subject and moves with the same timing, body pose, gestures, head motion, gaze, speech and facial expressions, while keeping the complete identity from <Picture 1>: facial structure, hair or fur, skin, body shape and clothing stay stable in every frame. The background, lighting, colors and camera of the guide video are preserved. Prevent identity drift, clothing changes, texture crawling and flicker.{details}는 머리부터 발끝까지 작성하도록 되어 있습니다. 성별, 키와 체형, 얼굴형과 피부톤, 머리카락, 색상과 소재를 포함한 상의와 하의, 신발, 액세서리, 그리고 문신이나 흉터, 주름 같은 두드러진 특징입니다. 가이드는 이 자리에 배경, 카메라, 조명을 설명하는 것을 금지합니다.
자동으로 채우는 방법은 두 가지입니다. Shot Planner에서는 {details}가 프롬프트에 남아 있고, 패널의 Describe refs 액션이 각 참조에 대한 설명을 작성하거나 워크플로가 실행될 때 언어 모델이 작성합니다. 네이티브 워크플로에서는 Generate Text가 참조 이미지와 함께 전체 프롬프트를 반환하라는 지시를 받으며, 가이드는 프롬프트 끝부분이 잘리지 않도록 max_length를 약 768로 설정할 것을 권장합니다.
사용 가능 여부
LoRA를 ComfyUI/models/loras/에 배치하고 v1.1 워크플로 중 하나를 로드한 다음, 그래프 안의 노트에서 필요한 모델을 확인하십시오. 공개된 설정은 H3 ref2va 디퓨전 모델(작성자 예시에서는 pruned int8_convrot 빌드), H3 텍스트 인코더, 비디오 및 오디오 VAE, 8스텝 DMD 터보 LoRA를 로드합니다. 선택적인 qwen3.5_9b_w4a8_gptq 비전-언어 모델은 참조를 설명하는 데에만 사용됩니다.
입력 순서가 중요합니다. LoRA가 가이드 잠재 데이터로 학습되었으므로 원본 클립을 frame_idx = 0으로 MiniMaxH3AddGuide에 보내고, 캐릭터 이미지는 H3의 네이티브 이미지 참조 경로를 통해 <Picture 1>로 보내십시오. 출력 종횡비와 프레임 수를 가이드와 정렬된 상태로 유지하고, H3 프레임 수 17n + 5(5, 22, 39, 56, 73, 90, 107, 124 등)를 사용하며, 긴 클립을 실행하기 전에 짧은 구간에서 테스트하십시오.
댓글
GitHub로 로그인하고 토론에 참여하세요.