RTX 30 시리즈 BF16 언락으로 ComfyUI 최대 60% 빨라진다
오픈소스 Linux 커널 모듈이 RTX 30 카드의 FP/BF16 명령 발행률을 복원합니다. 한 3090 Ti에서 ComfyUI BF16 그래프가 31~60% 빨라졌고 INT8은 그대로였습니다.
이 카드군은 수년째 소프트웨어 제한을 안고 있습니다. 소비자용 GA102, GA103, GA104, GA106 칩은 속의 실리콘이 프로용 형제 제품과 같음에도 FP/BF16 FMA(융합 곱셈-덧셈)를 FP32로 발행하는 속도가 절반입니다. gpu-unlock은 nvidia가 로드되기 전에 이 상한을 끌어올리는 속도 선택자를 기록하므로, 나머지 스택은 수정 없이 그대로 동작합니다.
모듈이 바꾸는 것
이 프로젝트는 두 가지 이전 접근을 결합합니다. CMP 언락커의 V67/PLM 기법과, UEFI 방식의 드라이버 이전 타이밍입니다. 구체적으로 모듈은 NVIDIA 드라이버가 카드를 바인딩하기 전에 전체 BF16 속도를 선택하는 속도 선택자 SS0 0x88888888과 IMLA4용 4비트 SS1 0x8을 기록한 뒤 FLR을 수행하고 종료합니다. UEFI 애플리케이션도, 패치된 드라이버도 아니며, 작성자가 강조하는 바로 그 특성입니다. NVIDIA가 새 드라이버 버전을 내놓을 때마다 다시 실행할 패치가 없습니다.
README는 그 효과를 명확히 밝힙니다. 이 네 칩 패밀리에서 FP/BF16 FMA를 FP32로 발행하는 명령 발행률을 두 배로 높인다는 것입니다. 이 모듈은 커널 명령줄에서 gpu_unlock.targets=로 옵트인하지 않으면 아무것도 하지 않으며, all 또는 PCI 주소 목록을 지정할 수 있고, 카드가 몇 장이든 약 1초 만에 동시에 언락됩니다.
수치로 보면
프로젝트 자체 참조 측정은 450 W의 RTX 3090 Ti에서 수행한 밀집 8192³ GEMM이며, FP32 누적으로 5회 표본의 중앙값입니다.
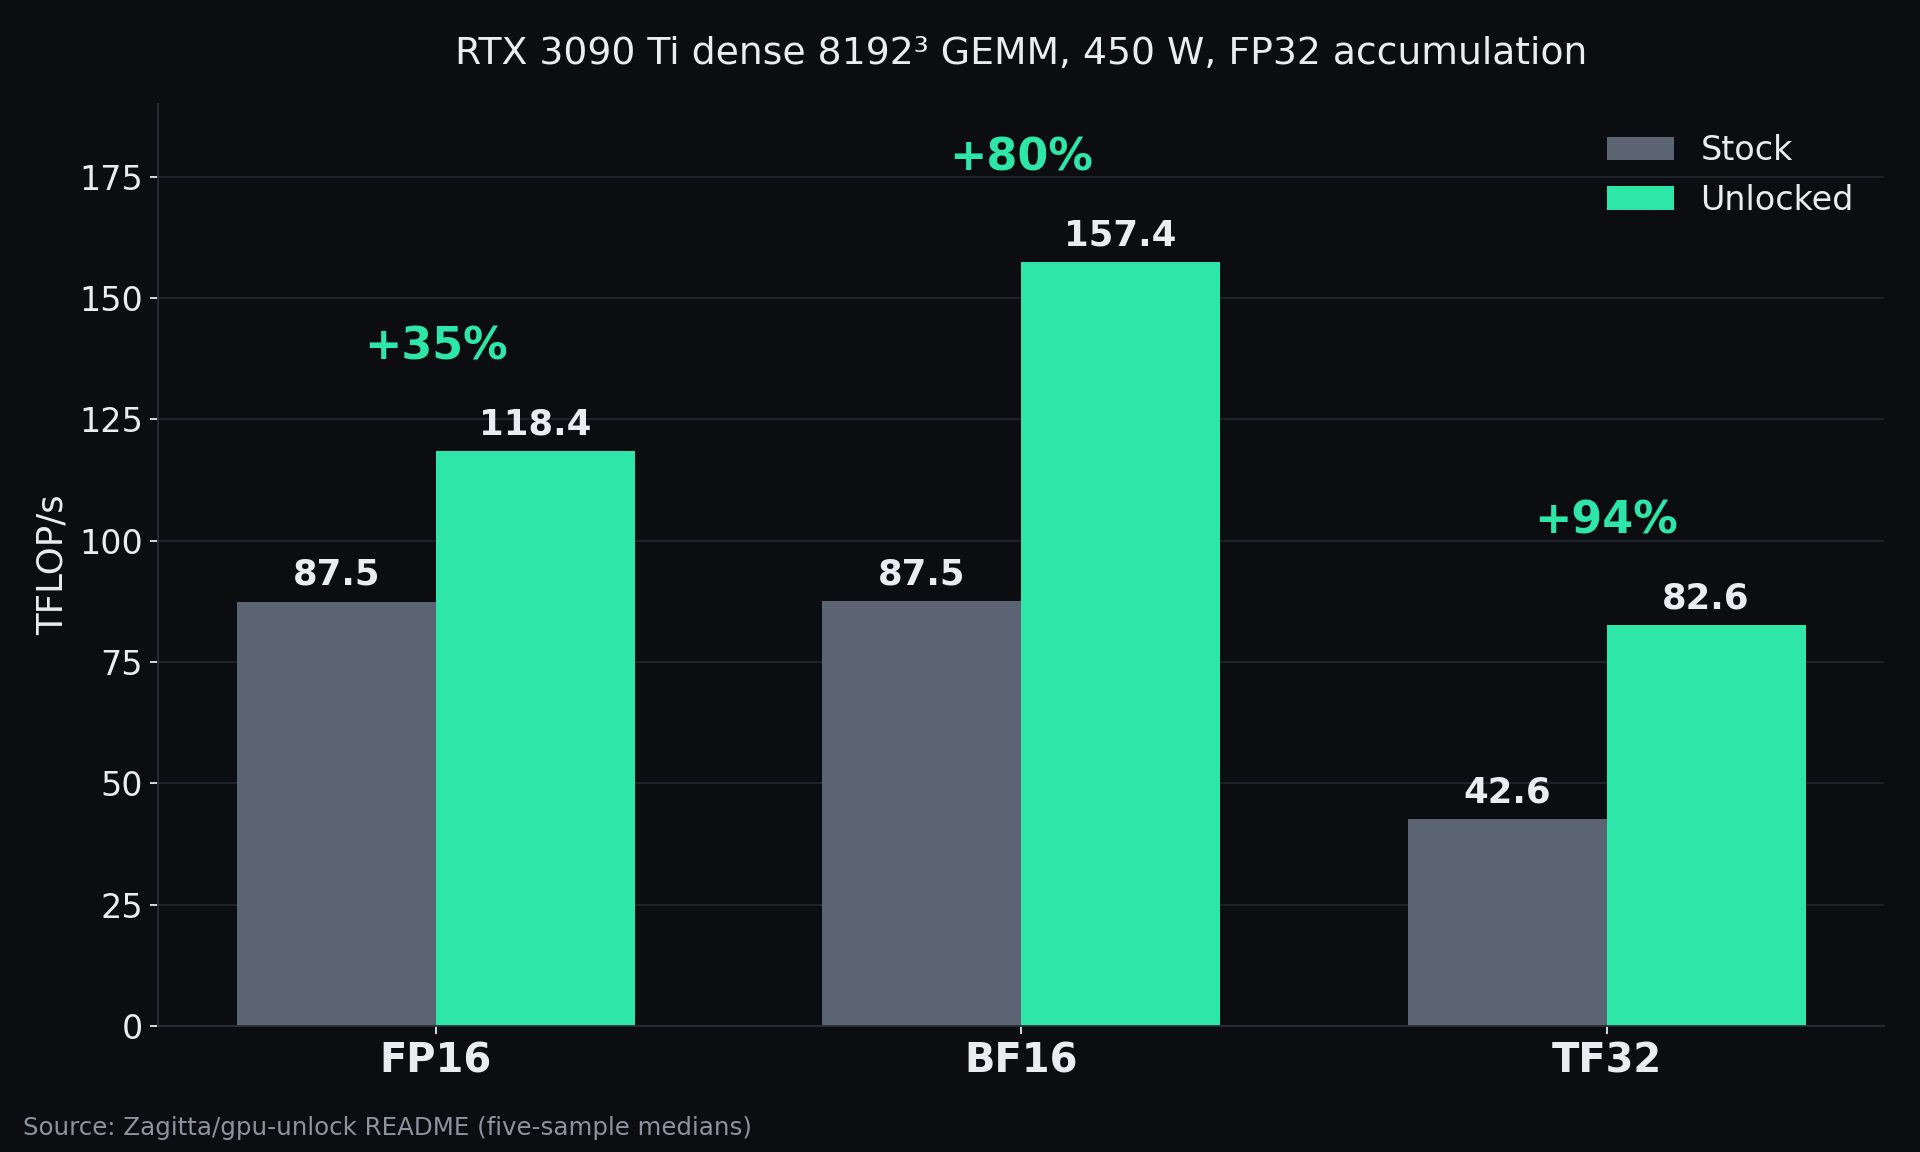
BF16은 87.5에서 157.4 TFLOP/s로, TF32는 42.6에서 82.6으로 거의 두 배가 되지만 FP16은 87.5에서 118.4로 증가 폭이 더 작습니다. README는 이 변화를 데이터 타입별로 나누지 않고 FP/BF16 FMA를 FP32로 발행하는 발행률이 두 배가 된다고 설명하므로, 공개된 표가 이 구분에 대한 유일한 측정치입니다.
저장소 README에 모인 사용자 호환성 신고는 나머지 스택을 다룹니다.
| 카드 | 결과 | BF16 GEMM 향상 |
|---|---|---|
| RTX 3090 Ti | 언락됨 | +68~80% |
| RTX 3090 | 언락됨 | +25~67% |
| RTX 3080 10 GB | 언락됨 | +70~73% |
| RTX 3080 20 GB | 언락됨 | +56~59% |
| RTX 3070 | 언락됨 | +73~81% |
| RTX 3060 12 GB | 언락됨 | 약 +80% |
| RTX 3080 Ti 20 GB (OEM) | 언락은 완료되지만 BF16은 절반 속도 유지 | 없음 |
| RTX 3070 Ti | 이 모듈로 테스트되지 않음 | 없음 |
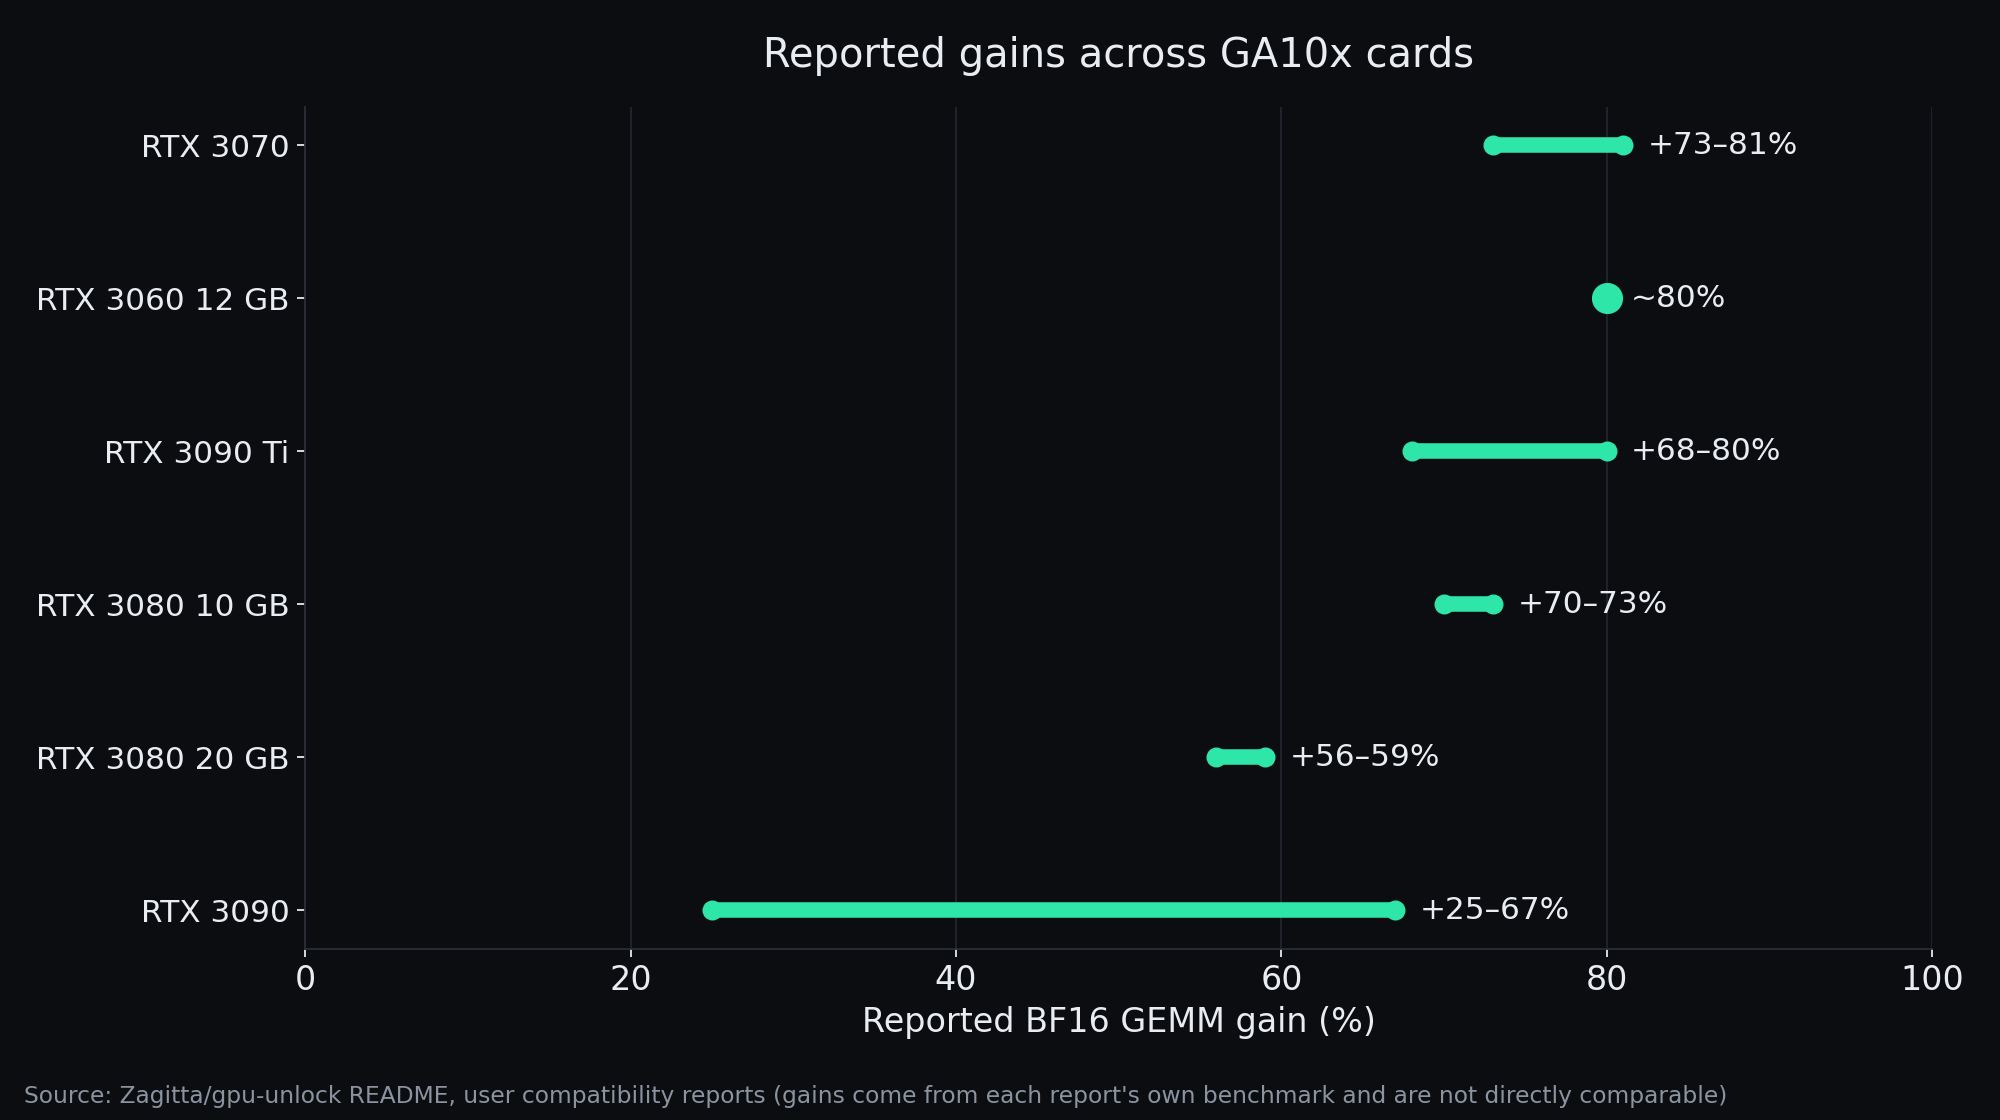
README는 이 수치들이 각 신고의 자체 벤치마크에서 나온 것이며 서로 직접 비교할 수 없다고 분명히 밝힙니다. 가장 큰 교란 요인은 전력 제한입니다. 가장 낮은 수치인 3090의 +25%는 225 W로 제한된 카드에서 나왔습니다.
ComfyUI에서 측정한 결과
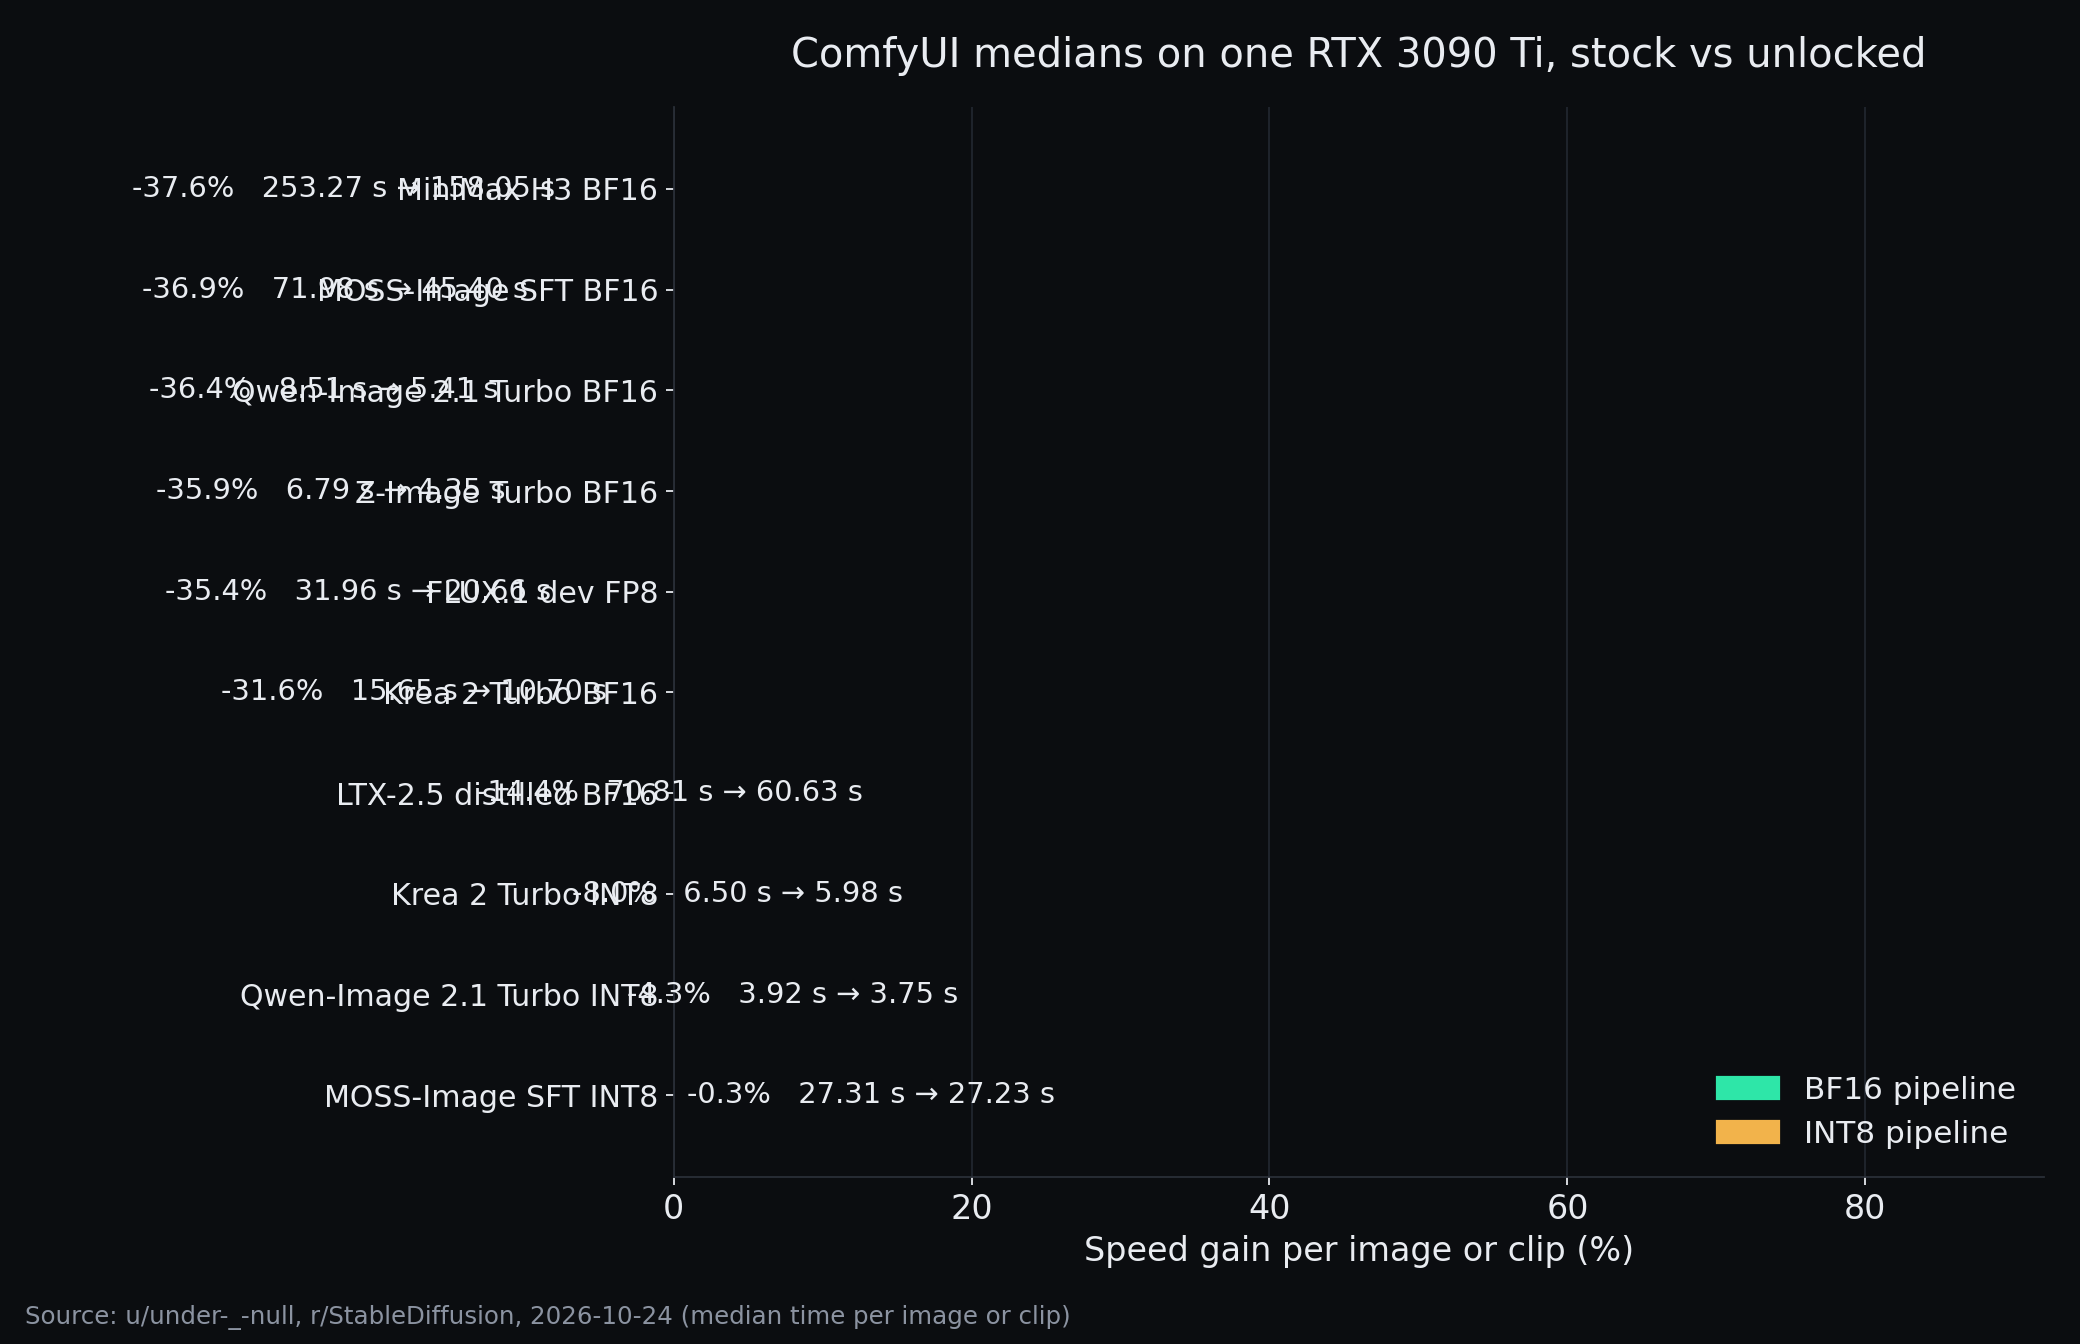
이 사이트에 유용한 테스트는 GEMM이 아니라 생성입니다. 독립적인 RTX 3090 Ti 소유자 u/under-_-null은 동일한 그래프를 기본 드라이버와 언락 드라이버에서 실행하고 이미지 또는 클립당 중앙값 시간을 공개했습니다. BF16 파이프라인에서는 최대 60% 빨라졌고 INT8에서는 거의 변화가 없었습니다.
| 모델 및 정밀도 | 기본 | 언락 | 향상 |
|---|---|---|---|
| MOSS-Image SFT BF16 | 71.98 s | 45.40 s | +58.6% |
| Qwen-Image 2.1 Turbo BF16 | 8.51 s | 5.41 s | +57.2% |
| Z-Image Turbo BF16 | 6.79 s | 4.35 s | +56.1% |
| FLUX.1 dev FP8 체크포인트 | 31.96 s | 20.66 s | +54.6% |
| Krea 2 Turbo BF16 | 15.65 s | 10.70 s | +46.3% |
| MiniMax H3 BF16 (비디오 및 오디오) | 253.27 s | 158.05 s | +60.2% |
| LTX-2.5 distilled BF16 (비디오 및 오디오) | 70.81 s | 60.63 s | +16.8% |
| MOSS-Image SFT INT8 | 27.31 s | 27.23 s | +0.3% |
| Qwen-Image 2.1 Turbo INT8 | 3.92 s | 3.75 s | +4.6% |
| MiniMax H3 INT8 ConvRot | 155.07 s | 118.21 s | +31.2% |
두 가지가 눈에 띕니다. 향상은 발행률이 중요한 BF16 작업에 집중되며, INT8 양자화 경로는 거의 영향을 받지 않습니다. 따라서 이미 INT8 ConvRot 체크포인트를 사용하는 사용자는 60%가 아니라 몇 퍼센트의 이득을 얻습니다. INT8 ConvRot의 MiniMax H3는 31%로 예외이며, 같은 신고의 다른 INT8 행보다 훨씬 높습니다.
출력 충실도는 유지되었습니다. 같은 신고에서 언락 상태와 기본 상태의 정지 이미지 실행 150회를 대조한 결과 디코딩된 RGB 픽셀이 동일했습니다. 저장소의 다른 호환성 신고도 같은 내용을 말하며, 이는 정밀도 변경이 아닌 발행률 변경과 일치합니다.
요구 사항 및 위험
시도하기 전에 알아야 할 세부 정보는 모두 프로젝트 문서에서 가져온 것입니다.
- Linux 전용. 이 모듈은 설치된 커널 헤더에 대해 빌드되며 mkinitcpio, initramfs-tools 또는 dracut을 통해 설치되고, Arch, Debian, Fedora 패키지 대상이 있습니다.
- 카드별 옵트인.
gpu_unlock.targets=all은 바인딩되지 않은 모든 GA10x 카드를 언락하며, 그렇지 않으면lspci -D가 출력하는 형식으로 PCI 주소를 나열합니다. 이미 드라이버가 초기화한 카드는 거부됩니다. - 콜드 부팅. 부팅 후 수동으로 모듈을 로딩해도
nvidia가 이미 바인딩한 카드에는 아무 효과가 없습니다. - 절전 처리. 속도 선택자는 전원이 끊기면 초기화되므로,
gpu_unlock.resume=0으로 비활성화하지 않는 한 모듈이 절전 알림을 통해 재개 시 다시 언락합니다. 최대 절전 모드는 지원되지 않습니다. - 디스플레이 카드도 동작합니다. 단, 재설정부터
nvidia-drm이 넘겨받을 때까지 콘솔이 비어 있습니다. - 모든 카드가 반응하지는 않습니다. OEM RTX 3080 Ti 20 GB는 언락이 완료되지만 BF16은 절반 속도를 유지하며, GA103에 대한 신고는 아직 없습니다.
별도의 커뮤니티 프로젝트인 impacifist/Windows-GPU-UNLOCK은 이 기법을 Windows 사용자를 위한 UEFI 경로로 이식합니다. 원본 프로젝트의 일부가 아니며 여기서는 테스트되지 않았습니다.
가용성
- 모듈: Zagitta/gpu-unlock, 저장소의 버전 1.0.0이며 호환성 표와 펌웨어 추출 코드가 포함되어 있습니다.
- 벤치마크 스레드: RTX 30 시리즈 언락 토론 및 RTX 3090 Ti ComfyUI 신고.
- Windows 포트: impacifist/Windows-GPU-UNLOCK.
댓글
GitHub로 로그인하고 토론에 참여하세요.