MOSS-Image Few-Step LoRA: 4스텝 rapid-moss와 8스텝 DMD
두 커뮤니티 LoRA가 MOSS-Image-SFT를 50스텝에서 4회 또는 8회 네트워크 평가로 줄이며, 4스텝 rapid-moss 어댑터는 네이티브 워크플로가 포함된 ComfyUI 노드를 제공합니다.
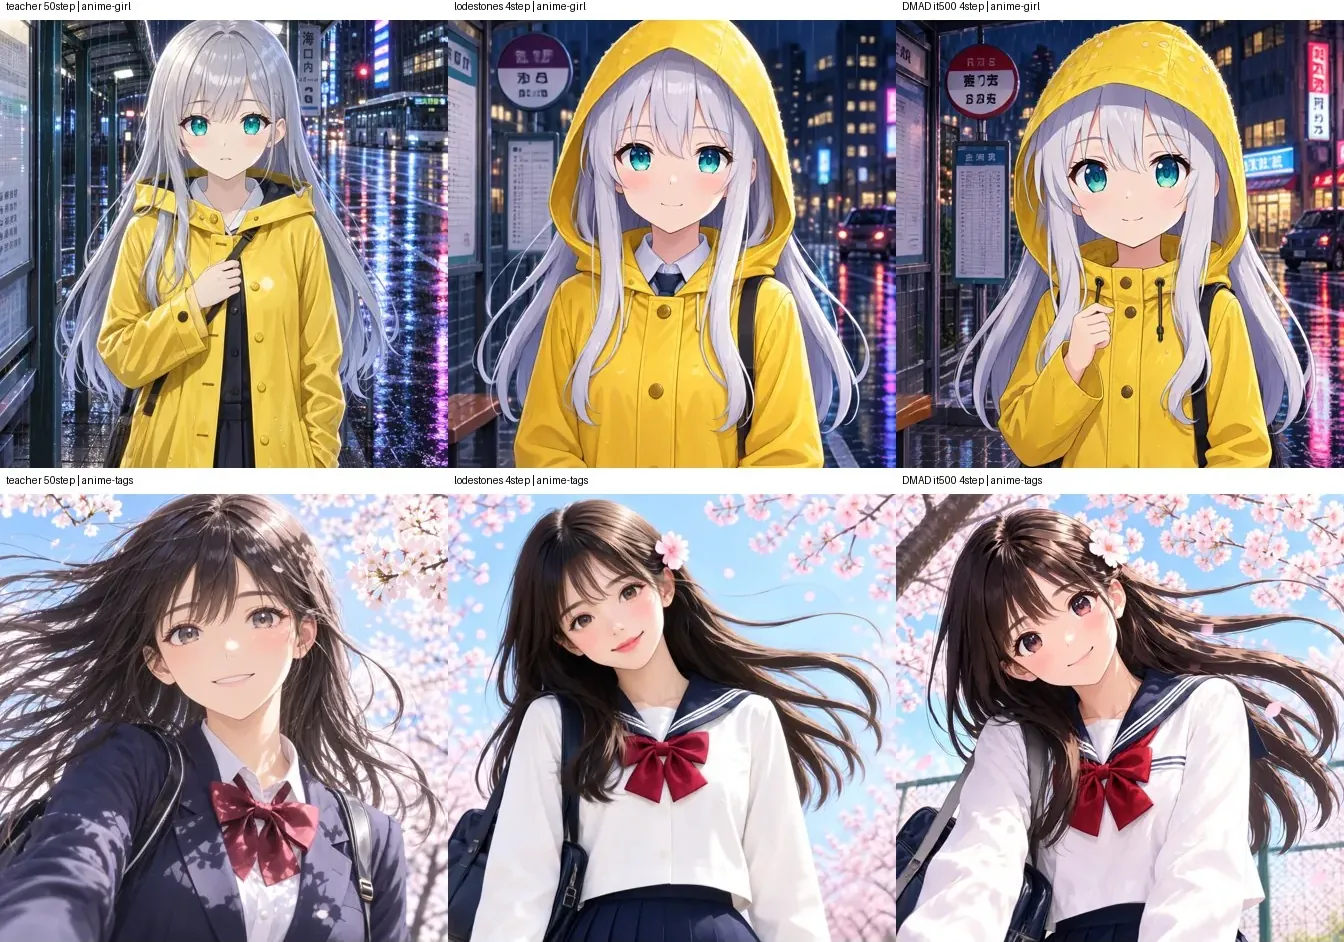
왼쪽부터: 50스텝 교사 모델, 4스텝으로 실행한 8스텝 체크포인트, 4스텝 rapid-moss 어댑터. 동일한 시드, 학습에 사용되지 않은 평가 프롬프트. 출처: darask0
샘플링 루프가 줄어드는 이유
MOSS-Image-SFT는 CFG 3으로 50스텝에서 이미지 한 장을 렌더링하며, CFG는 순방향 패스를 두 배로 늘리므로 그림 한 장에 약 100회의 DiT 평가가 소요됩니다. 8스텝 체크포인트는 이 루프를 데이터 공간 DMD(arXiv 2610.12102)로 대체합니다. 생성기는 고정된 노이즈 텐서에서 자체 클린 추정값을 네 번에서 여덟 번 반복하며, CFG도 타임스텝 스케줄도 사용하지 않습니다.
4스텝 어댑터는 그 체크포인트에서 이어져 이를 네 번의 반복으로 제한하며, DMAD(arXiv 2610.02188)로 학습되었습니다. 동결된 교사 모델 위의 LoRA 크리틱이 교사 샘플과 학생 샘플을 구분하고, 학생은 네거티브 크리틱 로짓을 최소화합니다. 작성자는 각 1개의 교사 샘플이 있는 3,199개의 프롬프트로 학습했으며, 이후 반복에서 프롬프트 준수도가 저하되기 시작하기 전인 500회 반복 체크포인트를 공개했습니다.
단일 H100에서 1024² 이미지당 DiT 시간:
| 체크포인트 | DiT 시간 | DiT 평가 횟수 |
|---|---|---|
| MOSS-Image-SFT (50스텝, CFG 3) | 16.2 s | 100 |
| lodestones 8스텝 DMD | 1.54 s | 8 |
| rapid-moss 4스텝 DMAD | 0.81 s | 4 |
측정 시간은 트랜스포머만 포함하며 Qwen3.5-9B 텍스트 인코더나 VAE는 포함하지 않습니다. RTX PRO 6000의 ComfyUI 내부에서 작성자는 텍스트 인코딩과 디코딩을 포함해 1024² 이미지 기준 4.5~6.9초를 측정했습니다.
ComfyUI 노드
두 어댑터는 크기가 bf16의 반올림 단위보다 작은 fp32 LoRA 델타이므로, 이를 bf16 가중치에 병합하면 증류의 대부분이 사라집니다. 따라서 LoraLoaderModelOnly, diffusers fuse_lora, 그리고 사전 병합된 가중치를 로드하는 모든 워크플로는 사용할 수 없습니다. 대신 함께 제공되는 MOSS-Image Few-Step Adapter (rapid-moss) 노드는 런타임에 fp32로 LoRA를 추가하고, fp32 시간 경로를 교체하며, 짝을 이룬 MODEL, SAMPLER, SIGMAS 트리플을 반환합니다.
출력은 하나의 세트로 함께 연결해야 합니다. MODEL은 CFG 없이 BasicGuider에, 그다음 SAMPLER와 SIGMAS는 SamplerCustomAdvanced에, 그다음 VAE 디코드에 연결합니다. Euler, sgm_uniform, shift 5의 ModelSamplingSD3, 레이어 22 스킵은 모두 50스텝 교사 모델용 설정이므로 여기서는 추가하지 않아야 합니다. 스텝은 rapid-moss의 경우 14, 8스텝 체크포인트의 경우 18이며, strength 1.0이 권장 기본값입니다.
두 개의 워크플로가 포함되어 있습니다. 네이티브 워크플로는 표준 ComfyUI 로더를 사용합니다. Comfy-Org/MOSS-Image의 moss_image_sft_bf16.safetensors, 타입 moss_image의 CLIPLoader, 그리고 FLUX.2 VAE입니다.
두 번째 워크플로는 OpenMOSS 자체의 moss-image HF Loader 노드를 유지하고 로컬 Diffusers 디렉터리를 가리킵니다:
comfyui/rapid-moss/를 ComfyUI/custom_nodes/rapid-moss/로 복사하고 재시작합니다.
2. lora.safetensors, time_embedding.safetensors, dataspace.safetensors를 ComfyUI/models/rapid_moss/rapid-moss-4step/에 넣습니다. models/rapid_moss/ 아래의 각 하위 폴더가 노드의 adapter 메뉴 항목이 되므로, 8스텝 파일은 두 번째 폴더에 넣습니다.
3. 워크플로를 로드하고 어댑터를 선택한 뒤 베이스 디퓨전 모델을 bf16 또는 fp32의 SFT 가중치로 설정합니다.
나란히 비교한 결과
17개의 평가 프롬프트에서 작성자는 4스텝으로 실행한 8스텝 체크포인트보다 더 많은 배경 디테일과 더 생동감 있는 구도를 보고했으며, 수직 포스터에서 중복된 "夏"가 수정되었고, 포스트잇, 표지판, 말풍선의 일본어 텍스트도 정확하게 유지됩니다.
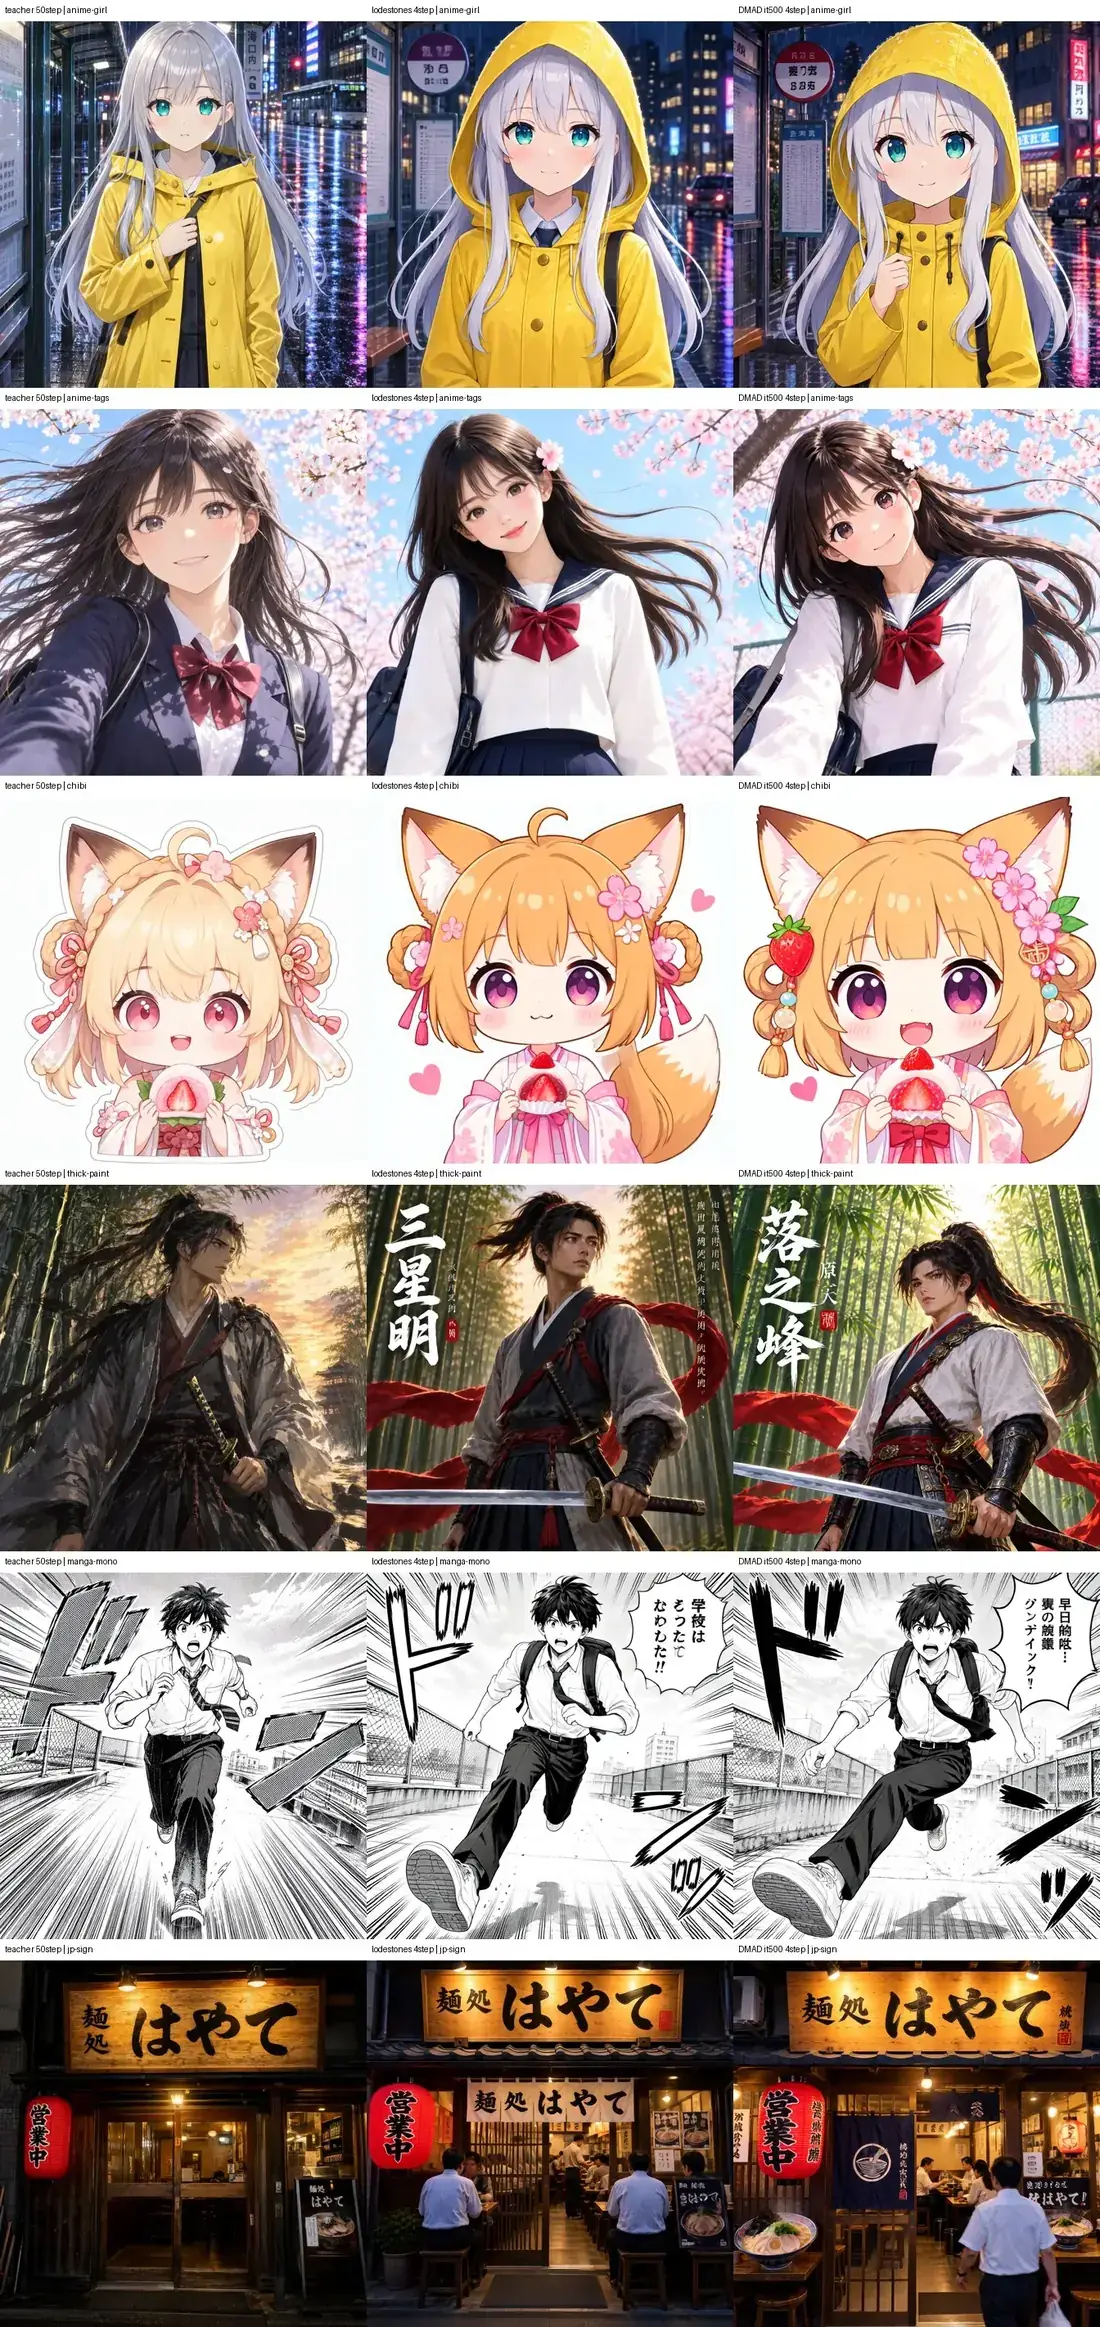
교사 모델, 4스텝으로 실행한 8스텝 체크포인트, 4스텝 어댑터. 출처: darask0
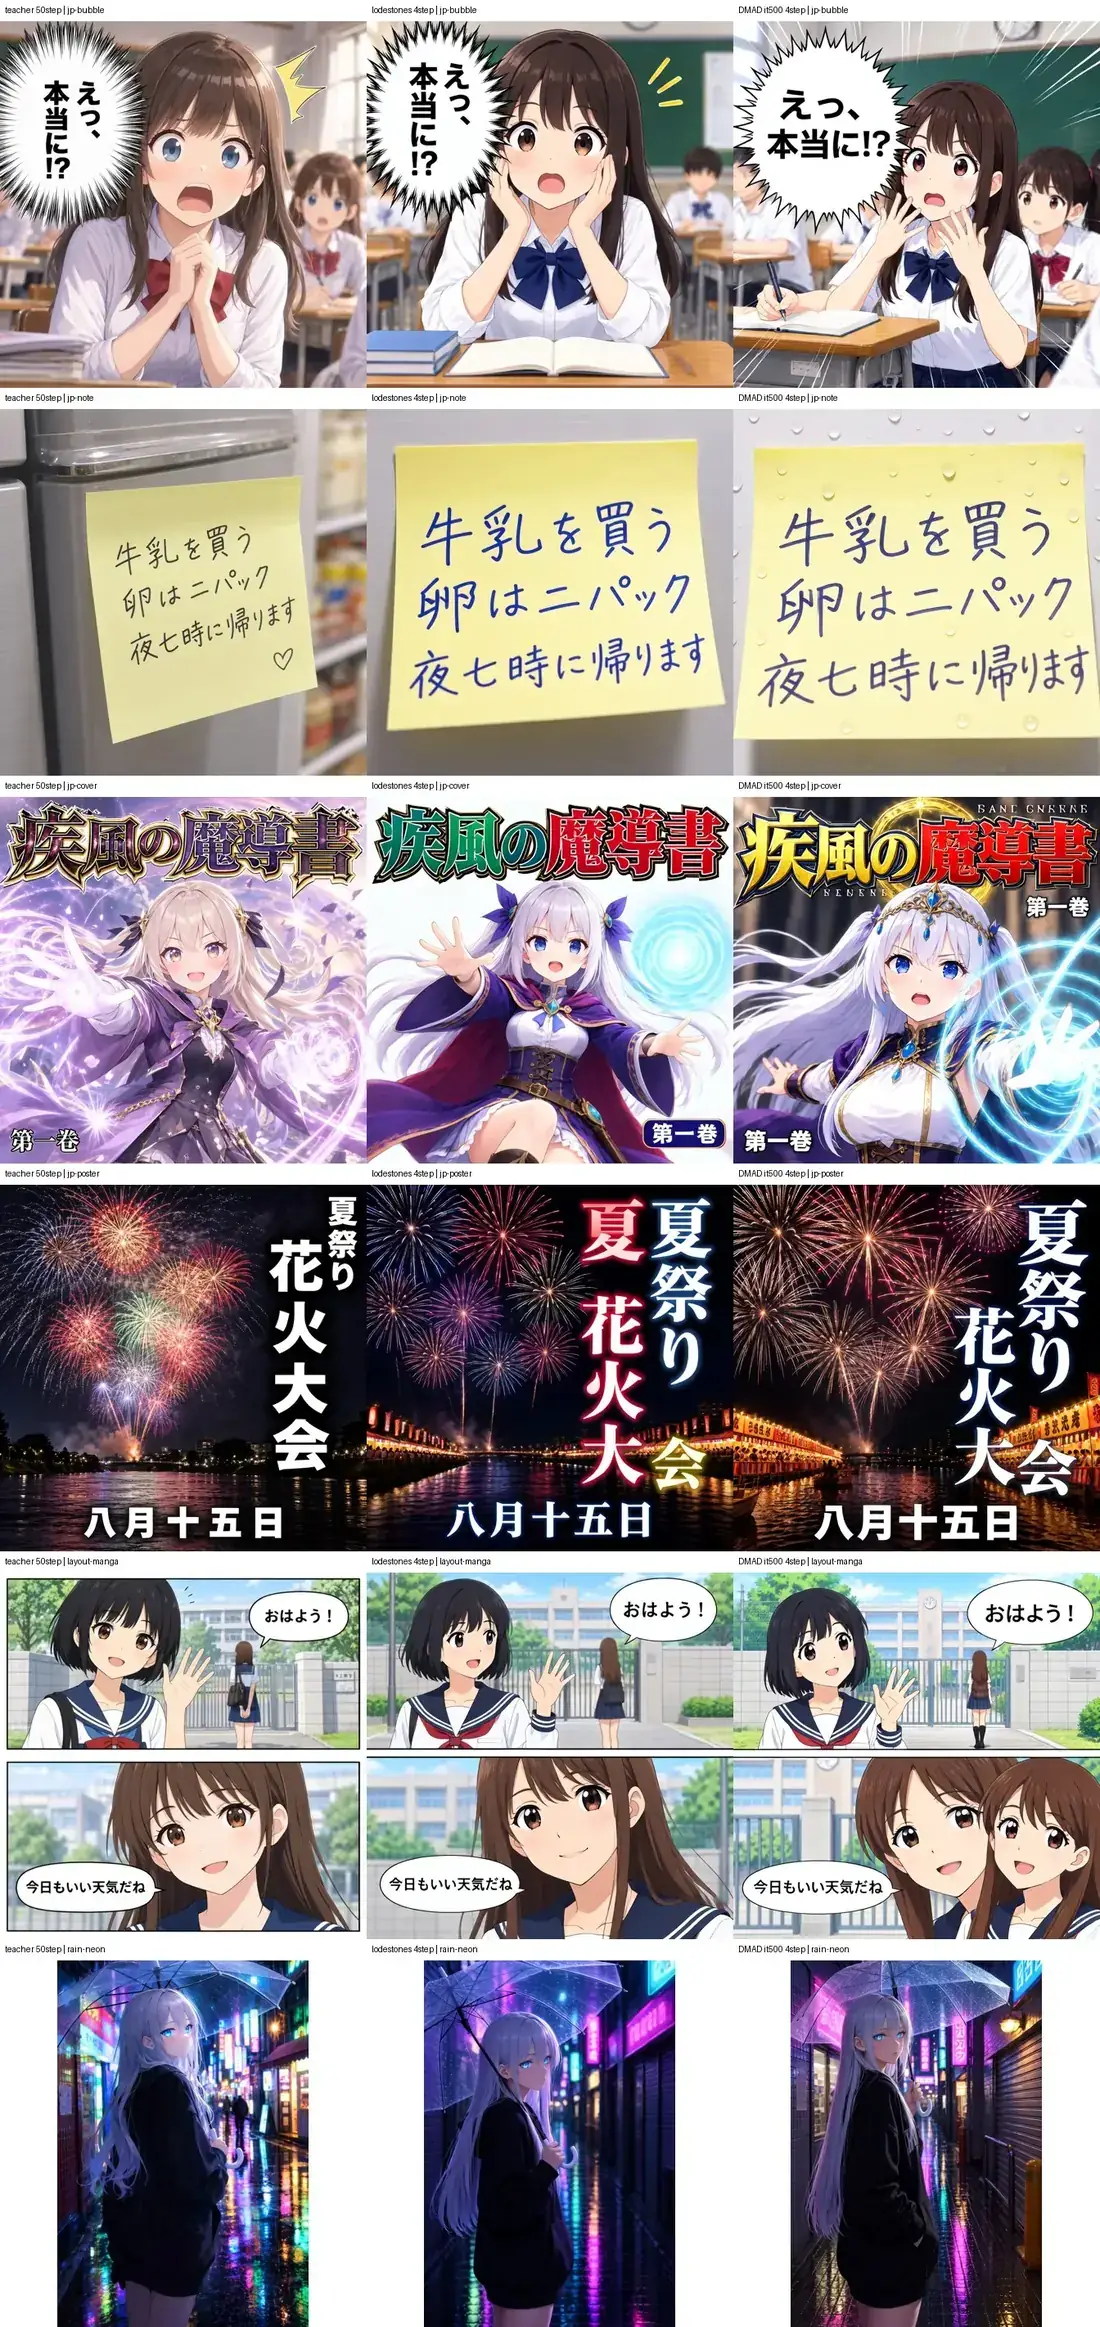
두 번째 프롬프트에서의 동일한 3자 비교. 출처: darask0
작성자는 문제를 감추지 않고 회귀도 나열합니다. 라이트 노벨 표지에 엉뚱한 라틴 문자가 나타나고, 두 패널 만화를 요청한 JSON 레이아웃 요청에서 아래 패널에 요청하지 않은 두 번째 인물이 추가되었으며, 상점 커튼과 만화 말풍선의 작은 텍스트는 여전히 실패합니다. 품질은 50스텝 교사 모델보다 낮습니다.
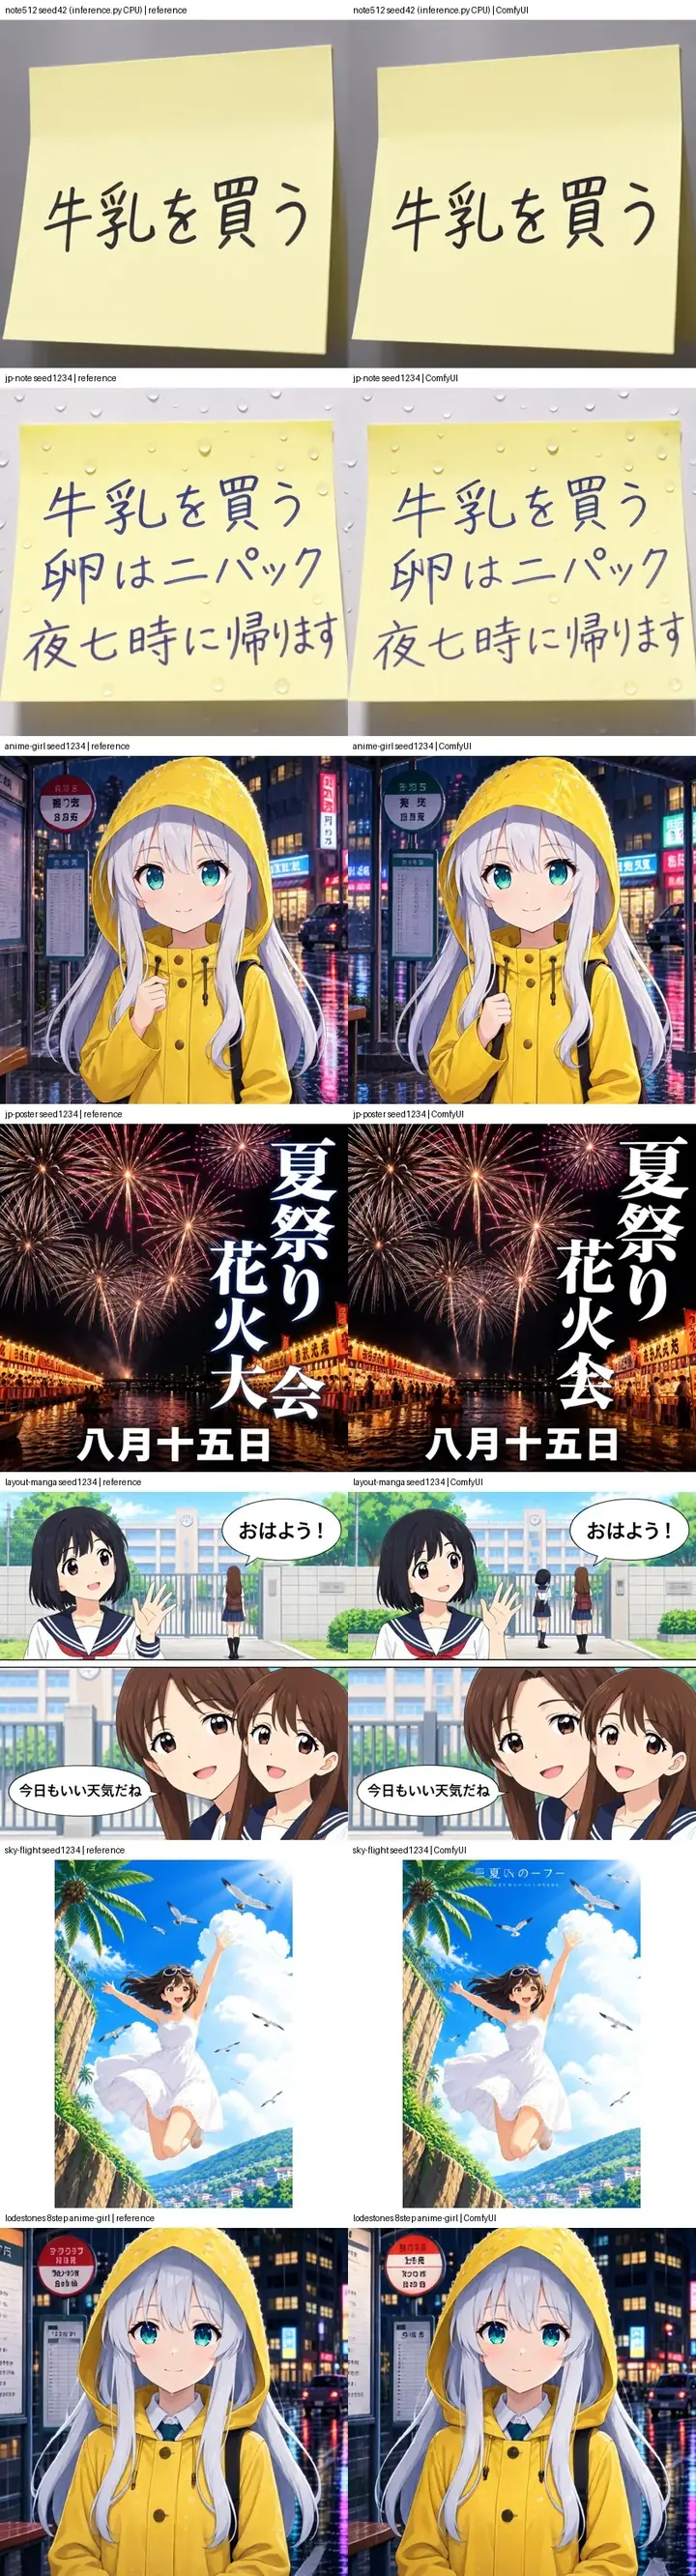
ComfyUI 내부의 rapid-moss 노드로, fp32 어댑터가 BasicGuider와 SamplerCustomAdvanced에 연결되어 있습니다. 출처: darask0
8스텝 체크포인트 단독 사용
lodestones는 이전 8스텝 체크포인트를 10월 16일 작업 진행 중 상태로 공개했습니다. 이는 파일만 제공됩니다. strength 1.0의 lora.safetensors, 또는 0.7의 lora_latest.safetensors, 그리고 동일한 time_embedding.safetensors와 dataspace.safetensors입니다. 자체 카드는 8스텝 가중치에 표준 ComfyUI LoRA 로더를 사용하라고 안내하는 반면, rapid-moss 노드는 4스텝 델타에 필요한 fp32 경로로 두 어댑터를 모두 구동할 수 있습니다.
ComfyUI 외부에서 어댑터를 실행하는 경우, 4스텝 저장소의 inference.py가 샘플러를 그대로 재현합니다. 초기 노이즈 텐서를 고정하고, dataspace.safetensors의 128x128 행렬을 통해 현재 추정값과 혼합하고, 동일한 파일에서 스텝 코드를 읽습니다.
사용 가능 여부
- 4스텝 어댑터: darask0/MOSS-Image_4-step_adapter_lora에 학습 코드, 로그, 평가 프롬프트, ComfyUI 노드가 포함되어 있습니다.
- 8스텝 체크포인트: lodestones/MOSS-Image-SFT-8-steps-dmd와 공개 데모 Space.
- 베이스 모델: OpenMOSS-Team/MOSS-Image-SFT 및 Comfy-Org/MOSS-Image의 ComfyUI 재패키지.
댓글
GitHub로 로그인하고 토론에 참여하세요.