Fizgig LoRA Isolation: 한 사람의 얼굴이 모두에게 번지는 것을 막는 ComfyUI LoRA 학습
Fizgig v8.4.0은 DOP, 융합 트리거 토큰, 네거티브 페어 학습을 결합한 LoRA Isolation을 추가해 Krea 2에서 낯선 사람의 얼굴 누출을 48/50에서 0/50으로 줄입니다.
Fizgig v8.4.0은 캐릭터 LoRA를 위한 학습 모드인 LoRA Isolation을 추가했습니다. 이 모드는 피사체의 얼굴이 이미지 속 다른 모든 사람에게 번지는 것을 막습니다 (릴리스 노트 | 기술 문서 | 데모 비디오). 한 인물의 일반적인 LoRA는 그 얼굴을 배경의 낯선 사람, 옆에 서 있는 친구, 또는 군중 전체에 끌어다 붙입니다. LoRA Isolation을 사용하면 학습된 피사체들이 한 이미지에 함께 서 있거나, 모델이 이미 알고 있는 사람 옆에 서 있어도 각 얼굴이 고유하게 유지됩니다. 트리거 단어 없이 프롬프트를 쓰면 학습 전과 마찬가지로 베이스 모델 고유의 사람들이 나옵니다.
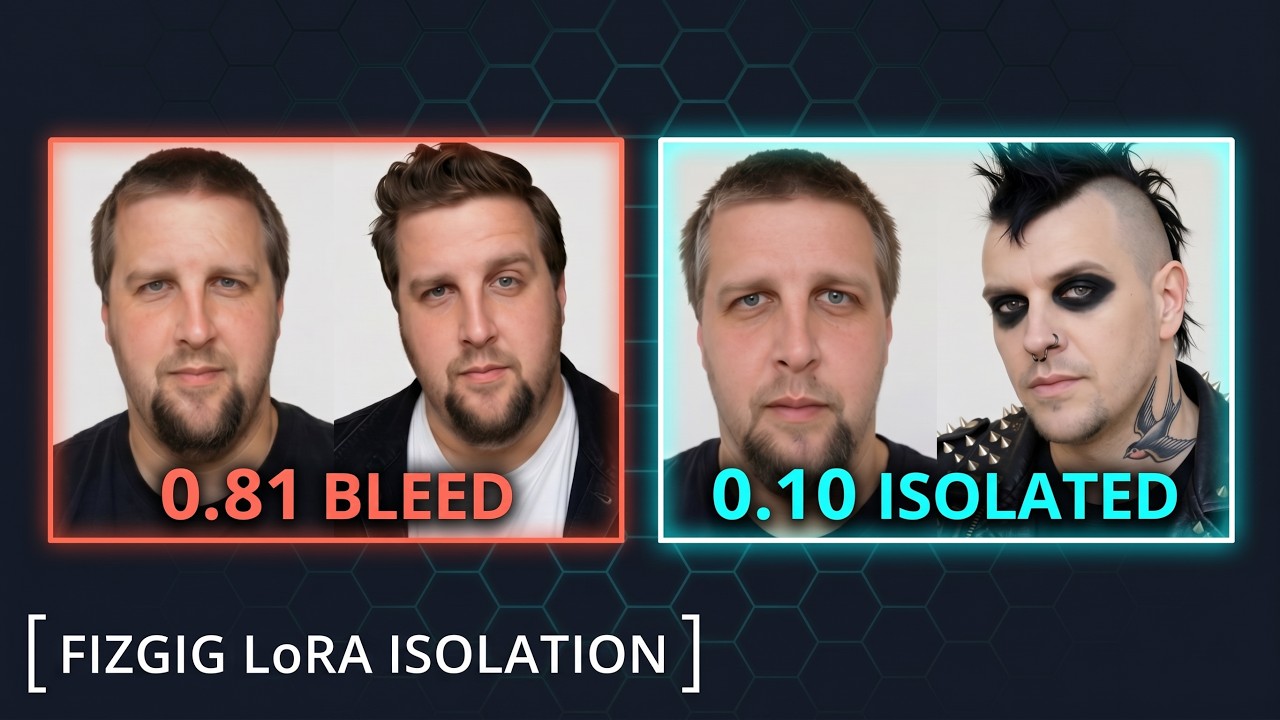
Fizgig LoRA Isolation, Fizgig 작성자의 데모 비디오. 소스: Fizgig v8.4.0 릴리스 노트
결과
동일한 사진, 설정, 시드, 에폭으로 Krea 2에서 두 개의 LoRA를 학습했으며, LoRA Isolation만 달랐습니다. 두 LoRA 모두 두 사람(피사체와 두 번째 캐릭터로서의 친구)과 페이퍼컷 스타일을 학습했습니다. 그다음 각 LoRA를 25개 프롬프트에 두 개의 시드로 렌더링해 총 50장의 이미지를 만들었습니다. 모든 이미지는 분할 프레임입니다. 한쪽에는 다르게 세심하게 묘사된 백인 남성이, 다른 쪽에는 마찬가지로 백인 남성인 학습된 피사체가 놓입니다. 이 조합은 누출에 가장 어려운 사례로 의도적으로 선택했습니다. 각 절반은 ArcFace(insightface buffalo_l)로 35장의 학습 사진에서 얻은 피사체의 평균 얼굴과 비교해 점수를 매겼으며, 같은 사람은 보통 0.45 이상, 관련 없는 사람은 0.0~0.2의 점수를 받습니다.
| 일반 LoRA | Fizgig LoRA Isolation | |
|---|---|---|
| 피사체로 인식된 낯선 사람 | 50명 중 48명 | 50명 중 0명 |
| 피사체가 자기 모습과 닮은 정도 | 0.77 | 0.78 |
닮은 정도는 떨어지지 않습니다. 피사체 본인의 실제 사진들은 서로 비교했을 때 0.81을 기록하고, 이 렌더링들은 두 번째 인물과 LoRA를 공유하면서도 0.78에 도달합니다. LoRA에 두 번째 인물이 있는 것은 보통 문제이지만, 여기서는 해결책의 일부입니다.
작동 방식
Fizgig LoRA Isolation을 Subjects 카드에서 선택하면 Fizgig가 여섯 가지 요소를 적용합니다.
DOP: 차분 출력 보존(Differential Output Preservation)
모든 학습 이미지는 캡션에서 트리거를 제거한 상태로도 학습되며, 이때 LoRA는 동일한 노이즈 입력에 대한 베이스 모델 자체의 예측에 맞춰집니다. 트리거가 없으면 LoRA는 아무것도 바꾸지 않는 것을 배우므로, 피사체를 지칭하지 않는 프롬프트에는 피사체가 나타나지 않습니다. Fizgig는 DOP 공로를 Ostris와 AI-Toolkit에 돌리며, 그 위에 자체 레이어를 구축합니다.
다중 피사체 정체성 고정
두 명 이상의 정체성을 함께 학습하며, 각각은 고유한 트리거를 가진 자체 폴더에서 가져옵니다. 나란히 학습된 두 얼굴은 얼굴이 일반적인 클래스가 아니라 특정 트리거에 속한다는 것을 LoRA에 가르쳐 주며, 그래서 두 번째 인물이 방해가 아니라 도움이 됩니다. 위 테스트는 두 번째 피사체로 여성을 사용했고 모든 낯선 사람은 남성이었으므로, 이 효과는 성별에 국한되지 않습니다. 한 사람만을 위한 LoRA라도 두 번째 인물을 함께 학습하는 것이 권장됩니다.
융합 토큰 클래스 분리
트리거와 클래스 단어는 모든 캡션에서 하나의 단어로 병합되어, gwelt, a man은 gweltman으로 학습됩니다. 일반 클래스 토큰("man")은 모델의 다른 모든 남성이 공유하는 것이며, 피사체의 특징이 다른 사람에게 건너가는 다리 역할을 합니다. 트리거에 결합되면 클래스 단어는 다른 토큰이 되어, 피사체의 모습이 공유 토큰에 붙지 않습니다. Fizgig는 캡션을 읽는 시점에 결합을 적용하고 디스크의 캡션 파일은 그대로 둡니다. 트리거는 깔끔하게 결합되어야 합니다. fyxo에 woman을 더하면 f | yx | ow | oman으로 읽혀 융합 단어가 깨지므로, Subjects 카드에는 학습 모델 자체의 토크나이저로 결합을 테스트하는 Check a trigger word 버튼이 포함되어 있습니다.
한 프레임 안의 네거티브 페어 합성
각 인물은 16장의 나란한 이미지를 받습니다. 자신의 학습 사진 하나가 생성된 낯선 사람 옆에 하나의 2:1 프레임으로 배치되며, 피사체가 어느 쪽에 놓일지는 무작위로 정해집니다. 이는 한 이미지 안에서 "이 사람은 피사체이고 저 사람은 낯선 사람으로 남는다"를 가르치며, 바로 이 지점에서 일반 LoRA가 누출됩니다. 캡션은 낯선 사람을 먼저, 피사체를 두 번째로 묘사합니다. 이 모델들이 사용하는 텍스트 인코더는 인과적이어서 트리거 뒤의 모든 단어가 이미 트리거를 본 상태로 인코딩되기 때문입니다.
낯선 사람들은 8개 인종에 걸친 32명의 생성된 인물로 구성된 고정 세트이며, 20대부터 50대까지의 남녀입니다. 세트의 두 번째 버전은 자연스러운 피부 질감을 위해 Qwen Image 2.1에서 렌더링되어 LoRA를 조악한 피부로 끌어당기지 않으며, 실제 인물의 사진은 사용되지 않습니다. 이 세트는 Fizgig의 모델과 함께 다운로드되며 약 21MB를 차지합니다.
학습률 스케일링과 균형 샘플링
나란한 이미지들은 자체 스텝에서 두 배의 학습률로 학습되고, DOP는 두 번째 스텝마다 두 배 가중치로 실행되며, Balance the subjects는 더 작은 폴더를 반복해 각 피사체가 가장 큰 폴더와 비슷한 횟수로 학습되도록 합니다.
클래스 인식 학습 경로
각 피사체는 사람, 동물이나 사물, 또는 스타일이나 룩으로 읽힙니다. 사람은 융합 트리거와 나란한 이미지들을 받습니다. 동물이나 사물은 융합 트리거만 받습니다. 스타일이나 룩은 트리거를 작성된 그대로 유지하며, 스타일은 전체 이미지를 바꿔야 하므로 나란한 이미지들을 받지 않습니다.
숫자 뒤의 레시피
| 설정 | 값 |
|---|---|
| 모델 | Krea 2, Standard LoRA |
| 피사체 | 한 사람(사진 36장), 두 번째 사람(사진 53장), 페이퍼컷 스타일(이미지 8장), 균형 |
| Rank / alpha | 16 / 16 |
| 학습률 | Adaptive LR, 2e-4~4e-4, 상수 스케줄러 |
| 옵티마이저 | AdamW 8-bit, max grad norm 1, 배치 1 |
| EMA | 0.98 |
| 해상도 | 0.25 MP (496 × 496), 버킷 적용, 업스케일 없음 |
| 베이스 정밀도 | INT8 |
| 시드 | 42 |
| 체크포인트 | 에폭 20 |
| Isolation 추가 사항 | 인물당 16장의 나란한 이미지(2× 학습률), 두 번째 스텝마다 DOP(가중치 2) |
학습 시간은 같은 설정의 일반 LoRA보다 약 1.5배 길어집니다.
지금까지 알려진 내용
- 최대 4명의 피사체까지 잘 학습됩니다. 한 이미지에 학습된 두 사람과 모델이 이미 아는 사람을 함께 넣는 것은 거의 항상 잘 작동하며, 한 이미지에 학습된 사람이 셋 이상이면 성공과 실패가 갈립니다.
- 같은 클래스의 두 피사체(예: 두 여성)는 약 1.6배의 에폭이 필요합니다. 둘 다 동일한 "a woman" 보존 패스를 사용하며 그 클래스는 대략 두 배 더 강하게 고정되기 때문입니다.
- 결합된 단어로 프롬프트를 작성하세요. 예:
gweltman man at a cafe. 그리고 이미지 속 다른 사람들을 묘사하세요. LoRA가 스스로 이들을 분리하며, 묘사는 안전장치입니다. - 이 방법은 지금까지 Krea 2에서만 테스트되었습니다. ACE-Step을 제외한 Fizgig의 모든 모델에서 실행되며, MiniMax H3에서는 클립과 음성 파일을 폴더에서 제외하고 사진만으로 피사체를 학습합니다.
사용 방법
이 모드는 Training 탭의 Subjects 카드에 있습니다. 피사체 수를 선택하고, 각 피사체에 폴더를 지정하고, 무엇인지 지정한 다음, Your subject and other people을 Fizgig LoRA Isolation으로 설정하세요. 각 피사체 아래에 카드는 학습되는 단어, 캡션 중 하나, 학습에 사용될 나란한 이미지들을 표시하므로, 캡션 문제를 실행 이후가 아니라 이전에 발견할 수 있습니다.
Subjects 카드 설정하기: Fizgig 작성자의 워크스루 비디오. 소스: Fizgig v8.4.0 릴리스 노트
캡션 가이드: MULTI_PERSON.md. 같은 릴리스에서 2~4개의 피사체 폴더를 사용하는 다중 개념 학습이 H3뿐 아니라 모든 모델의 Standard LoRA와 파인튜닝에서 사용 가능해졌습니다.
사용 가능 여부
Fizgig는 Klein 9B, Krea 2, MiniMax H3, Qwen Image 2.1, Anima, Z-Image Turbo, ACE-Step XL을 위한 오픈소스 LoRA 및 파인튜닝 스튜디오이며(GitHub), v8.4.0이 현재 버전입니다. LoRA Isolation은 학습 측 기능이므로, 결과 LoRA는 Fizgig에서 학습한 다른 LoRA와 마찬가지로 ComfyUI에 로드됩니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.