H3 Anti-Burn LoRA: 연속 H3 클립의 얼굴 번짐 방지
MiniMax H3 연속 클립용 rank-32 LoRA로, lightx2v 8스텝 체인에서 얼굴 번짐을 +44%에서 0%로, 한 번도 학습하지 않은 turbo에서 +61%에서 +4%로 줄입니다.
diffusion_model.*)을 사용하므로 커스텀 노드가 필요하지 않습니다.
해결하려는 문제
긴 H3 비디오는 보통 체인 방식으로 만듭니다. 클립 2는 클립 1의 마지막 프레임에서 이어지고, 클립 3은 클립 2에서 이어지는 식입니다. 각 연속 클립은 넘겨받은 엔딩을 복사하면서 자기 자신의 오류를 조금씩 더합니다. 클립이 몇 개 쌓이면 얼굴이 번집니다. 피부와 선이 거칠고 새겨진 듯 변하고, 프레임 전체가 더 딱딱해집니다.
이 LoRA는 연속 패스에만 로드되어, 정상적으로 생성되는 첫 클립의 룩에 결과를 가깝게 유지합니다. 번짐이 시작될 여지가 없는 클립 1에는 명시적으로 사용하지 않습니다.
사용 방법
- 연속 클립만 렌더링하는 모델(클립 2부터)에
LoraLoaderModelOnly로 로드합니다. - 강도 0.5에서 시작합니다. 클립이 진행될수록 얼굴이 여전히 거칠어지면 올리고, 얼굴이 부드러워지거나 밀랍처럼 되면 내립니다.
- 강도는 turbo와 파이프라인에 따라 달라집니다. LoRA를 8비트 체크포인트에 병합하면 효과가 약해지므로, 값을 확정하기 전에 4~5개 클립 체인에서 여러 값을 시험해 보는 것을 권장합니다.
측정 결과
각 클립이 약 37초인 10개 클립 체인을 네 개의 장면(주방, 두 번째 시드를 적용한 같은 주방, 공원, 현관)에서 만들고, 설정별로 모든 체인의 평균을 냈습니다. "얼굴 번짐"은 클립 1과 클립 10 사이에 얼굴의 미세 텍스처가 얼마나 변했는지를 나타냅니다. 0은 클립 10이 클립 1만큼 깨끗하다는 뜻이고, 양수는 번졌다는 뜻이며, 음수는 클립 1보다 부드러워졌다는 뜻입니다.
| Turbo | LoRA 없음 | 0.4 | 0.5 | 0.6 | 0.8 |
|---|---|---|---|---|---|
| 학습에 없던 모델 (한 번도 학습 안 됨) | +61% | +29% | +4% | −13% | |
| HyperFlow 8스텝 | +25% | +4% | −1% | −14% | |
| lightx2v 8스텝 v1.0 768p | +44% | +14% | 0% | −7% | −37% |
| Larry Turbo v4 (스텝 600 EMA) | +261% | +212% | +159% | +57% |
학습에 없던 모델 항목이 가장 중요합니다. 이 LoRA는 Larry Turbo v4, HyperFlow, lightx2v로 학습되었지만, 한 번도 본 적 없는 네 번째 turbo에서도 0.6에서 +4%까지 억제했습니다.
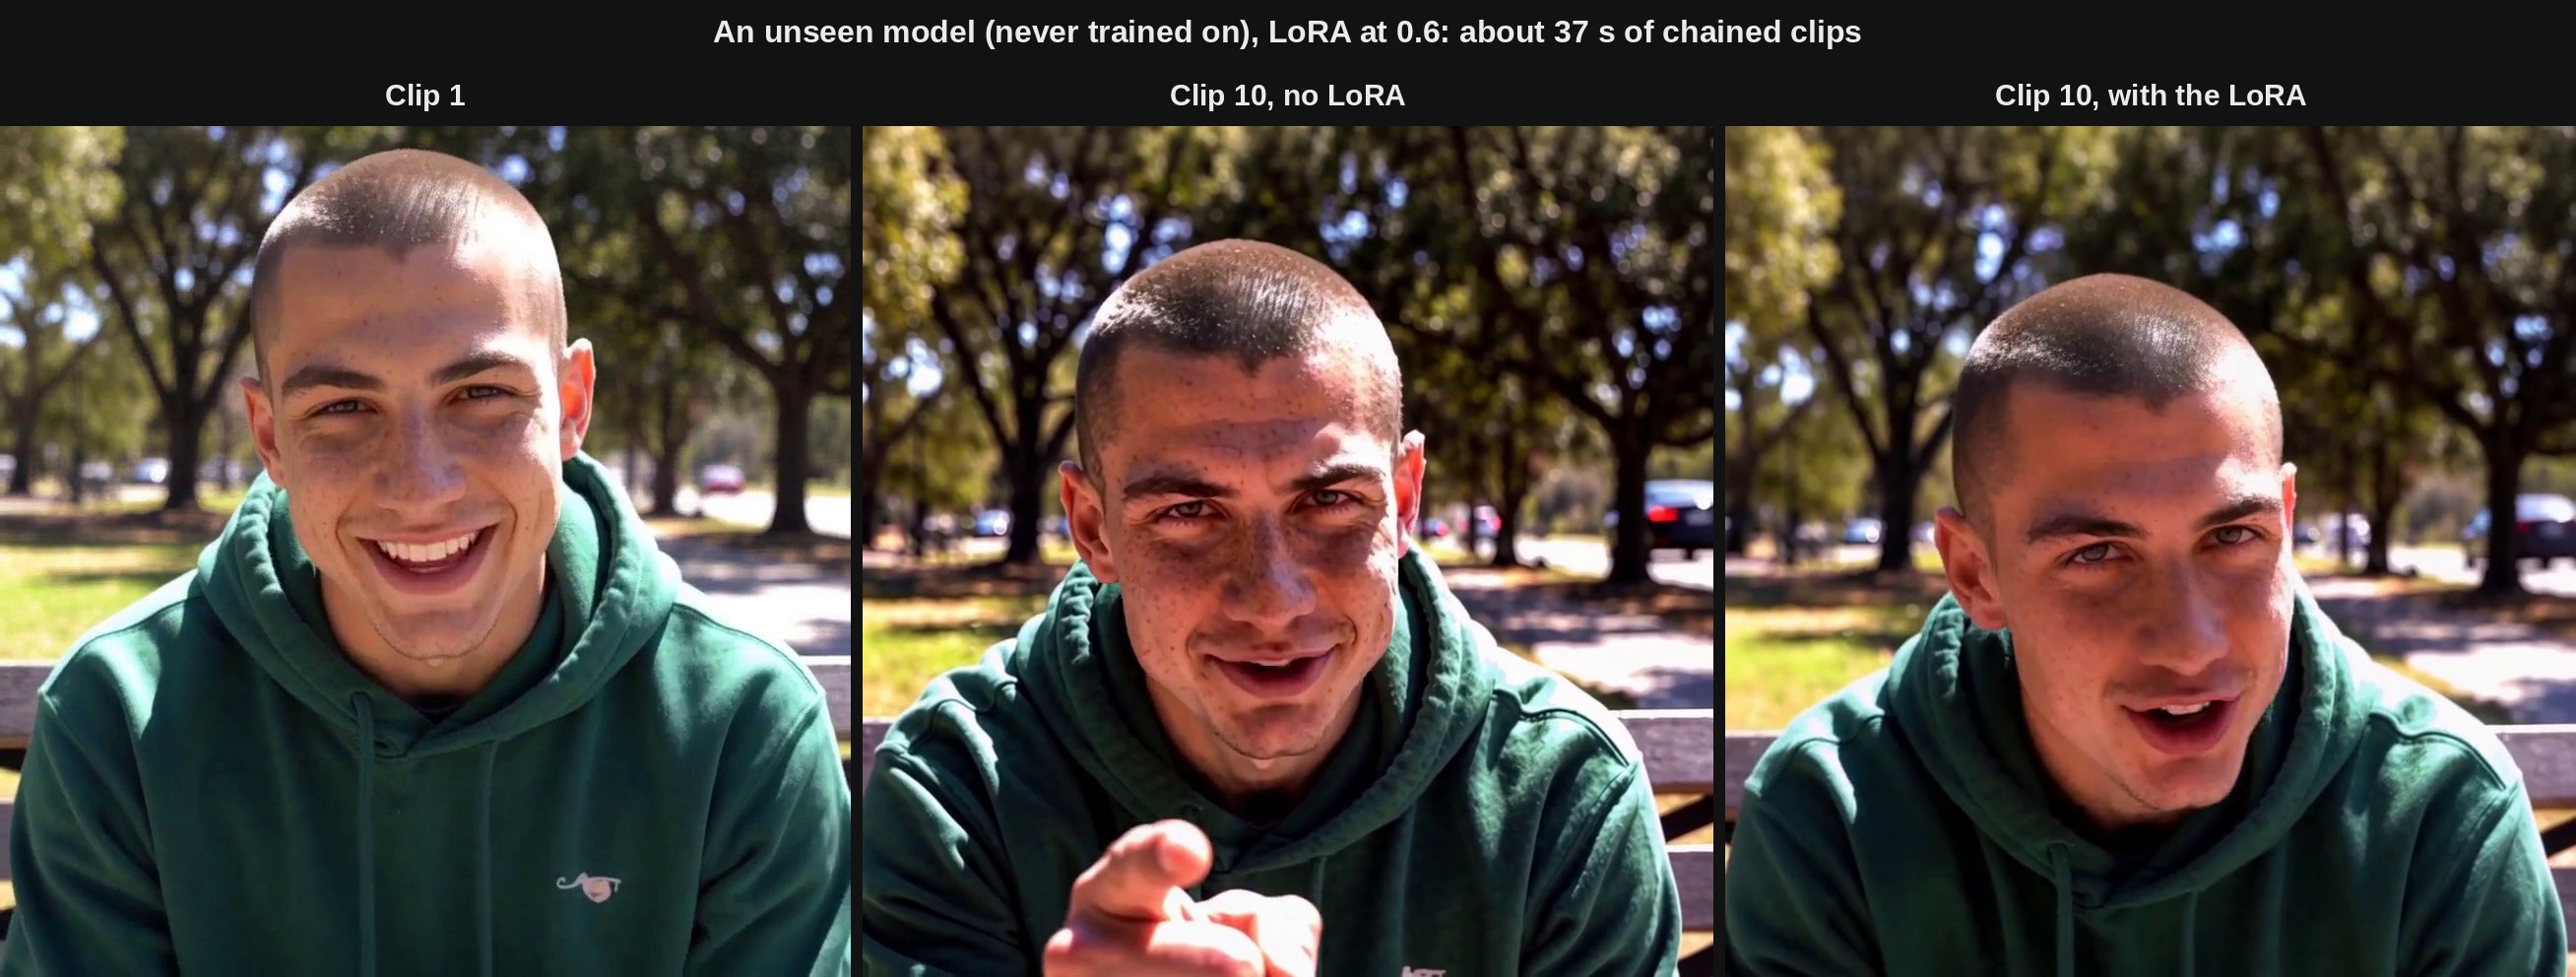
LoRA를 한 번도 학습하지 않은 turbo. 클립 1, LoRA 없이 만든 클립 10, 0.6으로 LoRA를 적용한 클립 10 순서입니다. 이 장면에서 얼굴 번짐은 +51%에서 −4%로 줄었습니다.
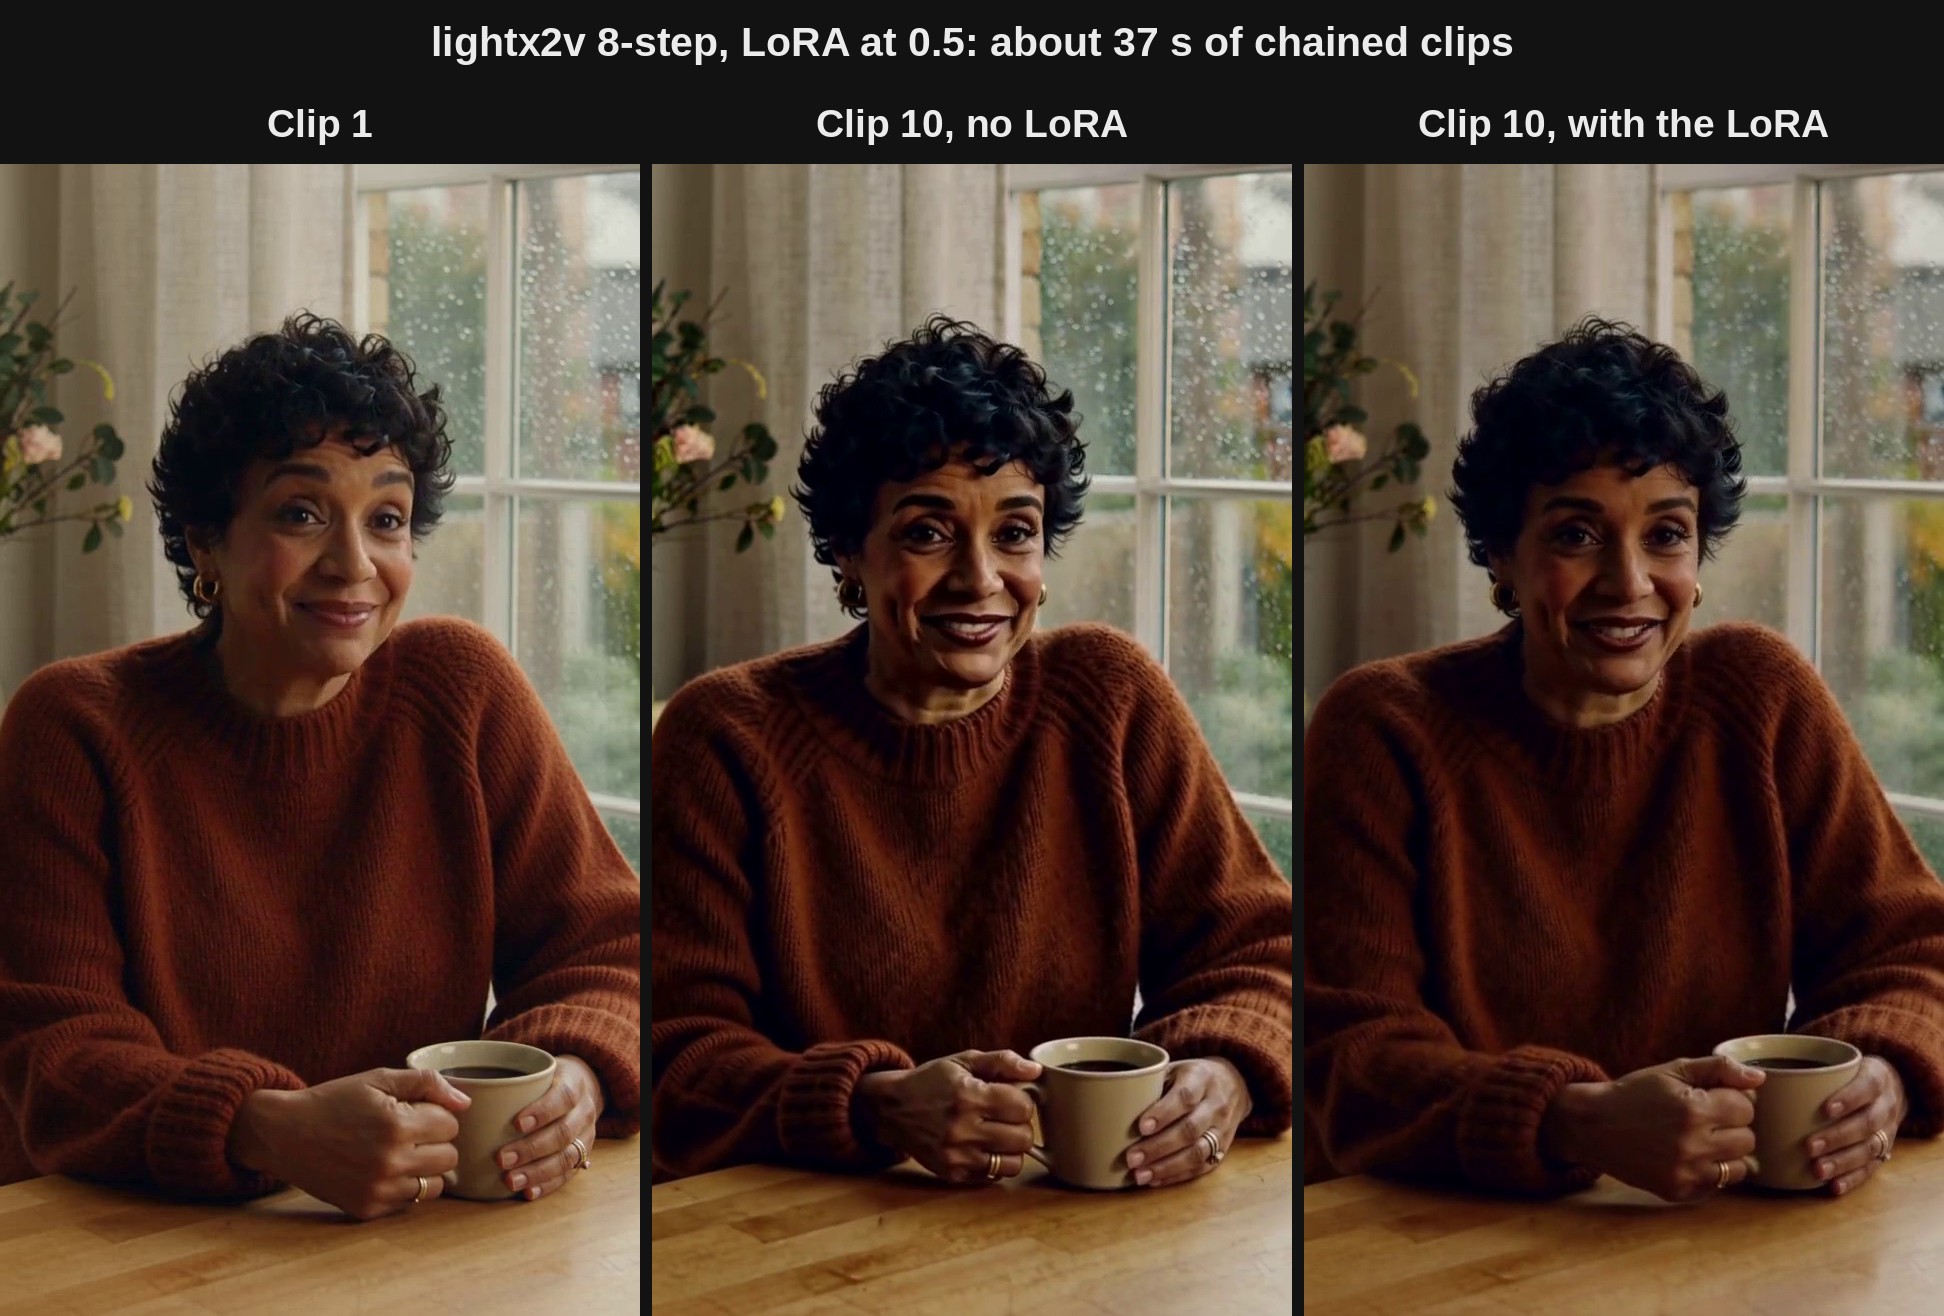
주방 장면의 lightx2v 8스텝 v1.0 768p: LoRA 없이 +52%, 0.5로 적용하면 +6%입니다.
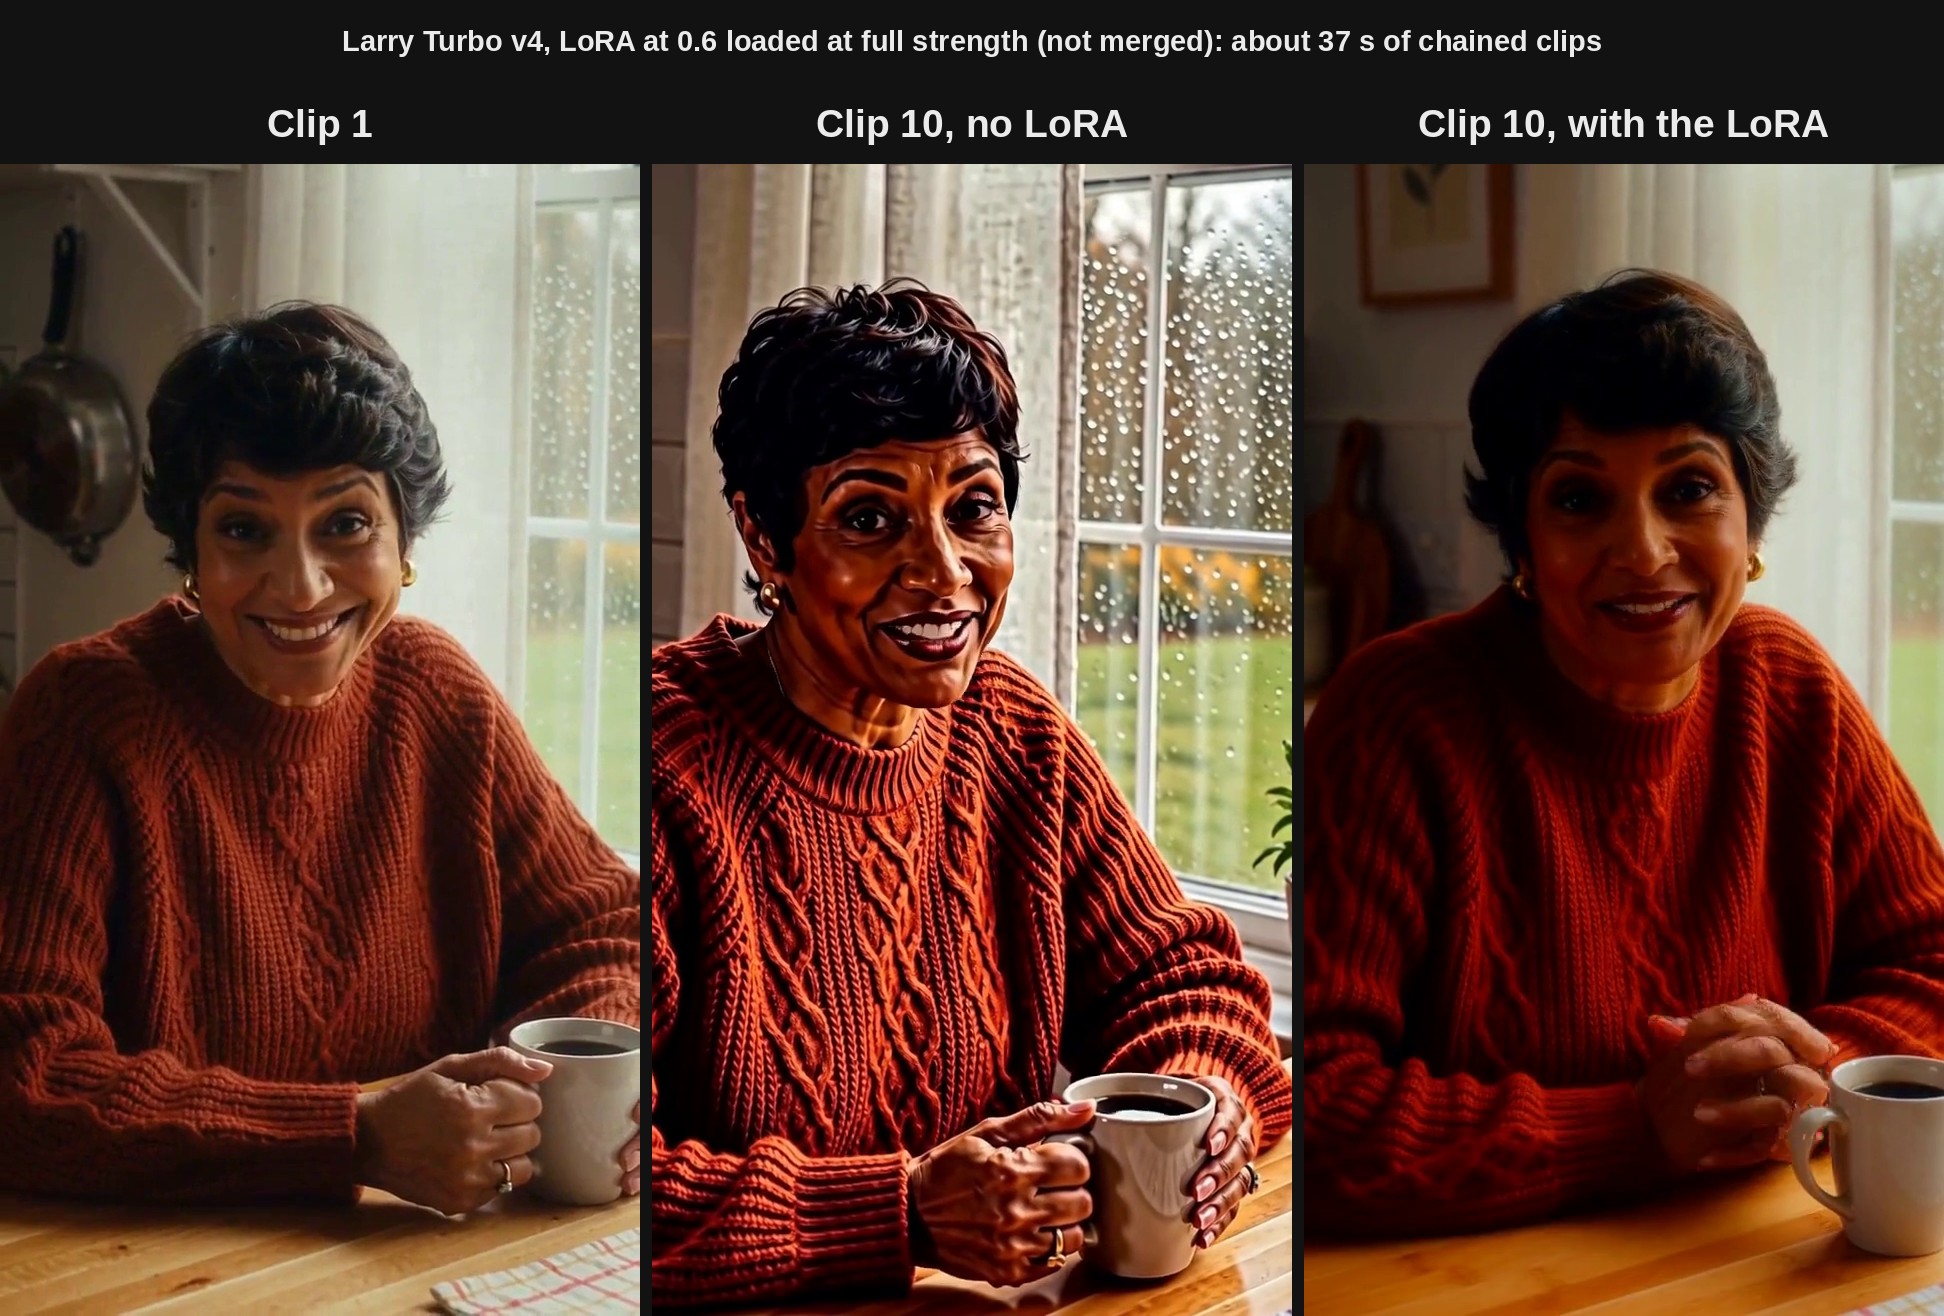
이 테스트에서 번짐이 가장 심한 Larry Turbo v4: LoRA 없이 +189%, 전체 강도로 로드한 0.6에서 −15%입니다. Larry는 여전히 이미지를 부드럽게 만들고 더 따뜻하고 어둡게 흘러갑니다.
Larry는 병합 설정에서 0.8보다 높은 값이 필요합니다. 1.0에서는 얼굴 번짐이 사라졌지만(−19%, 체인 2개) 카메라 프레이밍이 변하기 시작했습니다. 병합 대신 전체 강도로 로드하면 0.6에서 +261%가 −5%로 줄었습니다.
채도, 피부 붉은기, 립싱크는 LoRA를 사용하지 않았을 때와 같은 수준을 유지합니다. 세부 묘사는 소폭 감소하여 클립 1보다 414% 낮아지며, LoRA가 없을 때는 318% 높아집니다. 강도가 너무 높으면 얼굴이 부드럽고 밀랍처럼 보입니다.
수치 뒤의 설정
- Comfy-Org/MiniMax-H3의 ComfyUI int8 ConvRot 프루닝된 MiniMax H3 체크포인트를 사용했습니다. 클립 1은
fl2va, 연속 클립은ref2va를 사용합니다. - LoRA는 turbo LoRA 앞에서
LoraLoaderModelOnly로 병합합니다. - 각 연속 클립은 이전 클립의 마지막 39 프레임과 그 오디오를 보호된 마스크 컨텍스트로 전달받습니다.
- 8스텝, CFG 1, 640×1152, 1152×640, 864×864 해상도로 진행했습니다.
다른 체크포인트(bf16, fp8, GGUF), 다른 스텝 수, 다른 연속 방식에서는 다른 강도가 필요합니다.
한계
카드에는 적용 범위가 분명히 적혀 있습니다. 설정당 네 개의 장면은 작은 테스트이며, 10클립 체인 하나만으로도 ±15 포인트가 흔들릴 수 있습니다. 번짐을 예방하지만 이미 번진 비디오를 복구하지는 않습니다. 마스크 컨텍스트에서 이어지는 연속 클립에만 테스트되었고, 비디오를 확장하는 다른 방식에는 적용되지 않았으며, 중·근거리에 얼굴이 있는 말하는 사람만 검증했습니다.
학습 방식
학습은 궤적 자기 증류(trajectory self-distillation)입니다. 작성자는 각 turbo가 새로운 8스텝 생성에서 실제로 어떤 결과를 내는지 기록했으며, 총 150회의 풀사이즈 실행을 Larry, HyperFlow, lightx2v에서 각각 50회씩 진행했습니다. 그다음 LoRA를 연속 모드로 학습했습니다. 같은 비디오의 시작 부분을 보호된 컨텍스트로 고정하고 turbo 자체의 새로운 실행 결과를 대상으로 삼아, 연속 클립이 컨텍스트에 있던 것을 증폭하는 대신 새로운 생성처럼 보이도록 학습했습니다. 합성 번짐과 fresh-noise 손실은 사용하지 않았습니다. 이를 사용한 이전 버전들은 모든 것을 부드럽게 만들었습니다.
실행 설정은 300스텝, rank 32, 학습률 1e-4, 네트워크 가중치 0.6, 해상도 864, 124 프레임이었으며, 단일 RTX PRO 6000에서 진행했습니다.
사용 가능 여부
어댑터는 Hugging Face 저장소의 h3_antiburn_universal_v1.safetensors입니다. 416개의 tensor, bf16으로, 50개 DiT 블록과 2개 token-refiner 블록의 어텐션 및 MLP 레이어를 포함하며 adaLN은 없습니다. ComfyUI/models/loras/에 넣으면 됩니다. 학습 코드, 설정, 기록 및 채점 스크립트는 ai-toolkit 포크의 h3-antiburn 브랜치에 있습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.