ComfyUI-Drama3: Fish Audio Drama 3, 8GB 그래픽카드에서 로컬 실행
ComfyUI-Drama3는 8GB VRAM에서 Fish Audio Drama 3를 ComfyUI 안에서 실행하는 노드 팩으로, 음성 복제, 16명 화자 대화, 인라인 큐, Qwen3-ASR을 지원합니다.
ComfyUI-Drama3: Drama 3와 Qwen3-ASR을 ComfyUI 노드로 사용하며, 추가로 설치할 패키지가 없습니다.
Drama 3는 토큰당 3B 파라미터가 활성화되는 35B 전문가 혼합(mixture-of-experts) 텍스트 음성 변환 모델입니다. Fish Audio의 자체 패키지는 safetensors 샤드 8개와 코덱으로 구성되며 디스크에서 약 40GB이고, ComfyUI 파트너 노드는 API를 통해 이에 접근합니다. 이 팩은 로컬 경로를 택합니다. 공개된 체크포인트를 직접 로드하고, ComfyUI 안에서 오디오 코드를 생성하며, 같은 그래프에서 44.1kHz로 디코딩합니다.
8GB 그래픽카드에서 돌아가는 35B 모델
Drama 3는 Qwen3.5 스타일 전문가 혼합 모델입니다. 40개 레이어 각각에 256개의 라우팅된 전문가가 있고 그중 오디오 프레임마다 8개가 실행되며, 여기에 어텐션 또는 DeltaNet, 공유 전문가, 13개 레이어 코드북 디코더가 더해집니다. 라우팅된 전문가를 제외한 모든 부분은 약 6GB로 GPU에 상주합니다. 전문가를 RAM에 두면 32GB의 전문가 가중치가 고정된 시스템 메모리에 자리 잡습니다. 각 프레임은 레이어마다 필요한 8개 전문가를 복사하고, 남은 VRAM에 있는 최소 사용 빈도(LRU) 캐시가 다시 쓰이는 전문가를 붙잡아 두어 읽기의 85~95퍼센트가 13GB 캐시에 적중합니다.
이 팩은 체크포인트 빌드 4종을 제공하며, 컴퓨터마다 골라 쓸 수 있습니다:
| 파일 | 크기 | 전문가 | 전문가를 RAM에 둘 때의 RAM |
|---|---|---|---|
drama3_fp8experts_bf16 | 38.6 GB | FP8, Fish Audio가 배포하는 그대로 | ~48 GB |
drama3_int8experts_bf16 | 38.7 GB | int8 ConvRot | ~48 GB |
drama3_w6a8experts_bf16 | 32.7 GB | W6A8 | ~40 GB |
drama3_w4a8experts_bf16 | 24.6 GB | W4A8 | ~32 GB |
FP8은 Fish Audio 자체 전문가 가중치를 바이트 단위로 그대로 유지합니다. int8은 크기가 같으면서 RTX 3090에서 14~17퍼센트 더 빠르게 실행되었는데, int8 전문가는 int8로 실행되는 반면 FP8 전문가는 매 실행마다 bf16으로 변환되기 때문입니다. 더 작은 파일은 FP8 파일의 약 48GB RAM을 감당하기 어려운 컴퓨터를 위한 것입니다. experts를 RAM 대신 VRAM으로 설정하면 두 번째 GPU가 전문가 가중치를 맡을 수 있습니다.
음성, 대화, 큐
이 팩은 Drama 3 자체의 프롬프트 문법을 그대로 따르며, 기술 보고서에 문서화된 것과 동일합니다:
| 제어 | 작성 방법 | 예시 |
|---|---|---|
| 화자 | 줄 맨 앞에 <|speaker:N|>, N은 0부터 15 | <|speaker:0|> Ready? |
| 지점 태그 | 소리가 들어갈 자리에 [tag] | Well [sighs] fine, you win. |
| 범위 태그 | 영향을 주는 단어를 <tag>...</tag>로 감쌈 | Promise me <whisper>you won't tell her</whisper>. |
| 스타일 접두사 | 줄 맨 앞에 [style] | [with bright eager excitement] We won! |
| 연출 노트 | Direction:을 쓰고 다음 줄에 Line: | Direction: icy calm. |
| 언어 힌트 | 줄 뒤에 [language: xx], 발음되지 않음 | Welcome back. [language: en] |
하나의 텍스트를 최대 16명의 화자가 공유할 수 있고, 각자 음성 슬롯을 받습니다. 긴 텍스트는 태그를 쪼개지 않으면서 약 300바이트 단위로 잘립니다. 생성 방식에는 네 가지 모드가 있습니다. 줄마다 한 테이크, 앞 줄을 듣고 줄마다 한 테이크, 화자마다 한 테이크, 또는 전체 대본을 함께 생성해 모든 줄이 다른 줄을 듣게 하는 방식입니다. 디코딩은 개별 테이크를 0.3초의 무음으로 이어 붙이고, 긴 멈춤을 줄일 수 있습니다.
음성은 클립과 그 대본으로부터 한 번 인코딩되고, 그 후에는 output/drama3_voices에 몇 킬로바이트짜리 파일로 저장할 수 있어 이후 실행에는 클립도 코덱도 필요하지 않습니다. 생성된 테이크도 같은 방식으로 output/drama3_codes에 저장해 다시 생성하지 않고 재디코딩하거나 편집할 수 있습니다.
테이크 전사와 편집
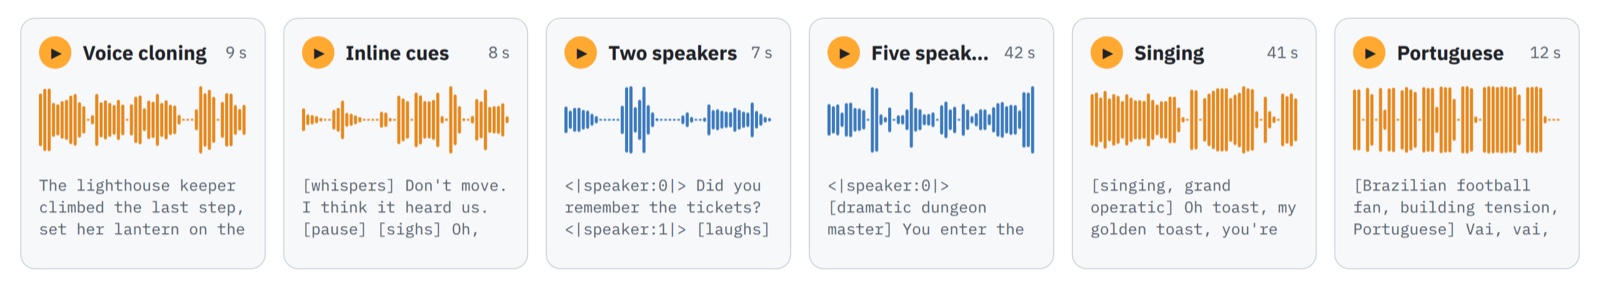
팩의 샘플 페이지에 있는 6가지 샘플: 복제, 큐, 두 화자 장면, 다섯 화자 장면, 노래, 포르투갈어. 각각 FP8 빌드로 RTX 3090 또는 RTX 4090에서 생성되었습니다.
음성 복제는 대본에서 시작하며, 이 팩이 대본을 제공합니다. Load Qwen3-ASR과 Qwen3-ASR Transcribe가 1.7B 또는 0.6B 음성 인식 모델과 강제 정렬기(forced aligner)를 추가 패키지 없이 30개 언어로 실행합니다. RTX 3090에서 6.6초 클립은 모델 로딩을 포함해 1.7B 모델로 약 2초, 0.6B 모델로 약 1초에 전사됩니다. 같은 정렬기가 Drama 3 Editor에 입력을 제공하며, 이 편집기는 ComfyUI 캔버스 위에 열립니다. 자막이 음성을 단어 단위로 따라가고, 음성마다 트랙이 하나씩 있으며, 편집기에서 컷을 넣고, 무음을 추가하고, 음성 이름을 지정하고, 볼륨을 설정할 수 있습니다. Use these edits를 누르면 해당 편집 내용으로 노드가 다시 실행되고, 내용은 워크플로에 남습니다.
속도
Drama 3는 음성 1초당 오디오 프레임 21.5개를 생성하므로, 프레임당 46ms가 실시간입니다. 프레임을 하나씩 디코딩하는 작업은 CPU에 묶여 있는데, 코어 하나가 작은 GPU 커널을 아주 많이 실행하기 때문입니다. 그래서 전문가 캐시 크기가 예상보다 속도를 적게 좌우합니다. 복제한 음성과 약 9초 분량의 음성으로, 프롬프트 처리를 포함해 Intel Core i9-14900K에서 측정한 결과입니다:
| GPU | 파일 | 전문가 캐시 | 프레임당 ms | 최대 VRAM |
|---|---|---|---|---|
| RTX 4090 | W4A8 | 16 GB | 52 | 21.3 GB |
| RTX 4090 | W4A8 | 4 GB | 67 | 11.7 GB |
| RTX 4090 | int8 | 16 GB | 69 | 21.5 GB |
| RTX 3090 | int8 | 16 GB | 69 | 21.6 GB |
| RTX 3090 | FP8 | 16 GB | 84 | 21.6 GB |
| RTX 3090 | FP8 | 4 GB | 119 | 11.9 GB |
| RTX 3090, 12GB로 제한 | FP8 | 자동 | 137 | 9.8 GB |
| RTX 3090, 8GB로 제한 | FP8 | 자동 | 214 | 6.5 GB |
마지막 두 행은 다른 프로세스가 3090의 나머지 메모리를 차지한 상태로 실행되었으며, 12GB 또는 8GB 그래픽카드를 대신한 것입니다. 작성자는 또한 Fish Audio의 서버가 top_k 30을 보내는데 이 때문에 멈춤 지점에서 테이크가 무음이 된다고 경고합니다. 그래서 노드는 기본값으로 Space 자체 설정인 temperature 1.0, top_p 0.9, top_k 상한 없음을 사용합니다.
시작하기
ComfyUI/custom_nodes/에 클론하고 ComfyUI를 재시작하세요. pip install이 필요한 것은 없습니다. 노드는 ComfyUI에 이미 포함된 것만 사용합니다.
cd ComfyUI/custom_nodes
git clone https://github.com/PedroMarinhoDev/ComfyUI-Drama3
가중치 다운로드
체크포인트는 models/diffusion_models에, 코덱은 models/vae에, ASR과 정렬기 파일은 models/asr에 넣습니다:
hf download PedroMarinhoDev/Drama-3-ComfyUI drama3_fp8experts_bf16.safetensors --local-dir ComfyUI/models/diffusion_models
hf download PedroMarinhoDev/Drama-3-ComfyUI drama3_codec.safetensors --local-dir ComfyUI/models/vae
hf download PedroMarinhoDev/Qwen3-ASR-ComfyUI qwen3_asr_0.6b_bf16.safetensors --local-dir ComfyUI/models/asr
워크플로 실행
예제 워크플로를 ComfyUI로 끌어다 놓고, 오디오 로드에서 몇 초 분량의 깨끗한 음성을 고르고, Drama 3 Generate에 텍스트를 작성한 뒤 큐에 넣으세요.
이용 가능 여부
노드 팩: PedroMarinhoDev/ComfyUI-Drama3
가중치: PedroMarinhoDev/Drama-3-ComfyUI · PedroMarinhoDev/Qwen3-ASR-ComfyUI
샘플: pedromarinhodev.github.io/ComfyUI-Drama3
베이스 모델: fishaudio/drama-3 · Drama 3 뉴스
댓글
GitHub로 로그인하고 토론에 참여하세요.