SMD: 이미지, 비디오, 3D, MiniMax H3를 위한 4스텝 증류
Simplified Matching Distillation은 few-step diffusion을 위한 회귀 전용 레시피입니다. student는 FLUX, Qwen-Image, Wan2.1, MiniMax H3, 3D를 아우르며, H3용 ComfyUI 워크플로를 제공합니다.
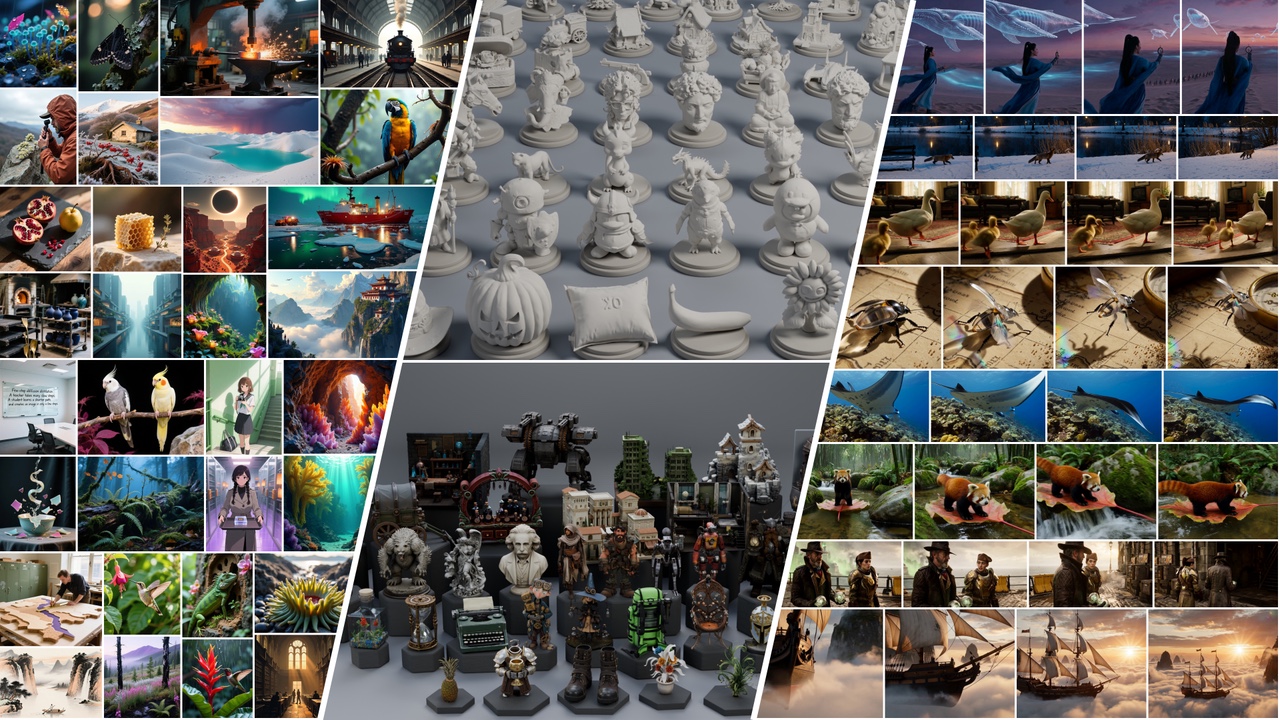
공개된 SMD student의 출력: 이미지 생성 및 편집, 3D 에셋, 그리고 오디오가 동기화된 비디오.
SMD가 바꾸는 것
SMD는 순수한 on-policy velocity 회귀에서 출발합니다. student는 teacher 샘플이 아니라 자신의 궤적에서 학습됩니다. 나머지 방법론은 두 가지 추가 요소가 담당합니다. Pivot은 학습 전용 잔차 프록시로, teacher가 거친 전환 안에서 수행하는 국소적 보정을 student 자신의 구간 평균 예측과 분리해, 4스텝 student가 스스로는 표현할 수 없는 teacher의 velocity 변화를 표현할 수 있게 합니다. 두 번째는 student를 더 약한 teacher 예측으로부터 밀어내는 반발 항으로, 논문에서는 바람직하지 않은 모드를 피하는 가벼운 방법이라고 설명합니다.
추론에는 아무것도 추가되지 않습니다. 온라인 score 추정도, fake-score 모델도, 적대적 discriminator도 없으며, 배포되는 generator는 아키텍처를 그대로 유지합니다. 그래서 같은 방법을 기존 checkpoint 위에 LoRA로 얹거나 full denoiser로 같은 릴리스에 담아낼 수 있습니다. 논문은 330억 파라미터까지의 확장과 cross-model, multi-teacher, causal-video 증류 지원을 보고합니다.
공개된 내용
| 작업 | Student | 형식 |
|---|---|---|
| 텍스트에서 이미지로 | FLUX.1-dev, Qwen-Image, SD3.5-Medium, FLUX.2 Klein 4B, Lens | LoRA, SD3.5는 full transformer로도 제공 |
| 이미지 편집 | Qwen-Image-Edit-2511 | LoRA |
| 텍스트에서 비디오로 | Wan2.1 1.3B, Wan2.1 14B, causal Wan2.1 1.3B | LoRA |
| 오디오-비디오 | MiniMax H3 T2VA 4스텝 및 8스텝, H3 Ref2VA 4스텝 및 8스텝 | LoRA 어댑터 |
| 이미지에서 3D로 | Hunyuan3D-2.1 Shape, TRELLIS.2 shape 및 texture | 증류 단계별 LoRA |
두 개의 곁가지 분기는 단일 teacher 증류를 넘어섭니다. FLUX.2 9B는 Klein 4B와 Lens 모두의 teacher로 사용되며, SD3.5-Medium은 self, clipscore, geneval, ocr, pickscore, multi의 여섯 가지 변형으로 제공되는데, 각 전문 변형은 서로 다른 보상을 최적화합니다.
컬렉션의 모든 저장소에는 가중치와 함께 프롬프트 또는 참조 입력, seed, 샘플링 설정이 담긴 작업 완료 예제가 포함되어 있습니다. LoRA 패키지는 일치하는 베이스 모델과 리비전이 필요하며, full transformer는 여전히 encoder와 decoder를 베이스에서 가져옵니다.
릴리스 전반의 예시
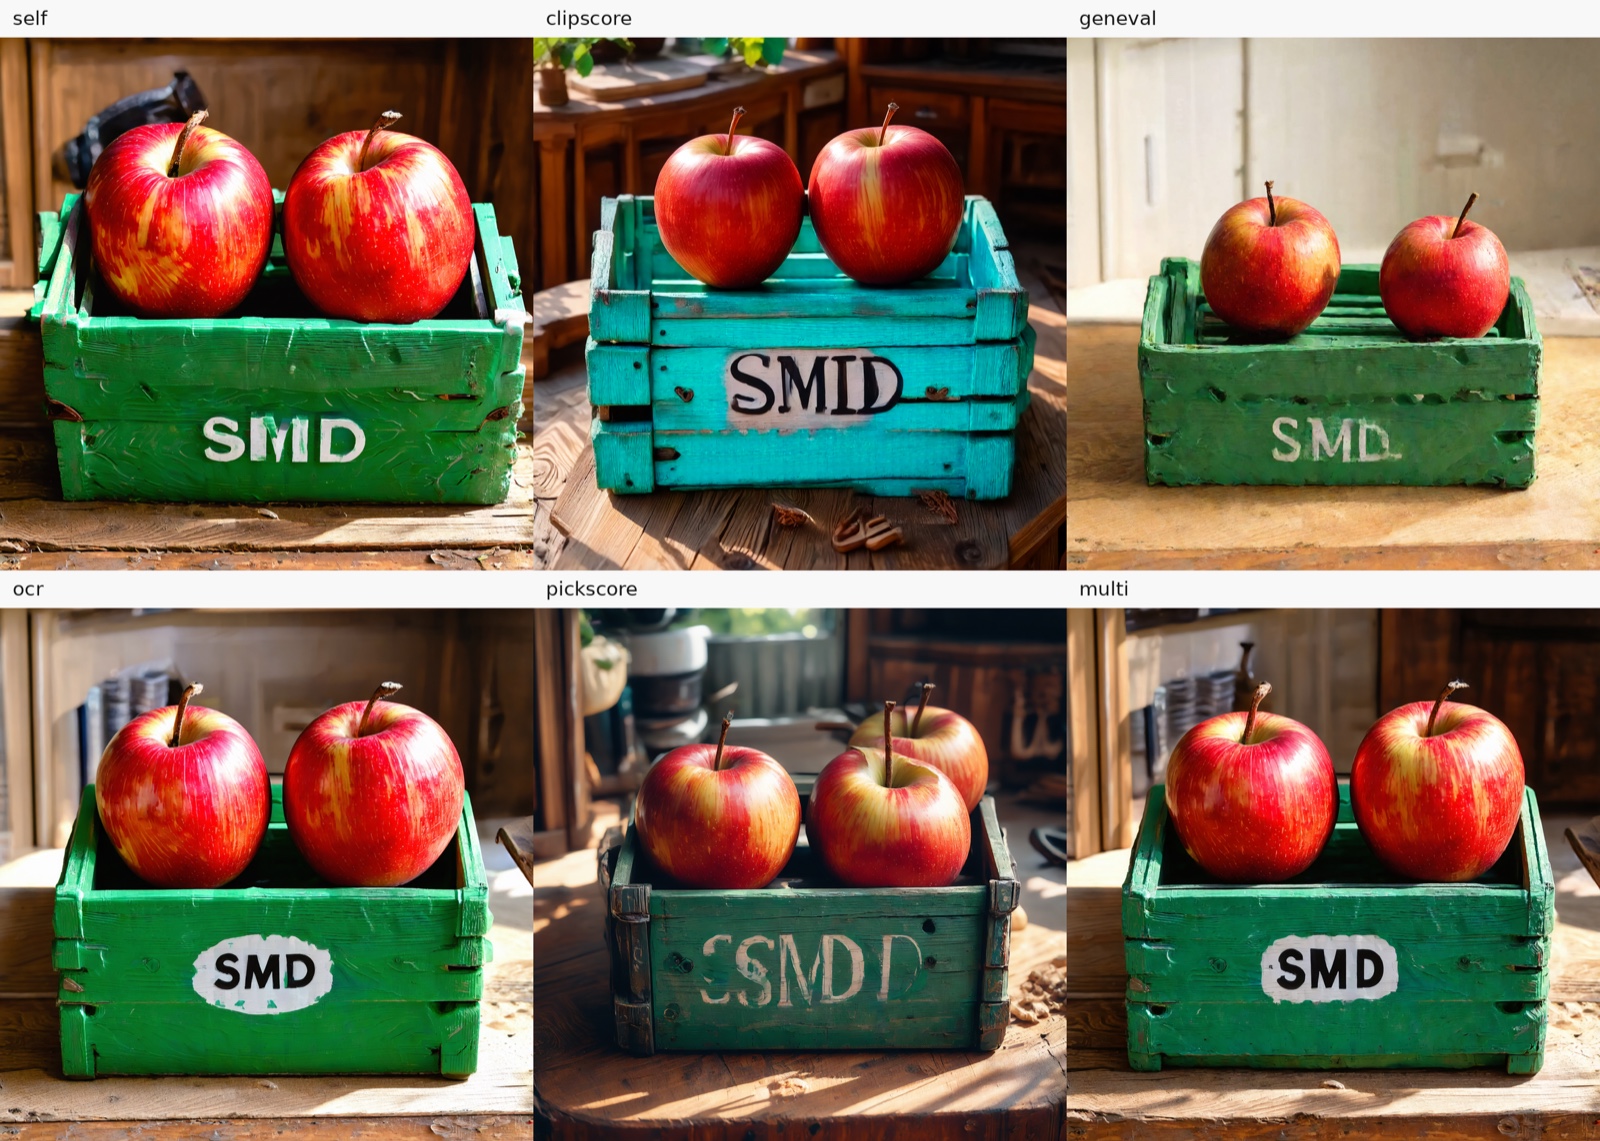
multi-teacher multi 변형을 포함해 나란히 비교한 여섯 가지 SD3.5-Medium student.
이미지 student는 각각 네 번의 샘플링 스텝을 사용하며, 모델 카드에는 이를 만들어낸 설정이 나와 있습니다. FLUX.1-dev에는 캔버스 토트백, Qwen-Image에는 애프터눈 티, Qwen-Image-Edit-2511에는 소스와 편집본 쌍, FLUX.2 Klein 4B와 Lens에는 두 teacher 비교가 있습니다. 비디오 쪽은 Wan2.1 14B와 causal 1.3B 모델에서 네 스텝으로 실행되며, 3D 쪽은 Hunyuan3D-2.1 Shape와 두 TRELLIS.2 단계 각각에 대한 4스텝 LoRA를 제공하고, 각각 턴테이블 비디오가 함께 제공됩니다.
ComfyUI에서의 MiniMax H3
네 가지 H3 student는 기본 ComfyUI 노드에서 실행되는 자체 패키지로 제공되며, 커스텀 노드 팩도, SMD 학습 저장소 체크아웃도 필요하지 않습니다.
| 패키지 | 스텝 | 예제 클립 |
|---|---|---|
| SMD-MiniMax-H3-T2VA-4step-ComfyUI | 4 | 텍스트에서 오디오-비디오로 |
| SMD-MiniMax-H3-T2VA-8step-ComfyUI | 8 | 텍스트에서 오디오-비디오로 |
| SMD-MiniMax-H3-Ref2VA-4step-ComfyUI | 4 | 참조 이미지에서 오디오-비디오로 |
| SMD-MiniMax-H3-Ref2VA-8step-ComfyUI | 8 | 참조 이미지에서 오디오-비디오로 |
각 패키지에는 변환된 LoRA, 완전한 워크플로, 예제 입력이 들어 있습니다. download_models.py는 모델 파일을 확인하고 예제 입력을 복사하며 워크플로를 ComfyUI의 기본 사용자 라이브러리에 추가하므로, Workflows 사이드바의 SMD 아래에 나타납니다. 워크플로 JSON을 캔버스로 끌어다 놓을 수도 있습니다. 참조 조건 그래프는 UNETLoader, LoraLoaderModelOnly, MiniMaxH3SigmaShift, MiniMaxH3ReferenceToVideo, ManualSigmas를 사용하므로 LoRA가 작업을 수행하고 샘플링 스케줄은 패키지에서 가져옵니다. 4스텝과 8스텝 사이를 전환하려면 해당 패키지의 워크플로와 LoRA를 열면 됩니다.
4스텝 Ref2VA 패키지로 만든 5초짜리 H3 참조-오디오-비디오 결과물이며, 저장소에 포함된 두 장의 참조 이미지로 생성했습니다.
패키지에서는 한 가지 함정을 경고합니다. H3 가중치를 ComfyUI의 기본 이미지 템플릿에 대입하면 audio_scale 누락 오류로 실패할 수 있으므로, 대신 패키지의 완전한 워크플로를 사용해야 합니다.
자신만의 student 학습하기
학습 코드는 추론 예제와 같은 저장소에 있습니다. Linux x86_64에서 Conda로 실행됩니다. environments/setup_conda.sh는 Python 3.12, PyTorch 2.7.1, CUDA 12.6 wheel로 환경을 구성하며, FlashAttention은 소스에서 컴파일합니다. 실행은 데이터 경로와 함께 학습 config 중 하나를 지정하는 torchrun 호출입니다. 예를 들어 Qwen-Image용 prompt 열을 담은 Parquet 파일과 GPU 두 개를 사용하며, --download-resources가 config에 필요한 항목을 내려받습니다.
학습은 NVIDIA FastGen을 학습 인프라로 기반으로 삼고 Hugging Face Diffusers의 모델 구현을 사용합니다. H3 내보내기 경로는 샘플링 메타데이터와 함께 LoRA 어댑터를 작성하므로 fused 베이스 checkpoint가 필요하지 않습니다. 저장소에는 환경 설정, 학습, 추론, 그리고 새 모델 온보딩을 위한 에이전트 스킬도 포함되어 있습니다.
한계
- 스텝 수와 품질 주장은 저자들의 것입니다. 4 NFE에서 SMD는 강력한 few-step 베이스라인을 능가하고 여러 벤치마크에서 multi-step teacher를 surpass한다고 보고됩니다. 이 수치는 논문에서 온 것이지, 여기서 독립적으로 재현한 결과가 아닙니다.
- 증류된 student는 자체 패키지의 베이스 리비전과 샘플링 설정에 묶여 있습니다. 특히 H3 student는 조건이 캐시된 LoRA 어댑터입니다.
- 학습 저장소는 Conda와 CUDA 12.6을 지원하는 NVIDIA 드라이버가 있는 Linux를 대상으로 합니다. 3D 단계에는 두 번째 환경이 필요합니다.
- 공개된 student 중 두 개의 H3 참조 조건 패키지가 지금까지 가장 많은 다운로드를 기록했으며(작성 시점 기준 약 1,500회와 1,200회), 이미지 및 3D 저장소는 아직 한 자릿수 또는 두 자릿수에 머물러 있습니다.
이용 가능
코드: zjwfufu/SMD
프로젝트 페이지: zjwfufu.github.io/SMD-Page
논문: arXiv 2610.18472
가중치: Hugging Face 컬렉션
데이터셋: zjwfufu/smd-data
H3 패키지: T2VA 4스텝 · T2VA 8스텝 · Ref2VA 4스텝 · Ref2VA 8스텝
베이스 모델: MiniMax H3
댓글
GitHub로 로그인하고 토론에 참여하세요.