Spark-H3: 블록 희소 어텐션으로 ComfyUI에서 MiniMax-H3 속도 향상
Spark-H3는 ComfyUI의 MiniMax-H3에 Spark-Attn 블록 희소 어텐션을 도입합니다. RTX 40 및 50 시리즈용 사전 빌드 노드와 10% 밀도에서 1.73배 빠른 DiT를 제공합니다.
프로젝트 저장소에서: 동일한 프롬프트, 시드, 스케줄을 Dense 어텐션, 10% 밀도의 Spark-H3, Sol-H3로 각각 렌더링한 결과.
Spark-Attn이 바꾸는 것
블록 희소 어텐션은 비디오 어텐션 연산을 두 갈래로 나눕니다. 상위 순위의 key/value 블록을 전부 계산하는 정확 분기와, 나머지 전체를 저렴하게 처리하는 압축 분기입니다. Spark-Attn은 이 두 부분을 모두 재설계했으며, Spark-H3는 그 MiniMax-H3 구현체입니다. 기술 블로그는 2026-09-23에 게시되었고 마지막 업데이트는 2026-10-08입니다.
- Spark-Reblock은 고정된 시공간 타일을 적응형 분할로 대체합니다. 두 query가 key에 대해 유사한 어텐션 점수 패턴을 만들면 유사한 것으로 간주하며, 이는 반대편의 2차 모멘트로 유도된 Mahalanobis 코사인 거리로 측정합니다. 계층적 분할기는 모든 리프가 목표 블록 크기를 가질 때까지 그룹을 계속 나누며,
O(N log N)시간에 수행됩니다. 따라서 블록 레이아웃은 고정된 이웃이 아니라 입력, 레이어, 헤드에 따라 결정됩니다. - Spark-Reweight는 압축 분기의 평균 풀링된 key/value 요약을 가중 요약과 log-mass 바이어스로 대체합니다. 평균 풀링은 어텐션이 정규화 전에 logit을 지수화하기 때문에 어텐션 질량을 과소평가합니다. 즉
E[exp(x)]대신exp(E[x])를 사용합니다. 바이어스가 누락된 질량을 복원하며, 스코어링은 헤드당 하나의 앵커로 비디오 query의 평균을 사용해 추가 비용을 선형으로 유지합니다.
두 부분 모두 10% Top-K 예산에서 개별적으로 측정되었습니다.
| 절제 실험 | 어텐션 질량 재현율 | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
| 고정 블록 분할 | 68.66% | 18.61 | 0.68 | 0.26 |
| + Spark-Reblock | 81.54% | 22.41 | 0.80 | 0.14 |
압축 분기의 경우:
| 절제 실험 | 절대 log-mass 오류 (nats) | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
| 평균 풀링 | 3.86 | 18.61 | 0.68 | 0.26 |
| + Spark-Reweight | 2.78 | 19.17 | 0.70 | 0.24 |
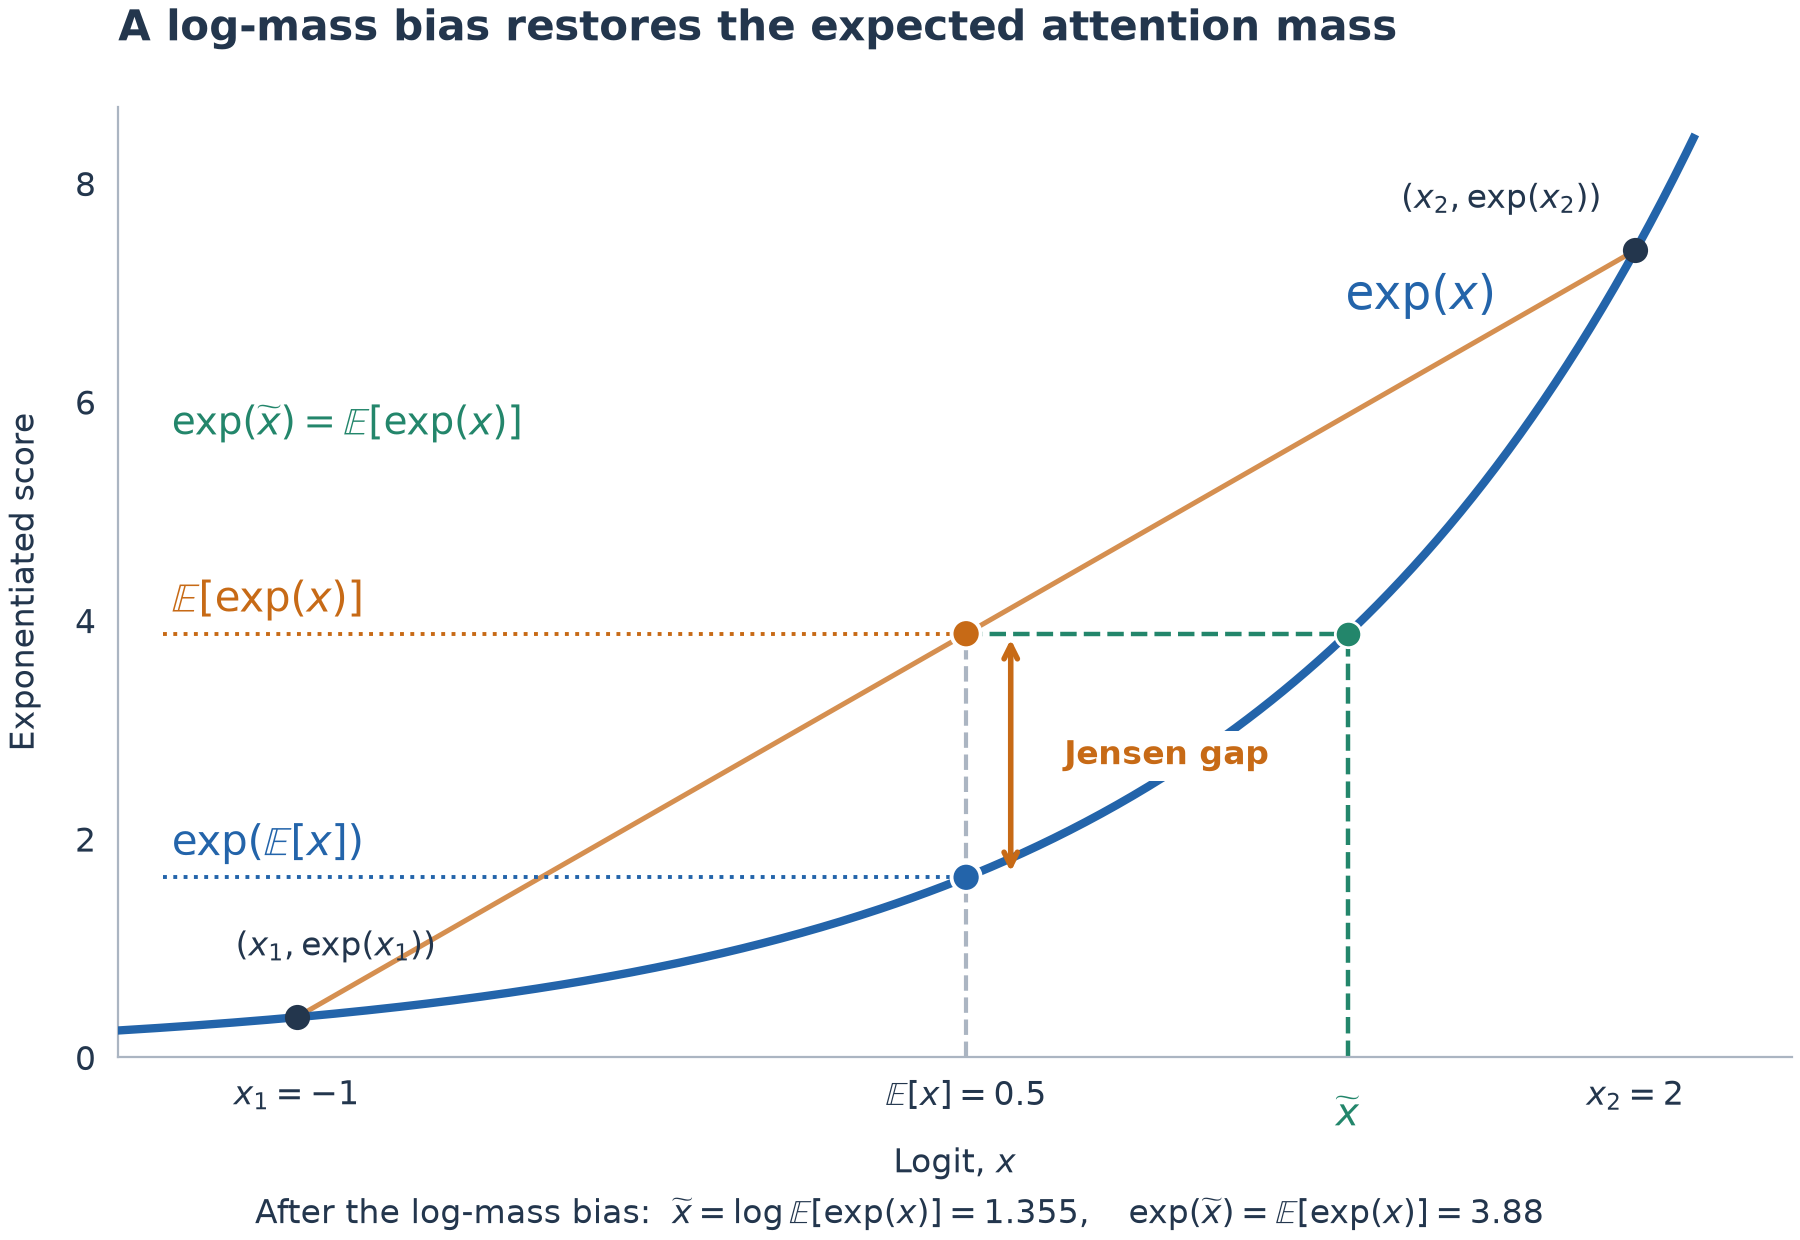
평균 풀링은 파란색으로 표시된 exp(E[x])를 만들어내며, 이는 주황색으로 표시된 기대 지수값 E[exp(x)]보다 낮습니다. 초록색 점은 log-mass 바이어스 적용 후의 유효 풀링 logit이며, 그 지수값은 기대 지수값과 일치합니다.
벤치마크
직접 비교 수치는 1344x768 해상도, 24 fps의 240 프레임, 단일 RTX PRO 6000 Blackwell에서 19스텝 MiniMax-H3 스케줄을 사용한 VBench 프롬프트 기준입니다. 여기서 모든 희소 방식은 20% Dense 워밍업을 공유하고, 첫 Transformer 레이어는 전체 구간에서 Dense로 유지되며, 동일한 프롬프트와 시드의 Dense 출력과 비교됩니다.
| 방법 | 밀도 | DiT 지연 시간 | DiT 속도 향상 | PSNR | SSIM | LPIPS | ATTN 속도 향상 |
|---|---|---|---|---|---|---|---|
| Dense | 100% | 583.3 s | 1.00x | 참조 | 1.00 | 0.00 | 1.00x |
| Sol-H3 | 동적 | 355.4 s | 1.64x | 20.36 | 0.71 | 0.20 | 2.19x |
| Spark-H3, Speed | 10% | 337.4 s | 1.73x | 23.30 | 0.80 | 0.14 | 2.33x |
| Spark-H3, Balanced | 20% | 371.1 s | 1.57x | 25.38 | 0.85 | 0.09 | 1.96x |
| Spark-H3, Fidelity | 30% | 404.1 s | 1.44x | 27.07 | 0.88 | 0.07 | 1.76x |
| Spark-H3-Lite, Speed | 10% | 330.2 s | 1.77x | 23.34 | 0.80 | 0.14 | N/A |
10% 밀도에서 Spark-H3는 Sol-H3보다 PSNR이 2.94 dB 높으면서도 실행 속도는 약간 더 빠르며, 밀도를 높이면 속도를 충실도와 단조적으로 맞바꿉니다. Spark-H3-Lite는 리블로킹 지연 시간을 절반으로 줄이는 저비용 변형으로, 20%와 30%에서 약간의 충실도 손실을 감수합니다. VBench 항목에서 모든 Spark-H3 변형은 피사체 및 배경 일관성, 모션 부드러움, 이미징 품질, 심미적 품질에서 Dense 대비 약 0.3점 이내를 유지합니다.
ComfyUI 노드
이 패키지는 ComfyUI 자체의 MiniMax-H3 구현을 위한 두 가지 어텐션 노드를 추가합니다. MiniMax H3 Spark Attention (SM89) 와 MiniMax H3 Spark Attention (SM120) 입니다. 하나는 모델 로더와 BasicGuider 사이의 MODEL 연결선에 배치하며, 모델당 하나의 어텐션 패치만 적용해야 합니다. 그래프의 나머지 부분은 그대로 유지되므로, 예제에서 사용하는 커뮤니티 LoRA와도 함께 쌓아 쓸 수 있습니다.
| 요구 사항 | 값 |
|---|---|
| ComfyUI | 0.38.x 또는 0.39.x |
| Python | 3.12+ |
| PyTorch / CUDA | CUDA 13.0, BF16 |
| OS | Linux 또는 Windows x86_64 |
| SM89 | GeForce RTX 40 시리즈 |
| SM120 | GeForce RTX 50 시리즈, RTX PRO 5000 / 6000 Blackwell |
설치 프로그램은 사용 중인 ComfyUI에 맞는 백엔드를 선택합니다. 0.38.x에서는 comfy-kitchen 0.2.36, 0.39.x에서는 0.2.37입니다. 릴리스 v0.1.2는 검증된 Windows 패키지를 추가하고 번들 워크플로와 설치 문서를 갱신했습니다. CUDA 12.8은 소스 빌드 경로를 통해서만 사용할 수 있습니다. 모델 파일은 여전히 Comfy-Org MiniMax-H3 저장소에서 받으며, ComfyUI 가이드는 중국어 설치 가이드도 링크합니다.
동일한 RTX PRO 6000 Blackwell에서 1344x768, 14.4초 클립을 ComfyUI에서 종단 간 실행한 결과:
| 변형 | Dense | Fidelity (20%, 워밍업) | Speed (20%, 워밍업 없음) |
|---|---|---|---|
| MiniMax-H3, 20 스텝 | 1018.5 s | 461.7 s · 2.21x | 323.3 s · 3.15x |
| MiniMax-H3 + LightX2V 8스텝 | 408.0 s | 199.5 s · 2.05x | 129.6 s · 3.15x |
하나의 클립에 Dense, Fidelity, Speed 어텐션을 적용한 결과로, ComfyUI의 네이티브 MiniMax-H3 워크플로로 생성했습니다. 프롬프트는 Video DeltaNet의 프롬프트 세트에서 가져왔습니다.
워크플로
다섯 가지 예제 워크플로가 릴리스와 함께 제공되며, 각각 topk_mode=topk_ratio와 reblock_layout=q_reuse_k를 고정합니다. 네이티브, LightX2V, Larryvrh, DMAD 예제는 topk_ratio=0.2를 사용하고, LBH 2패스 예제는 Diffusers h3_lbh 경로에 맞춰 0.1을 사용합니다.
| 예제 | 구성 |
|---|---|
| 네이티브 MiniMax-H3 | 핵심 예제: 20 스텝, LoRA 없음, 추가 노드 없음 |
| LightX2V 8스텝 LoRA | models/loras에 LightX2V Turbo LoRA 필요 |
| Larryvrh 8스텝 LoRA | 변환된 LoRA가 필요하며, ComfyUI 자체의 LoraLoaderModelOnly로 로드 가능 |
| DMAD 4스텝 LoRA | DMAD re-noise 샘플러 사용 |
| LBH 2패스 + LightX2V 4스텝 | 공식 LBH 업스케일러 노드와 해당 잠재 데이터 업스케일러 모델 필요 |
이 패키지는 추가 LoRA를 조용히 설치하지 않습니다. LoRA는 models/loras 아래에 남아 있으며 설치는 사용자의 선택입니다. Larryvrh 가중치용 변환 스크립트는 208개의 백본 LoRA를 유지하고, 51개의 AdaLN 업데이트를 프루닝된 모델의 8차원 타임스텝 곡선에 투영합니다.
Spark-H3 백엔드로 렌더링한 미니멀한 제품 광고 프롬프트로, 프로젝트 저장소의 샘플 세트에서 가져왔습니다.
사용 가능 여부
Spark-H3는 github.com/zechengtang/Spark-H3에 있으며, 코드만 있는 미러는 Aazeus/Spark-H3, 설명 글은 zechengtang.github.io/Spark-H3에 있습니다. 이는 checkpoint가 아닌 추론 백엔드이므로 모델 가중치를 재배포하지 않으며, 기존 H3 LoRA와 함께 사용할 수 있습니다. 프로젝트 로드맵에는 SM120 검증이 진행 중, comfy-kitchen 의존성이 없는 독립 릴리스와 SM90 및 SM100용 커널이 계획됨, 기술 보고서는 아직 게시되지 않음으로 기재되어 있습니다. 첫 ComfyUI 릴리스도 얼마 되지 않았으므로 패키징과 라우팅 세부 정보는 계속 바뀔 것으로 예상됩니다.
MiniMax-H3에서 이미 Veda 희소 어텐션을 사용해 보았다면, 블로그에 Spark-Attn, Sol-Attn, Veda, 일반 블록 희소 어텐션이 어떻게 다른지에 대한 논의가 있습니다. Veda는 Top-K 선택을 위한 스코어러를 학습하고, Sol-Attn은 콘텐츠 적응형 임계값을 사용하며, Spark-Attn은 블록 레이아웃과 선택되지 않은 블록의 처리 방식을 바꿉니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.