Qwen-Image-2.1-Turbo: ComfyUI 공식 8스텝 Turbo 체크포인트
Alibaba의 공식 Qwen-Image-2.1-Turbo 체크포인트는 7B 생성기와 편집기를 CFG 1에서 8 디노이징 스텝으로 실행하며, ComfyUI용으로 Comfy-Org가 재패키징한 가중치를 제공합니다.
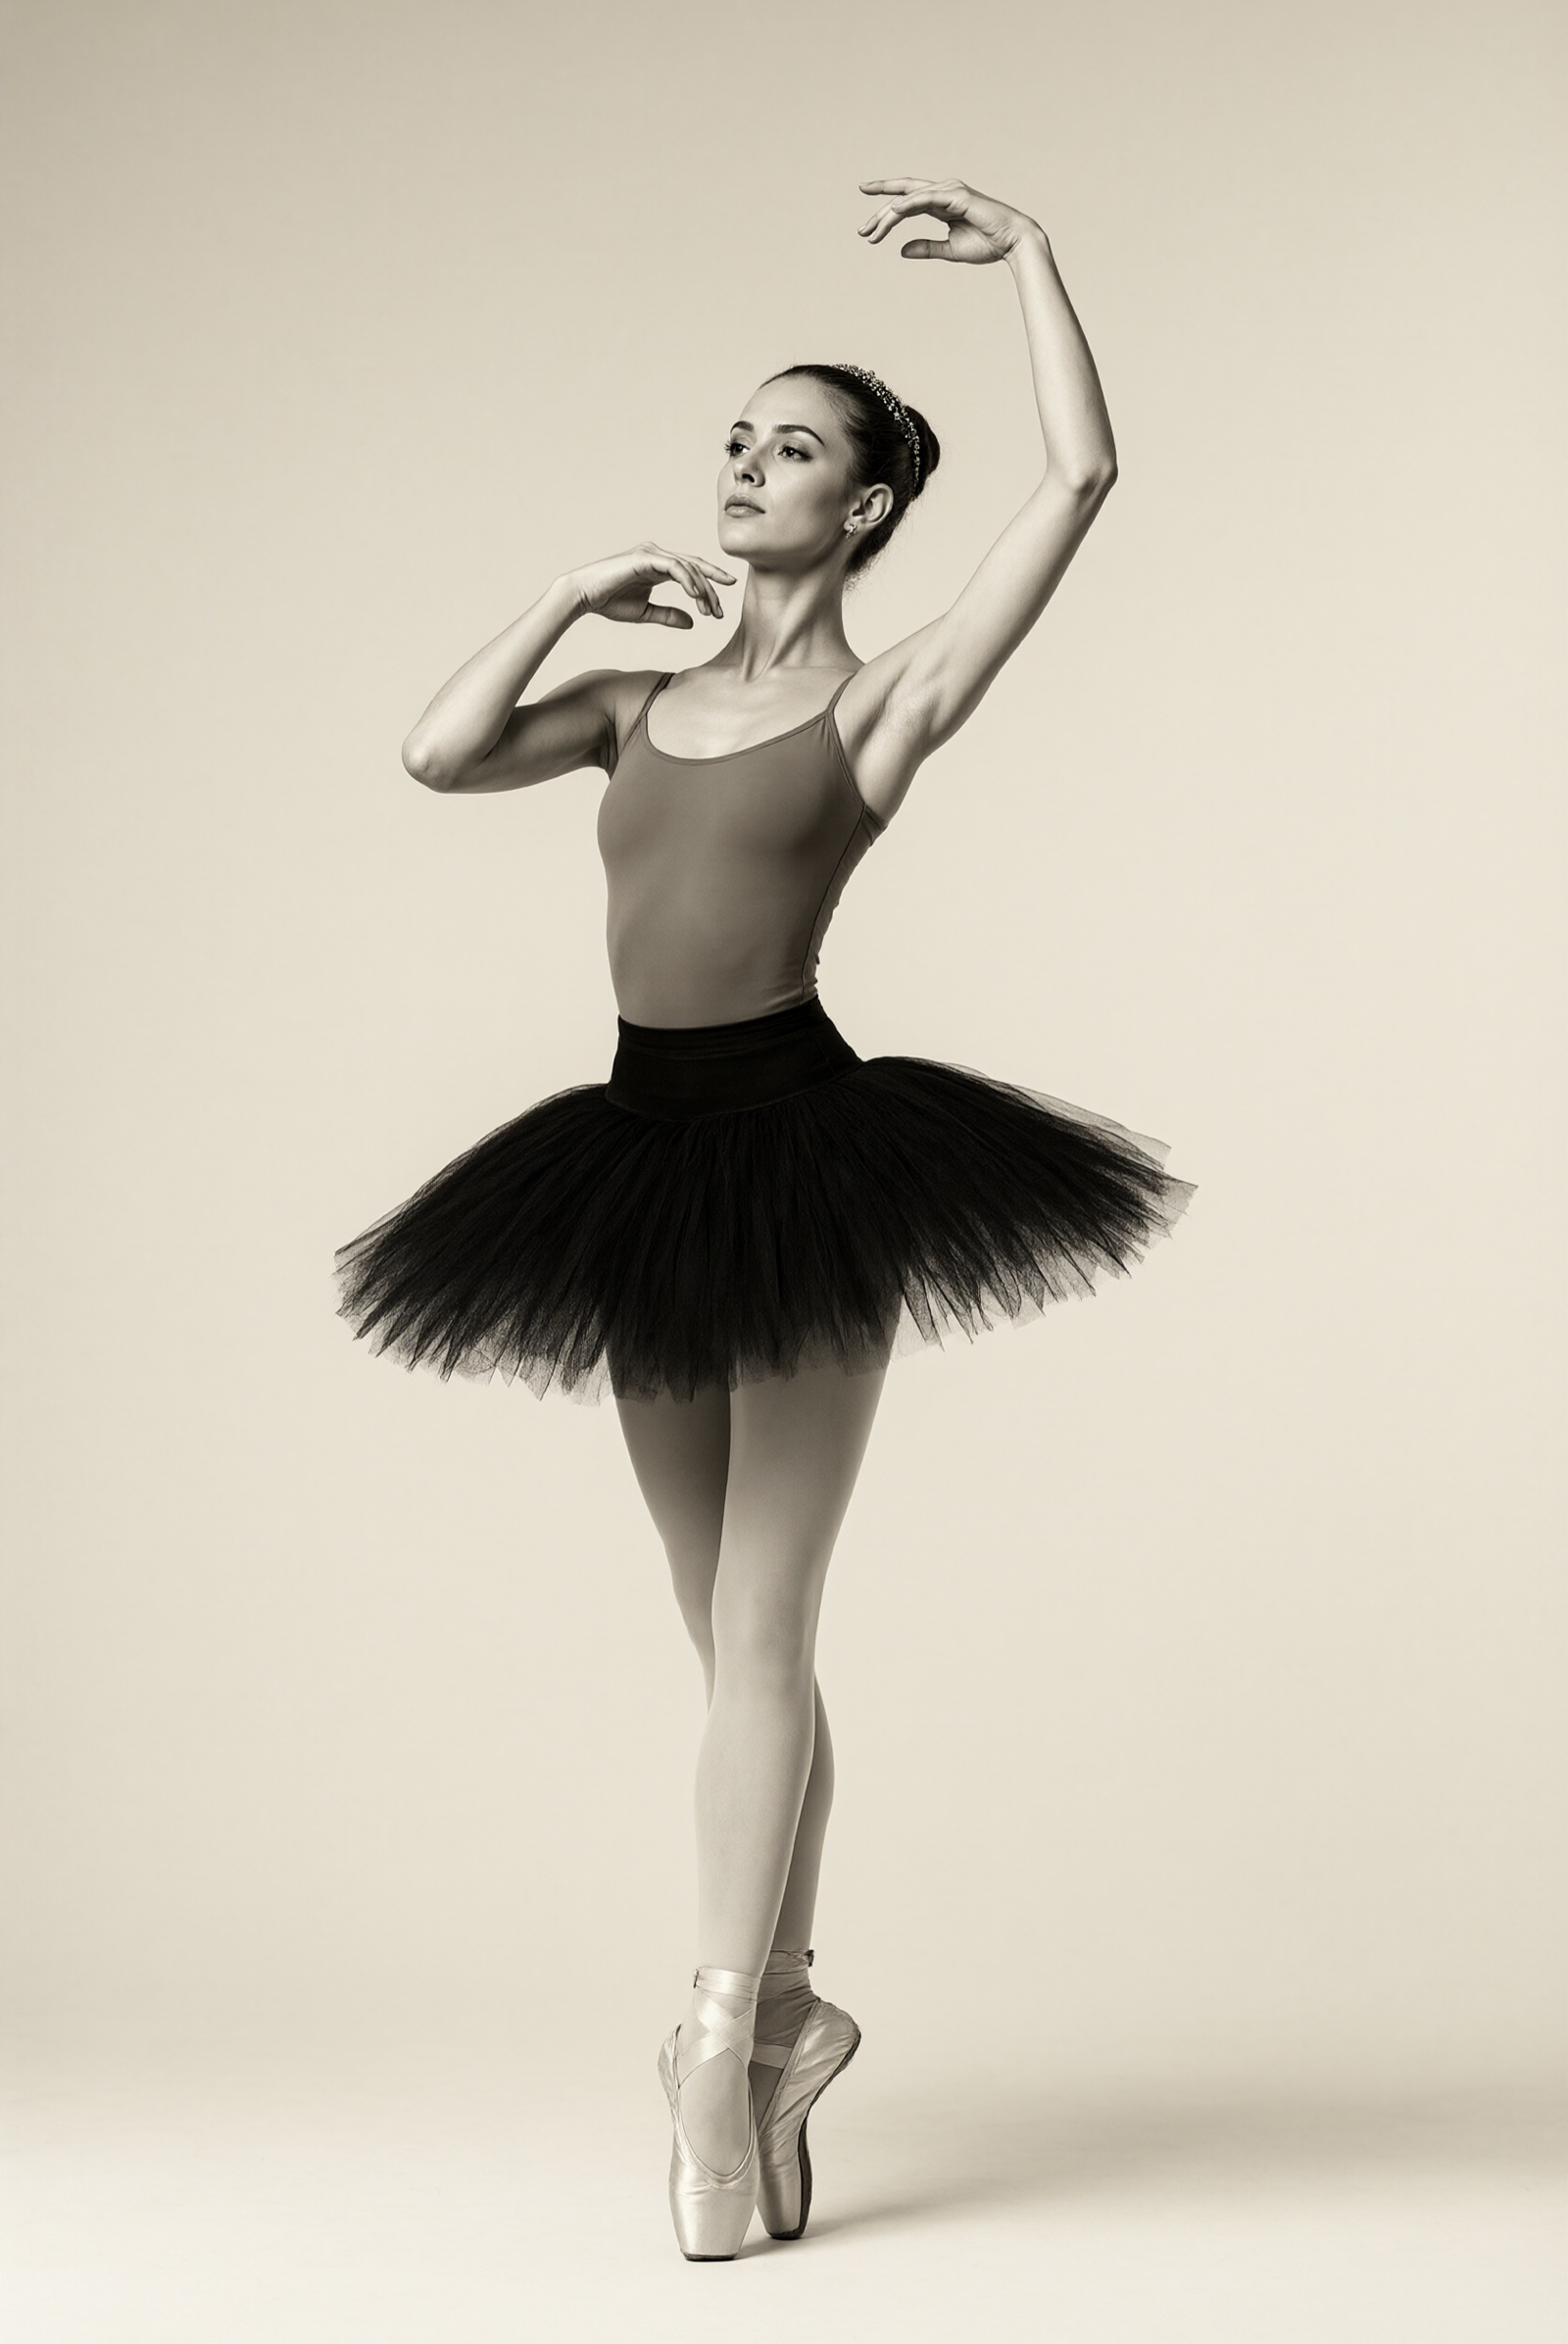
인체 포즈와 동작: Alibaba 자체 Turbo 쇼케이스의 8스텝 카테고리 중 하나입니다.
Turbo 체크포인트가 바꾸는 것
Turbo는 새로운 아키텍처가 아닙니다. 샘플링 스케줄이 내장된 Qwen-Image 2.1의 두 번째 체크포인트이며, 따라서 동일한 transformer 가중치가 이전과 마찬가지로 생성, 지시 기반 편집, RGBA 투명도, 피사체 추출을 담당합니다. 실제로 연결할 때 중요한 차이는 다음과 같습니다.
- 40 스텝 대신 8 디노이징 스텝. 권장 8스텝 스케줄이 체크포인트 안에 포함되어 있습니다. 모델 카드에는
num_inference_steps만 전달하는 것으로는 이 스케줄을 덮어쓸 수 없으며, 다른 스케줄은 이 체크포인트에 대해 평가되지 않았다고 명시되어 있습니다. - 기본값은 CFG 1. classifier-free guidance가 꺼져 있어 각 스텝은 단일 순전파만 실행합니다.
- Prefix KV 캐싱은 디노이징 스텝 전반에 걸쳐 텍스트와 참조 이미지 컨텍스트를 재사용하며, 파이프라인은
use_kv_cache=True로 이를 활성화합니다. - 베이스 모델과 동일한 해상도 프리셋으로, 2048x2048 (1:1)부터 2752x1536 (16:9) 및 이에 대응하는 세로 비율까지 지원합니다.
- 현재로서는 diffusers 기반입니다.
QwenImage21Pipeline으로 로드되며, 파이프라인에서 설정된 샘플링 시그마를 지원하는 diffusers 빌드가 필요합니다.
저장된 스케줄은 1.0, 0.978453, 0.95418, 0.926626, 0.89508, 0.845148, 0.704534, 0.414568이며, 빈 0 스텝으로 끝납니다. Banodoco #qwen-image 채널에서 Kijai는 이 스케줄이 shift를 적용하지 않은 ComfyUI의 linear_quadratic 스케줄러와 유사하며, 일반적으로 turbo 체크포인트에서 고정 Euler 스케줄이 확률적 샘플러를 능가하는 사례는 보지 못했다고 언급했습니다.
쇼케이스
모델 카드는 8스텝 출력을 사람들이 실제로 모델에 요청하는 작업 기준으로 그룹화합니다. 인물 사진과 포스터 타이포그래피도 편집 사례와 동일한 체크포인트에서 나옵니다.
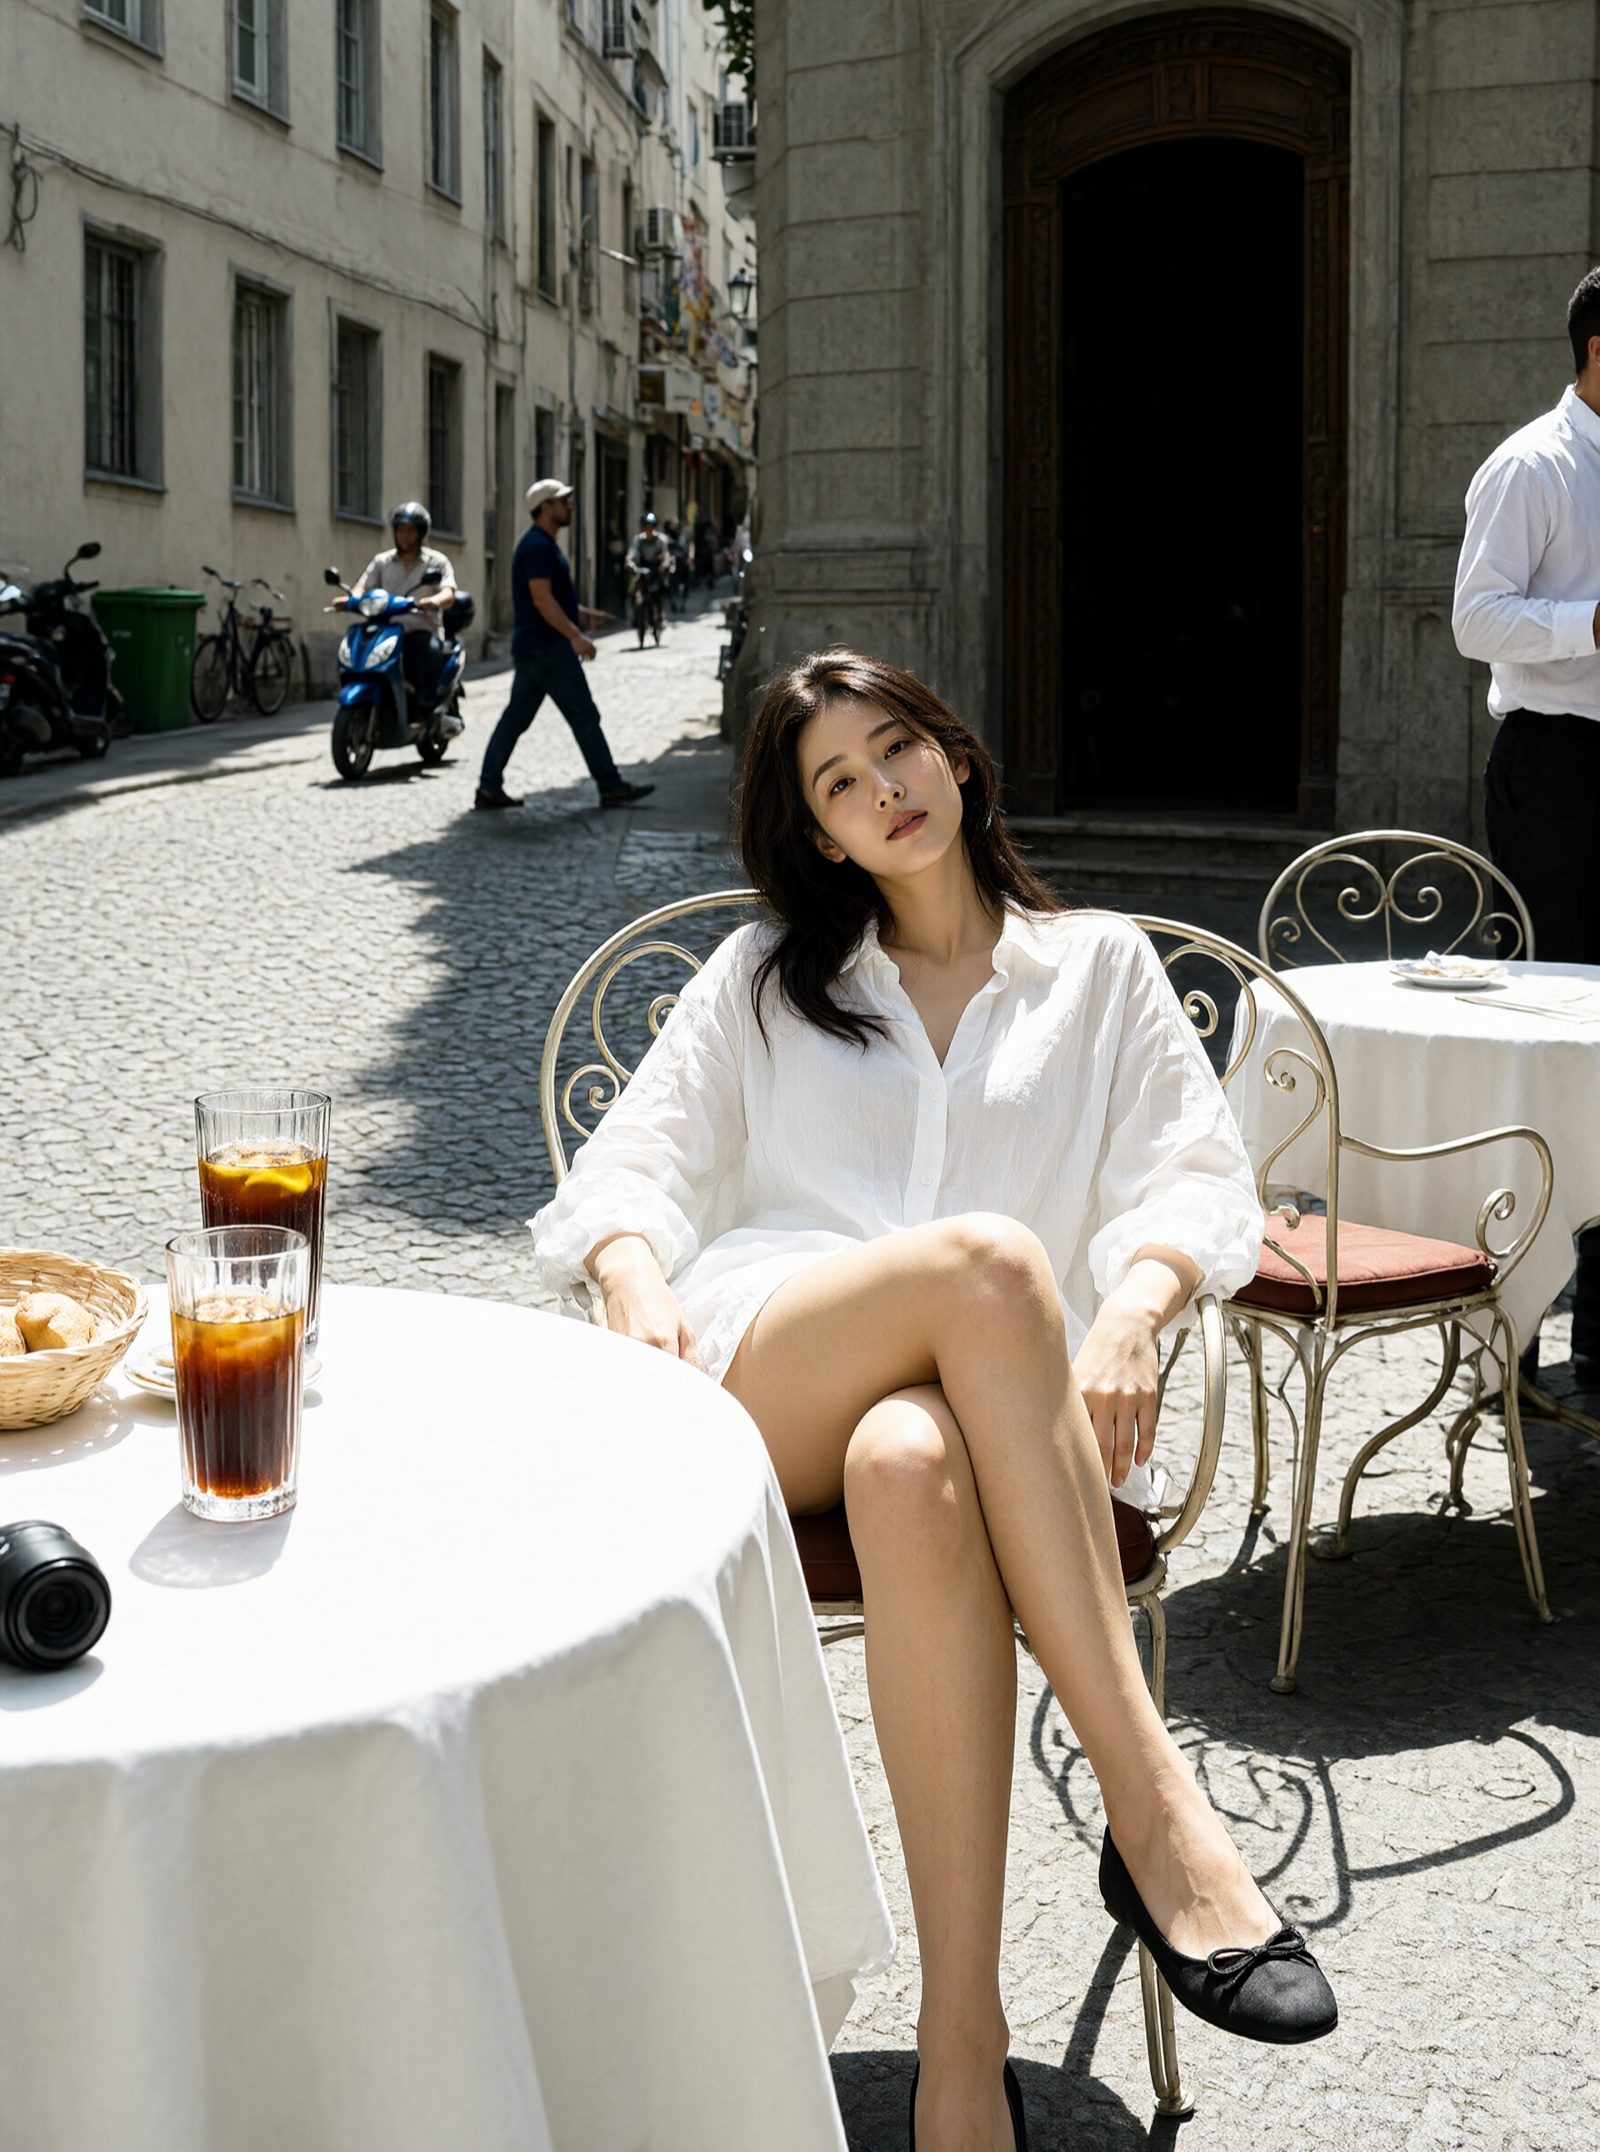
인물 사진, 1680x2512 해상도에서 8 스텝으로 생성됨.
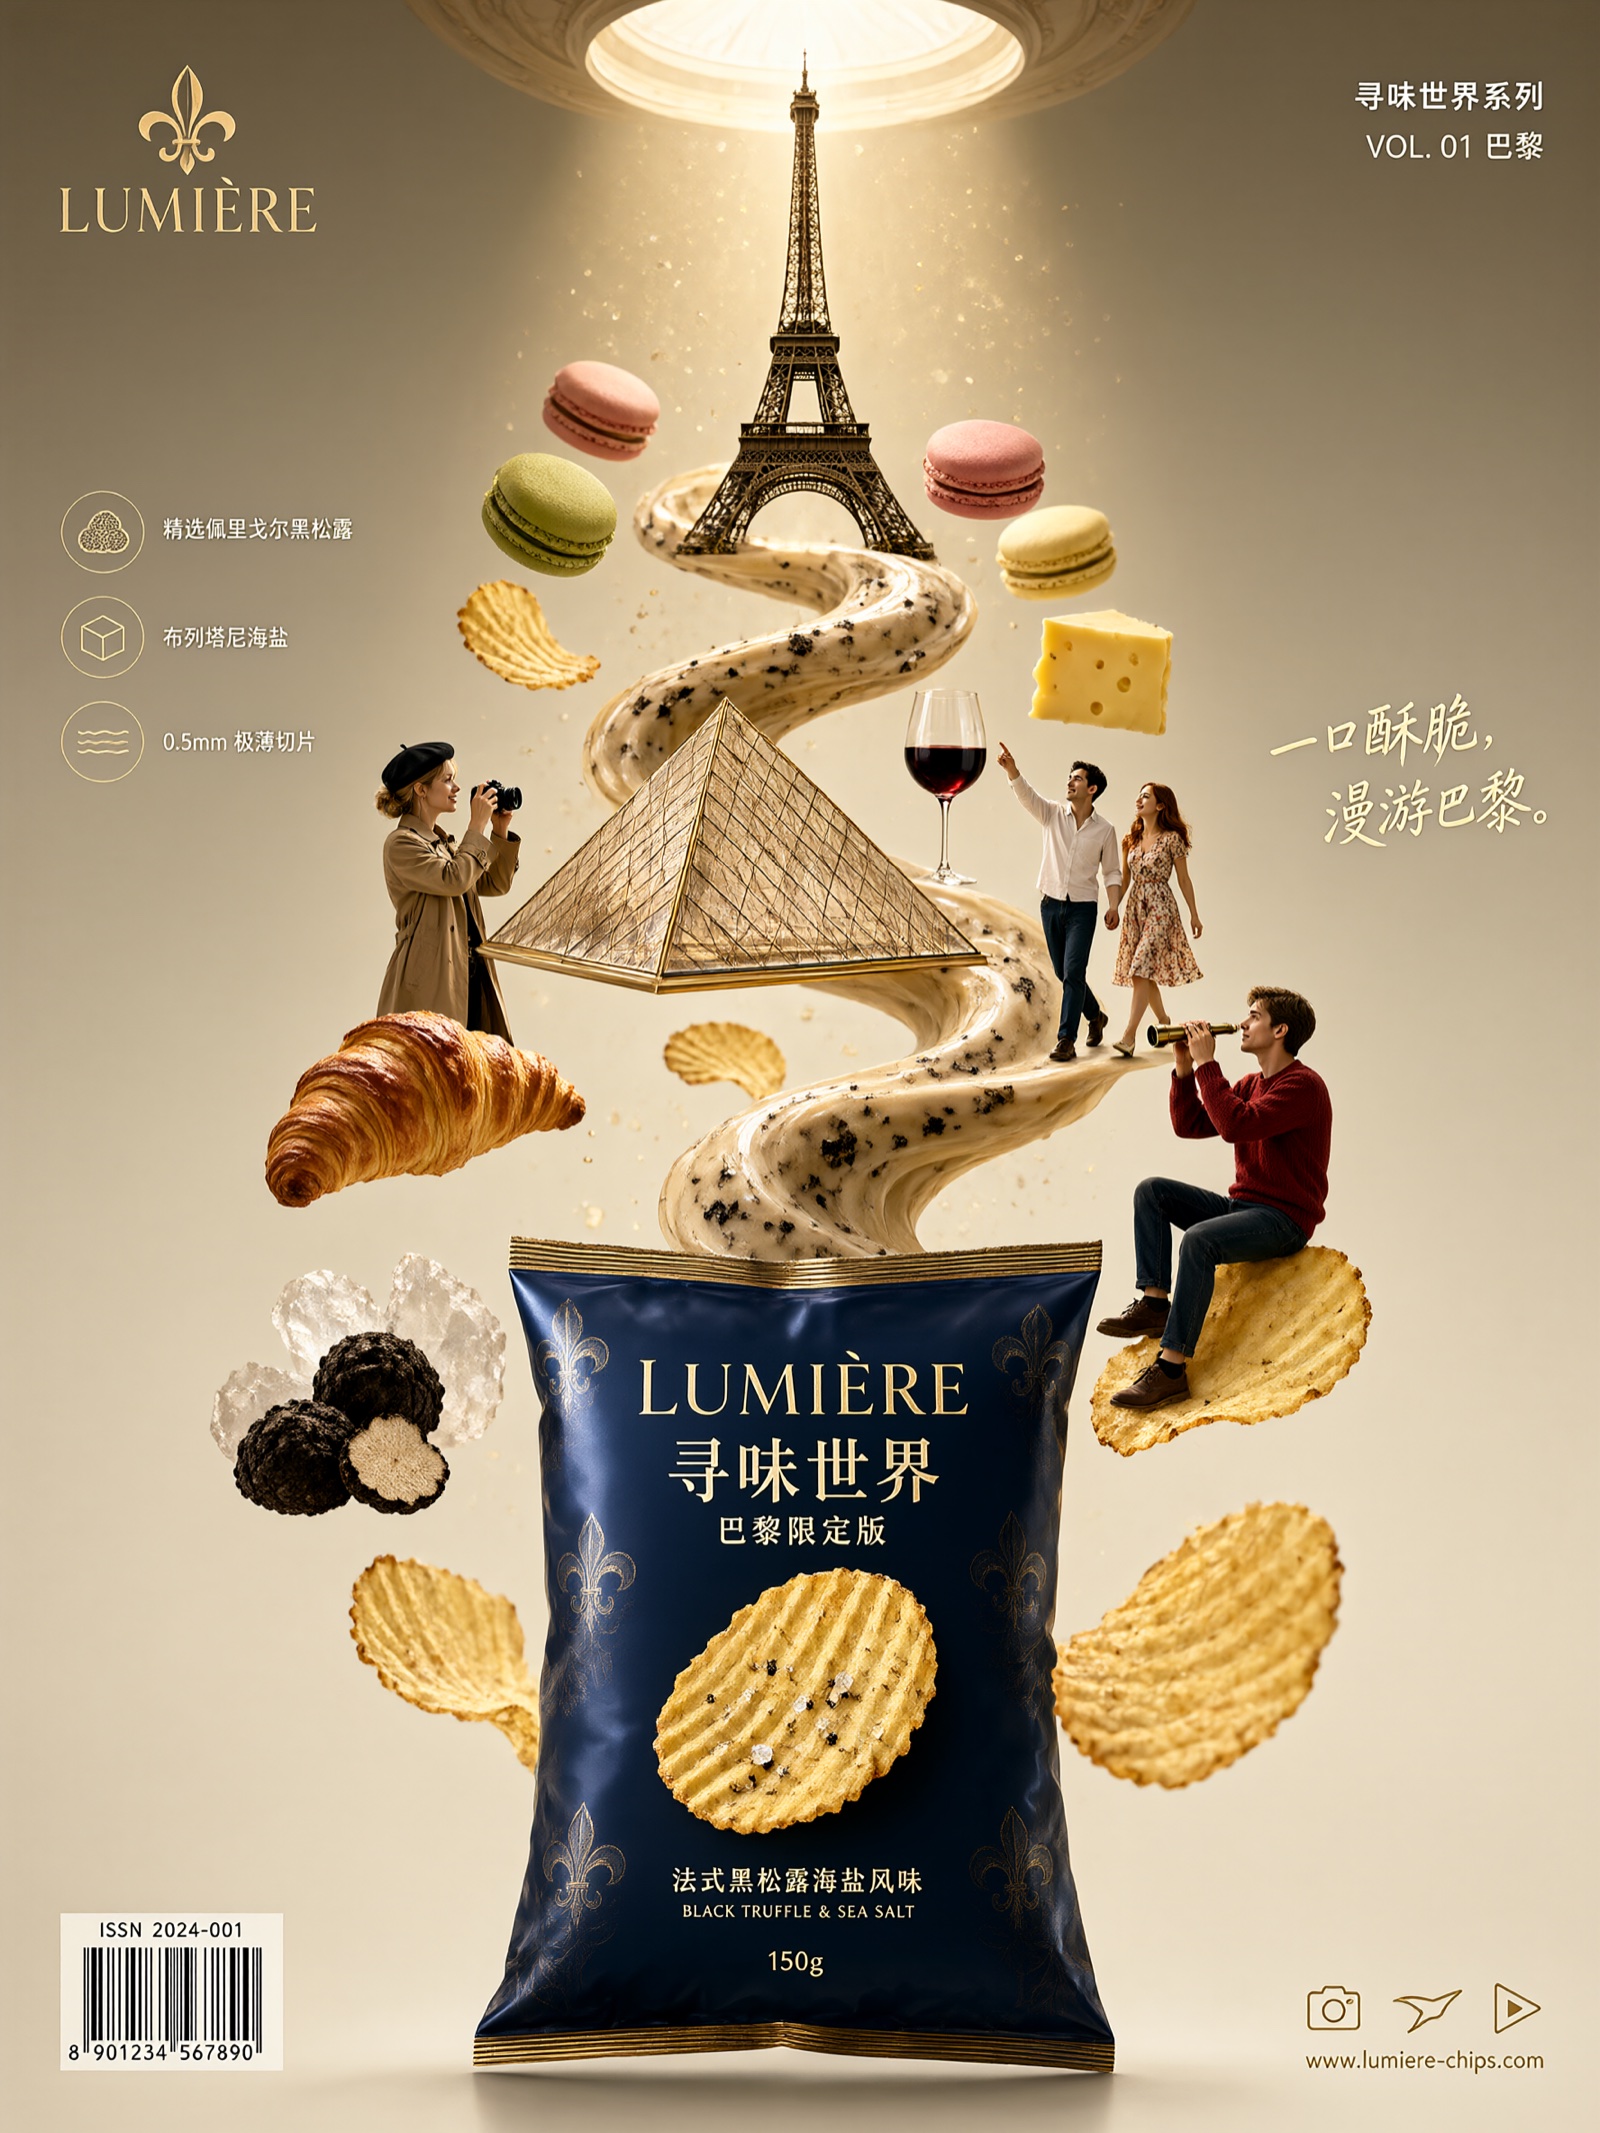
타이포그래피와 포스터 디자인: 이전에는 전체 40스텝 롤아웃이 필요했던 카테고리입니다.
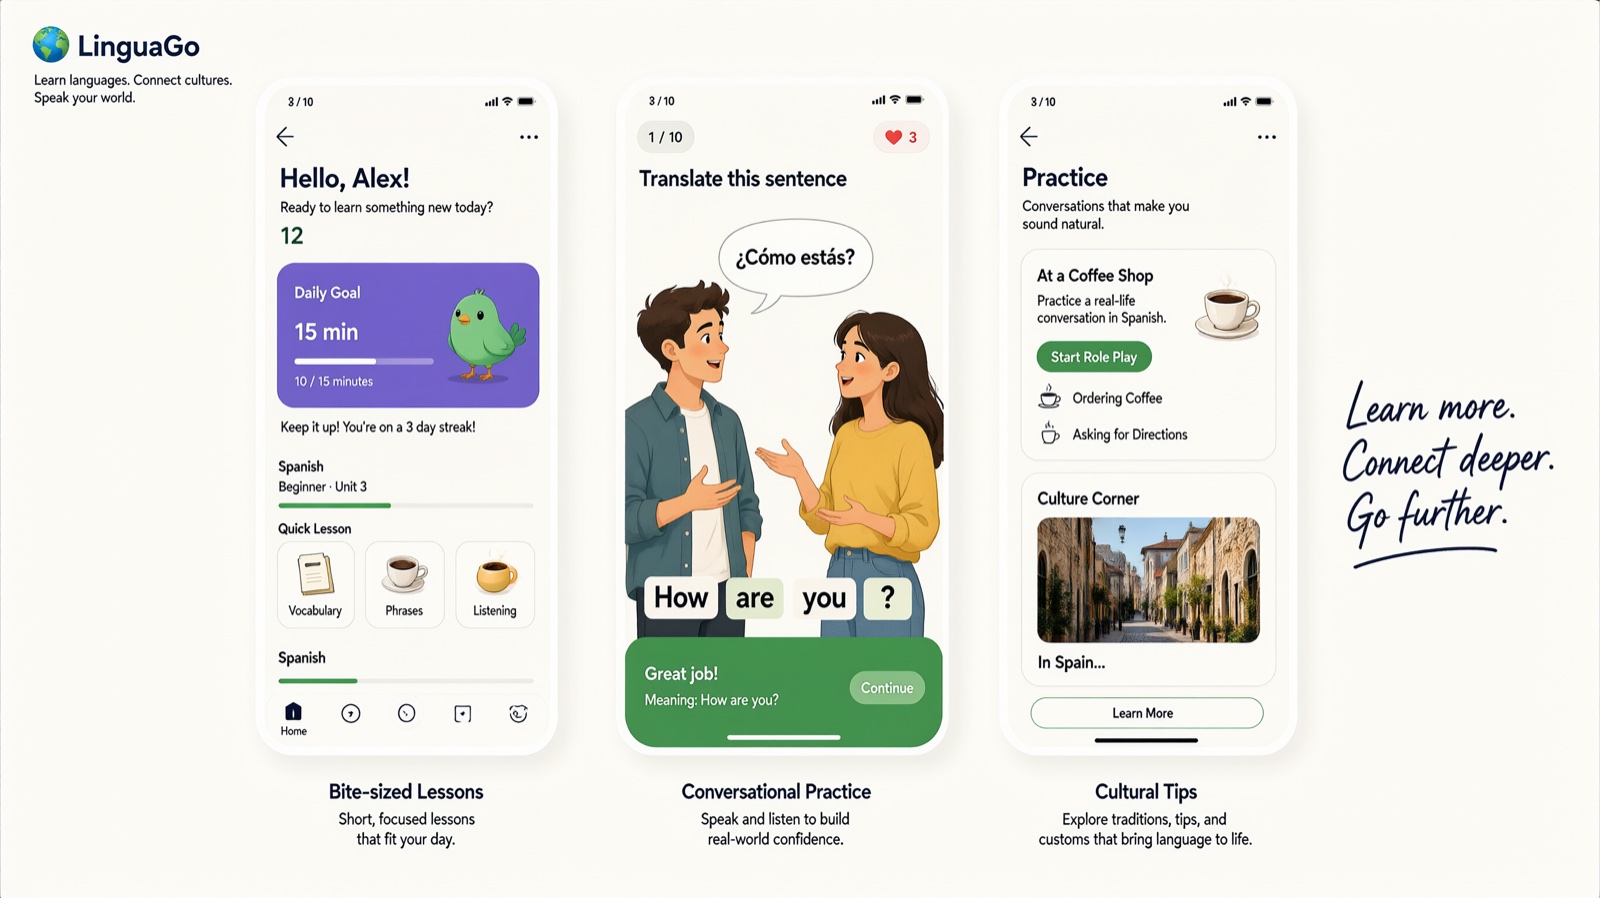
UI 및 정보 레이아웃: 구조화된 출력 중에서도 더 어려운 사례 중 하나입니다.
투명도는 가속 후에도 유지됩니다. 알파 채널은 모델이 직접 기록하므로 스티커와 제품 에셋도 합성 가능한 상태로 출력됩니다.
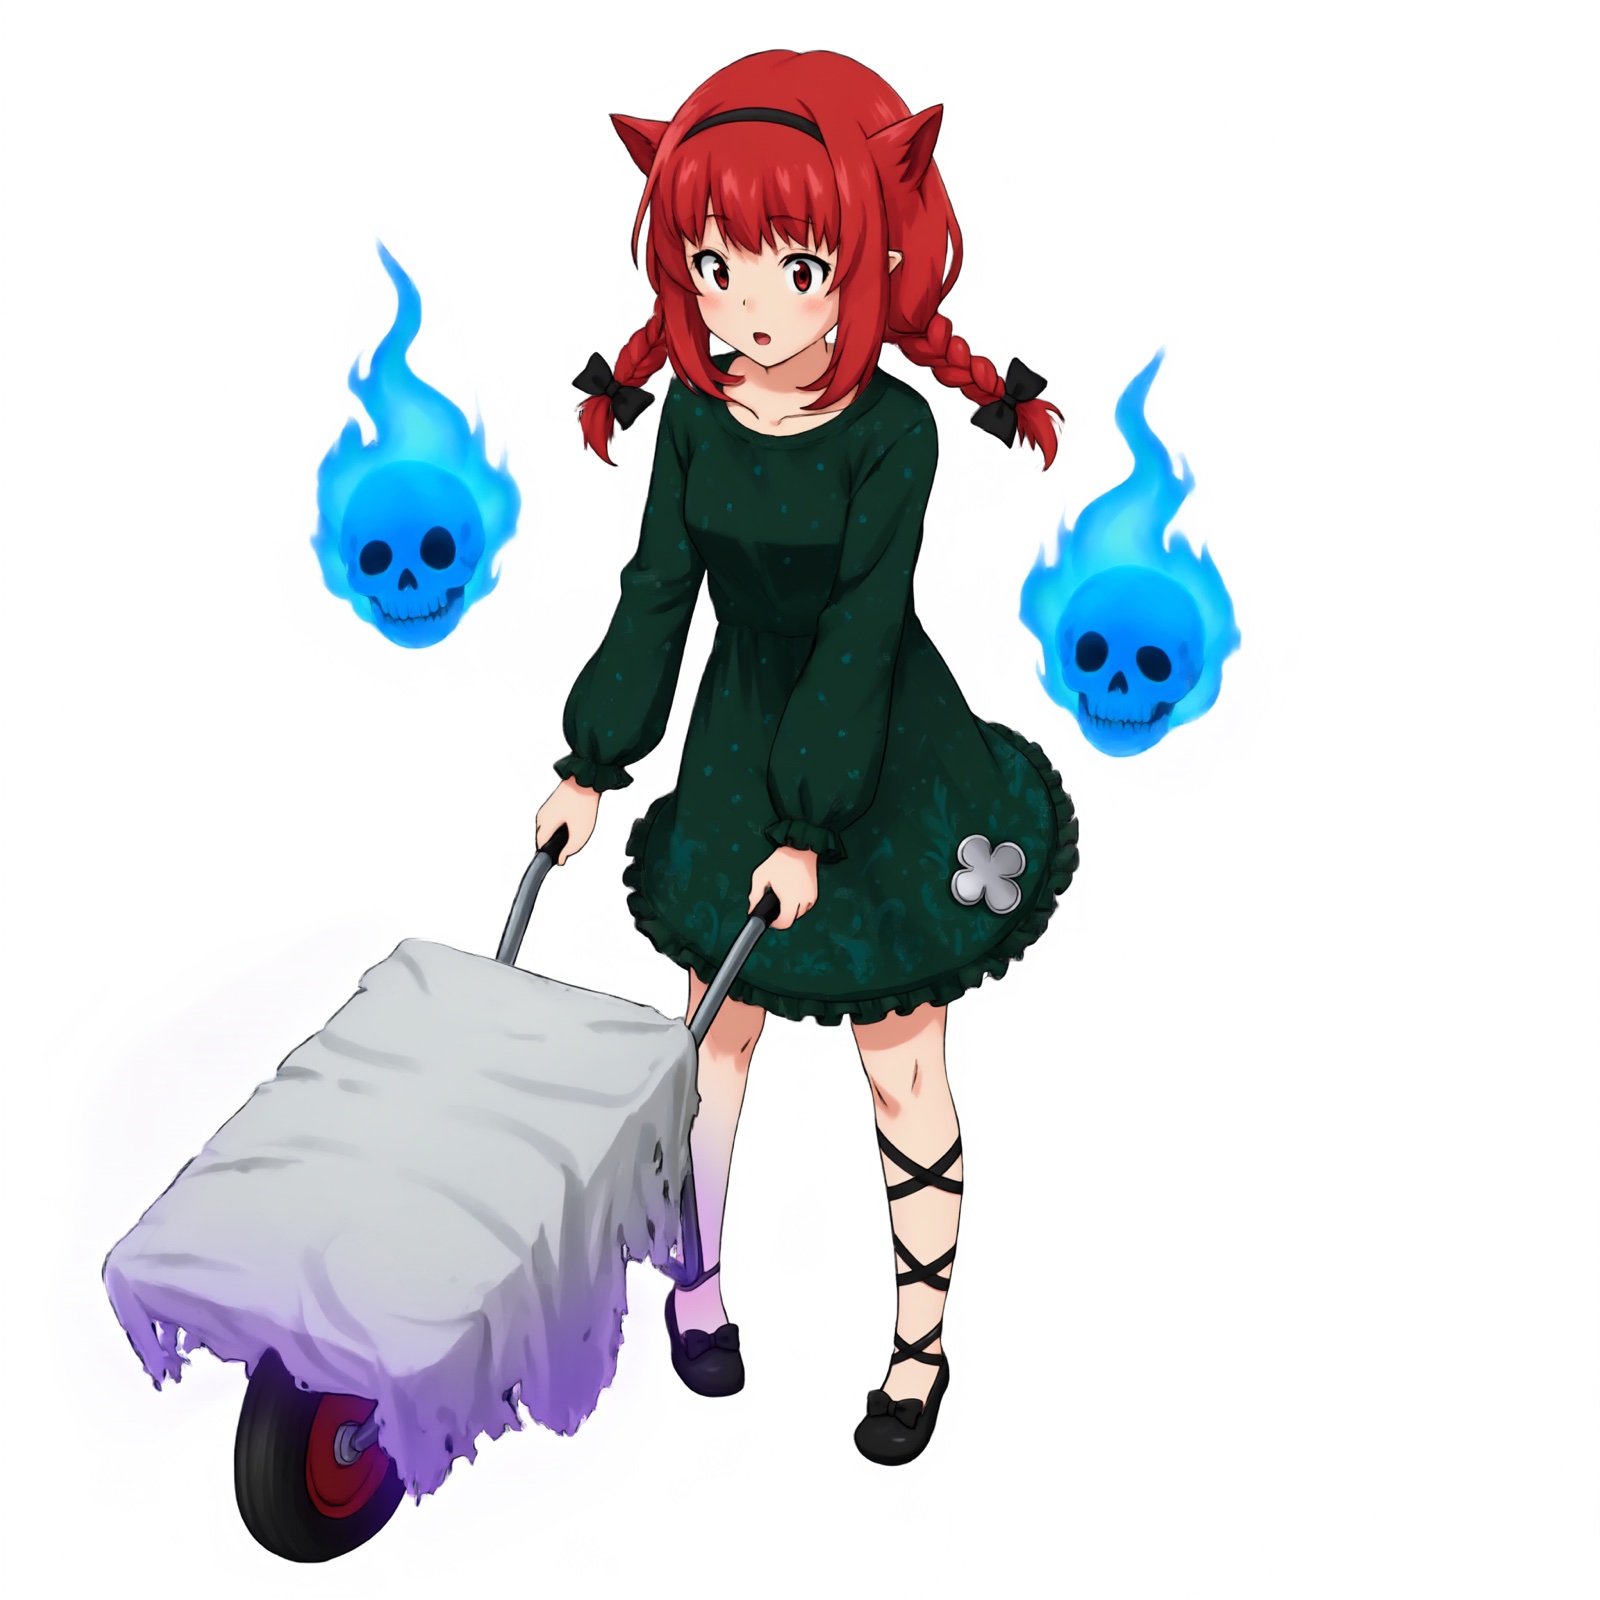
Turbo 체크포인트를 사용한 투명 이미지 생성.
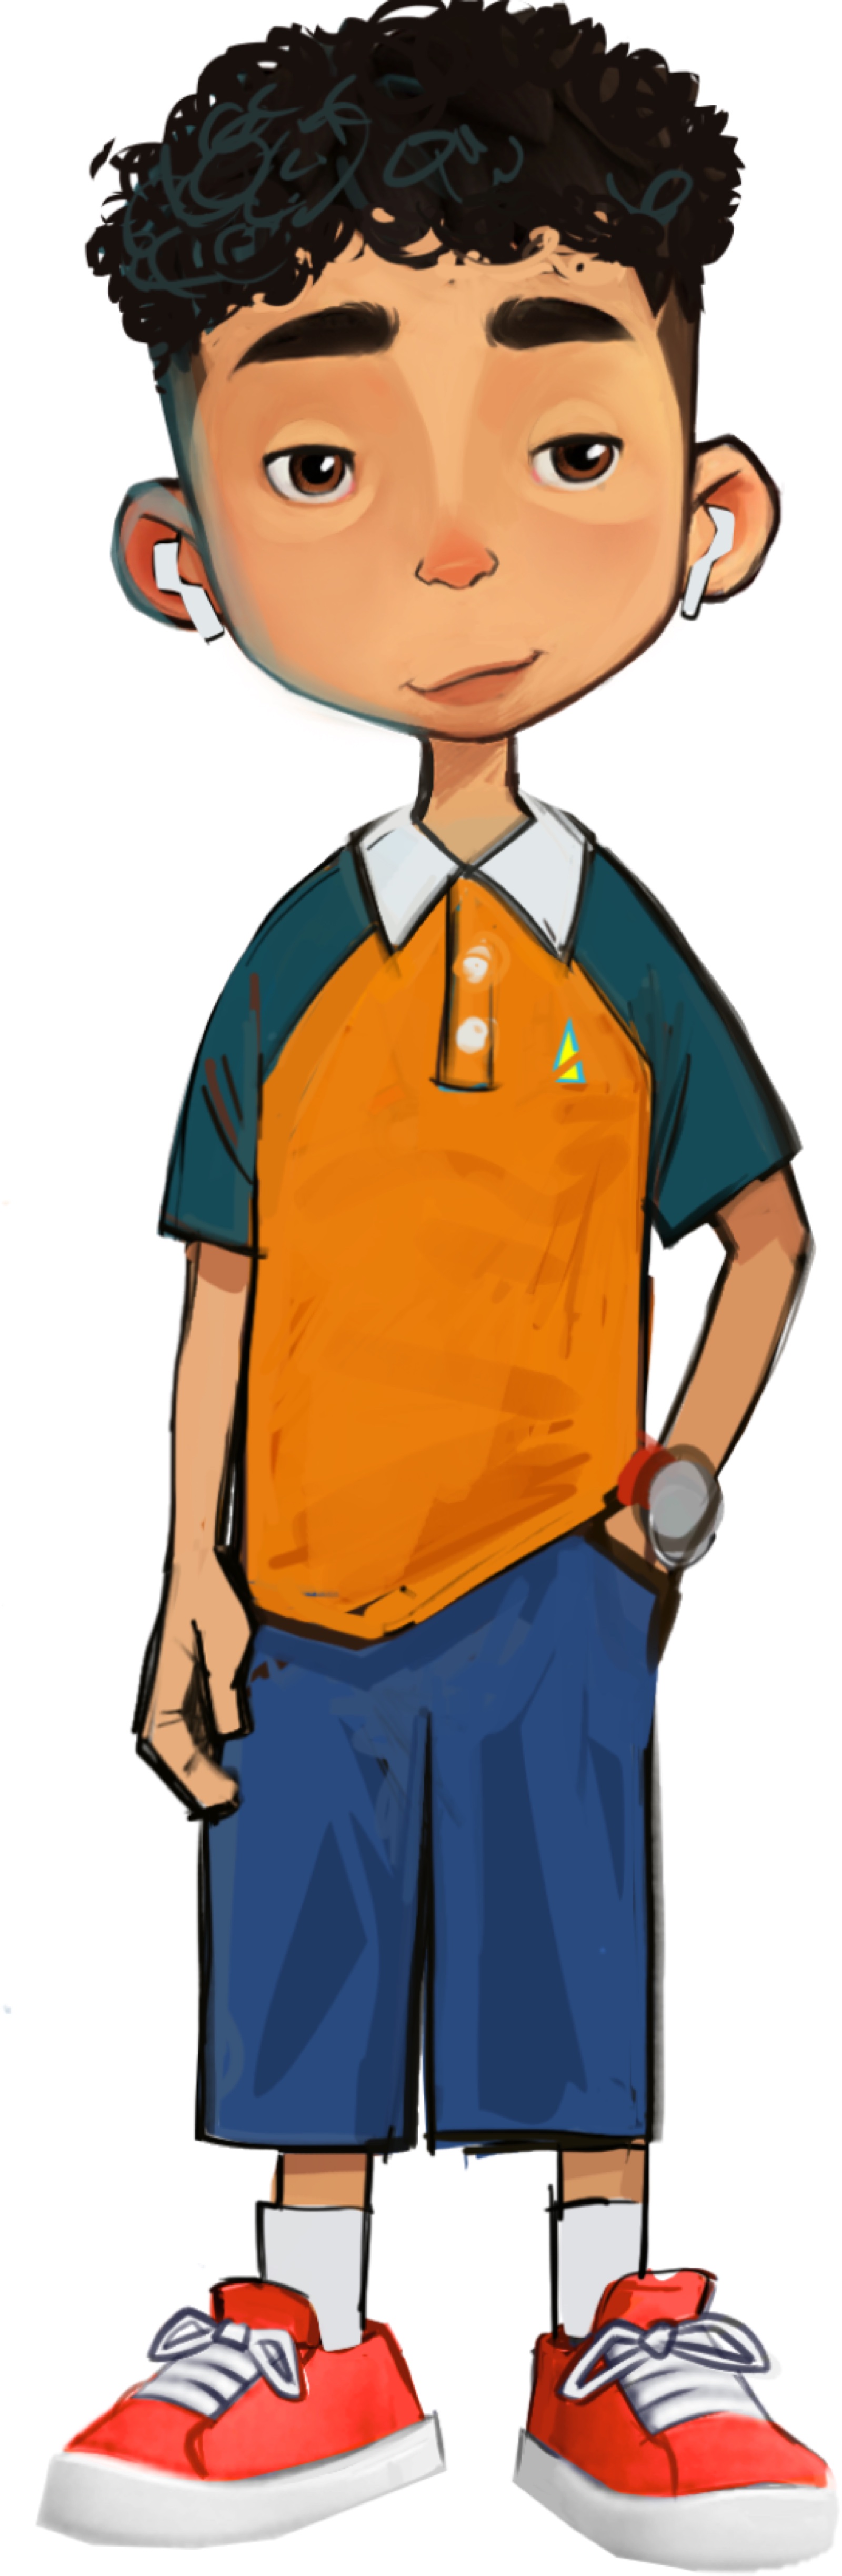
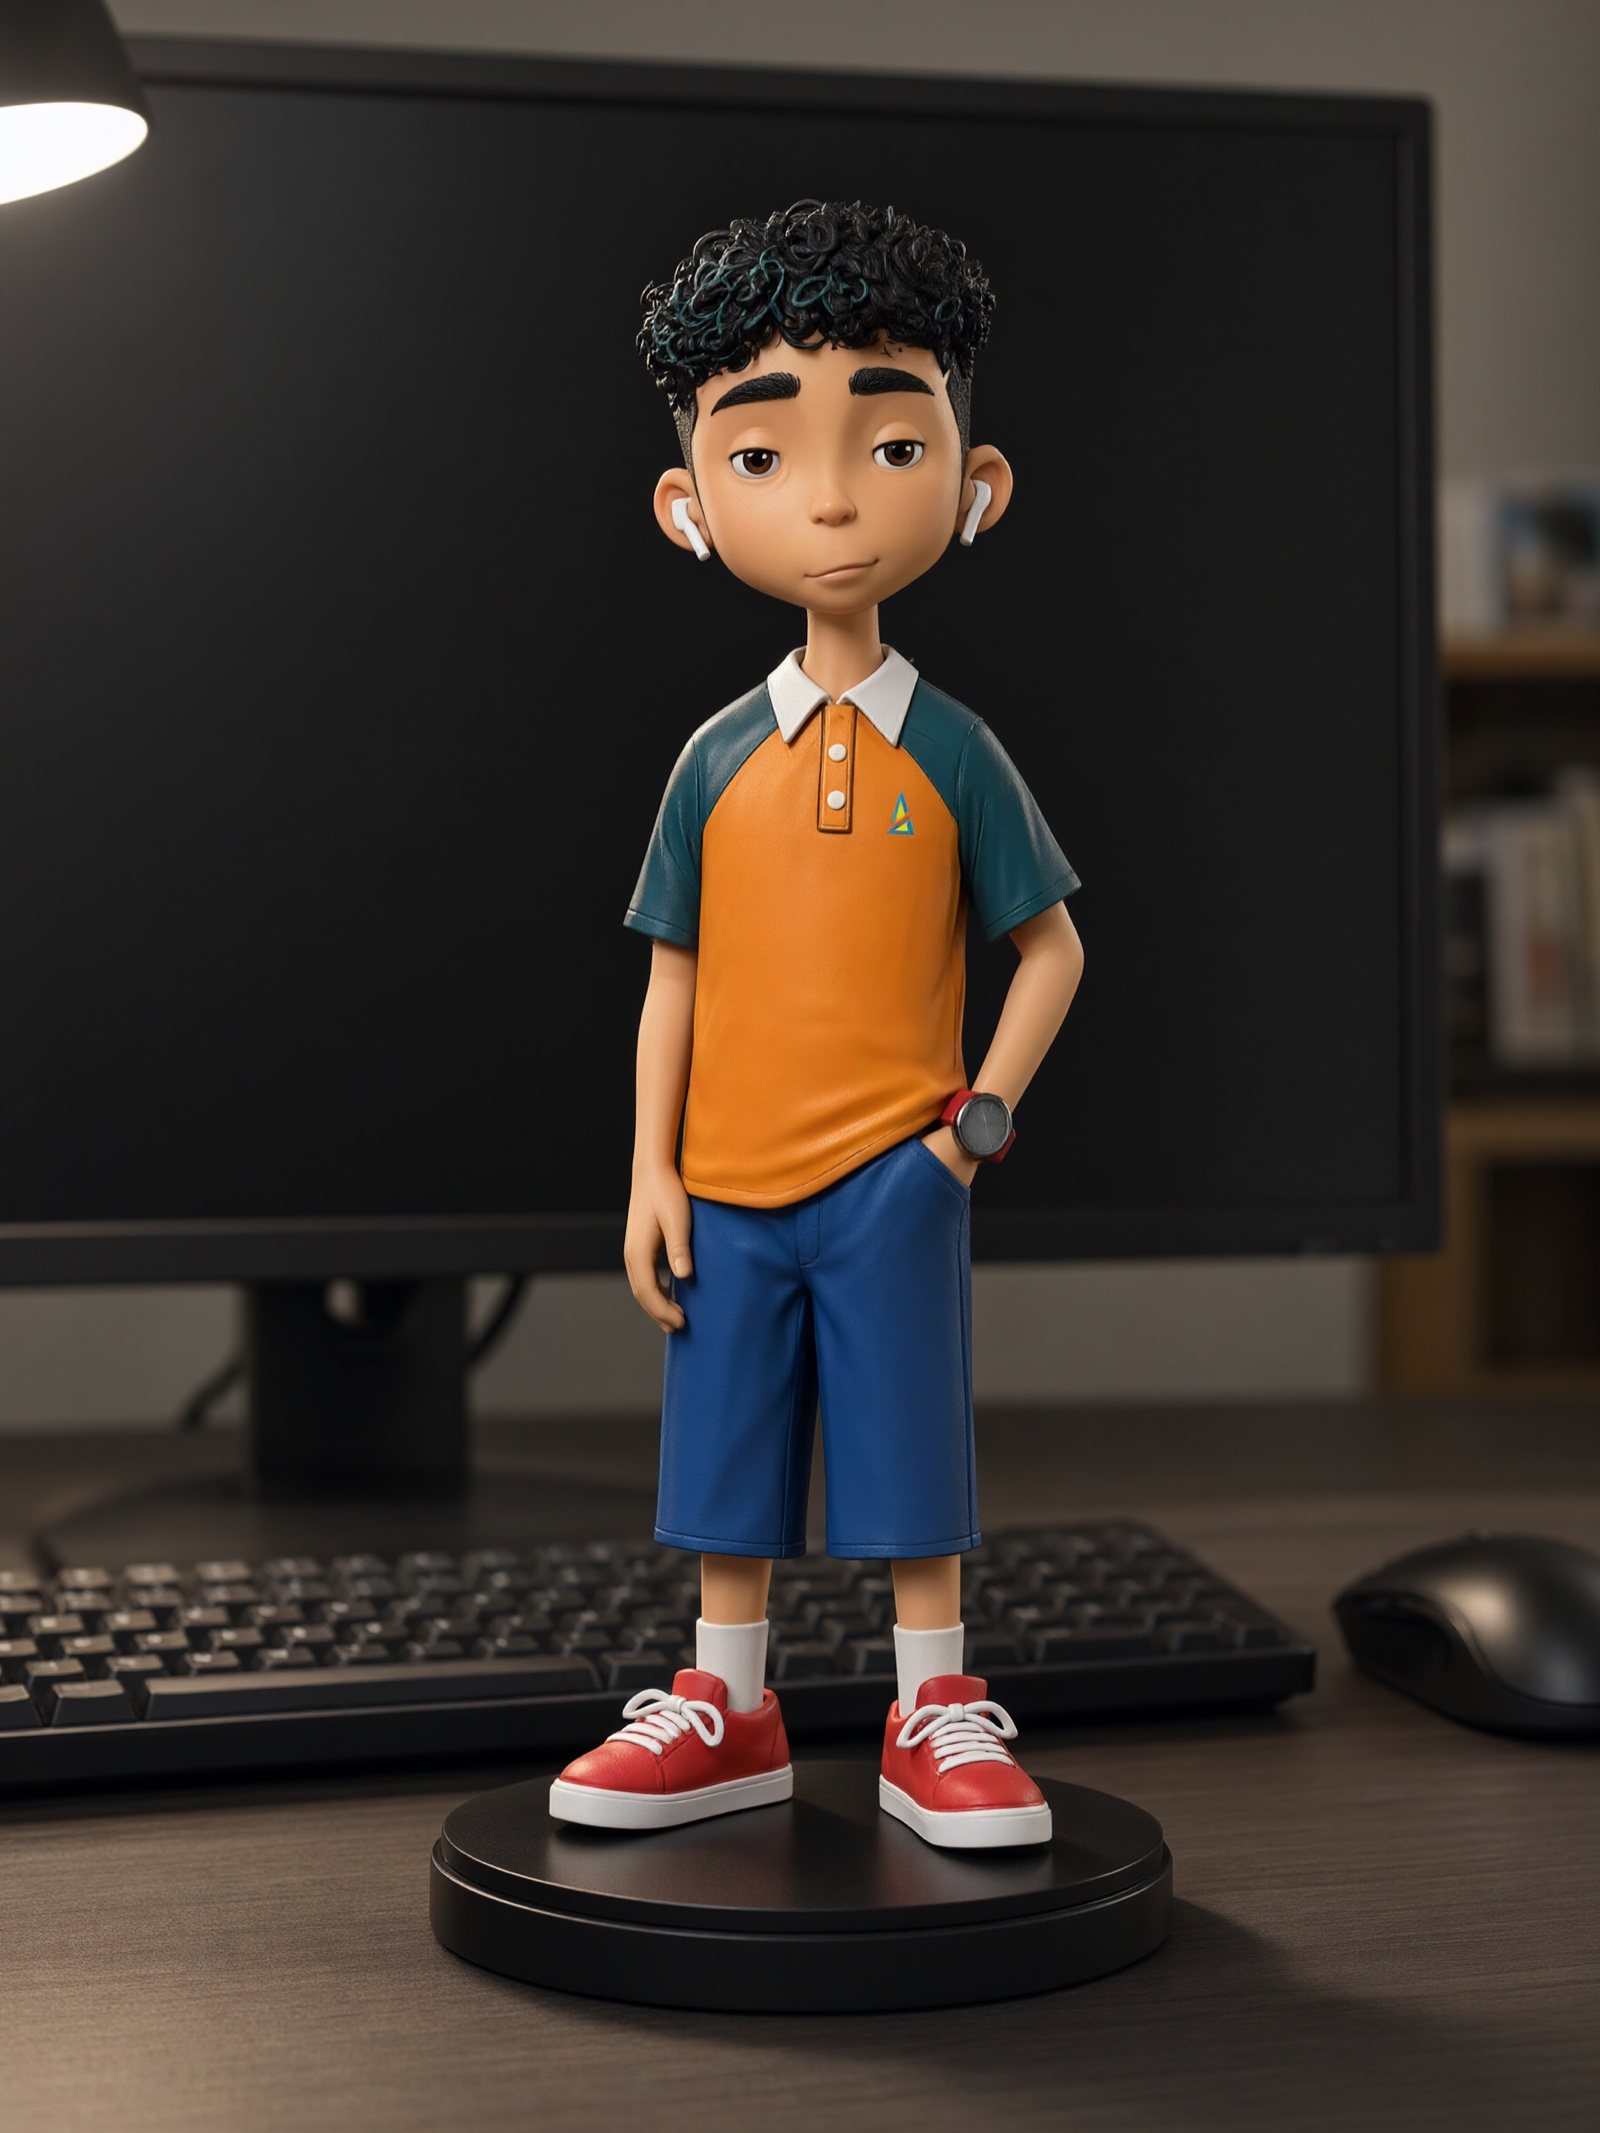
편집은 단일 이미지 변환을 포함해 베이스 모델과 동일하게 작동합니다.
 |  |
|---|---|
| 입력 참조 | 8스텝 편집 출력 (2048x2048) |
ComfyUI 사용 가능 여부
Comfy-Org/Qwen-Image-2.1은 릴리스 후 몇 시간 안에 Turbo를 추가했으며, 베이스 모델과 동일한 세 가지 형태로 제공합니다.
diffusion_models/qwen_image_2.1_turbo_bf16.safetensors, BF16 형식의 전체 8스텝 체크포인트.diffusion_models/qwen_image_2.1_turbo_int8_convrot.safetensors, VRAM 사용량을 줄인 INT8 convrot 양자화.loras/qwen_image_2.1_turbo_lora_avg_rank_178_bf16.safetensors, 체크포인트를 교체하는 대신 베이스 transformer 위에 로드하는, 동일한 증류의 LoRA 추출본.
텍스트 인코더와 VAE는 Qwen-Image 2.1과 공유되므로, 이미 베이스 모델을 실행 중인 환경이라면 새로운 transformer 또는 LoRA만 있으면 됩니다. Turbo 가중치는 기존 공식 Qwen-Image 2.1 워크플로에 그대로 적용됩니다. 샘플러를 8 스텝, CFG 1로 설정하고 turbo diffusion 모델 또는 베이스 모델 + turbo LoRA 중 하나를 선택하세요.
초기 반응
릴리스는 같은 날 #qwen-image에 올라왔고 현장에서 바로 테스트되었습니다. RuneX는 "공식 turbo가 아주 잘 작동한다"고 보고했으며, 동일한 프롬프트에서 최소 한 개의 서드파티 Turbo LoRA보다 확실히 더 나아 보였다고 밝혔습니다. Corza는 배포된 시그마를 사용자 지정 Euler 스케줄과 비교했고 차이는 미미했으며, LoRA나 LoKR을 함께 쌓았을 때 나타나는 약간의 추가 샤프닝과 피부 디테일 정도가 대부분이었다고 말했습니다. 이는 베이스 모델에서 어댑터를 중첩했을 때 보고된 과도한 스무딩 문제와 동일합니다. Kijai는 더 나은 turbo 결과를 주장하는 커뮤니티 노드에 대해 별 감흥이 없다고 했으며, flow-matching 모델에서 ComfyUI의 Euler 샘플러는 이미 flow-match Euler이므로 그러한 노드는 대부분 시그마만 바꾸는 것이라고 지적했습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.