H3 Person Remover LoRA: 동영상에서 인물 삭제하기
Akatz Labs의 Person Remover LoRA는 SAM 3.1로 인물을 추적하고 마스크를 초록색으로 채운 뒤 겹치는 창 단위로 배경을 재구성하며, 바로 사용할 수 있는 ComfyUI 워크플로를 제공합니다.
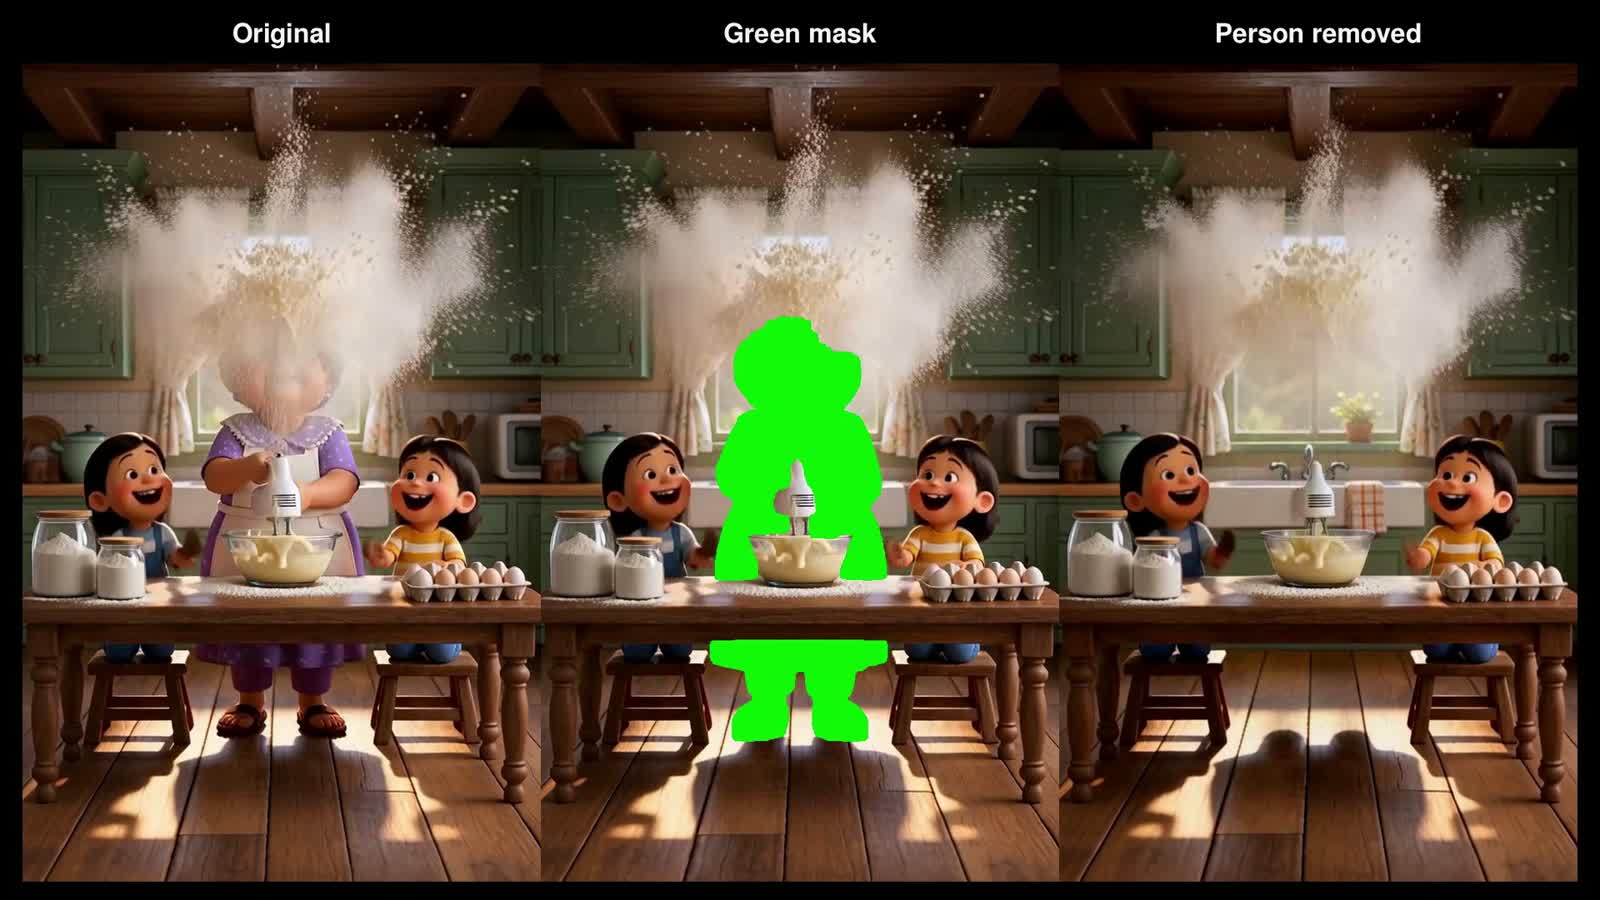
8개 예시로 구성된 쇼케이스에서: 원본 클립, 초록색 마스크, 재구성된 배경.
작성자의 이전/이후 쇼케이스, 가로 1280픽셀로 재인코딩한 영상.
어댑터가 하는 일과 하지 않는 일
이 LoRA는 인물을 세그멘테이션하지 않으며 깨끗한 배경을 스스로 만들어내지도 않습니다. SAM 3.1은 man in gray shirt 같은 텍스트 설명을 바탕으로 추적 마스크를 제공하며, 인물이 이미 사라진 동영상 첫 프레임의 깨끗한 버전은 이미지 편집기나 이미지 편집 모델을 통해 직접 준비해야 합니다. 그 이후는 창 리롤(window reroll) 워크플로가 처리합니다. 초록색 마스크가 씌워진 프레임이 입력되면 H3가 가려진 영역을 재생성하고, 재구성된 경계 프레임이 이어짐을 다음 창으로 넘겨줍니다.
기본 제거 프롬프트:
초록색으로 마스킹된 인물을 제거하고 배경을 재구성하세요. 카메라 움직임과 프레임 타이밍을 포함해 동영상의 나머지 부분은 그대로 유지하세요.
숫자로 보는 창 리롤
이 워크플로는 범용이 아니라 세밀하게 조정된 것이며, 기록된 설정은 그대로 따라 할 만한 가치가 있습니다:
| 설정 | 값 |
|---|---|
| Scheduler | beta / simple |
| CFG | 1 |
| Video / audio sigma shift | 12 / 3 |
| 마스크 확장 | 5픽셀 |
| 프레임 속도 | 24 fps |
| 시드 | 904234 |
Turbo나 VFX LoRA는 필요하지 않습니다. 이 워크플로는 17n + 5 형태의 H3 프레임 길이(22, 39, 56, 73 ...)를 사용하며, 더 긴 창은 메모리를 더 많이 소모하면서도 결과가 자동으로 좋아지지는 않으므로 22 프레임에서 시작할 것을 권장합니다. 각 이어짐은 생성된 경계 프레임을 다음 참조로 사용하고 18 프레임의 생성된 비디오 및 오디오 기록을 함께 전달하며, 릴레이는 겹치는 부분을 제거하고 결과를 소스 프레임 수에 맞춰 잘라냅니다. 출력은 기본적으로 무음이며, 사운드를 유지하려면 비디오 컴포넌트 추출의 원본 오디오를 마지막 비디오 생성 노드에 연결하면 됩니다.
입력 요구 사항은 구체적입니다. 24 fps 동영상, 너비와 높이가 32로 나누어떨어지는 영상, 그리고 이상적으로는 약 5초 길이의 짧은 연속 촬영본이어야 합니다.
학습 기록
V1은 pruned Ref2VA 모델을 기반으로 한 rank-16 어댑터로, 정적 5프레임 쌍과 보존 정규화로 250회의 초기 업데이트를 거친 뒤 2,000회의 옵티마이저 업데이트로 학습되었습니다.
| 설정 | 기록된 값 |
|---|---|
| 아키텍처 | minimax_h3_ref2va, pruned |
| Rank / alpha | 16 / 16, adaln_proj 제외 |
| 텐서 | BF16, 208개 어댑터 대상에 걸친 416개 텐서 |
| 옵티마이저 / 학습률 | AdamW8bit / 5e-5 |
| 텍스트 인코더 | NVFP4 Qwen3VL |
| 태스크 / 정규화 해상도 | 1152 / 256, 종횡비 버킷 |
| 태스크 프레임 길이 | 24 fps에서 5, 56, 73, 90, 124 |
| 정규화 길이 | 오디오 포함, 24 fps에서 107 프레임 |
| 런타임 | AI Toolkit 0.13.23 + 기록된 aligned-video-guide 패치 |
혼합 단계의 학습 풀에는 128개의 정적 쌍, 20개 장면에서 추출한 80개의 움직이는 마스크 발췌, 6개의 보존 클립이 포함됩니다. 데이터셋 카드에는 구성, 분할, 검토 상태가 문서화되어 있으며, training/에는 설정, 스케줄, 모델 해시, 런타임 패치가 담겨 있습니다.
제한 사항
Akatz Labs는 아직 실패하는 부분을 솔직하게 밝힙니다:
- H3는 전체 장면을 재생성하므로, 학습 쌍이 마스크 외부의 픽셀을 보존하더라도 마스크되지 않은 영역이 원본에 픽셀 단위로 고정되지 않습니다.
- 놓친 손, 머리카락 경계, 그림자, 반사, 가려진 신체 부위가 남을 수 있으며, 마스크가 클수록 모델이 더 많은 배경을 지어내야 합니다.
- 깨끗한 첫 프레임의 품질이 나쁘면 이후 창들로 전파되며, 강한 카메라 움직임이나 급격한 장면 전환은 연속성을 깨뜨릴 수 있습니다.
- 창을 리롤하면 그 이어짐이 바뀌므로, 재구성된 뒷부분도 함께 확인해야 합니다.
- 기록된 데이터셋 승인 플래그는 여전히 false입니다. 기술적 검사를 통과한 것이 모든 예시에 대한 사람의 승인과 같은 의미는 아닙니다.
사용 가능 여부
이 워크플로에는 네이티브 MiniMax H3 및 SAM 3.1 지원이 포함된 최신 ComfyUI와 models/loras/에 위치한 H3-Person-Remover-V1.safetensors가 필요합니다. 공개된 워크플로는 H3 ref2va pruned INT8 ConvRot 트랜스포머, NVFP4 Qwen3VL 텍스트 인코더, H3 비디오 및 오디오 VAE, SAM 3.1 multiplex를 고정합니다. 이전 검증은 RTX 4090과 ComfyUI 0.37.0에서 수행되었으며, 작성자는 이를 최소 사양이 아니라 테스트된 구성이라고 설명합니다. H3 Relay는 이 워크플로가 사용하는 창 미리보기와 리롤 컨트롤을 제공합니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.