Qwen-Image 2.1 복원 LoRA: 원본 구도를 지키는 업스케일
Qwen-Image 2.1용 커뮤니티 LoRA가 복원하거나 확대한 사진을 원본 프레임 그대로 유지합니다. 적용하지 않으면 2.2 px 어긋나던 것이 0.3 px로 줄어들며, ComfyUI 워크플로와 두 개의 체크포인트도 함께 제공됩니다.
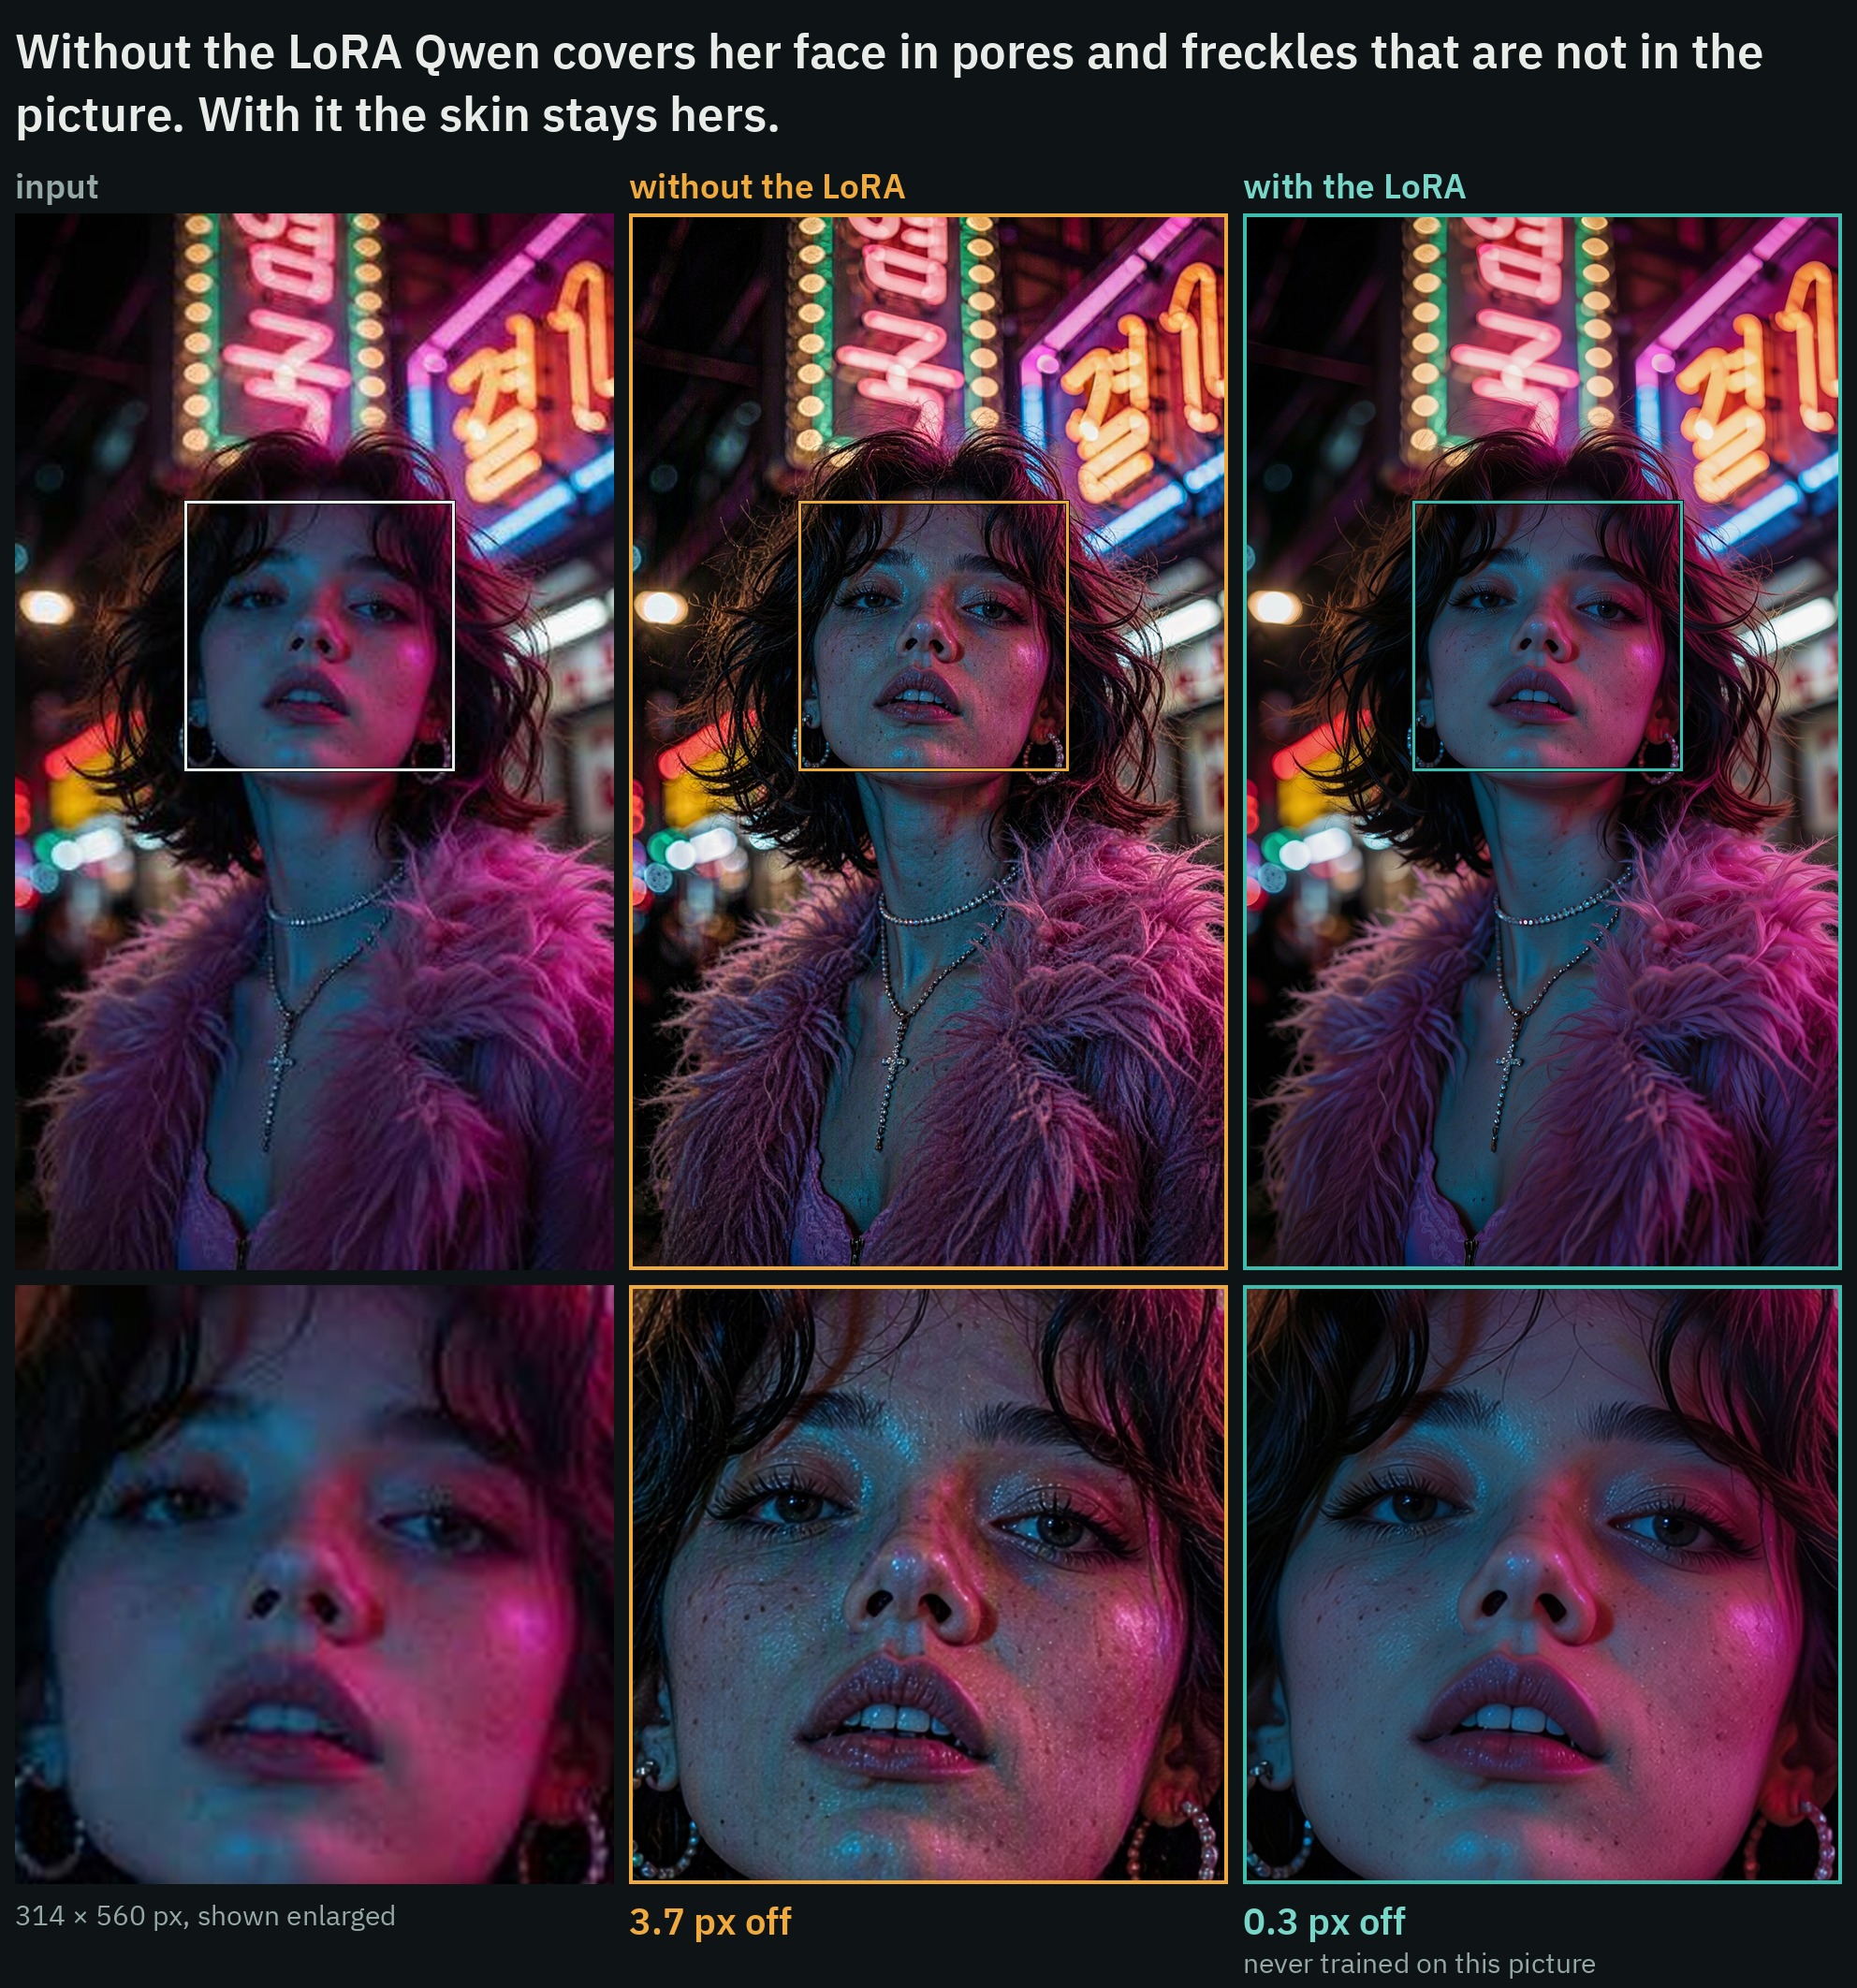
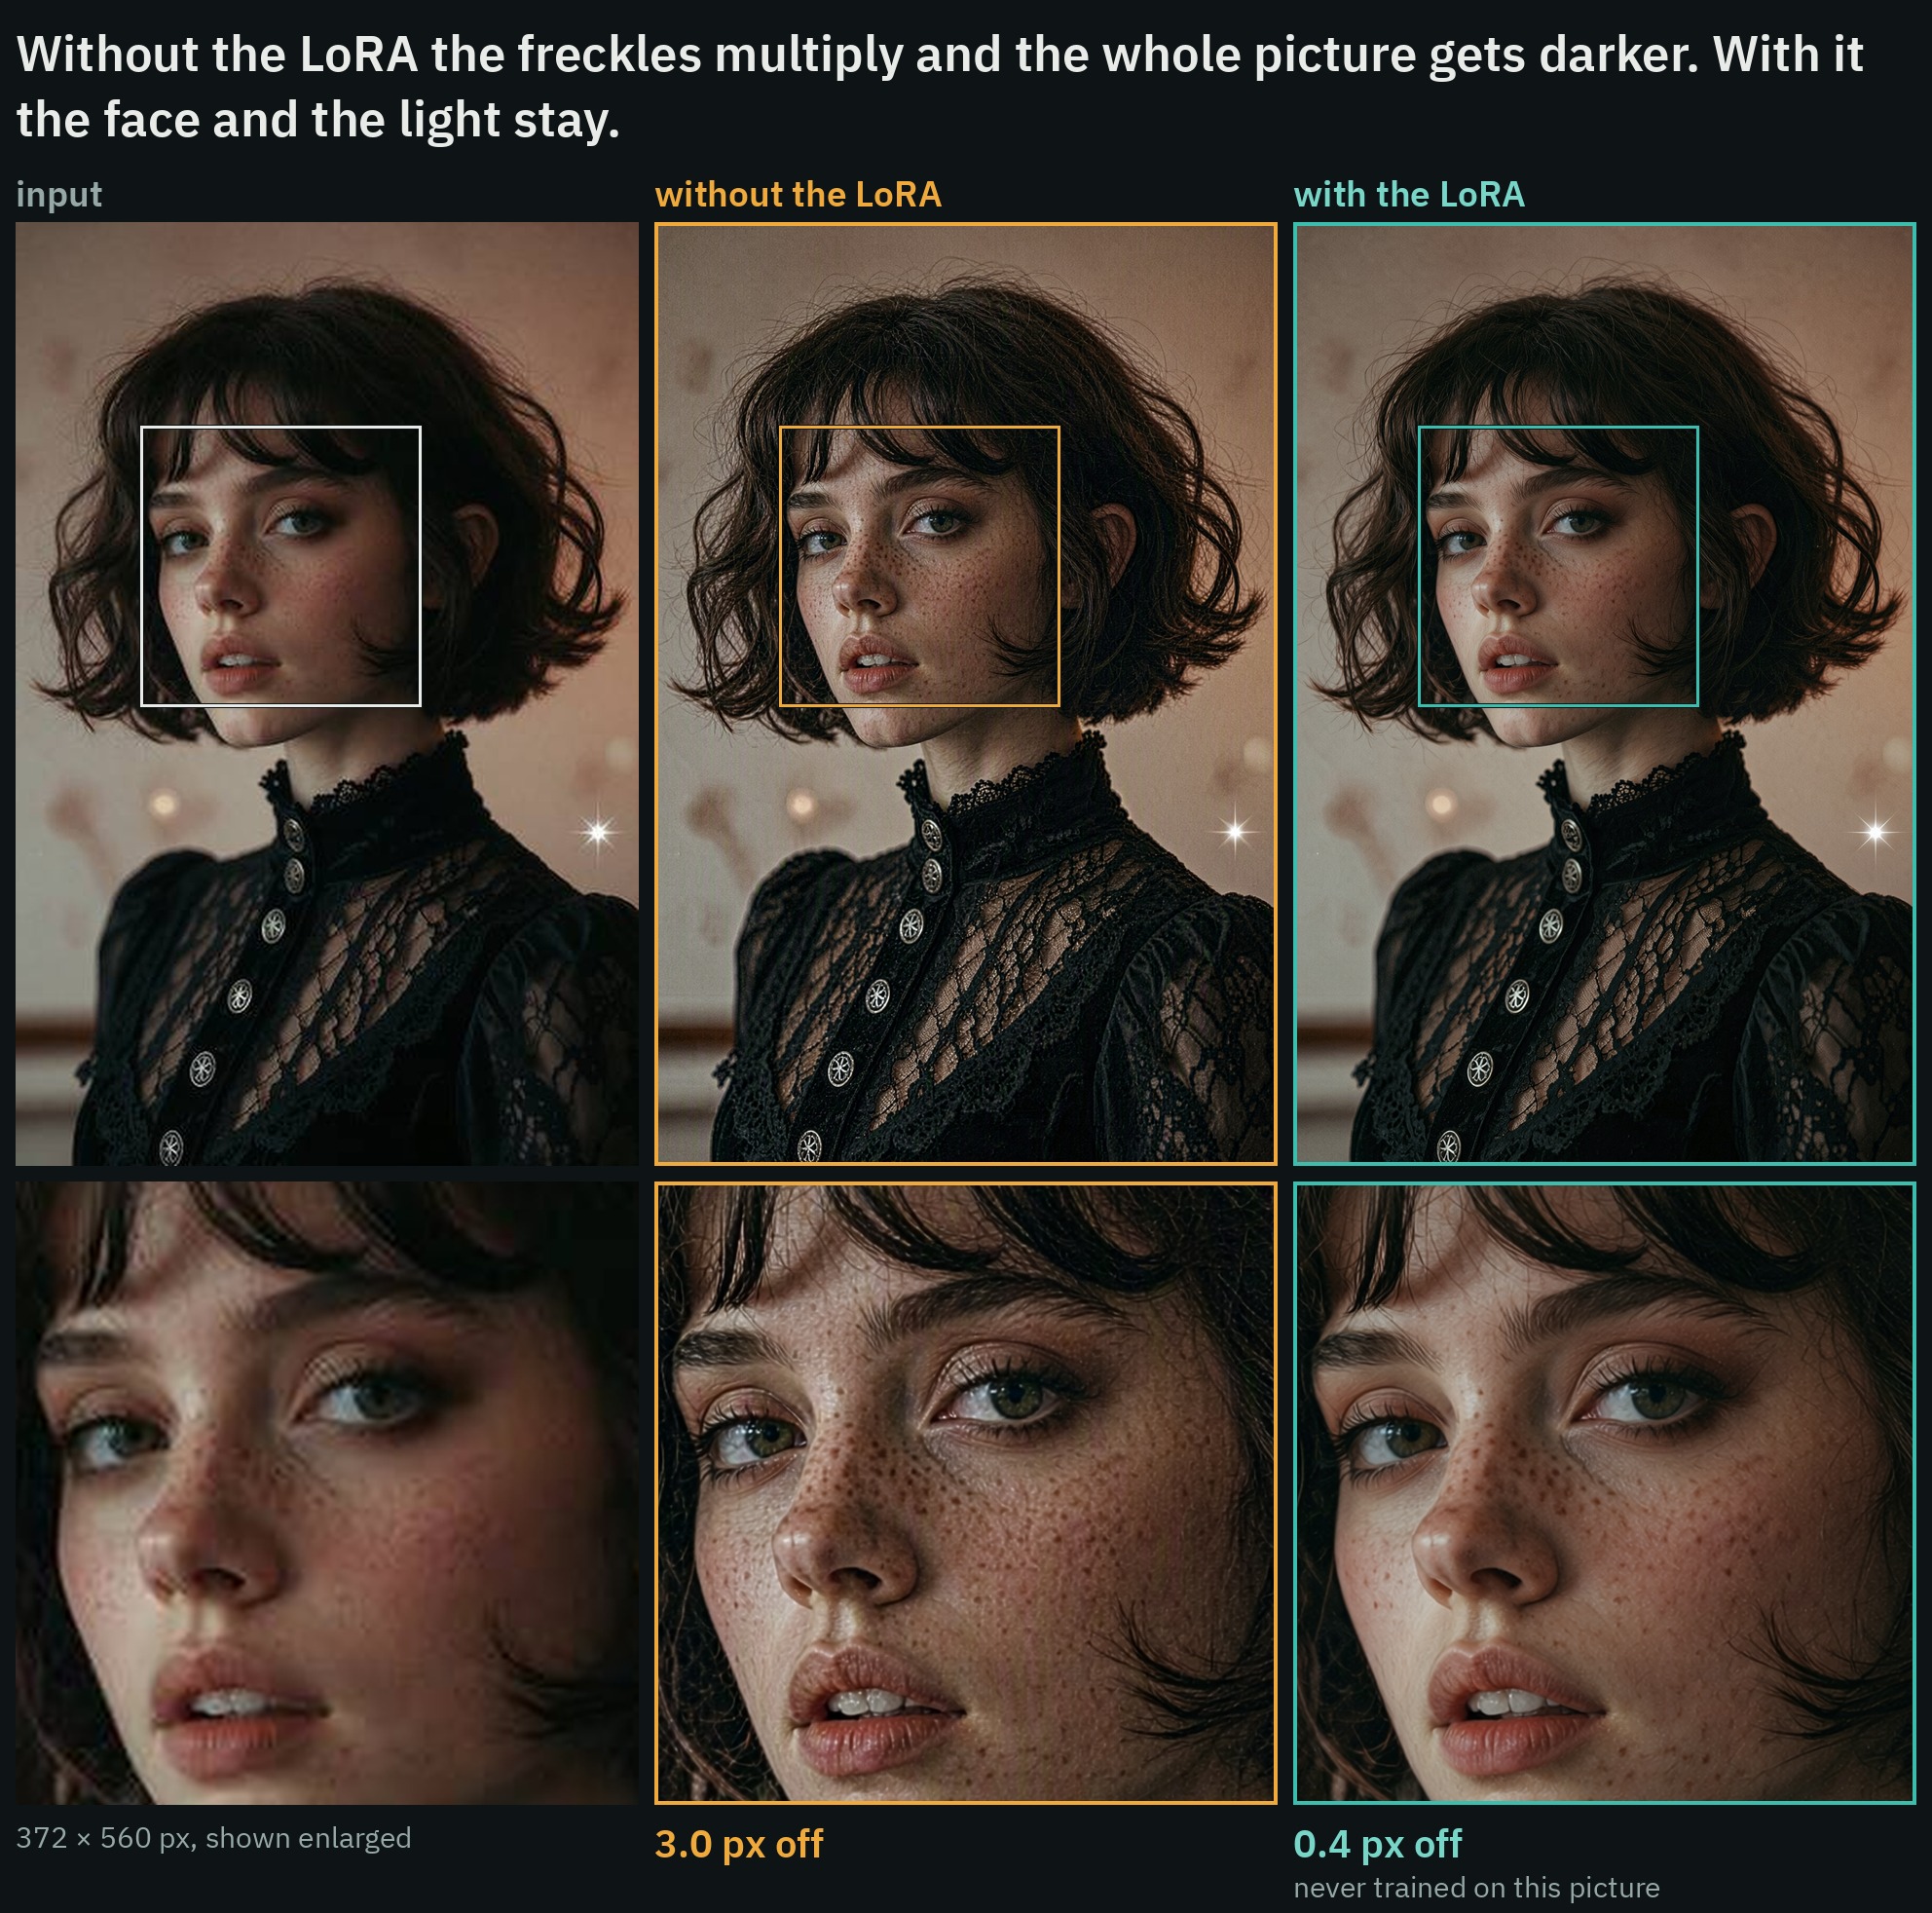
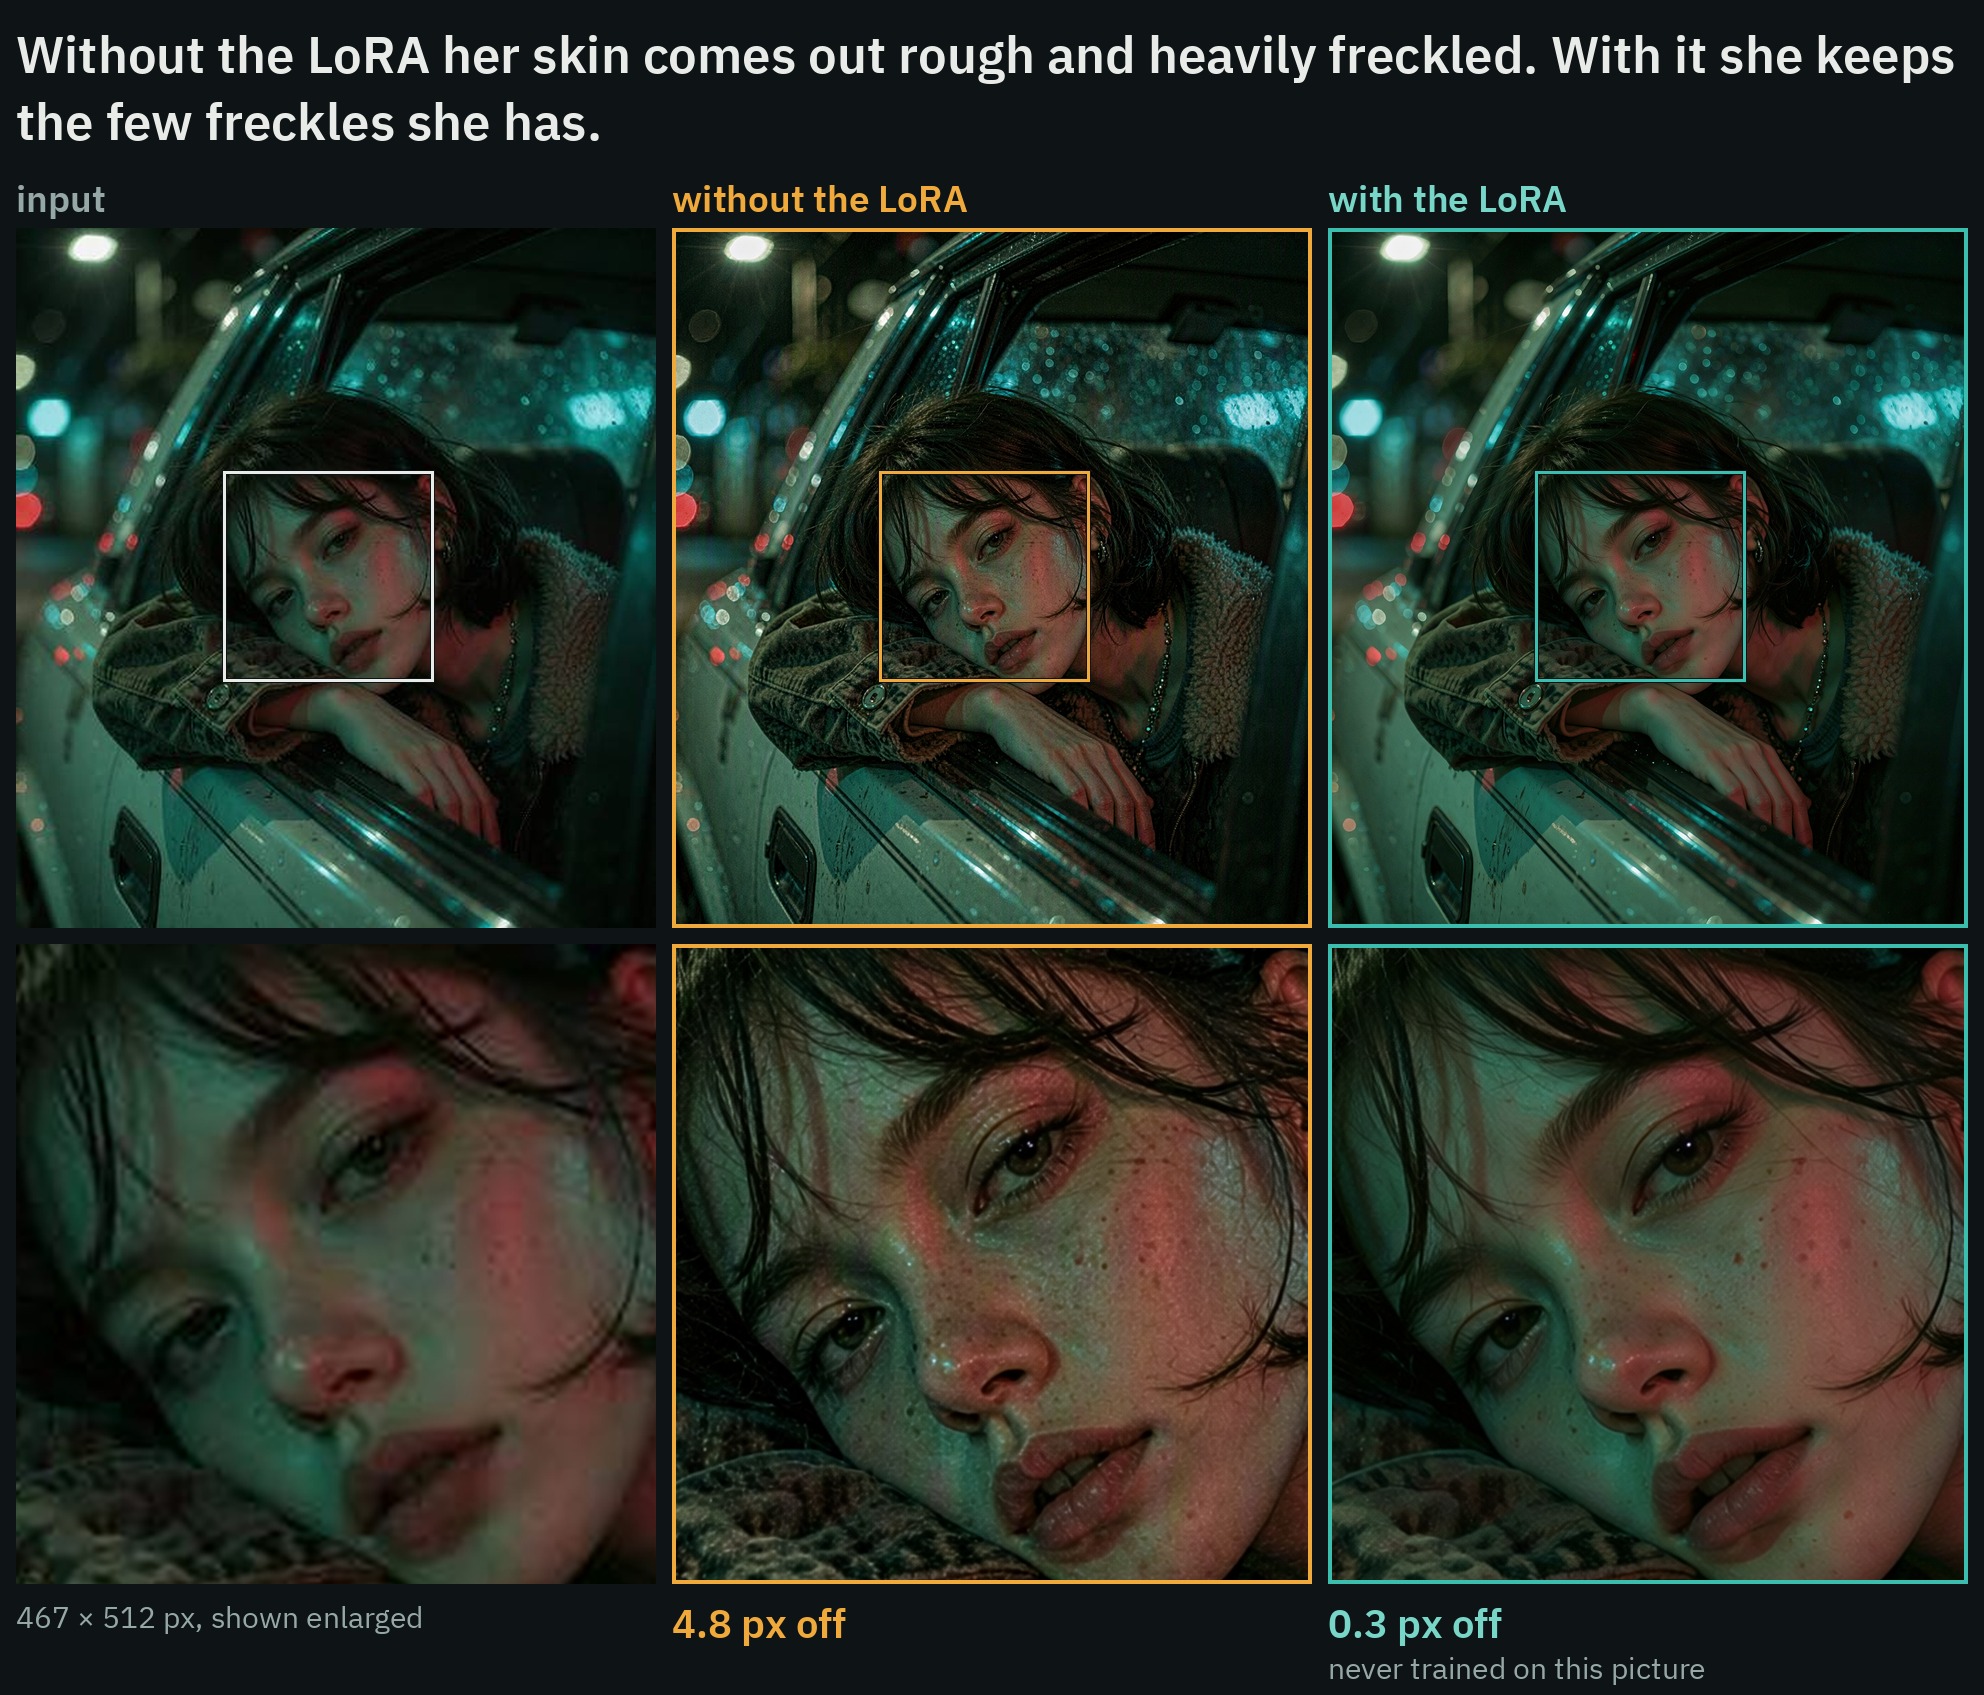
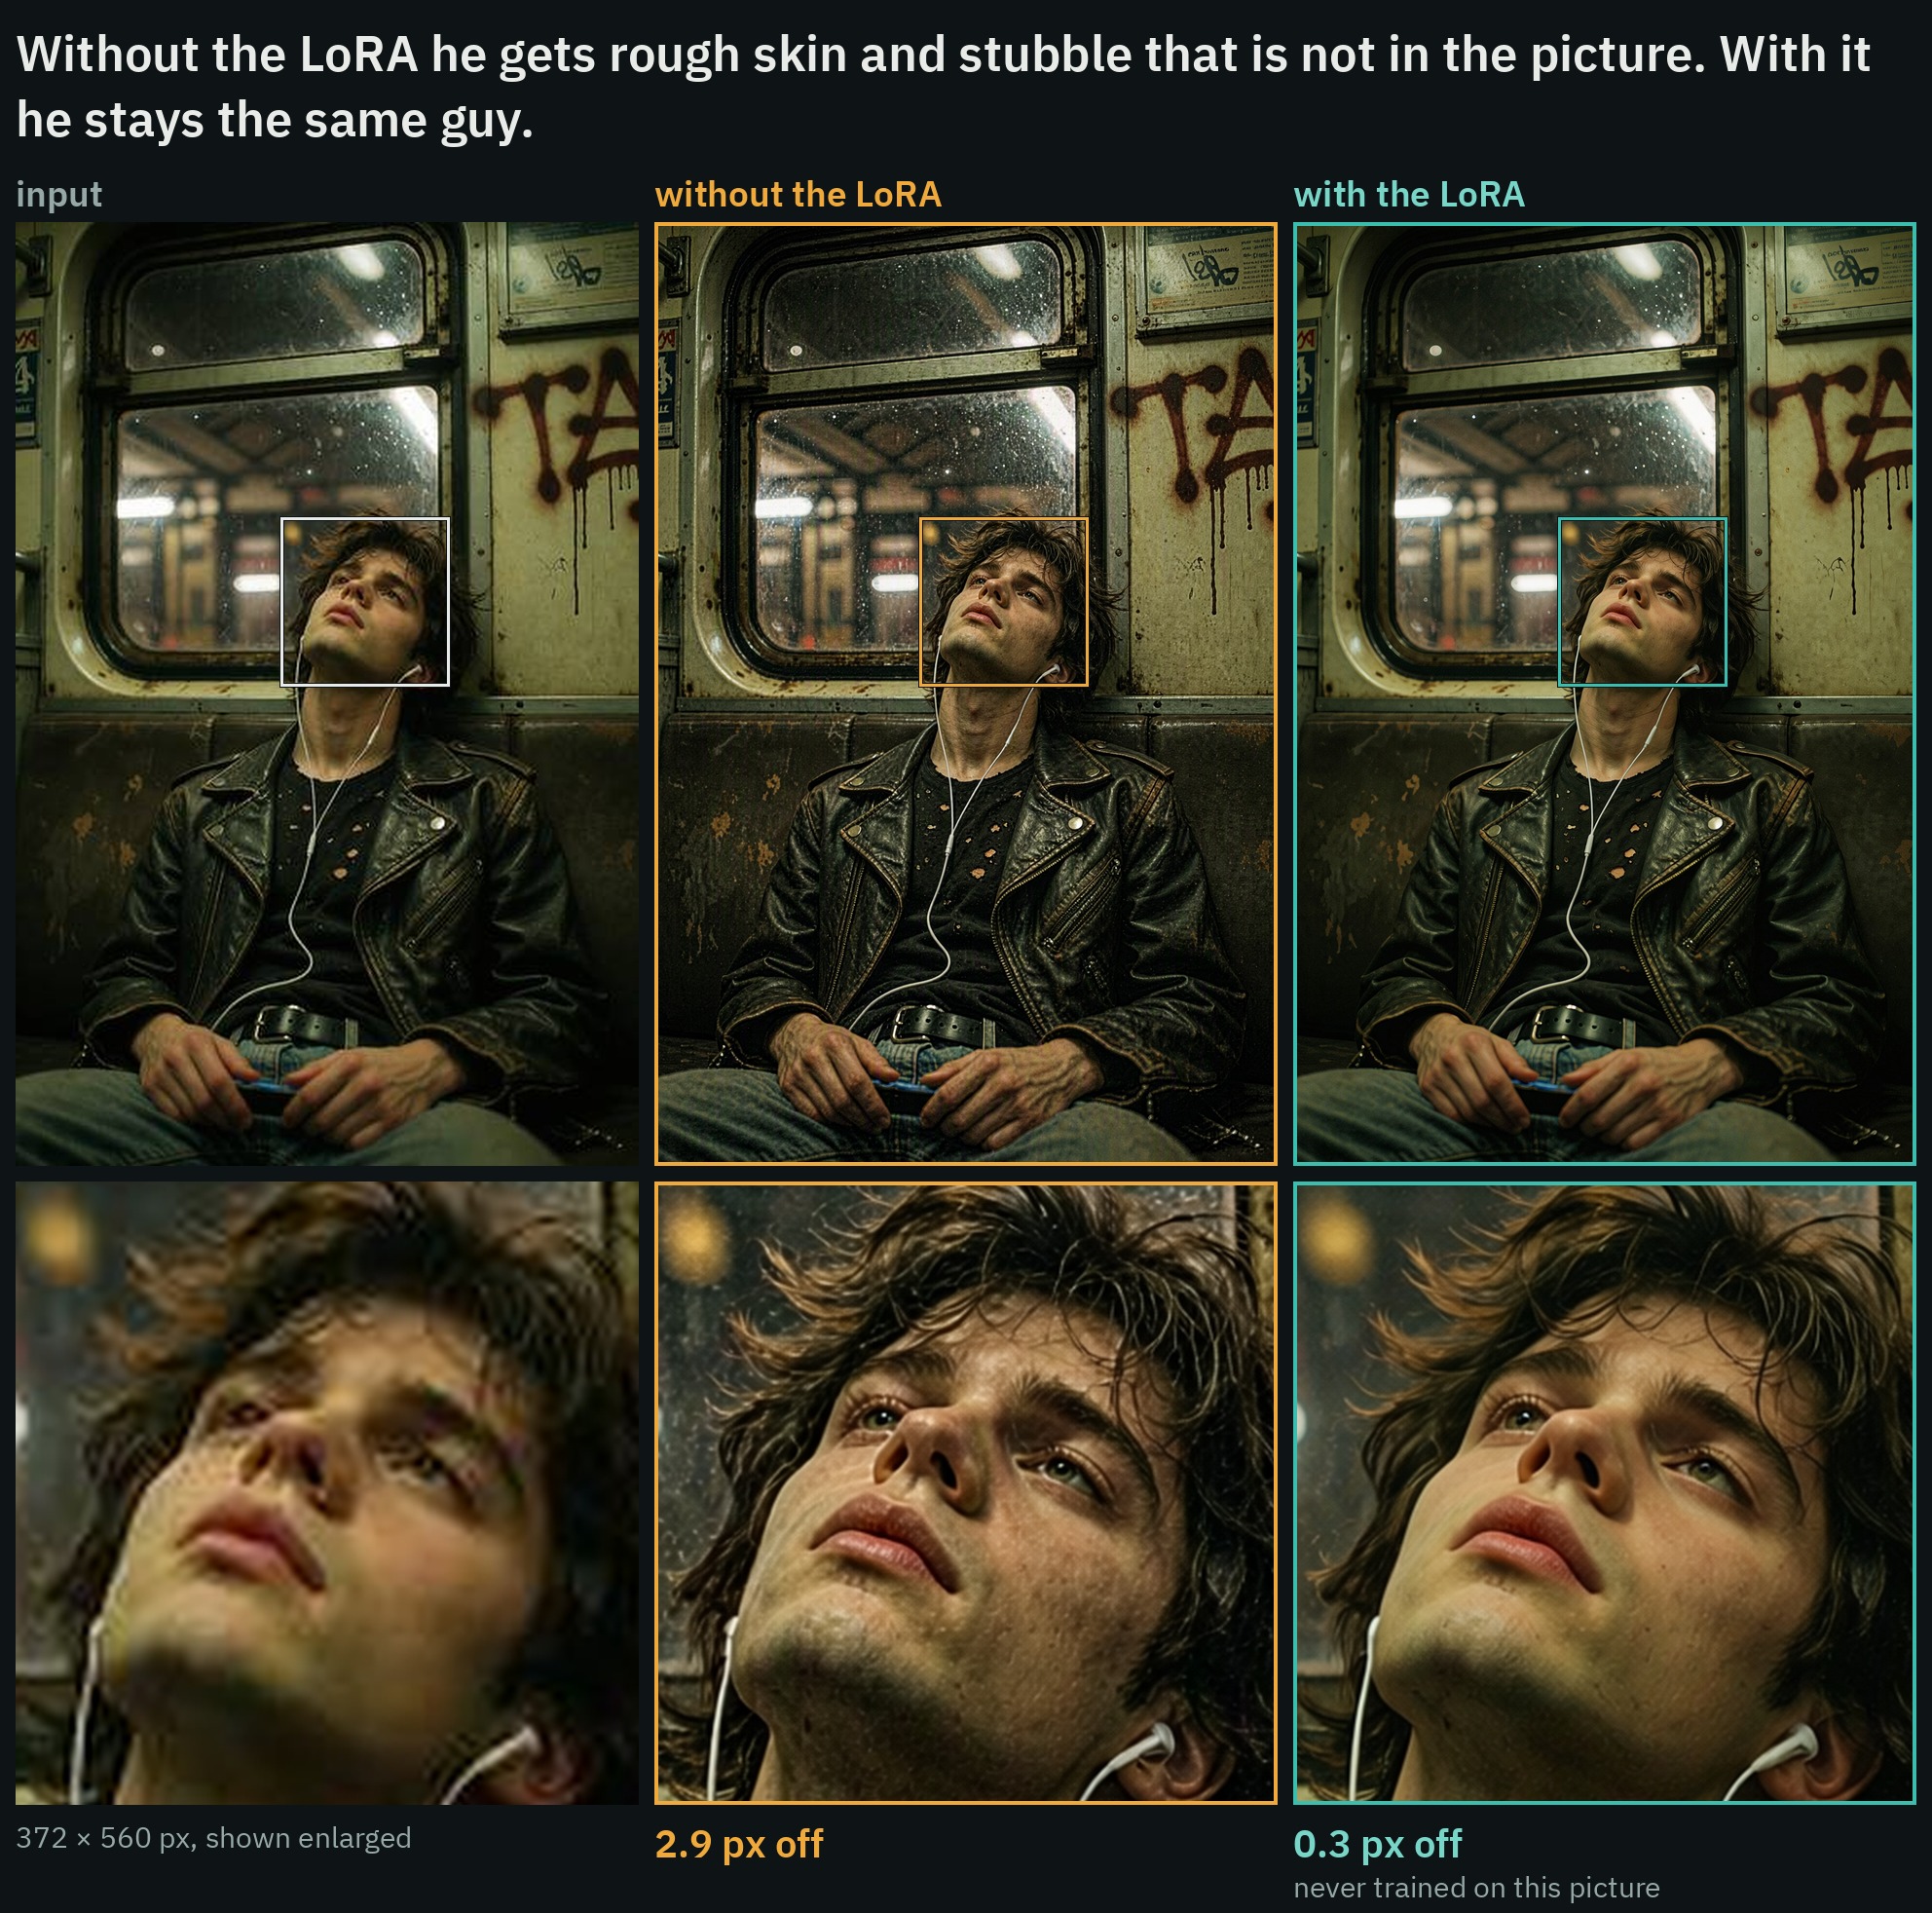
각 비교에서: 작은 입력, LoRA 없이 만든 결과, LoRA를 적용한 결과, 그리고 그 아래에 확대해 표시한 부분. 모두 저장소 자체 워크플로로 같은 프롬프트와 시드, Viggle Turbo로 8스텝, 약 2 MP로 실행했습니다. "px off"는 결과가 입력을 축소해 만든 원본 크기 사진에서 얼마나 떨어져 있는지를 나타냅니다. 이 사진들은 모두 학습 세트에 들어 있지 않습니다.
일반 Qwen-Image 2.1이 작은 사진에 미치는 영향
Qwen-Image 2.1은 그 자체로도 우수한 사진 복원 도구이며, 그 실패 양상은 블러와 정반대입니다. 압축되었거나 저해상도인 사진을 확대하라고 하면 원본에는 없던 디테일을 만들어냅니다. 모공, 주근깨, 수염 자국, 그레인 같은 것들이죠. 그리고 사진 속 인물보다 몇 년은 더 나이 든 얼굴로 다시 그립니다. 사물의 위치도 바꿔 놓습니다. 작성자의 테스트 세트 전반에서 일반 Qwen-Image 2.1 결과물의 가장 나쁜 모서리는 원본 크기와 2.35 px 어긋났는데, 화면에서는 작아 보이지만 결과물을 소스 위에 다시 겹쳐 놓을 수 없을 만큼은 충분한 차이입니다.
이 LoRA는 그렇게 만들어낸 텍스처 일부를 포기하는 대신 사진 위에 머무르도록 학습되었습니다. 이것은 복원이 아니라 다시 그리기입니다. 세밀한 디테일은 여전히 만들어낸 것이며, 다만 그 양이 줄었을 뿐입니다. 카드에도 이 점이 분명히 적혀 있습니다.
- 트리거 단어 없음. 먼저 사진을 약 2 MP로 확대하고(양 변이 32로 나누어떨어지도록), 이미지 1로 넣은 뒤 요청하세요.
- 초점이 맞은 작은 사진이나 압축된 사진에는 Strength 1.0.
- Qwen 고유의 텍스처를 조금 더 원한다면 Strength 0.75.
- 흐릿한 사진, 흔들린 사진, 비디오 프레임에는 Strength 0.5.
Restore the photo: remove blur, noise and compression artifacts and recover sharp, natural detail, keeping the same composition, people and colors.긁히거나 색이 바랜 인화지의 경우, 카드에서는 색상까지 복원하는 두 번째 프롬프트를 사용합니다.
Restore the old photo: remove scratches, dust, fading and grain and recover sharp, natural detail and color, keeping the same composition and people.측정된 홀드아웃
작성자 본인의 사진 8장을 긴 변 기준 512 또는 560 px로 축소해 품질 70의 JPEG로 저장한 뒤, 약 2 MP로 확대하고 동일한 시드, LoRA 1.0, CFG 1, euler / simple로 복원했습니다. 모든 수치는 모델이 한 번도 보지 못한 원본 크기 원본과 비교해 측정했습니다. 8 스텝 열은 Viggle Turbo를 사용했고, 25 스텝 열은 사용하지 않았습니다:
| 홀드아웃 이미지 8장 | LoRA 없음, 8 스텝 | LoRA 적용, 8 스텝 | LoRA 없음, 25 스텝 | LoRA 적용, 25 스텝 |
|---|---|---|---|---|
| 원본과의 거리, 최악 코너 중앙값 | 2.35 px | 0.26 px | 1.59 px | 0.15 px |
| 동일 지표, 8장 중 최악 | 3.83 px | 0.38 px | 3.25 px | 0.26 px |
| 원본과의 유사도 (SSIM, 1 = 동일) | 0.578 | 0.766 | 0.743 | 0.812 |
| PSNR | 23.2 dB | 28.0 dB | 26.3 dB | 29.3 dB |
| 색상 및 밝기 변화 | 2.05 % | 0.97 % | 1.72 % | 1.04 % |
| 동일 인물 (얼굴 인식, 1 = 동일) | 0.821 | 0.905 | 0.837 | 0.901 |
| 세부 디테일, 원본 대비 | 121 % | 78 % | 58 % | 36 % |
세부 디테일 행은 그 타협을 하나의 숫자로 보여줍니다. 100 %를 넘으면 만들어낸 디테일이라는 뜻입니다. 8 스텝에서 LoRA 없이 순수한 Qwen-Image 2.1은 원본에 있는 것보다 더 많은 그레인을 그려내고, 25 스텝에서는 원본의 약 절반만 그려냅니다. LoRA를 적용하면 둘 다 원본보다 낮아서 결과가 다소 부드럽게 보입니다. 작성자는 같은 8 스텝 테스트에 사진 29장을 추가로 돌렸습니다. LoRA 사용 시 0.28 px 차이, 미사용 시 2.16 px, 동일 인물 0.88 대 0.79, SSIM 0.777 대 0.611이었습니다.
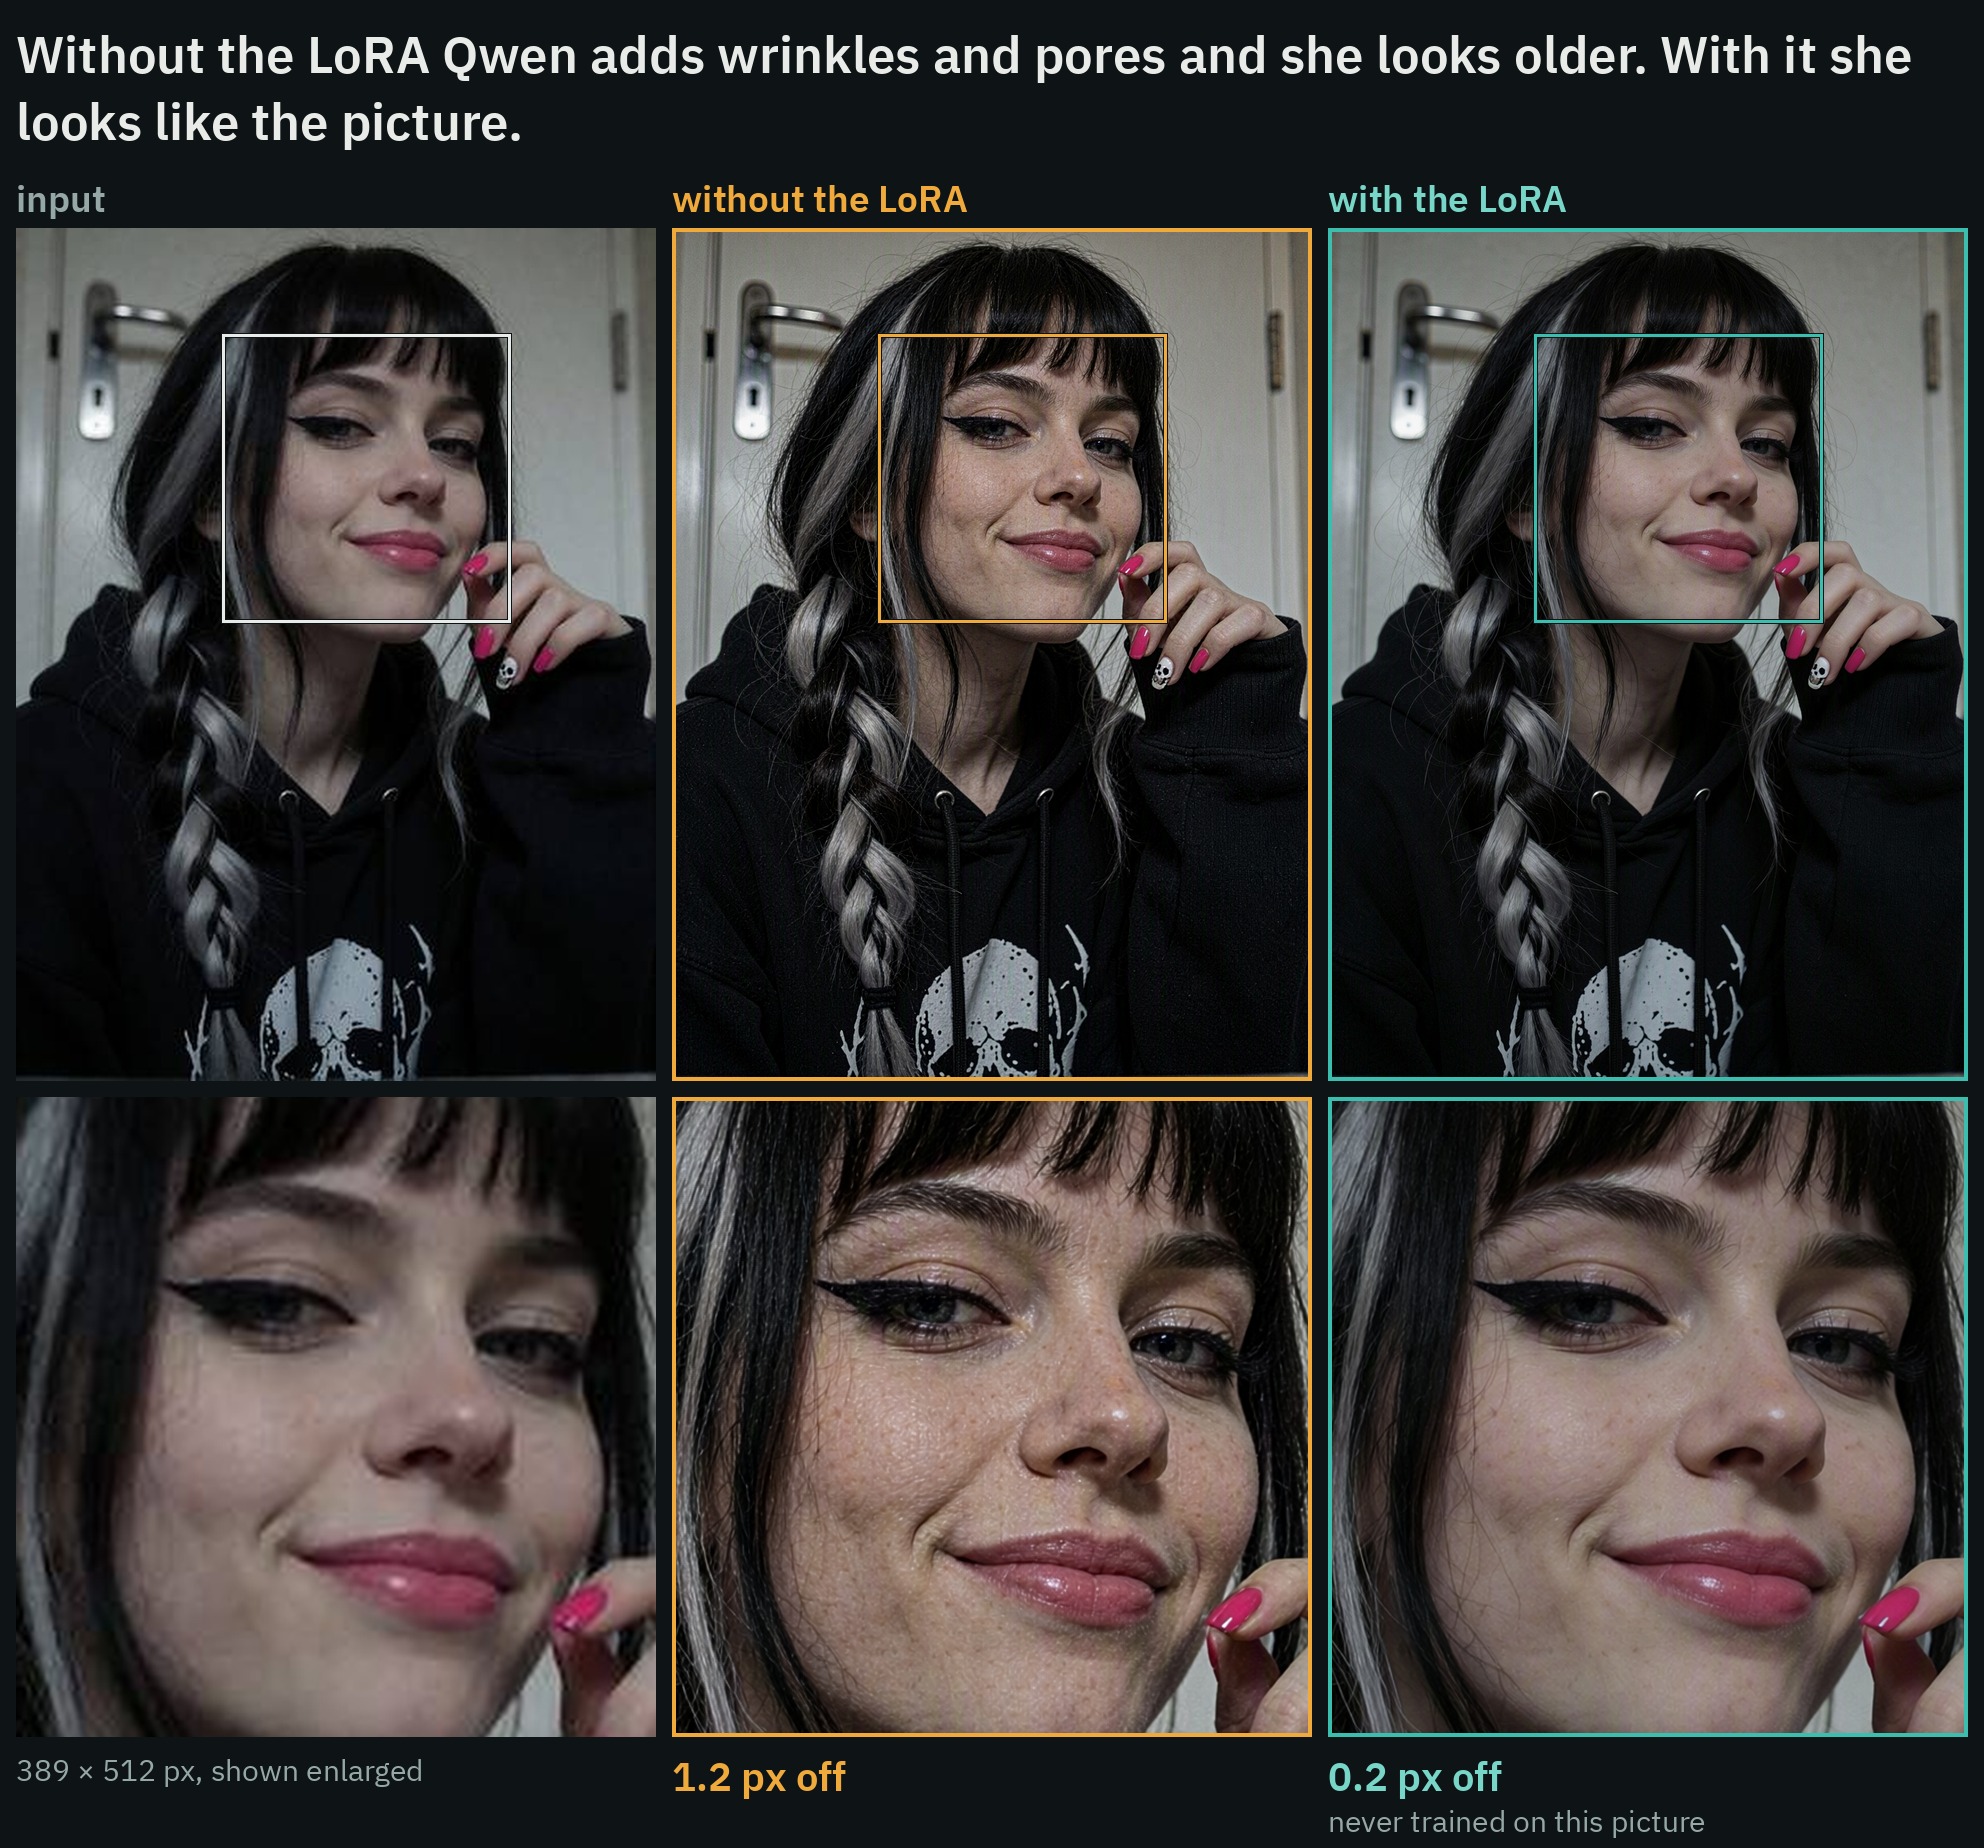
389 px JPEG를 2 MP로 확대한 것. 이 사진 중 어느 것도 학습 세트에 없습니다.
모든 종류의 손상
이번 릴리스에서는 학습 쌍과 동일한 방식으로 손상된 57개의 홀드아웃 쌍에 대해, 일반 요청으로 8스텝 1회 패스를 수행한 결과도 함께 보고합니다. SSIM은 깨끗한 원본 이미지를 기준으로 측정하며, "px off"는 중앙값입니다:
| 손상 종류 | 이미지 수 | SSIM, 손상된 입력 | SSIM, LoRA 없음 | SSIM, LoRA 사용 | px off, LoRA 없음 | px off, LoRA 사용 |
|---|---|---|---|---|---|---|
| 작은 웹 이미지 | 15 | 0.772 | 0.524 | 0.716 | 2.53 | 0.31 |
| 휴대폰 스무딩 | 5 | 0.836 | 0.565 | 0.857 | 2.65 | 0.17 |
| 비디오 정지 화면 | 5 | 0.771 | 0.578 | 0.745 | 2.77 | 0.50 |
| 저장 후 재저장 | 5 | 0.816 | 0.560 | 0.794 | 2.21 | 0.24 |
| 블러와 노이즈 | 5 | 0.496 | 0.521 | 0.678 | 2.48 | 0.24 |
| 저해상도 JPEG | 5 | 0.777 | 0.531 | 0.763 | 3.16 | 0.23 |
| 복합 손상 | 5 | 0.735 | 0.646 | 0.746 | 1.28 | 0.25 |
| 오래된 인쇄물 | 4 | 0.551 | 0.437 | 0.749 | 2.46 | 0.19 |
| 밴딩 | 4 | 0.915 | 0.463 | 0.843 | 2.34 | 0.17 |
| 저해상도 PNG | 4 | 0.873 | 0.636 | 0.847 | 3.39 | 0.15 |
| 전체 | 57 | 0.756 | 0.544 | 0.762 | 2.70 | 0.23 |
LoRA를 사용하면 57개 모두에서 결과가 깨끗한 원본 이미지에 더 가까웠고, 57개 모두에서 변화 폭도 더 작았습니다. 몇몇 종류에서는 손상된 이미지 자체가 어떤 복원 결과보다 더 높은 점수를 받는데, 이는 부드러운 이미지가 평균적으로 원본에 가깝기 때문입니다.
오래된 인쇄물은 4개의 홀드아웃 예시에 대해 별도 수치를 가집니다. 색상과 밝기는 복원 이전에 깨끗한 원본 이미지에서 15% 벗어났고, 일반 요청으로 복원한 이후에는 7%, 오래된 사진 요청으로는 4% 벗어났습니다. 스크래치, 먼지, 그레인은 어느 요청에서든 사라졌습니다. 모델이 본 적 없는 종류의 색 바램은 그대로 남을 수 있습니다. 다른 바램을 사용한 두 번째 테스트에서는 스크래치가 사라졌지만 바랜 색상은 그대로 남았습니다.
강도는 다이얼입니다
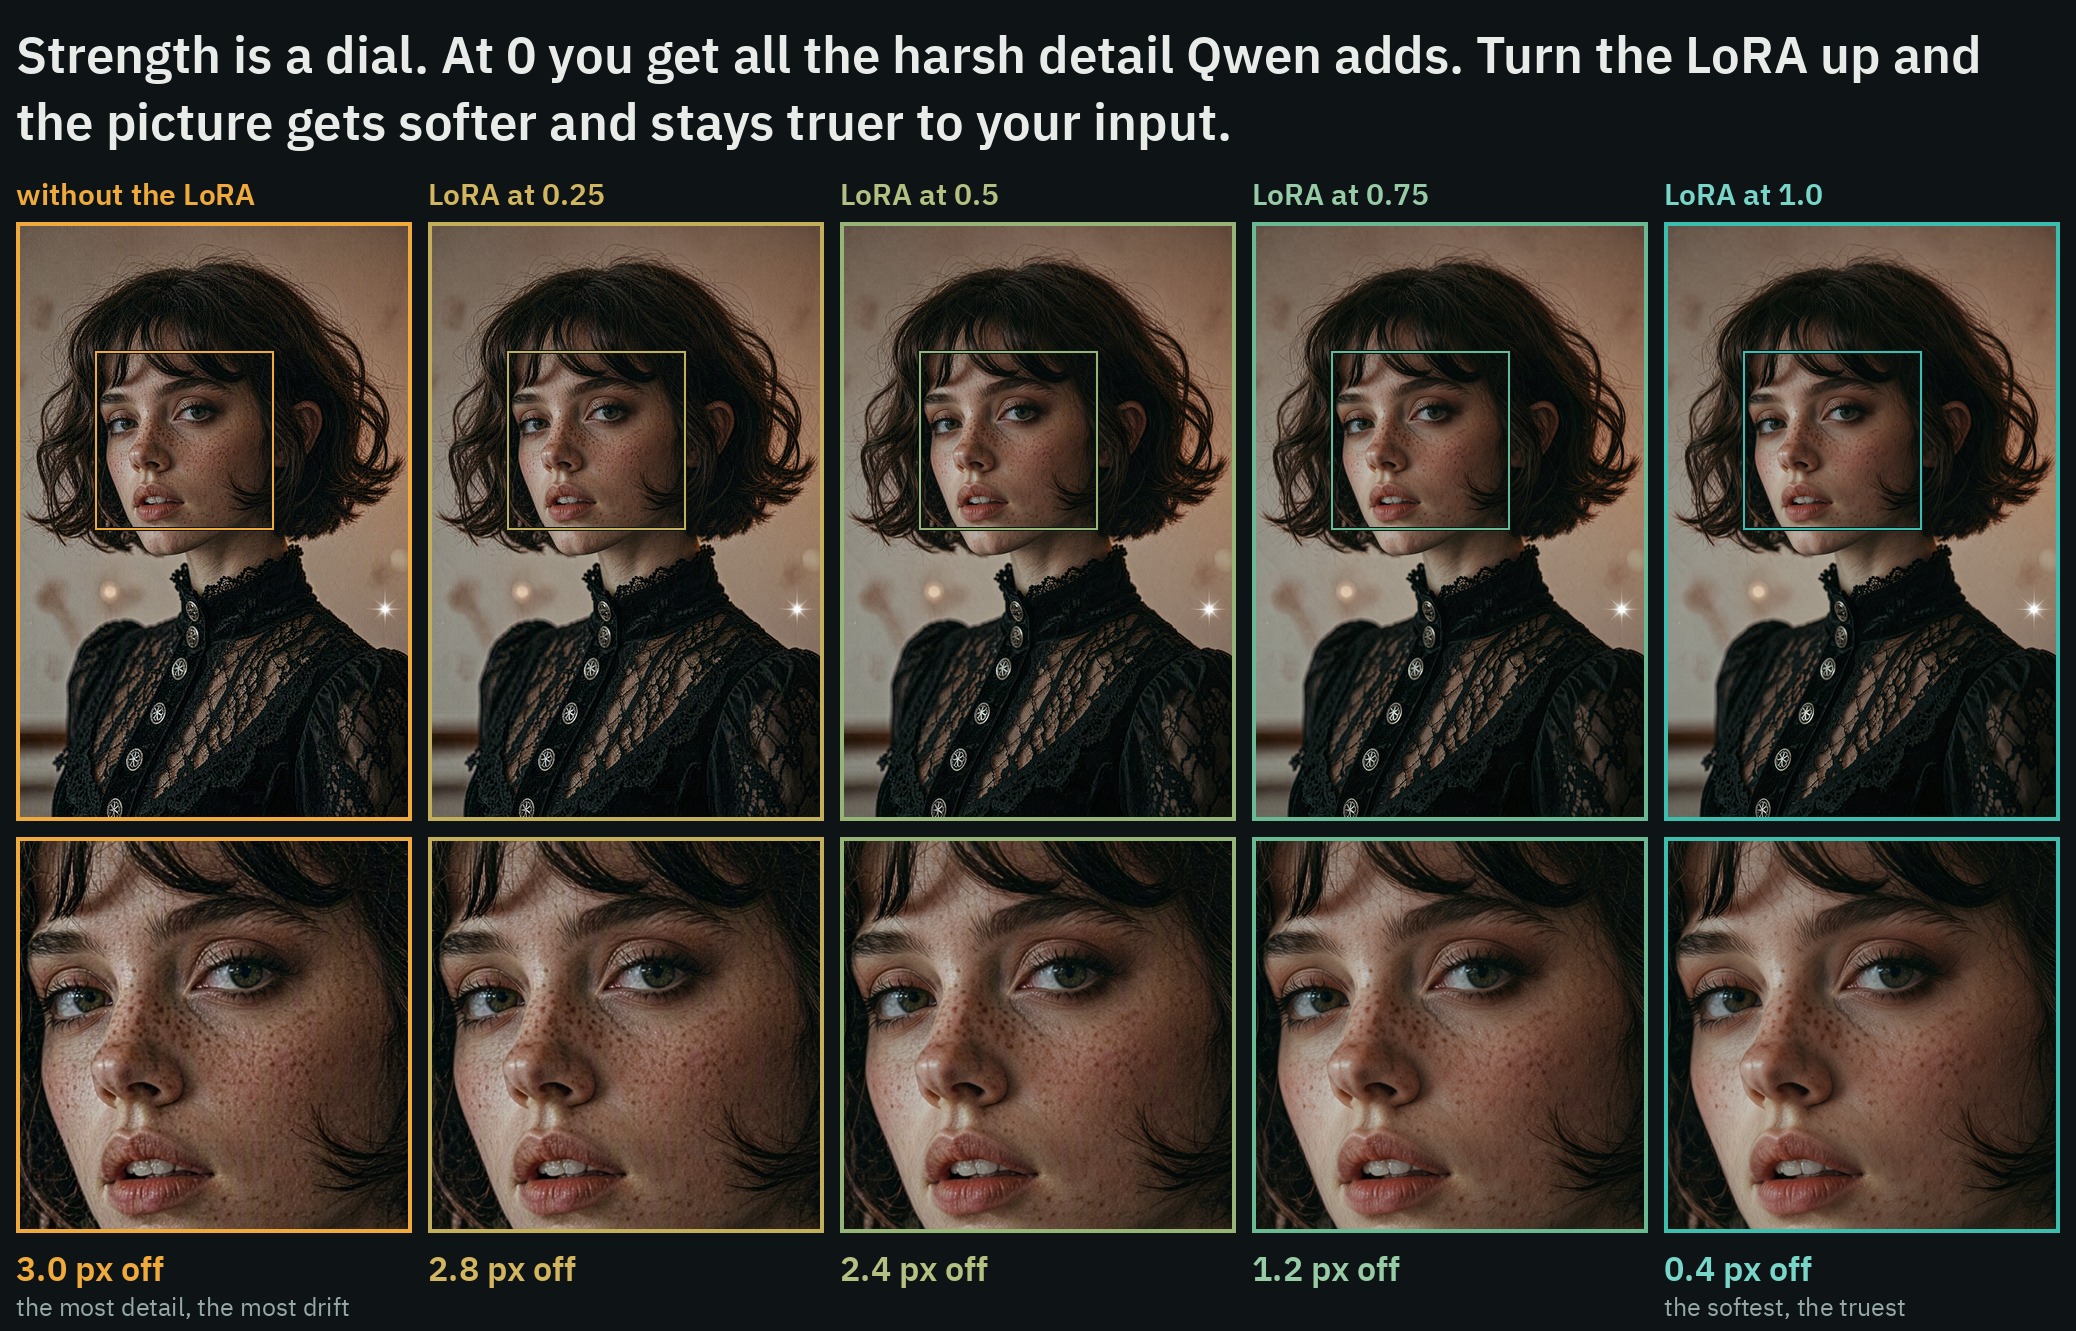
29장의 사진 세트에서 전체 범위는 순수 Qwen에 해당하는 0부터 가장 충실한 결과를 내는 1.0까지 이어집니다:
| 강도 | off / 0.5 / 0.75 / 1.0 |
|---|---|
| 원본과의 차이 | 2.16 px / 1.31 px / 0.37 px / 0.28 px |
| 동일 인물 | 0.794 / 0.858 / 0.875 / 0.880 |
| 색상 및 밝기 변화 | 1.88 % / 1.26 % / 1.05 % / 0.94 % |
| 원본 대비 세부 디테일 | 102 % / 81 % / 77 % / 72 % |
흐릿한 사진에서 이 다이얼이 가장 중요합니다. 작성자는 실제 저해상도 사진 26장(오래된 셀카와 휴대폰 사진)을 1.0, 0.75, 0.5로 실행했습니다. 가장 흐릿한 6장에서는 1.0이 부드럽게 돌아왔고 0.75는 거의 도움이 되지 않았으며 0.5는 선명하게 돌아왔습니다. 나머지 20장에서는 세 설정 모두 작업 완료되었고 1.0이 가장 매끄러웠습니다. 부드러운 사진을 타일로 나누어 8 MP로 확대한 경우에도 그렇게 시도한 3장에서는 1.0에서 선명하게 돌아왔습니다.
이 LoRA는 사진으로 학습되었지만 그림에서도 성능을 유지합니다. 6장의 테스트 그림(애니메이션, 글자가 있는 포스터, 수채화, 3D 카툰, 만화, 유화)에서 스타일과 글자를 그대로 보존했습니다: SSIM은 LoRA 없이 0.491인 것에 비해 0.714였고, 원본과의 오차는 2.65 px 대비 0.27 px였습니다.
다른 도구와의 비교
이 카드는 이번 릴리스를 같은 작업에 사용할 수 있는 다른 도구들과 비교합니다. 동일한 29장의 사진, 동일한 측정 방식, 모두 1.0으로 실행했습니다. 이 도구들이 모두 같은 목적으로 만들어진 것은 아닙니다. 일부는 디테일을 더하기 위해 만들어졌고, 이 LoRA는 사진을 그대로 유지하기 위해 만들어졌습니다. 따라서 이 표는 한 가지 질문, 즉 결과가 원본에 얼마나 가깝게 남는지에 대한 답을 보여줍니다.
| 작은 사진 29장 | 원본에서 벗어난 정도 | 얼굴 동일성 | 색상 및 밝기 변화 | SSIM |
|---|---|---|---|---|
| Qwen Image 2.1 단독 | 2.16 px | 0.79 | 1.88 % | 0.611 |
| SeedVR2 (3B), ComfyUI 자체 노드 | 0.42 px | 0.82 | 0.44 % | 0.771 |
| Deblur anything | 0.39 px | 0.85 | 1.42 % | 0.702 |
| Detail Enhancer, 동일한 그래프에서 | 2.07 px | 0.76 | 2.94 % | 0.673 |
| Detail Enhancer, 자체 워크플로, 25 스텝 | 12.45 px | 0.71 | 4.16 % | 0.590 |
| 이 LoRA | 0.28 px | 0.88 | 0.94 % | 0.777 |
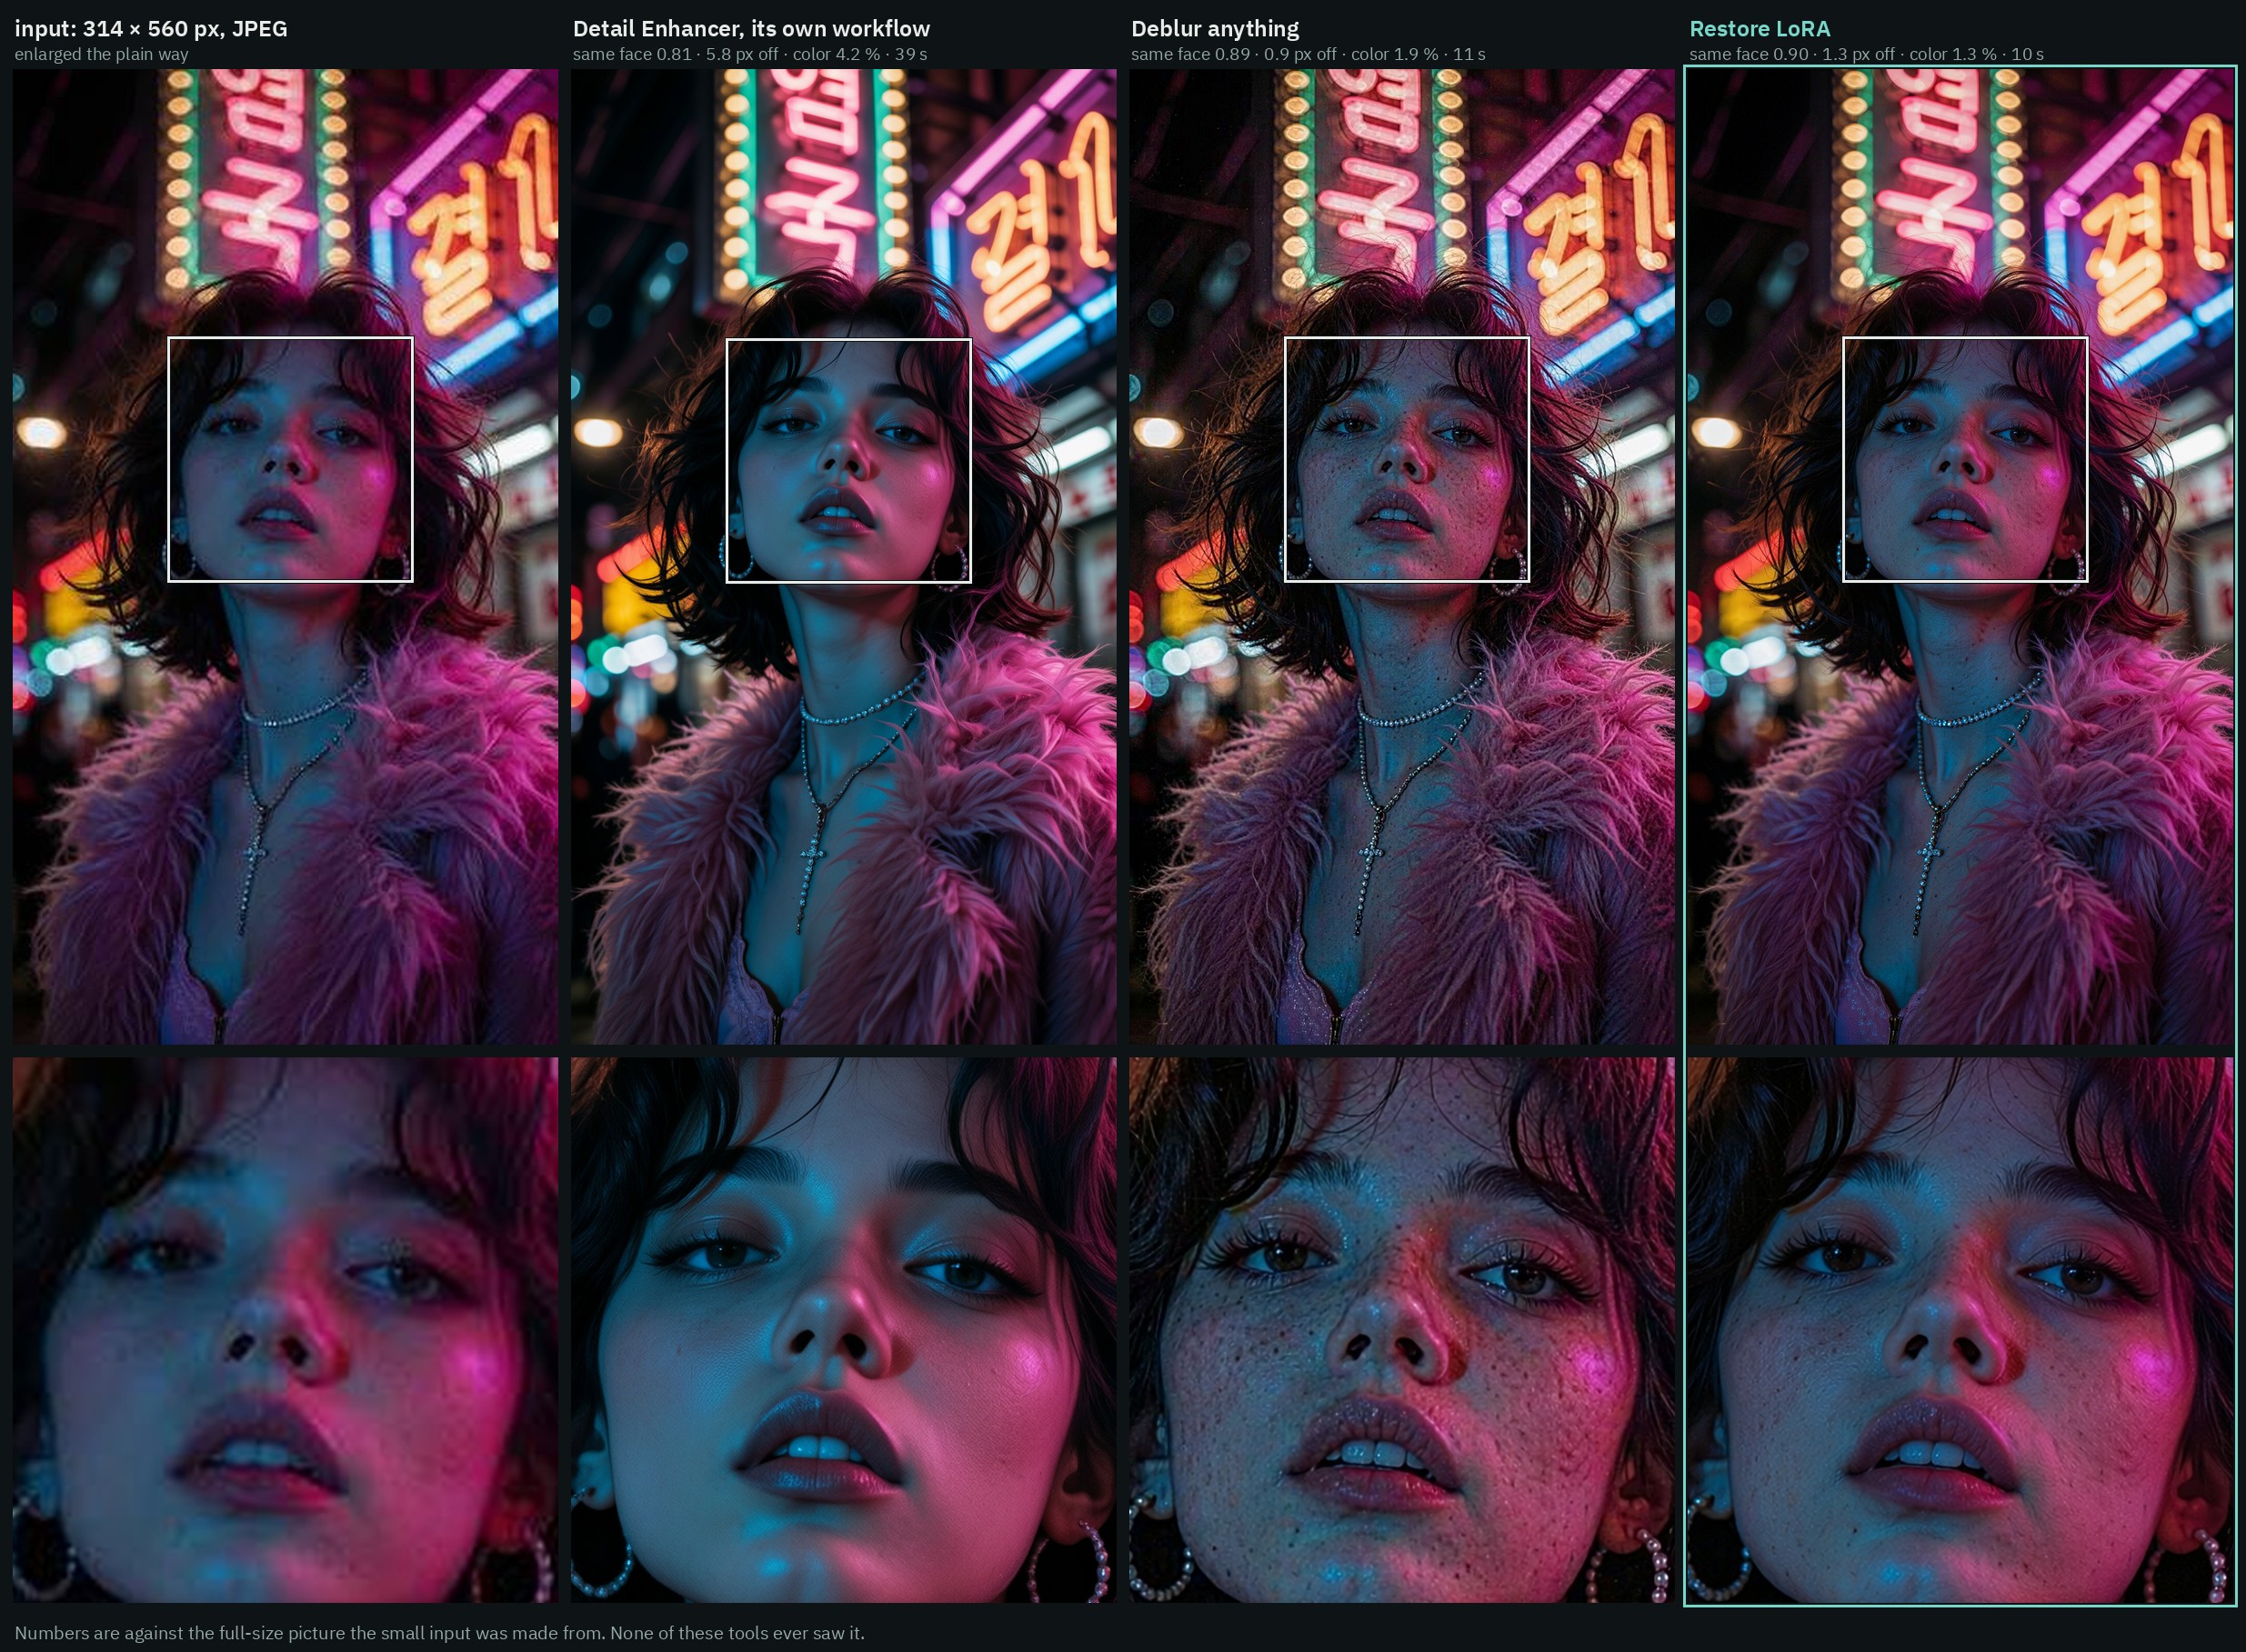
SSIM 기준으로 이 LoRA는 29장 모두에서 Detail Enhancer보다 원본에 더 가깝게 남았고(Detail Enhancer가 자체 워크플로를 실행한 경우에는 29장 중 28장), Deblur anything보다도, 그리고 29장 중 18장에서 SeedVR2보다 더 가깝게 남았습니다. 얼굴을 유지한 정도는 Detail Enhancer보다 28장 중 28장에서, Deblur anything보다 28장 중 26장에서, SeedVR2보다 28장 중 27장에서 더 좋았습니다. SeedVR2는 11초에 비해 약 3초로 가장 빠르며 색상도 가장 잘 유지합니다.
어떤 파일을 사용해야 할까요
| 파일 | 설명 |
|---|---|
qwen-image-2.1-restore.safetensors | 1,500 스텝, 여기서 시작하세요. 작성자의 테스트 이미지에서 둘 중 원본에 가장 가깝습니다. 피부가 조금 부드럽게 나옵니다. |
qwen-image-2.1-restore-1250.safetensors | 1,250 스텝. 노이즈가 많은 휴대폰 사진에서 더 세밀한 디테일을 살리고 피부 질감을 더 많이 유지합니다. 원본과의 유사도는 조금 떨어집니다. |
둘 다 rank 32이며 ComfyUI 키 이름 규칙을 사용하므로, 변환 없이 Comfy-Org Qwen-Image 2.1 가중치에 로드됩니다.
ComfyUI에서 실행하기
이 어댑터는 model-only LoRA이므로 복원 자체에는 커스텀 노드가 필요하지 않습니다. .safetensors 파일을 ComfyUI/models/loras/에 넣고 모델 로더 이후에 LoraLoaderModelOnly 노드를 strength 1.0으로 추가한 다음, Qwen-Image 2.1에 작은 사진을 image 1로, 위의 요청을 프롬프트로 전달하세요. 카드 자체 설정은 Viggle Turbo 사용 시 CFG 1에서 8 스텝, 사용하지 않으면 25 스텝입니다.
바로 사용할 수 있는 워크플로가 저장소의 workflows/ 폴더에 포함되어 있으며, 작성자의 ComfyUI-AusBoss 노드로 제작되었습니다. 이는 그의 이전 릴리스에서도 사용한 것과 동일한 팩입니다.
한계
- 이것은 복원이 아니라 다시 그리는 방식입니다. 미세한 디테일은 맞춤을 위해 만들어내는 것이며, 일반 Qwen-Image 2.1이 그런 부분을 더 많이 그려냅니다.
- 원본 그림 위에 머무는 것이 핵심이므로, 새로운 콘텐츠가 필요한 결과는 얻을 수 없습니다.
- 흐릿한 입력을 최대 강도로 넣으면 부드럽게 돌아옵니다. 0.5로 낮추거나 타일 단위로 확대하세요.
- 수치는 작성자 본인의 테스트 이미지와, 비교 세트 일부에서 Turbo 없이 25 steps로 진행한 결과에서 나온 것입니다.
- 2 MP를 넘는 결과물의 경우 작성자는 Civitai에 있는 자신의 타일드 업스케일 워크플로와 함께 사용합니다.
사용 가능 여부
- LoRA 가중치: ausboss/Qwen-Image-2.1-Restore-LoRA
- 이미지별 수치: comparison_numbers.csv
- 베이스 모델 재패키징: Comfy-Org/Qwen-Image-2.1
- 작성자의 노드 팩: ausboss/ComfyUI-AusBoss
댓글
GitHub로 로그인하고 토론에 참여하세요.