Qwen-Image 2.1 의상 교체 LoRA: ComfyUI로 원본 프레임 그대로 옷만 바꾸기
Qwen-Image 2.1용 커뮤니티 LoRA로 원본 사진 위에서 의상 교체를 실행합니다. 구도와 얼굴, 배경은 그대로 유지되고 옷만 바뀌며, ComfyUI 워크플로와 함께 사용할 수 있습니다.
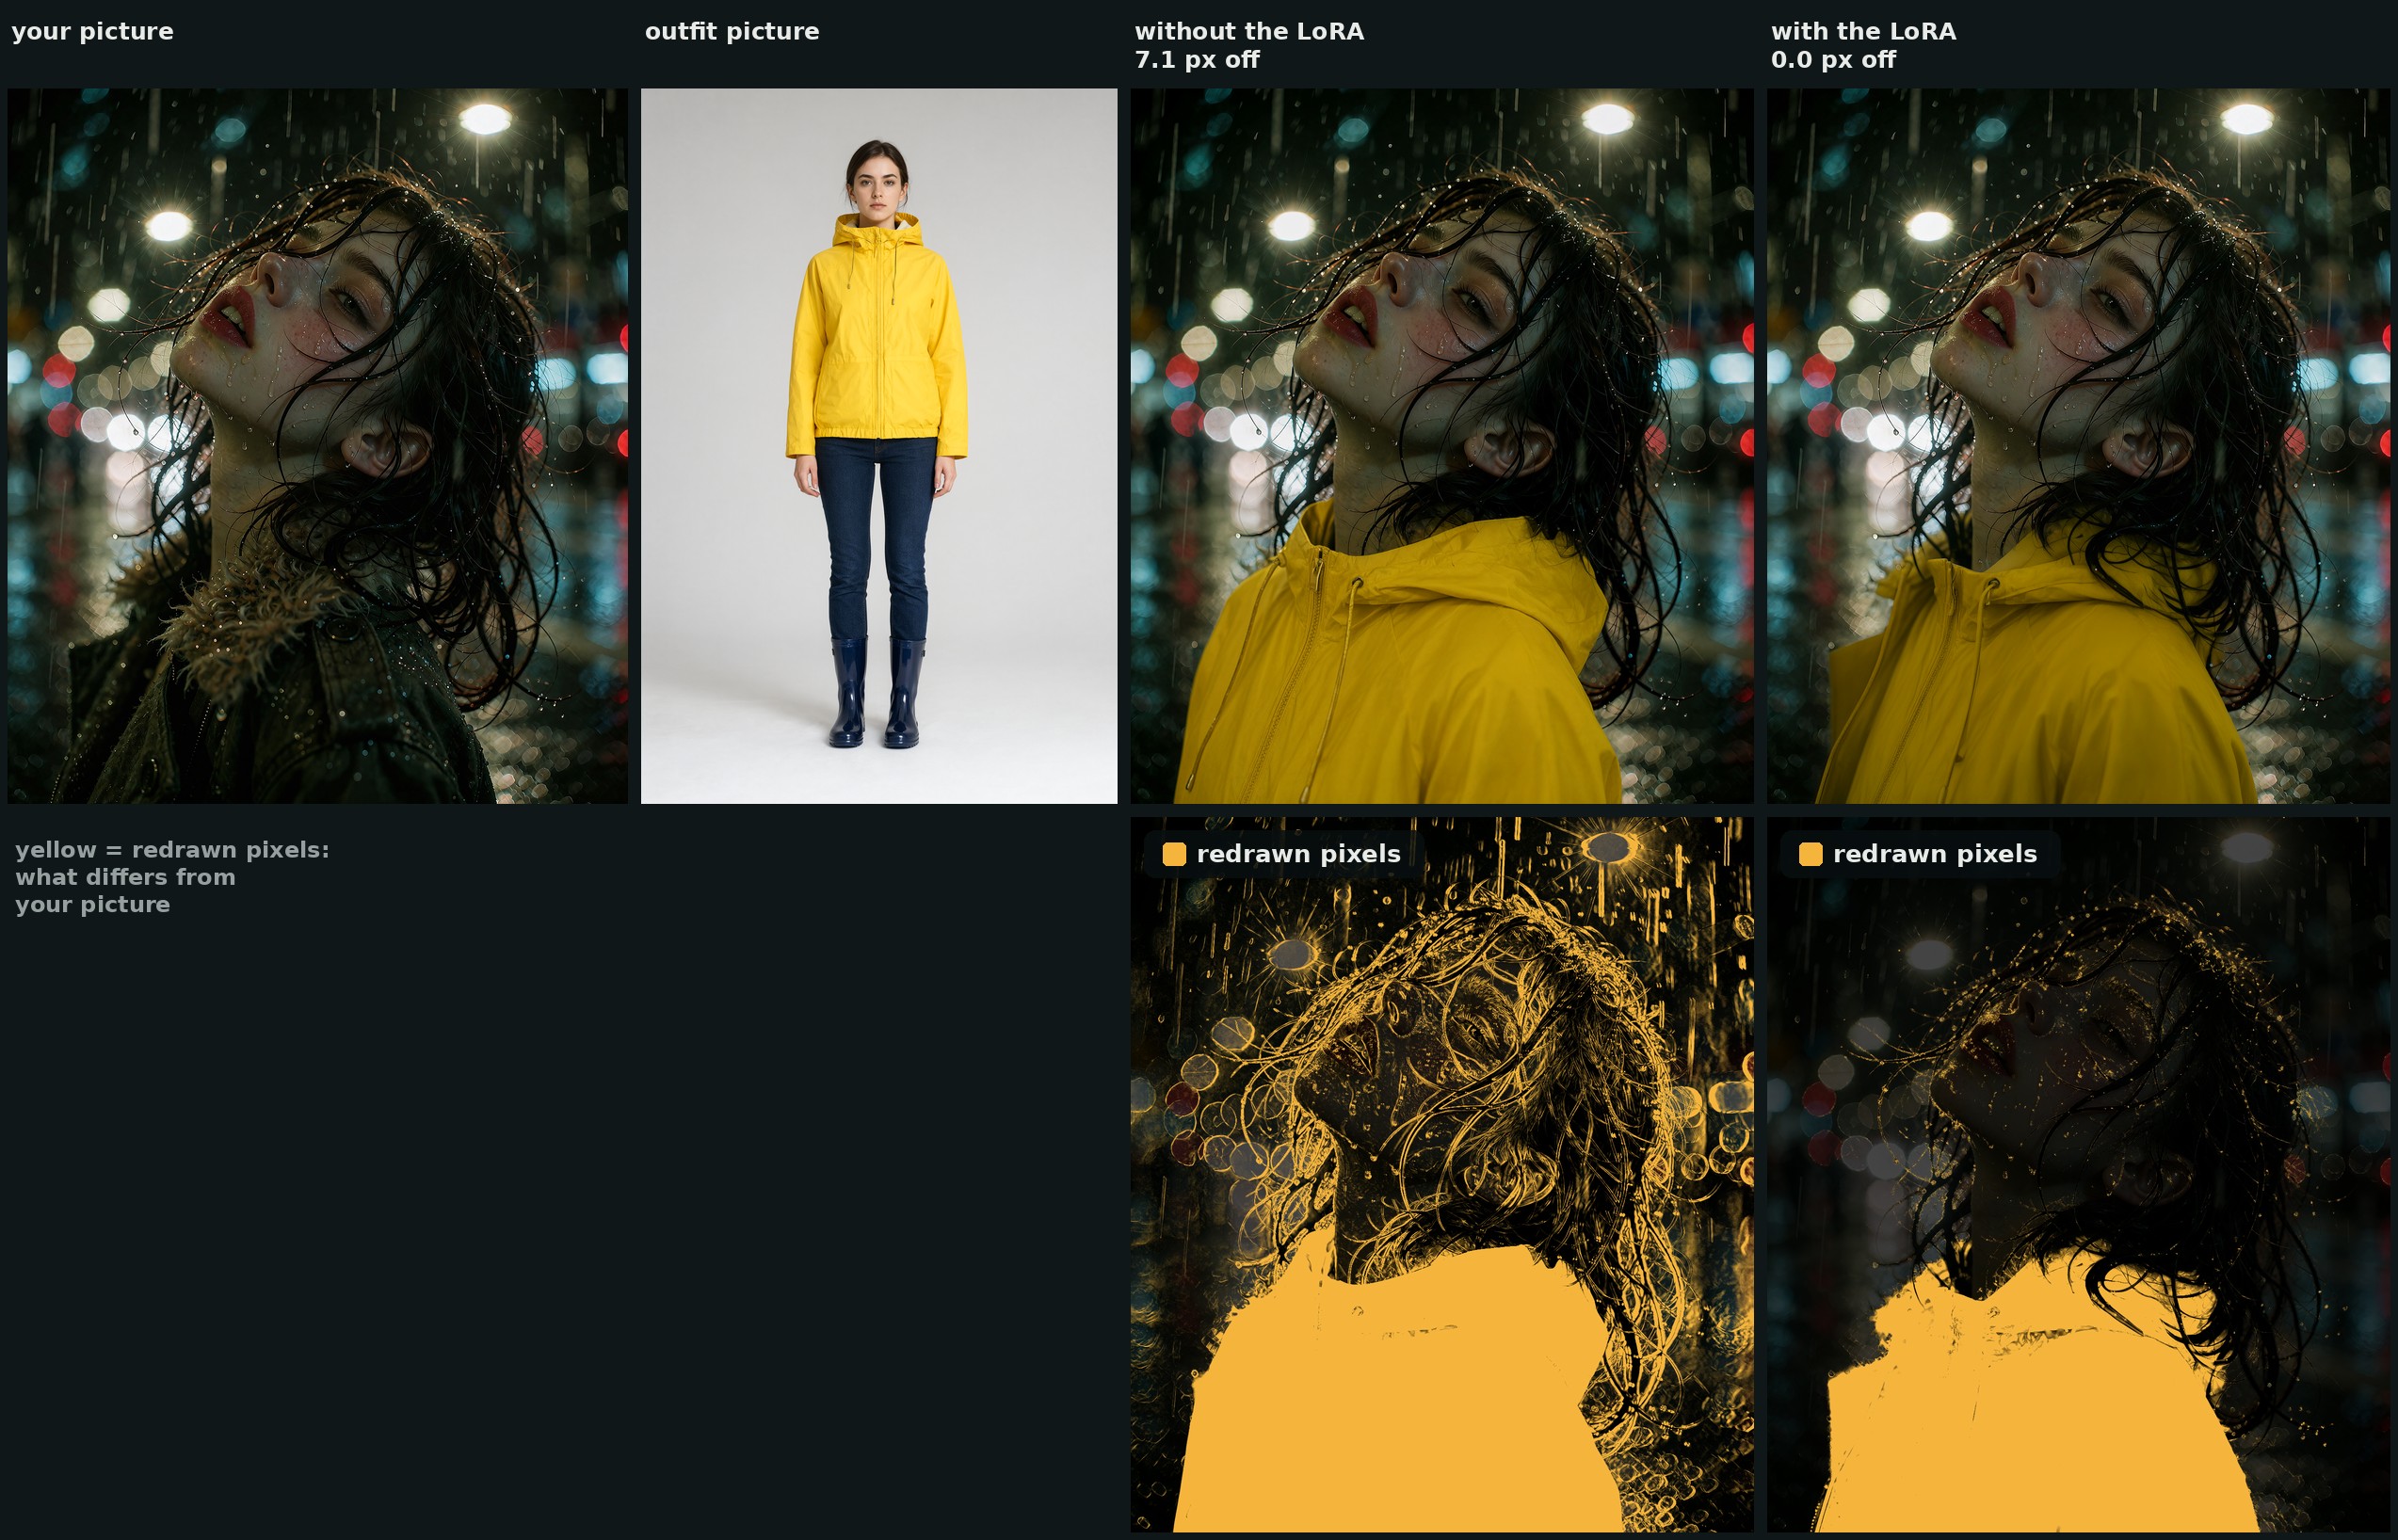
위쪽 행: 동일한 요청과 시드로 수행한 교체. 아래쪽 행: 노란색으로 표시된 다시 그려진 픽셀. LoRA가 없으면 얼굴과 창, 벽이 밝게 표시되고, LoRA가 있으면 코트만 달라집니다. 이 인물과 이 코트는 모두 학습 세트에 없습니다.
기본 Qwen-Image 2.1이 잘못 처리하는 부분
Qwen-Image 2.1의 모든 편집은 매번 새로 생성하는 방식이므로, 의상 교체는 옷뿐 아니라 그 이상을 재구성합니다. 작성자는 기본 Qwen-Image 2.1로 47번의 교체를 실행하고 각각을 눈으로 판정했습니다. 24개는 사용할 수 있었고 나머지 23개는 무언가 잘못되어 있었습니다. 대개 문제는 의상 자체가 아니었습니다.
- 카메라가 의상 전체를 프레임에 맞추기 위해 뒤로 물러났습니다.
- 다리가 없던 샷에 바지가 밀려 들어왔습니다.
- 새 옷을 입히기 위해 신체나 포즈가 다시 그려졌습니다.
- 또는 모든 것이 그냥 몇 픽셀씩 이동했습니다.
인물 사진을 기준으로 측정했을 때, 기본 결과물은 가장 나쁜 모서리에서 약 3.4px 어긋났습니다. 작은 차이지만, 결과물을 원본 위에 다시 겹칠 수 없다는 뜻입니다. 얼굴은 조금 더 부드럽게 다시 그려지고, 요청하지 않은 곳까지 배경이 다시 칠해집니다. 컨트롤넷으로 포즈를 고정하면 장면은 그대로 유지됐지만, 다섯 번 중 한 번꼴로 의상이 제대로 입혀지지 않아 결국 사용하지 않았습니다.
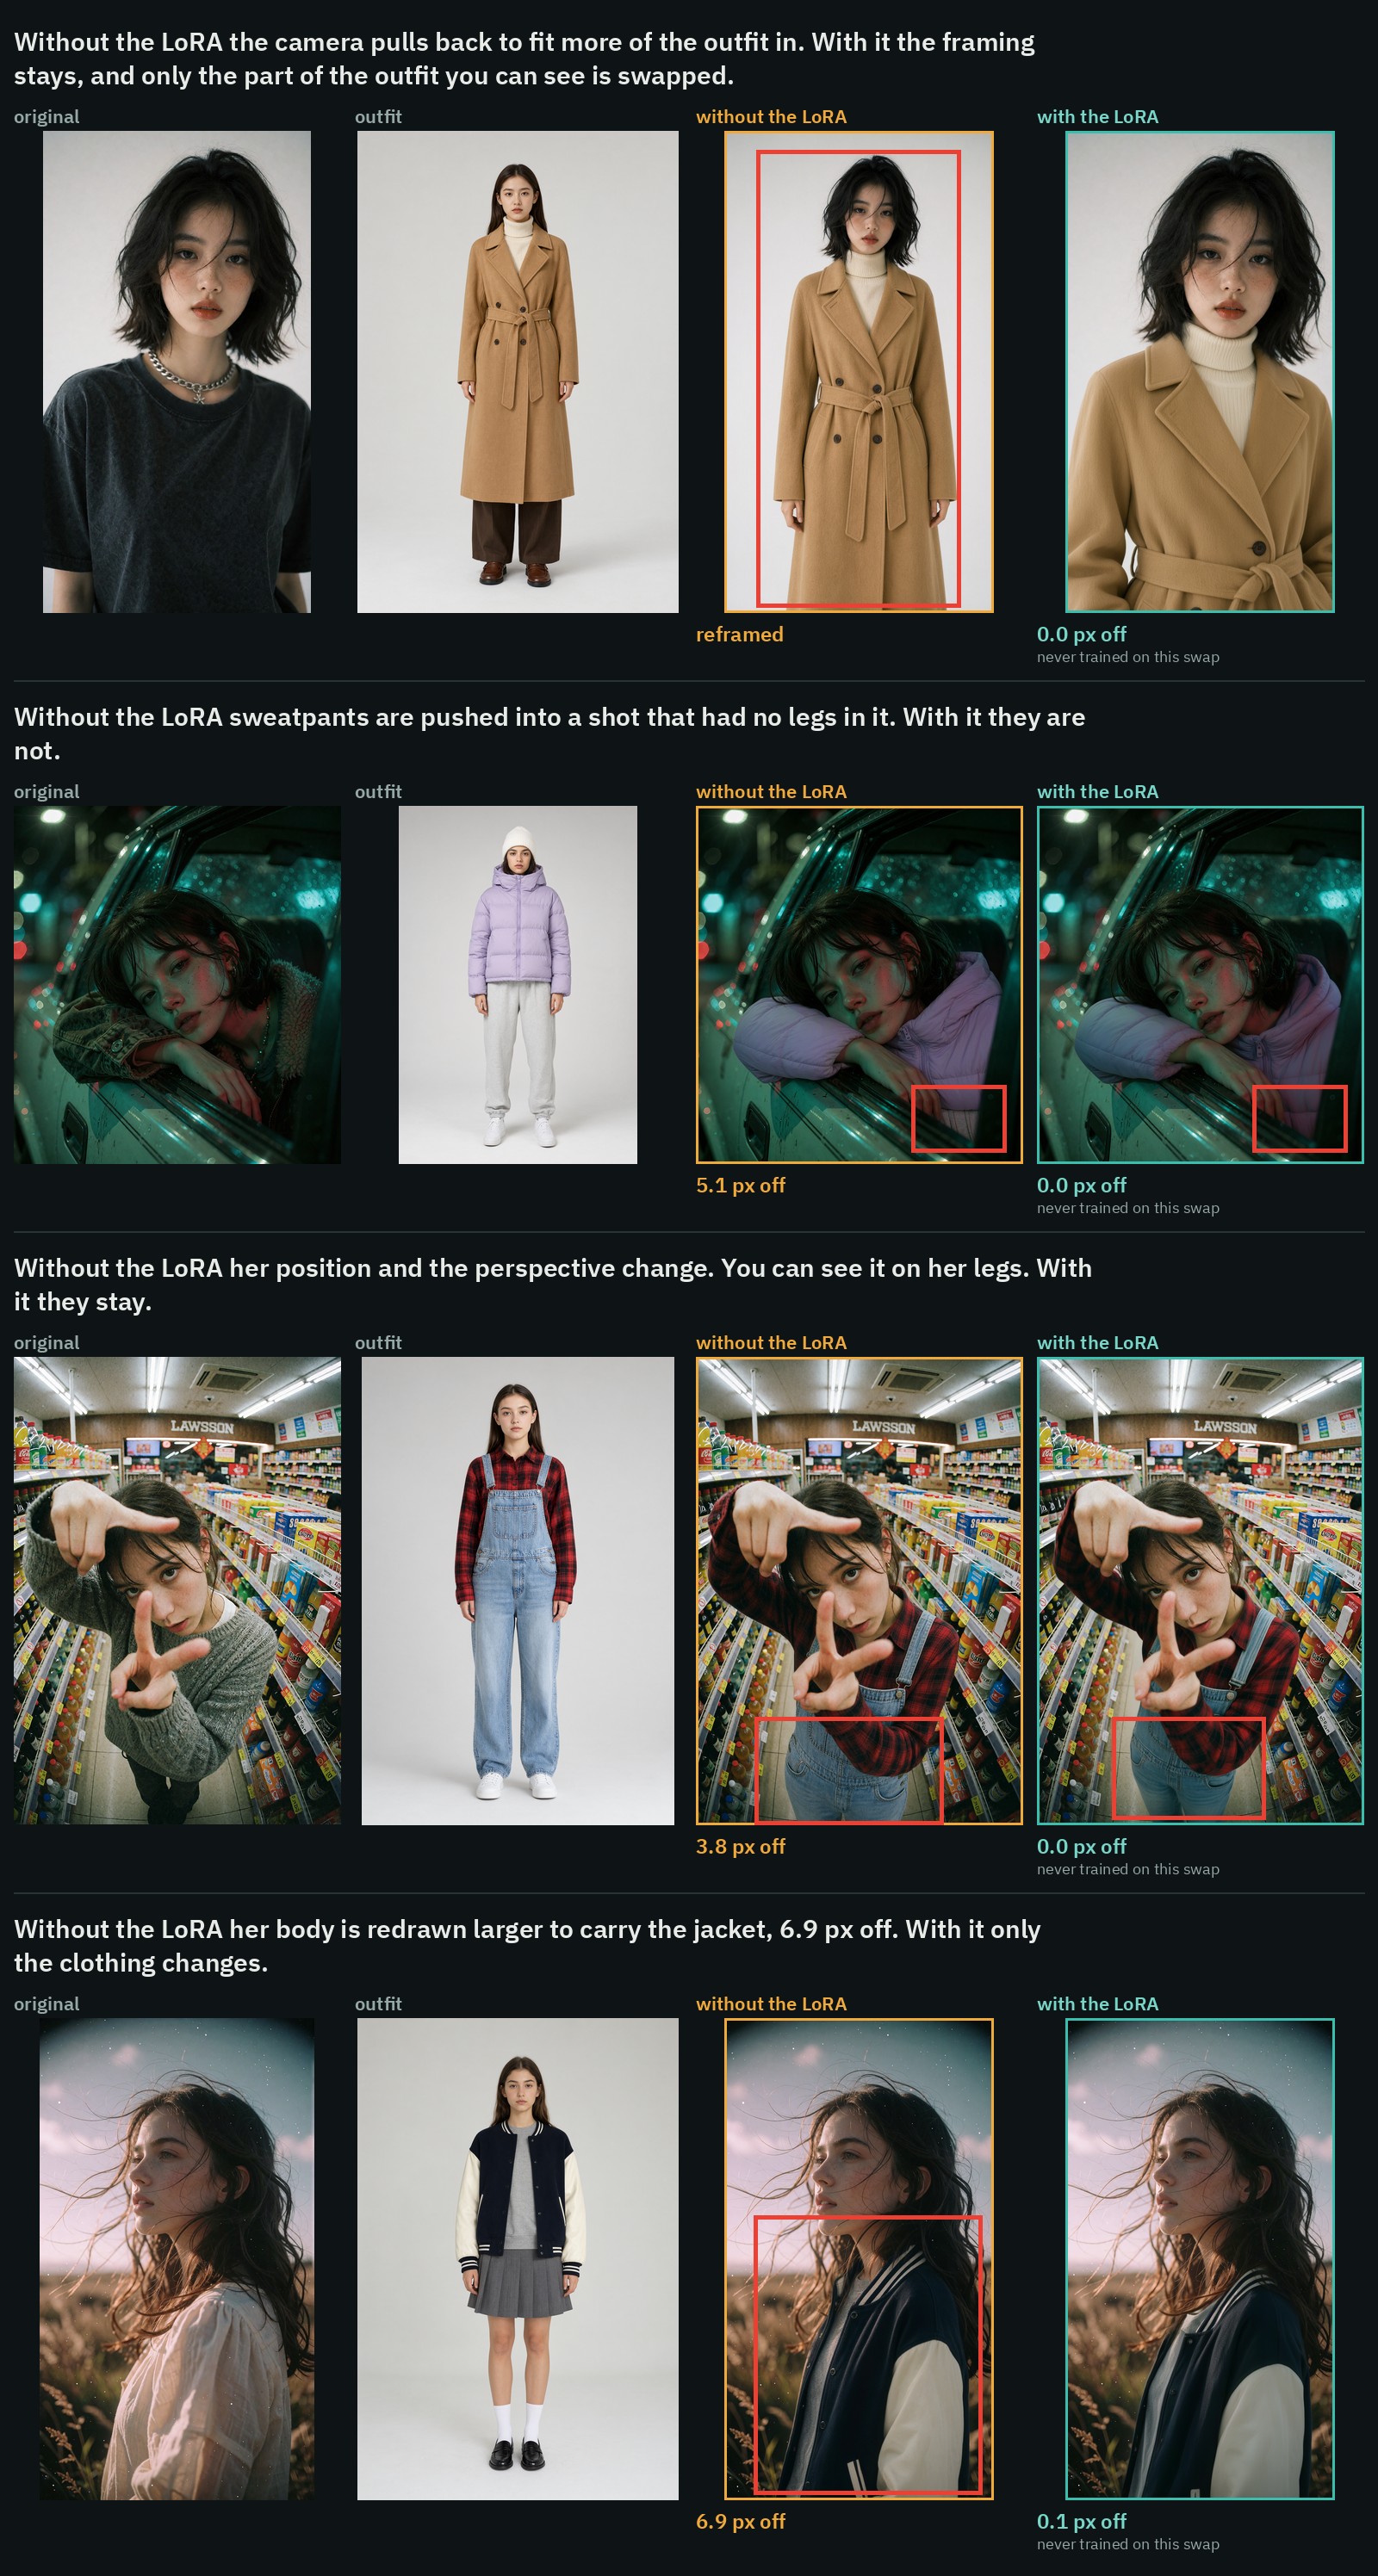
47번의 교체 중 네 가지로, LoRA 없이 그리고 LoRA와 함께 동일한 워크플로와 시드로 실행한 결과입니다. 어느 것도 학습 세트에 포함되지 않았습니다.
측정된 유지력
LoRA가 한 번도 학습하지 않은 16개의 스왑을 모두 동일한 워크플로에서 약 2 MP, 같은 시드, 25 스텝, CFG 1, euler / simple, 어댑터 1.0으로 실행했습니다. "Off"는 결과의 가장 나쁜 모서리가 인물 사진에서 얼마나 떨어져 있는지를 나타냅니다. 얼굴과 배경 수치는 결과를 인물 사진에 정렬한 뒤 측정한 값이므로, 드리프트가 아니라 다시 그려진 부분을 반영합니다:
| 16개 홀드아웃 스왑 | LoRA 없음 | 스텝 1,000 | 스텝 1,250 | 스텝 1,500 |
|---|---|---|---|---|
| 가장 나쁜 모서리 이탈, 중앙값 | 3.6 px | 0.1 px | 0.1 px | 0.1 px |
| 가장 나쁜 모서리 이탈, 16개 중 최악 | 7.0 px | 0.2 px | 0.2 px | 0.2 px |
| 눈에 띄게 변한 얼굴 픽셀 | 14.1 % | 1.7 % | 1.8 % | 2.0 % |
| 얼굴, 인물 사진 대비 PSNR | 29.8 dB | 37.8 dB | 37.7 dB | 37.1 dB |
| 눈에 띄게 변한 배경 픽셀 | 10.8 % | 0.9 % | 0.9 % | 1.2 % |
| 배경, PSNR | 27.6 dB | 40.5 dB | 40.4 dB | 40.0 dB |
강도도 중요합니다. 스텝 500에서 0.5는 1.8 px 이탈한 반면 1.0은 0.1 px였으므로, 강도를 절반으로 줄이면 드리프트도 약 절반으로 돌아옵니다. 500 이후의 모든 스텝은 수치상 사진을 동일하게 유지합니다. 이들 사이의 차이는 새 의상이 덮지 않는 옷에서 나타납니다.
참고로, 위의 일반적인 네 가지 비교는 LoRA 없이 4.8, 7.1, 5.2, 7.2 px 이탈했고, LoRA를 사용하면 0.1, 0.0, 0.0, 0.1 px 이탈했습니다.
오래된 옷은 어떻게 되는가
일반 Qwen-Image 2.1은 새 의상이 덮지 않는 부분을 그대로 남겨 두는 경우가 많습니다. 비키니 아래의 부츠, 스커트 아래의 찢어진 청바지처럼요. 이 부분의 대부분은 step이 결정합니다. 두 가지 교체, 각각 시드 3개, 일반 요청:
| 새 스커트 아래 청바지 제거 | 비키니와 함께 부츠 제거 | |
|---|---|---|
| LoRA 없음 | 3회 중 0회 | 3회 중 0회 |
| step 500 | 3회 중 0회 | 3회 중 0회 |
| step 1,000 | 3회 중 2회 | 3회 중 2회 |
| step 1,250 | 3회 중 0회 | 3회 중 0회 |
요청 끝에 문장을 하나 붙이면 step 1,000에서 결과가 더 잘 제어됩니다. Replace everything they wear.는 수영복 아래의 타이츠를 벗겼고(신발은 그대로 남았습니다), Keep their own shoes and legwear.는 일반 요청에서는 제거되었던 부츠를 유지했습니다. 두 문장 모두 어떤 학습 캡션에도 없었으므로, 이는 LoRA가 나머지 화면을 고정하는 동안 베이스 모델이 반응한 결과입니다. step 1,250과 1,500에서는 같은 문장이 거의 또는 전혀 차이를 만들지 못했는데, 이것이 이번 릴리스가 step 1,000을 가리키는 또 다른 이유입니다. 제공되는 워크플로는 기본적으로 Replace everything they wear.를 추가하며, 이 문장은 편집할 수 있는 상자에 들어 있습니다.
어떤 파일을 사용할까요
| 파일 | 참고 |
|---|---|
qwen-image-2.1-outfit-swap.safetensors | 1,000 step, 여기서 시작하세요. 기존 의상을 남기지 않고 가장 자주 완전히 지워 주는 버전입니다. |
qwen-image-2.1-outfit-swap-1250.safetensors | 1,250 step. 인물을 그대로 잘 유지합니다. 착용 중인 항목(부츠, 스커트 아래 청바지)을 더 많이 보존합니다. |
qwen-image-2.1-outfit-swap-1500.safetensors | 1,500 step, 학습의 끝 지점. 유지력은 같지만 얼굴과 배경의 변화가 조금 더 큽니다. |
세 파일 모두 rank 32이며 ComfyUI 키 이름 규칙을 사용하므로, 별도의 변환 없이 Comfy-Org Qwen-Image 2.1 가중치에 바로 로드됩니다.
ComfyUI에서 실행하기
이 어댑터는 모델 전용 LoRA이므로 스왑 자체에는 커스텀 노드가 필요하지 않습니다. 요청을 한 문장으로 작성하고, 사람을 이미지 1로, 의상을 이미지 2로 지정하세요:
Dress the person in image 1 in the <outfit, in a few words> shown in image 2. Keep their face, hair, hands, pose and the background exactly the same.두 이미지를 사용하는 모든 Qwen-Image 2.1 편집 그래프에 추가하려면:
.safetensors파일을ComfyUI/models/loras/에 넣고, 모델 로더 바로 뒤에 LoraLoaderModelOnly 노드를 강도 1.0으로 추가합니다.- Text Encode Qwen Image 2.1 노드를 사용하여 사람을
image_1, 의상을image_2,resolution을 0으로 설정하고, 요청을 프롬프트로 입력합니다. - 인코더의
latent출력에서 KSampler로 25 스텝, CFG 1,euler/simple, denoise 1로 샘플링합니다. - VAE Decode로 디코딩한 다음 Split Image with Alpha를 사용합니다. Qwen-Image 2.1 VAE가 RGBA로 디코딩하기 때문입니다.
바로 사용할 수 있는 워크플로가 저장소에 함께 제공됩니다. 이 워크플로는 작성자의 ComfyUI-AusBoss 노드(2.5.1 이상)로 제작되었으며 ComfyUI 0.38 이상이 필요합니다. 카드에는 동등한 기능의 노드라면 무엇이든 괜찮다고 적혀 있습니다.
모델 카드에서 가져온, 동일한 스왑을 LoRA 없이와 LoRA와 함께 나란히 실행한 결과입니다.
추가 비교
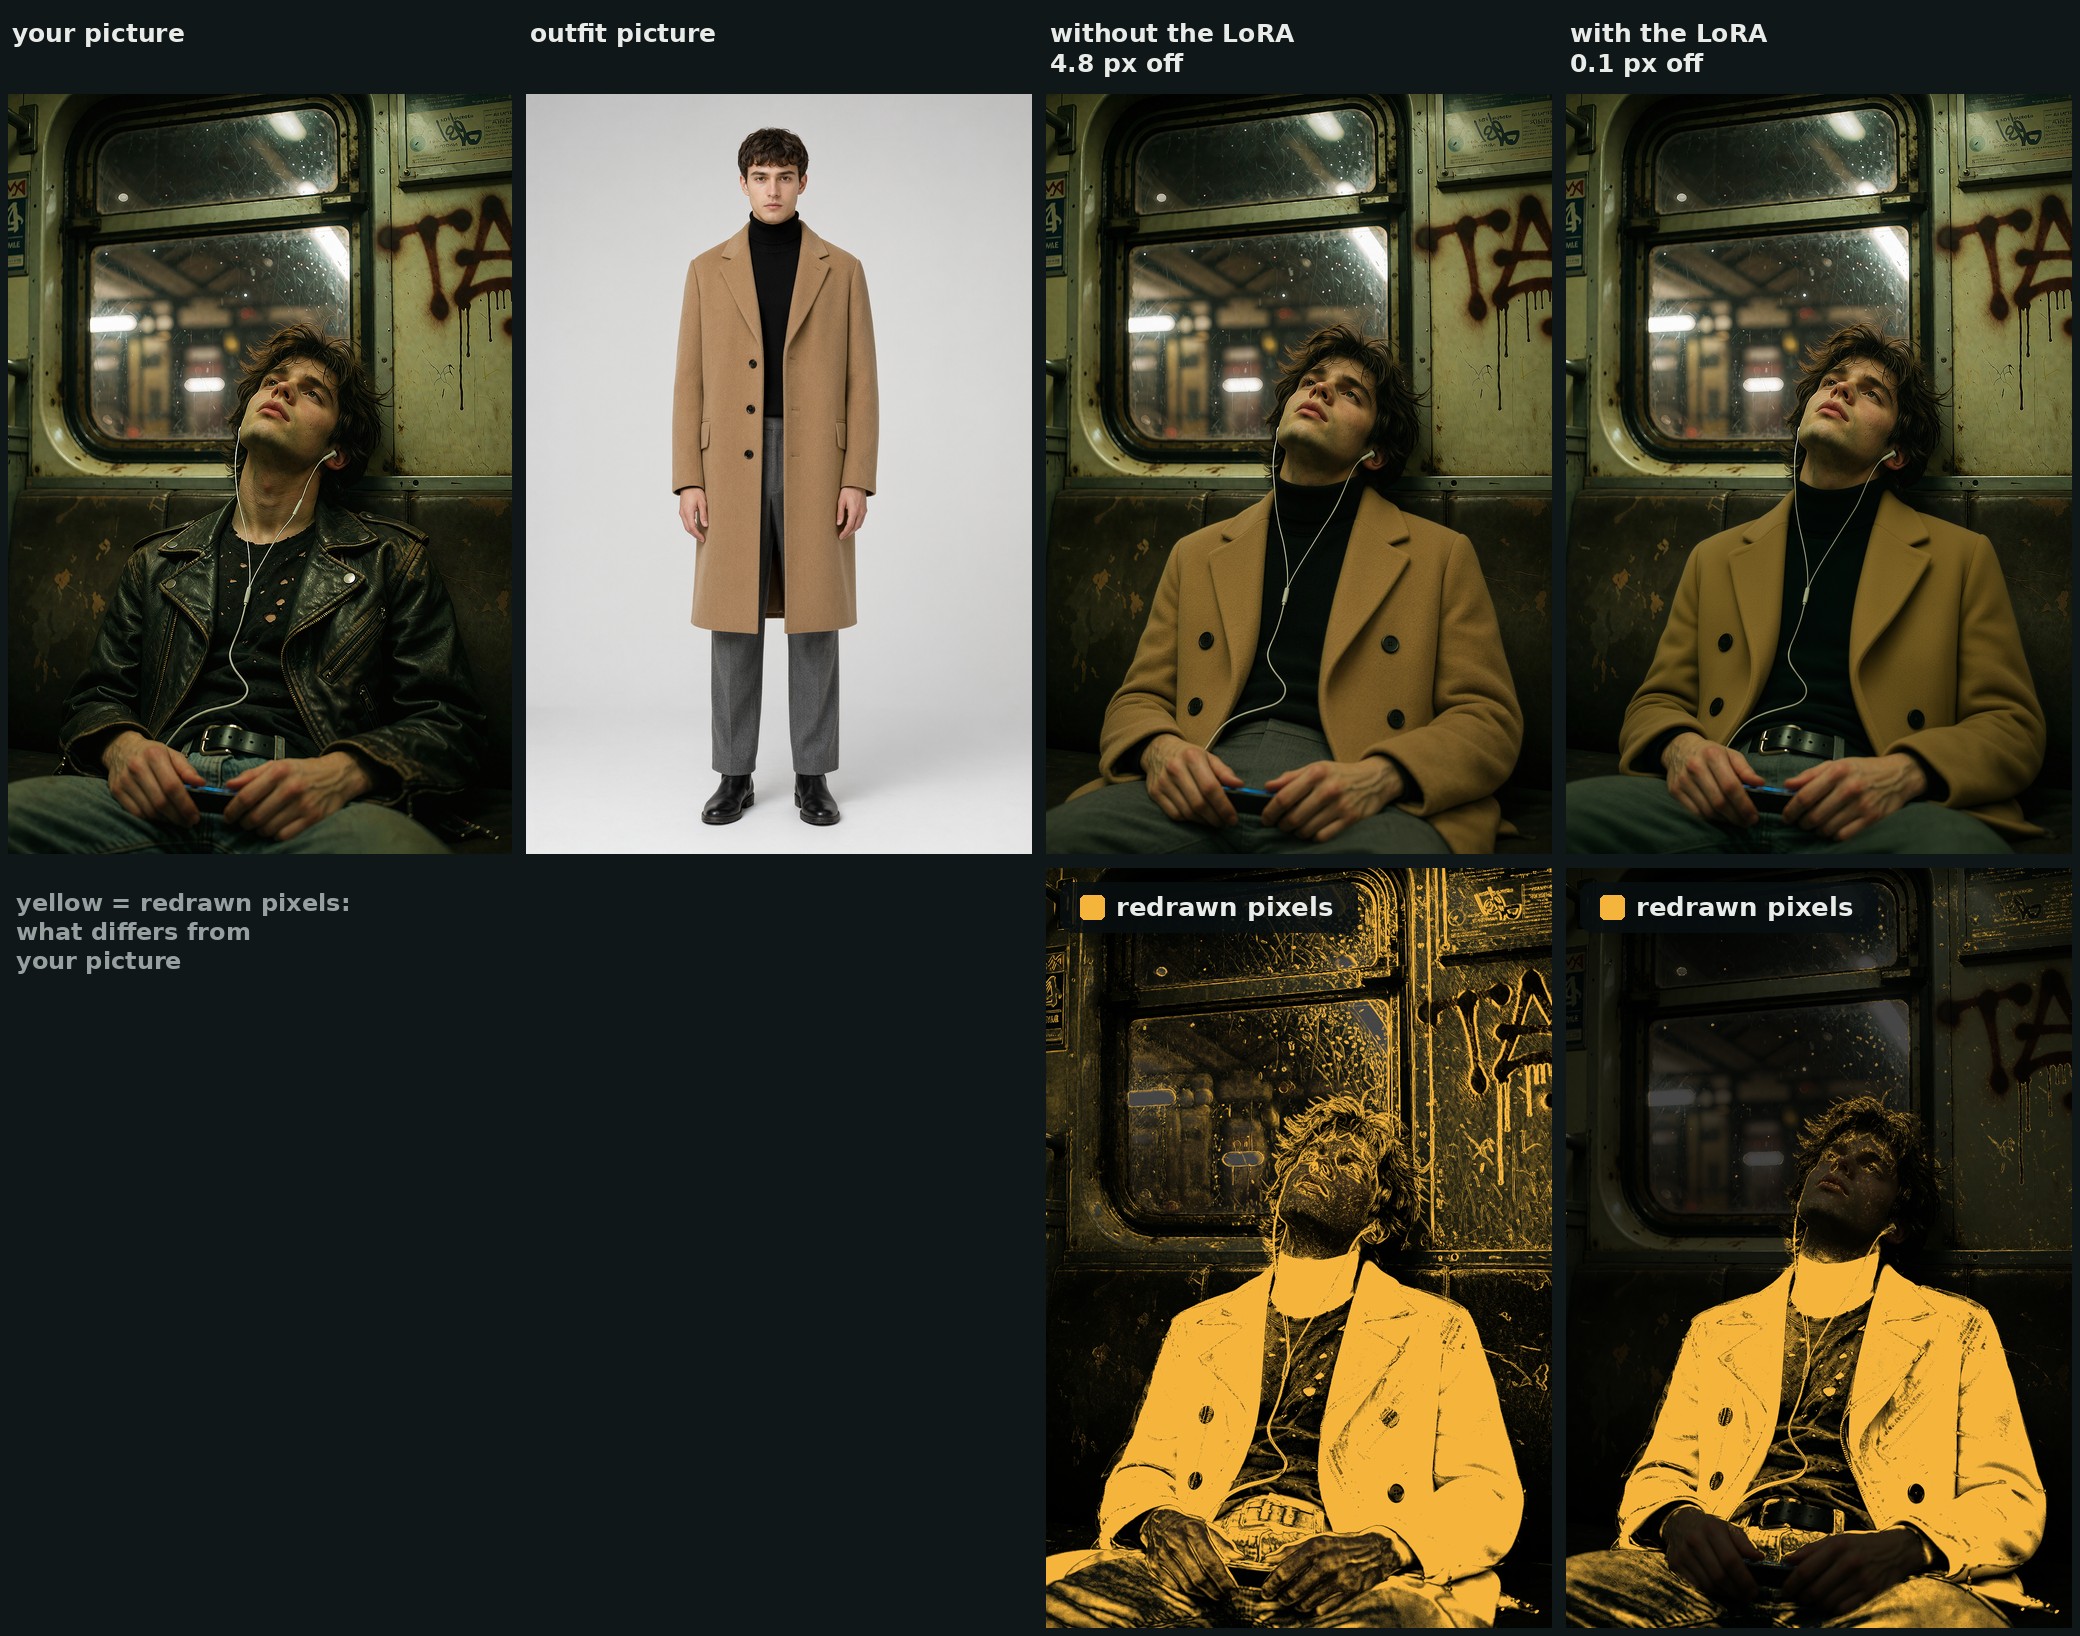
빗속에서의 동일한 비교. 이 인물은 학습 세트에 포함되어 있지 않다.
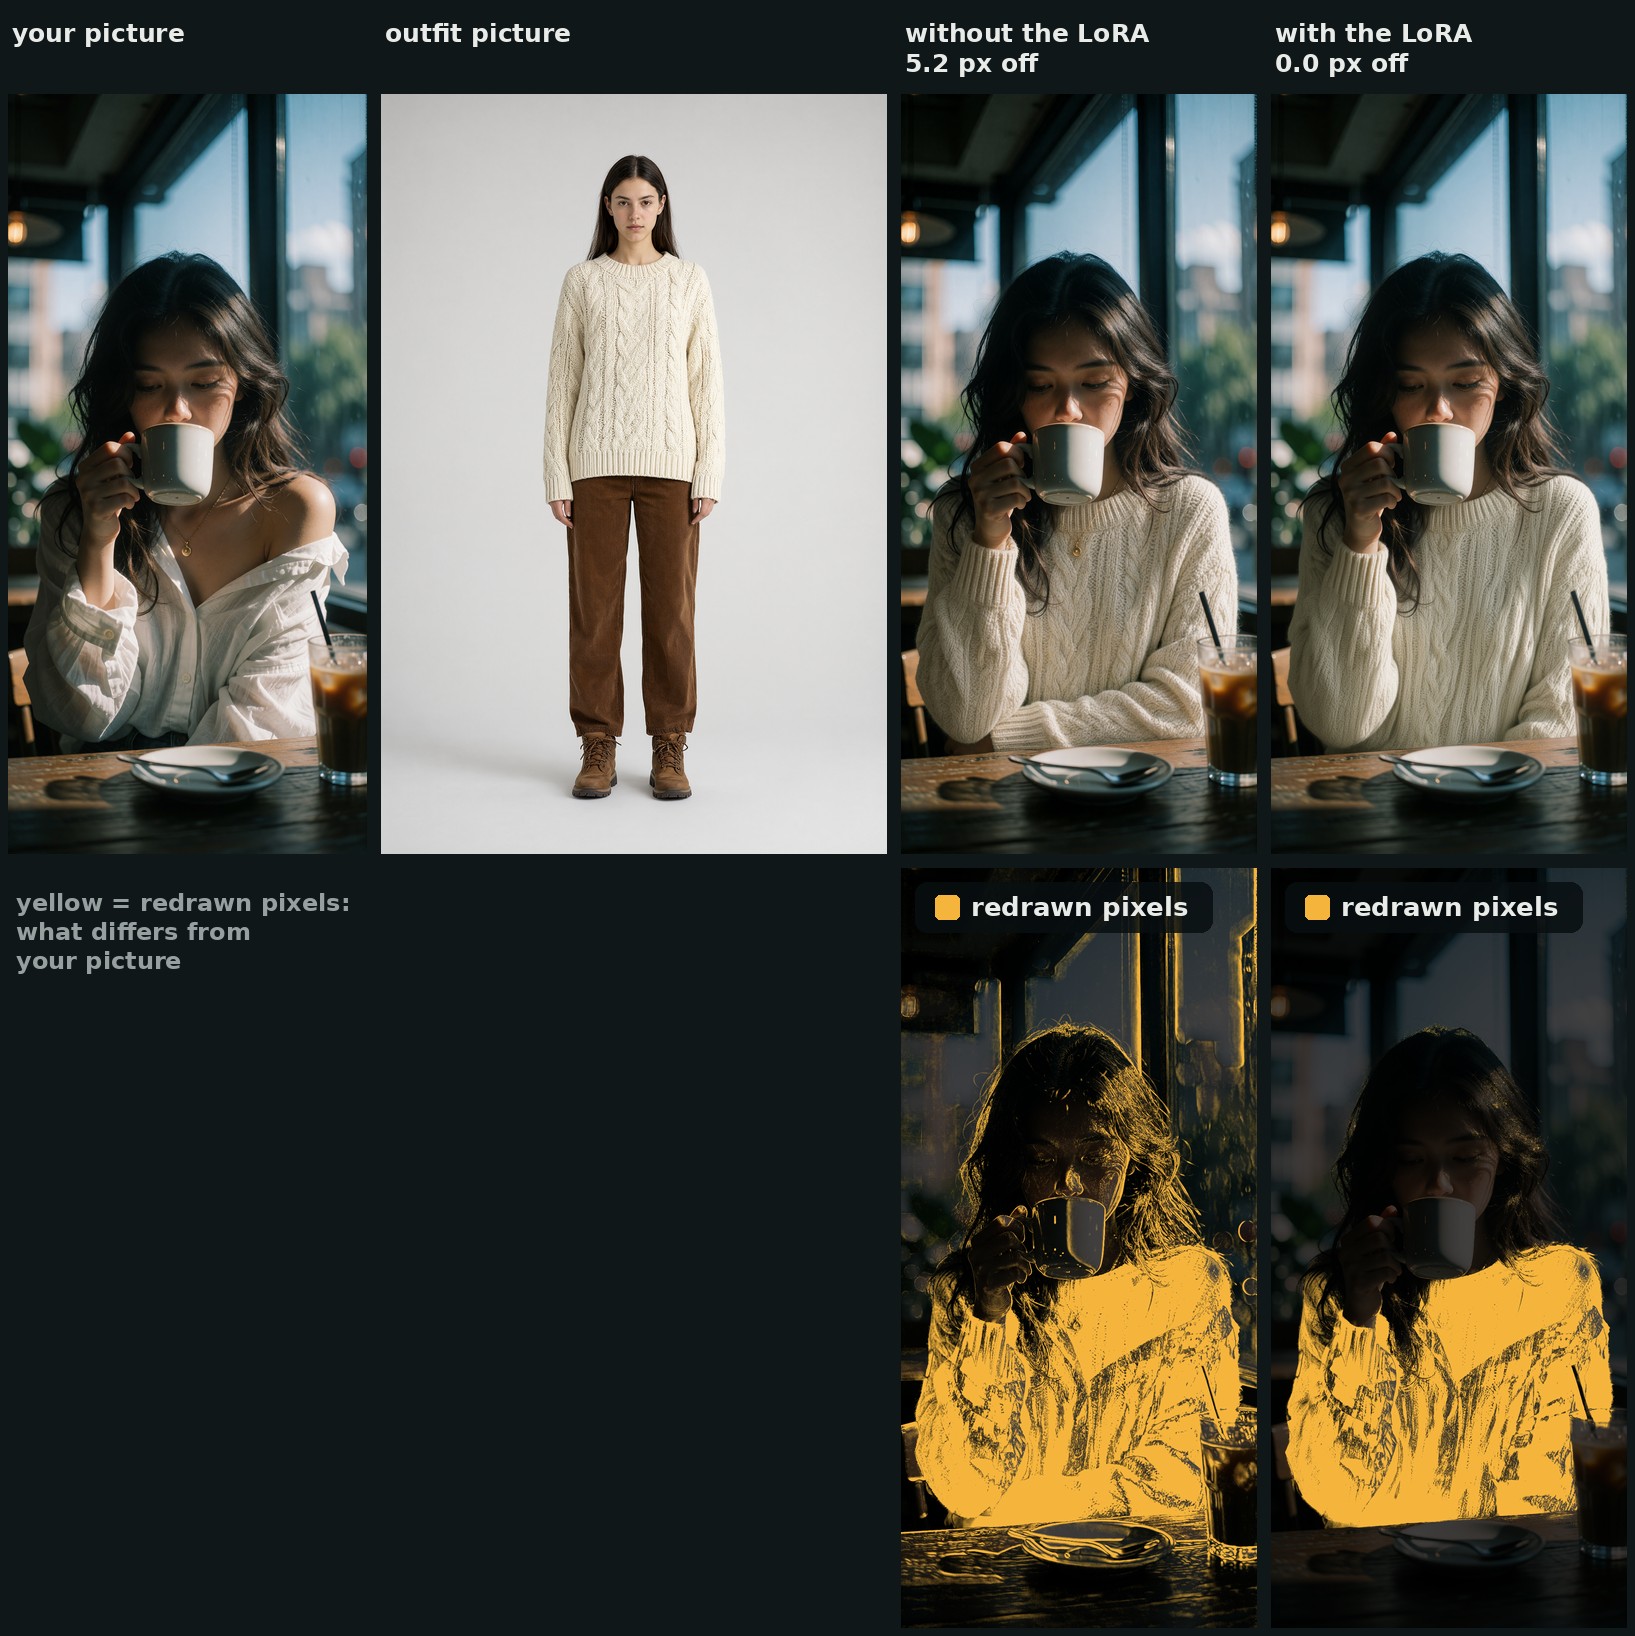
이 인물 역시 학습 세트에 포함되어 있지 않다.
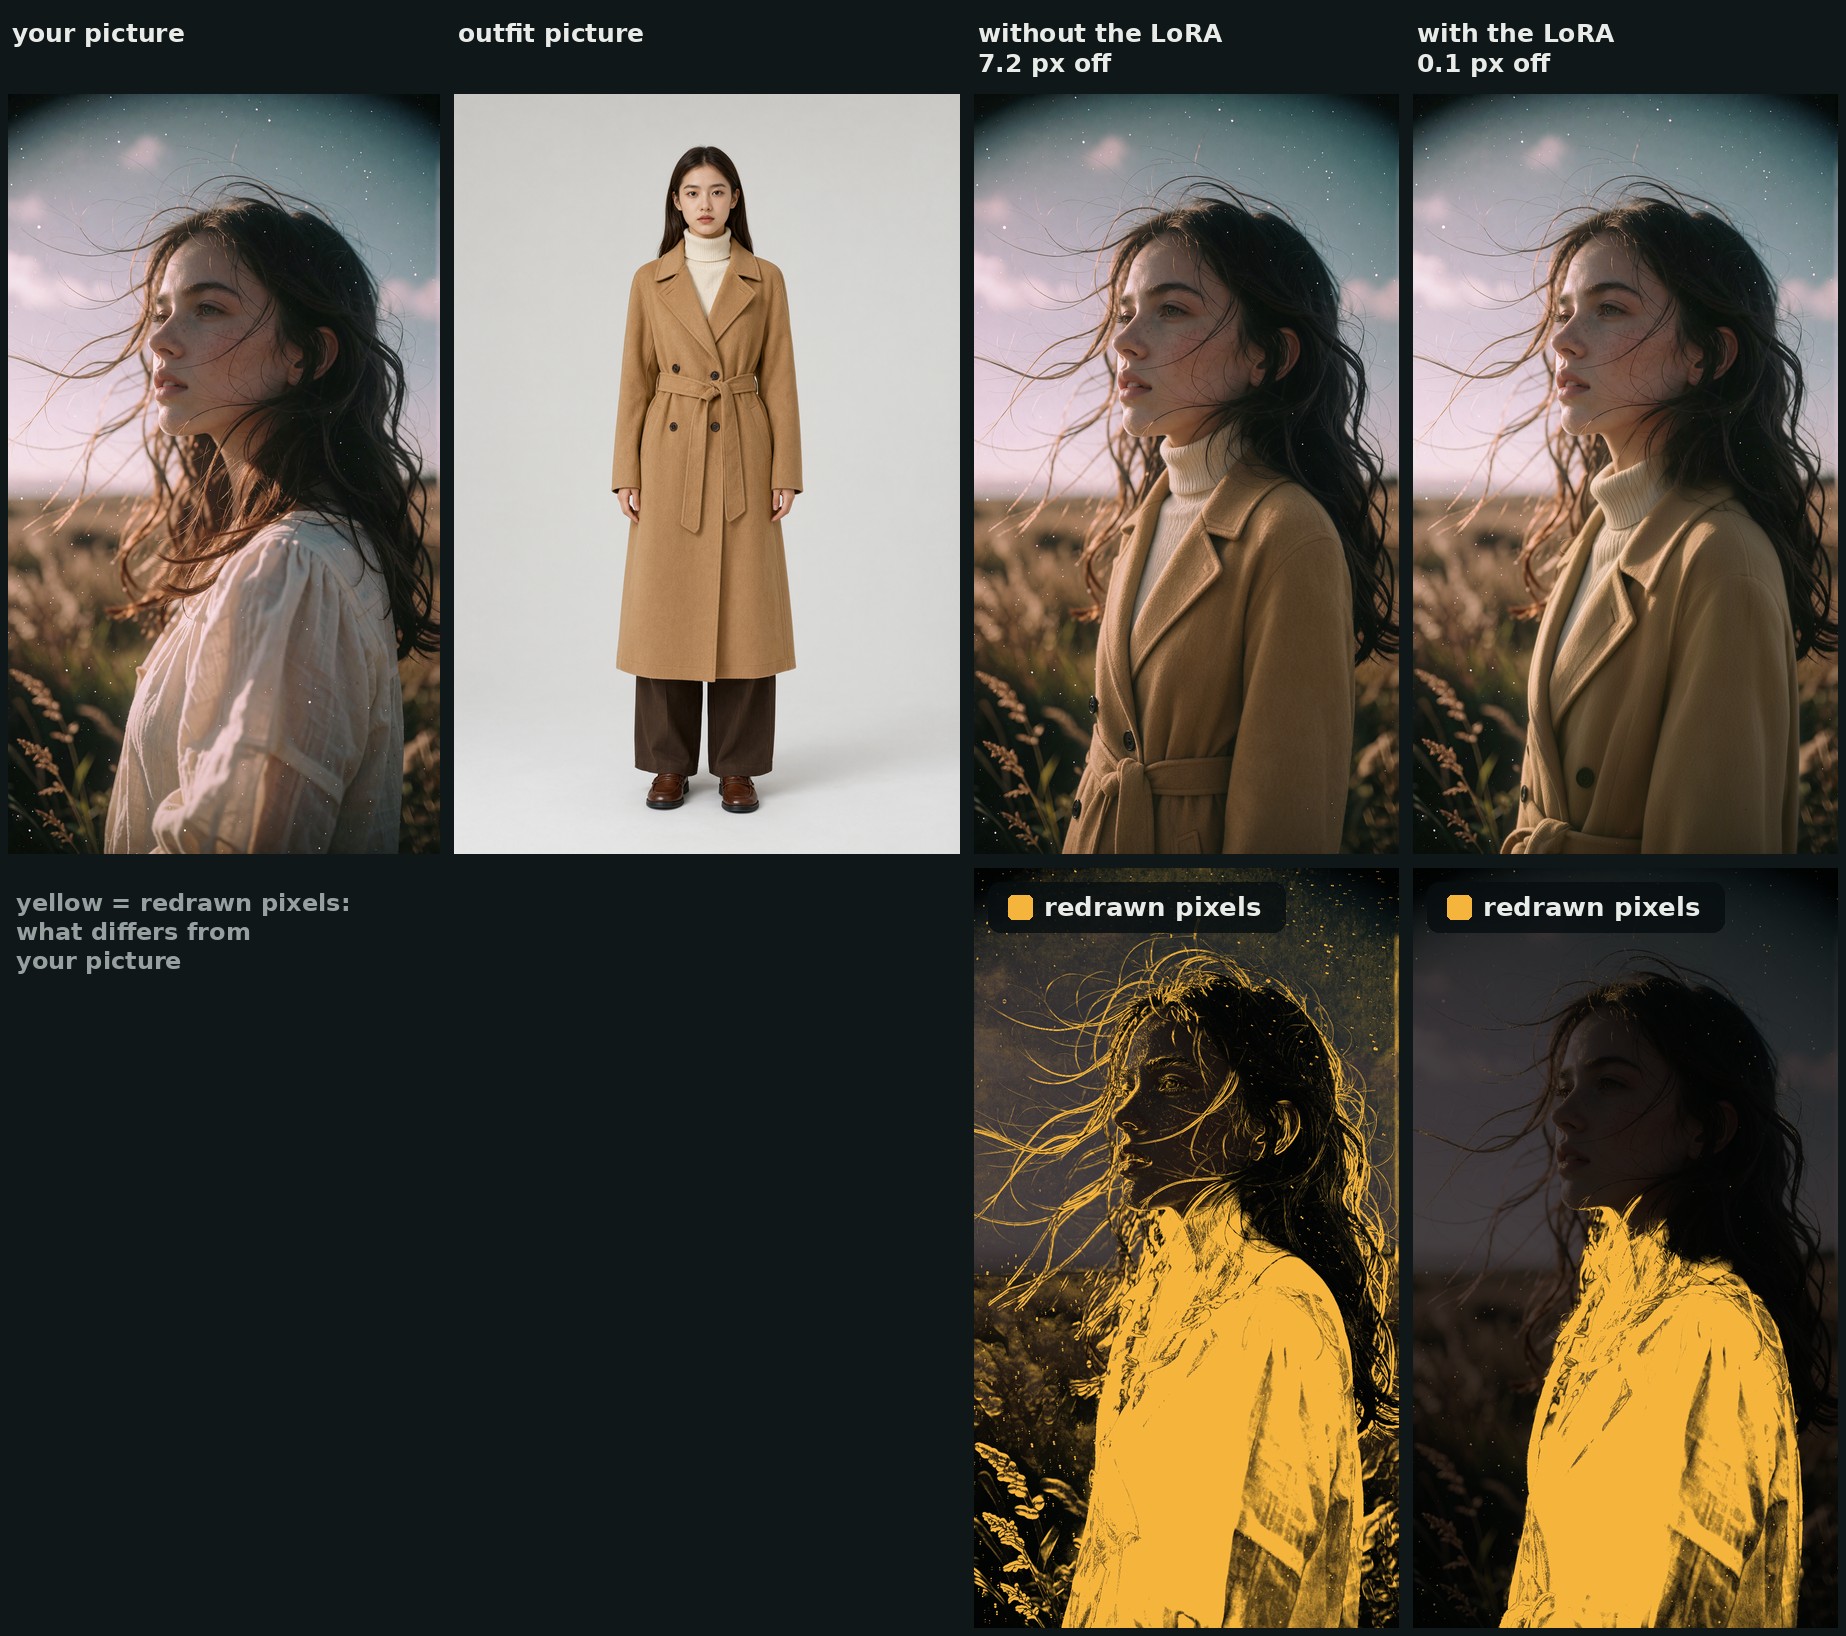
LoRA는 이 인물의 스왑 이미지로 학습된 적이 없으며, 이 코트도 학습 세트에 포함되어 있지 않다.
학습 방법
데이터셋은 실제 Qwen-Image 2.1 스왑 결과물로 구성한 뒤, 모든 학습 대상이 소스의 프레임 위에 놓이도록 보정합니다. 가공하지 않은 스왑은 좋은 대상이 아닙니다. 여기에는 밀림(drift), 흐려진 얼굴, 다시 그려진 배경이 따라붙고, 이를 그대로 학습한 LoRA는 이런 요소들을 배웁니다. 각 결과물은 정수 픽셀 단위로 인물 사진 위에 되돌려 놓고(리샘플링은 하지 않습니다), 스왑에서 가져오는 것은 옷뿐입니다. 얼굴, 머리카락, 손, 배경은 다시 인물 사진 자체의 픽셀입니다. 66개의 학습 대상 중 40개는 작성자의 이전 Consistency LoRA를 켠 상태로 만든 스왑에서, 26개는 일반 스왑에서 나왔습니다. 22개는 정수 픽셀 이동이 필요했고, 중앙값 대상은 픽셀의 27 %를 스왑에서 가져옵니다.
- 66개의 학습 페어: 45명의 서로 다른 인물과 31벌의 서로 다른 의상(착용샷, 플랫 레이, 제품샷)을 사용했으며, 네 쌍은 테스트용으로 남겨 두었습니다.
- 학습: Comfy-Org INT8 ConvRot 베이스에
arch: qwen_image_2로 ostris/ai-toolkit을 사용했고, 예시당 두 개의 참조(인물과 의상), dropout 0의 캡션. Rank 32, alpha 32, AdamW8bit, lr 1e-4, batch 1,shifttimesteps, 250 스텝마다 체크포인트를 저장하며 총 1,500 스텝, RTX PRO 6000 한 대에서 스텝당 약 4.5초.
트레이너의 세부 동작 하나 때문에 한 번의 실행이 낭비되었고, 이 내용은 저장소의 RESEARCH.md에 정리되어 있습니다. AI-Toolkit은 학습 대상을 크기 버킷에 맞출 때 스케일링과 크롭을 적용하지만, 참조 이미지는 통째로 불러와 32 px 그리드에 끼워 넣습니다. 이미지의 형태가 버킷 형태와 다르면 둘은 더 이상 정렬되지 않습니다. resolution: 1024에서 1056 x 1888 페어는 768 x 1344에 놓이므로, 대상은 높이의 2 %를 잃는 반면 참조는 대신 2 % 압축됩니다. 첫 실행은 손실 기준으로는 잘 학습되었고, 모든 이미지를 1.6 % 더 길게 만드는 LoRA를 만들어 냈습니다. 수정은 트레이너가 아니라 내보내기 쪽에 있습니다. 정렬되어야 하는 대상과 참조를 같은 크기로 기록하고, 양쪽 모두 32의 배수로 맞춥니다.
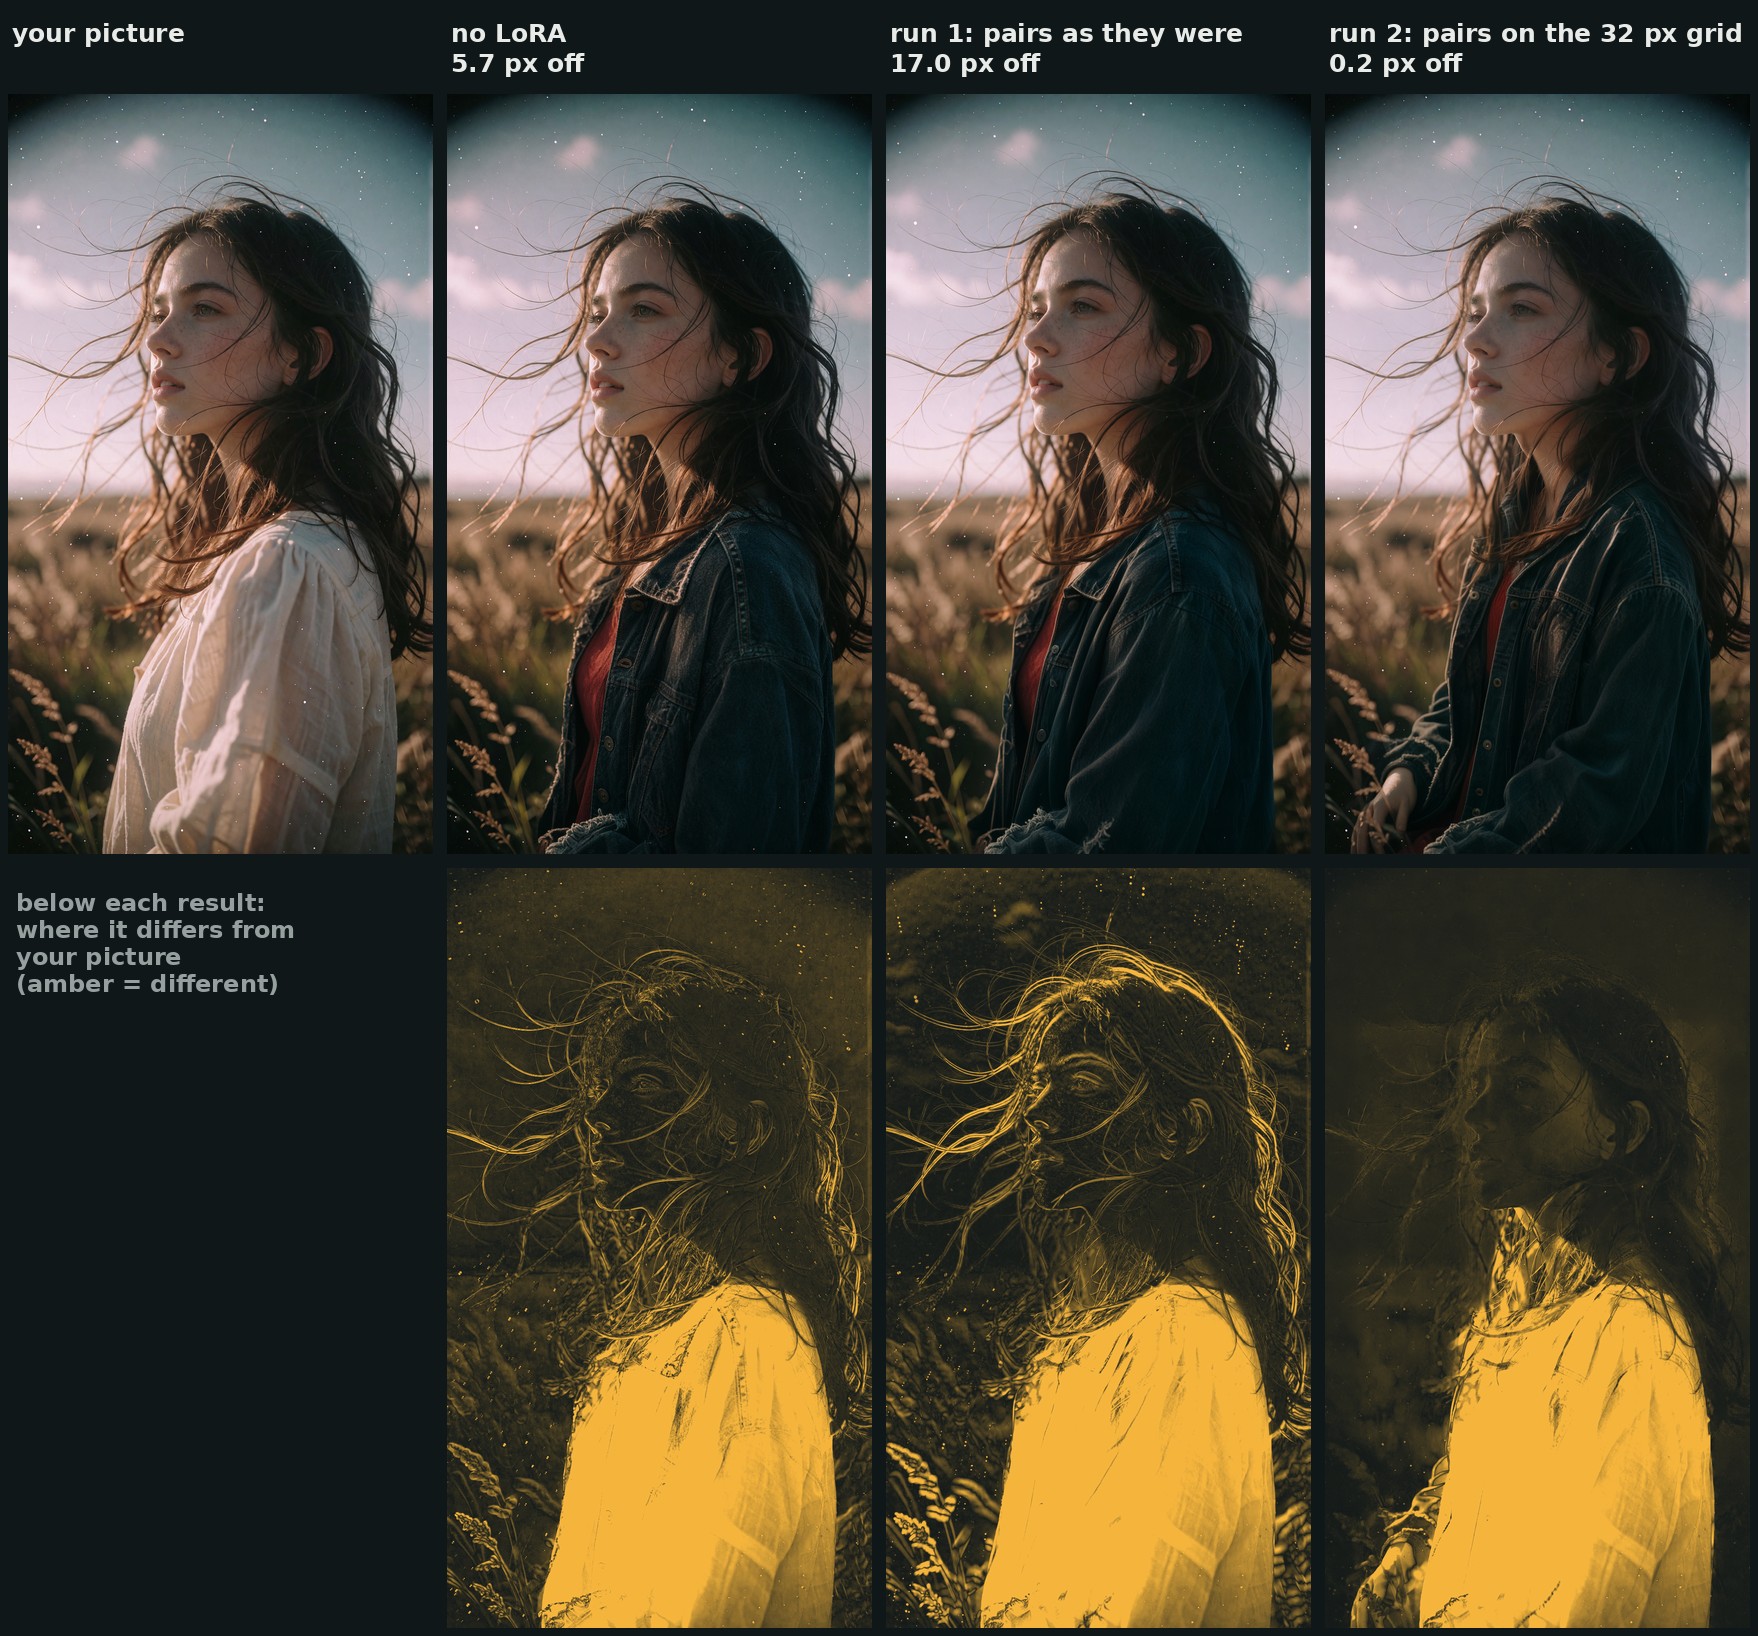
250 스텝에서 첫 실행은 이미지를 늘리기 때문에 모든 것이 원본과 달라집니다. 수정된 실행은 그렇지 않습니다.
한계
이 카드는 이 릴리스의 적용 범위가 얼마나 좁은지 솔직하게 밝힙니다:
- 일반 Qwen-Image 2.1보다 의상을 더 잘 그리는 것은 아닙니다. 단추, 벨트, 패턴은 어차피 나올 대로 나오며, 일반 Qwen이 오히려 의상을 더 많이 복사할 때도 있습니다. 위의 첫 번째 비교에서 일반 Qwen은 바지까지 바꿔버린 반면, LoRA는 기존 청바지와 벨트를 유지했습니다.
- 있던 것을 그대로 붙잡으므로 포즈도 함께 유지합니다. 다른 포즈가 필요한 의상은 그 포즈를 얻지 못합니다.
- 신발이 고집스러운 부분입니다.
Replace everything they wear.를 사용해도 세 번의 테스트 교체 중 한 번은 신발 한 켤레가 그대로 남았습니다. - 초기 checkpoint(step 250)는 한 번의 교체에서 사진에 없던 손을 그려냈습니다. step 500~1,500에서는 열여섯 개 중 어느 것에서도 그런 일이 없었지만, 검사한 것은 열여섯 개뿐입니다.
- 약 1 MP에서 학습하고 약 2 MP에서 테스트했으며, 25 steps, CFG 1입니다.
- 8 steps에서 Viggle Turbo LoRA를 사용해도 여전히 그림을 유지합니다(다섯 번의 교체에서 0.05~0.24 px). 다만 단색 원단은 약간 거칠게 나올 수 있습니다.
- 옷 위에 걸치는 요소들은 옛 의상과 함께 사라지거나 새 의상 위에 어색하게 놓일 수 있습니다. 재킷 위의 이어폰 케이블은 제거되었고, 새 재킷 위의 핸드백 스트랩은 어색해 보였습니다.
사용 가능 여부
- LoRA 가중치: ausboss/Qwen-Image-2.1-Outfit-Swap-Consistency-LoRA
- 베이스 모델 리팩: Comfy-Org/Qwen-Image-2.1
- 작성자의 노드 팩: ausboss/ComfyUI-AusBoss
댓글
GitHub로 로그인하고 토론에 참여하세요.