Qwen-Image 2.1 Multiple-Angles LoRA: 어떤 시점에서든 객체를 다시 촬영하기
Akhaliq의 Multiple-Angles LoRA는 Qwen-Image 2.1에 카메라 제어 기능을 부여합니다. 사진을 입력하고 72가지 방위각과 고도 프레이밍 중 하나를 고르면 ComfyUI에서 피사체를 다시 촬영할 수 있습니다.
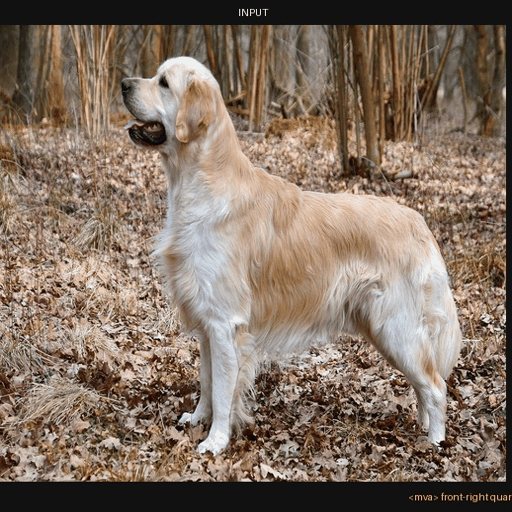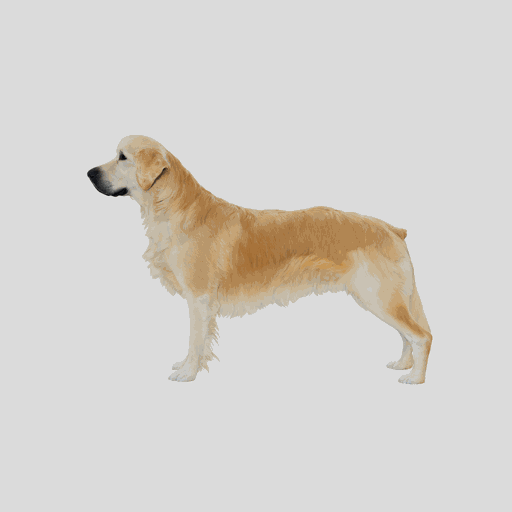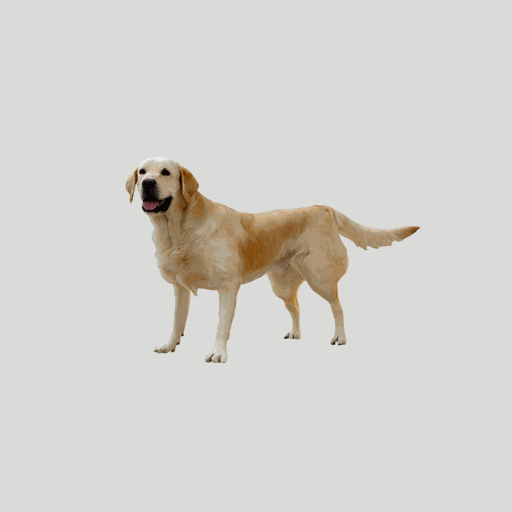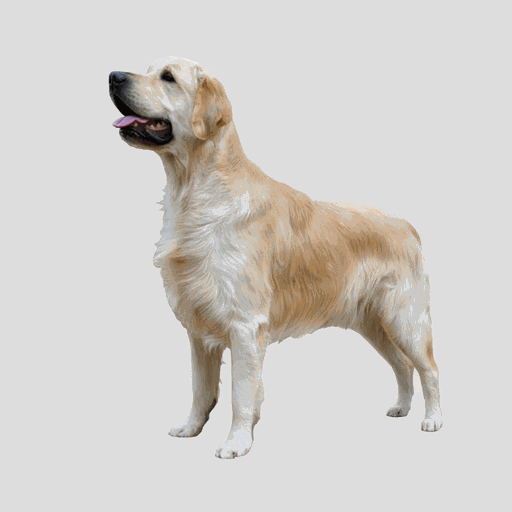
눈높이에서 골든 리트리버를 12개 방위각 단계 전체로 회전시킨 결과물로, v2 체크포인트의 1,500 스텝으로 생성했습니다.
어댑터가 추가하는 기능
Qwen-Image 2.1은 하나의 모델에서 생성과 편집을 모두 처리하지만, 카메라가 어디에 서 있는지에 대한 개념은 없습니다. "뒷면을 보여줘"라고 프롬프트해도 보통 피사체는 원래 있던 자리에 그대로 남습니다. 이 LoRA는 대신 포즈 사전을 학습합니다. 모든 프롬프트는 트리거 <mva>로 시작하고 그 뒤에 이름이 지정된 방위각과 고도가 오며, 모델은 장면이 아니라 카메라를 움직입니다.
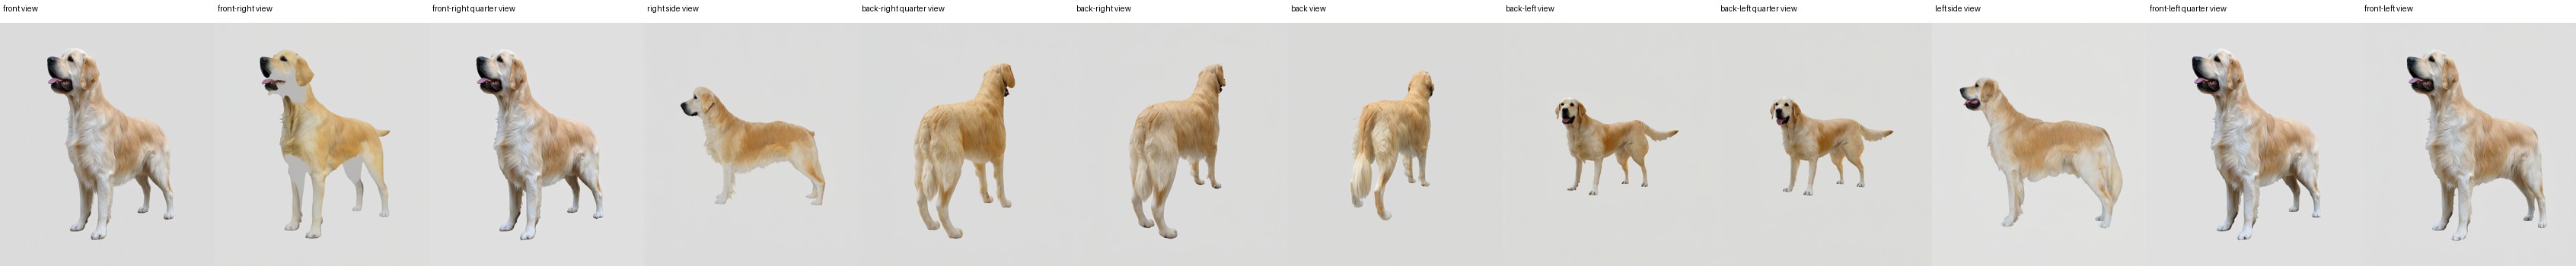
라벨이 붙은 스트립으로 나타낸 동일한 회전이며, 방위각마다 한 프레임입니다.
문법은 짧습니다:
<mva> {azimuth}, {elevation}[ close-up]- 12개 방위각은 30도 간격으로, 정면 뷰에서 양쪽 측면을 거쳐 후면 뷰까지 이어집니다.
- 4개 고도: 눈높이, 높은 위치(30도), 하이 앵글(60도), 탑다운(90도).
- 모든 조합에 대한
close-up변형이 있어 총 72개의 지정 가능한 프레이밍이 있습니다. - ComfyUI 또는 diffusers에서 권장 LoRA 강도는
0.8에서1.0사이입니다.
실제 사진에서의 동작
학습 데이터셋은 렌더링된 객체들이지만, 모델 카드에는 한 번도 본 적 없는 일반 사진에 대한 홀드아웃 테스트가 기록되어 있습니다. Wikimedia Commons의 골든 리트리버, 고양이, 사과입니다. 강도 1.0 정도에서 피사체는 요청한 시점으로 회전하고 장면은 대부분 유지되지만, 학습 분포에서 멀리 떨어진 피사체의 경우 털 같은 세부 디테일이 흐려집니다.
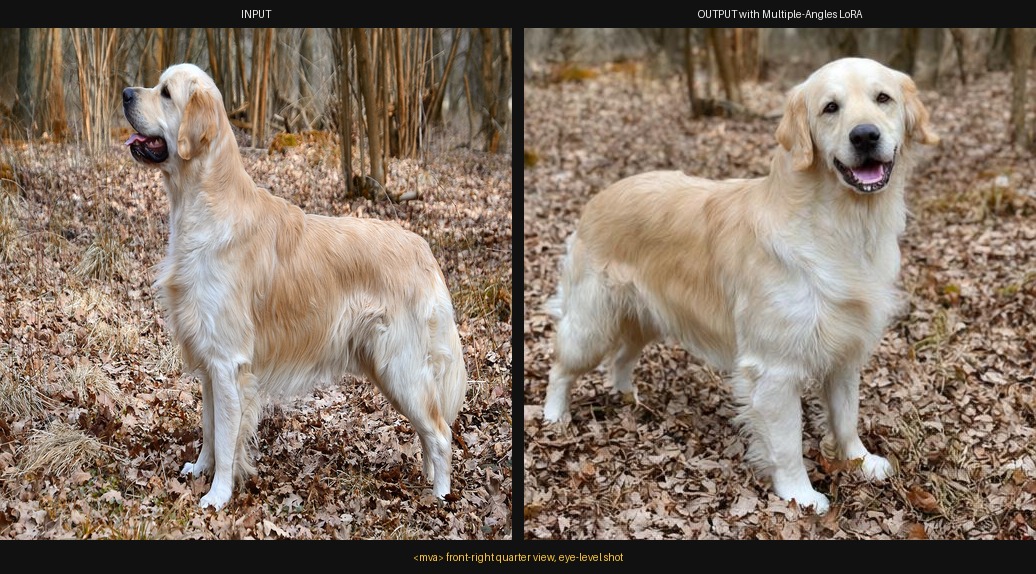 | 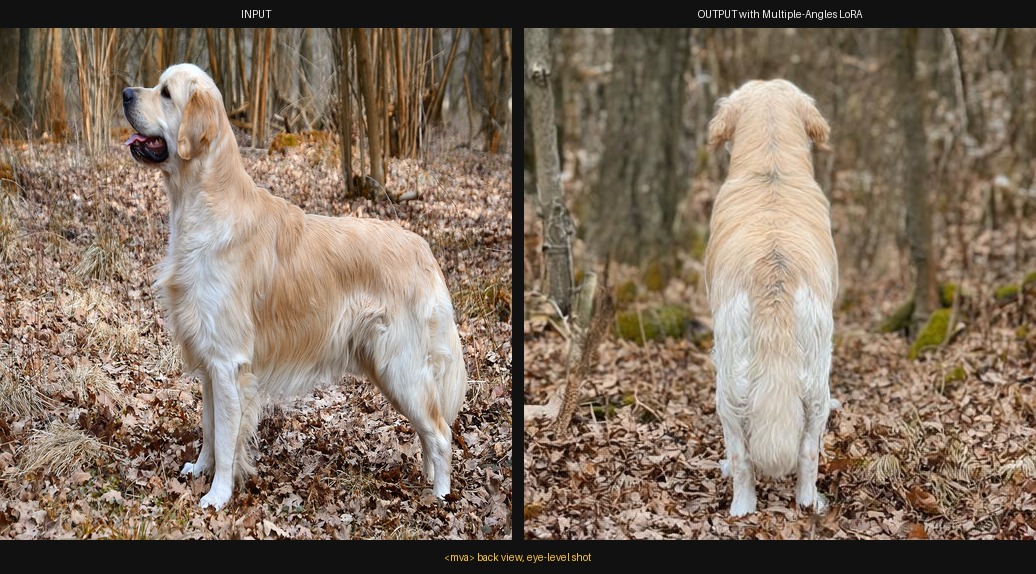 |
|---|---|
| 정면 오른쪽 4분면 뷰, 눈높이 | 후면 뷰, 눈높이 |
카드의 경험 법칙은 이렇습니다. 강도 1.0에서 시작하고, 카메라를 움직이는 대신 참조 사진을 복사하는 쪽으로 결과가 흐르면 체크포인트를 바꾸지 말고 강도를 0.8 쪽으로 낮추세요.
v2에서 달라진 점
두 번째 개정판이 권장 다운로드입니다. 학습 쌍을 5,028개에서 13,328개로 늘리고(캐릭터를 우선한 Dome-Objaverse 세트와 라이선스 필터링을 거친 리깅 캐릭터), rank를 32에서 64로 올렸으며, 베이스 정밀도를 convrot int8에서 bf16으로 전환하고 가중 타임스텝 샘플링을 적용했습니다.
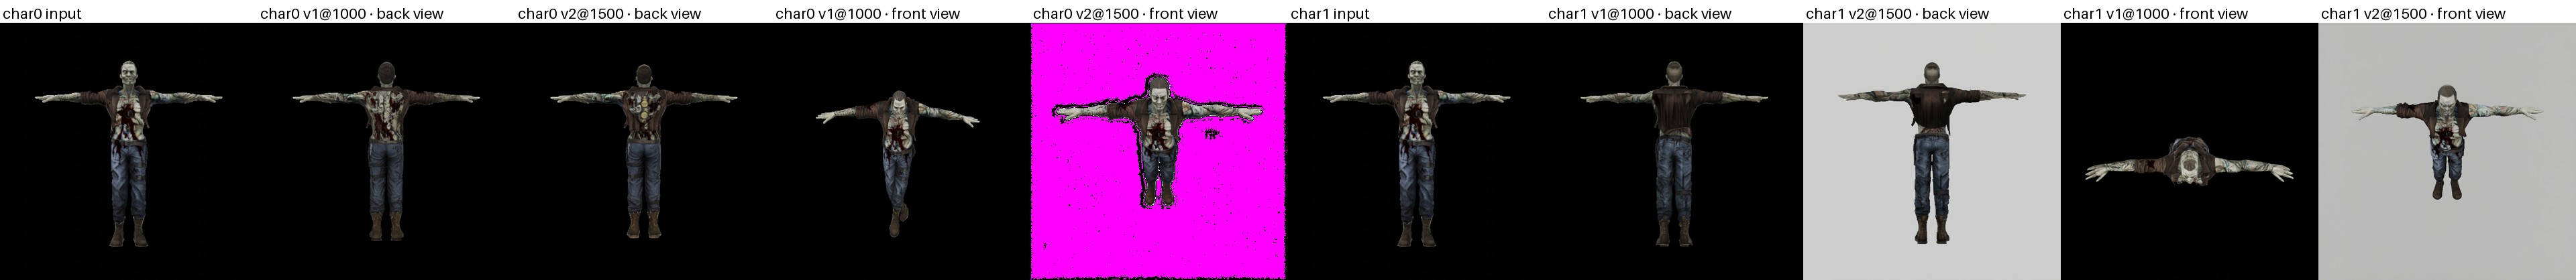
1,000 스텝의 v1과 1,500 스텝의 v2를 비교한 캐릭터 포즈 시트.
<mva> 문법과 포즈 사전은 버전 간에 달라지지 않았으므로, v1용으로 만든 워크플로는 파일을 교체한 뒤에도 계속 작동합니다. 카드에서는 v2 학습의 스텝 1,500을 권장합니다(rank 64, 전체 정밀도, checkpoints_v2/에서 약 319 MB). v1 파일은 checkpoints/에 남아 있으며, 그중에서는 스텝 1,000이 선택할 만합니다.
ComfyUI에서 실행하기
이 어댑터는 일반 LoRA이므로 커스텀 노드 팩이 필요하지 않습니다. .safetensors 파일을 ComfyUI/models/loras/에 넣고, Qwen-Image 2.1 diffusion 모델과 텍스트 인코더, 그에 맞는 VAE와 함께 표준 LoRA 로더로 불러오면 됩니다. 카드에서는 강도 0.8에서 1.0을 권장합니다. 어댑터 전용 샘플러나 CFG 값은 없으므로 베이스 모델 자체의 설정이 적용됩니다.
벤치마크, 있는 그대로
카드에는 144개 케이스의 홀드아웃 벤치마크(보지 못한 객체 24개, 각 6개 포즈)가 공개되어 있으며, 정답 돔 렌더를 기준으로 CLIP 이미지-이미지 코사인으로 채점한 결과를 솔직하게 보고합니다. 어댑터를 적용하지 않은 베이스가 오히려 평균 점수가 조금 더 높은데(0.857 대 0.832), 이 지표는 카메라가 움직였는지보다 전반적인 이미지 유사도를 주로 측정하기 때문입니다. 저자들은 올바른 프로토콜이 포즈 검색 정확도이며 이는 아직 렌더링을 한 번 더 거쳐야 한다고 언급하고, 이 기능 자체에 대한 주요 증거로 동일 프롬프트 A/B 이미지를 독자들에게 제시합니다.
다운로드 정보
가중치: akhaliq/Qwen-Image-2.1-Multiple-Angles-LoRA
베이스 모델: Qwen/Qwen-Image-2.1
학습 데이터 (v2): akhaliq/qwen21-multiple-angles-train-v2
베이스 패밀리 페이지: Qwen-Image 2.1
댓글
GitHub로 로그인하고 토론에 참여하세요.