Prism: 2K 공동 비디오·오디오 생성, 학습 속도 2.5배
푸단대, 텐센트 Hunyuan, 저장대가 개발한 Prism은 동적 희소 어텐션으로 2K 공동 비디오-오디오 모델을 학습합니다. 전체 어텐션보다 2.5배 빠르며 미리보기 가중치가 공개되었습니다.
공개된 미리보기 체크포인트의 생성 예시.
Prism이 하는 일
네이티브 고해상도 학습은 비디오-오디오 통합 모델이 더 미세한 시각적 디테일과 더 선명한 움직임을 학습하는 방법이지만, 전체 어텐션은 시퀀스 길이에 따라 제곱으로 증가하며 2K에서는 방대한 중복 토큰에 어텐션을 분산시킵니다. Prism은 해상도는 유지하고 어텐션 방식을 바꿉니다.
이 방법은 토큰 시퀀스를 시공간 매크로 존으로 구성합니다. 각 존마다 두 가지 신호로부터 국소 정보 구조를 추정합니다.
- 채널 차원에 따른 비디오 특징 분산: 각 방향에서 시각 콘텐츠가 얼마나 빠르게 변하는지 보여줍니다.
- 오디오-비디오 교차 어텐션의 특징 노름: 오디오가 각 시각 영역에 얼마나 강하게 영향을 주는지 보여줍니다.
이 신호들이 존별 블록 형태를 결정합니다. 시각 콘텐츠가 빠르게 변하거나 오디오-비주얼 결합이 강한 축을 따라서는 더 세밀하게 분할하고, 그 외의 영역에서는 더 거칠게 분할합니다. 의도는 블록 내부의 토큰이 의미적으로 일관되게 유지되어, 블록 수준 특징이 시각 콘텐츠와 오디오-비디오 상호작용을 모두 담아내는 것입니다. 이어서 하이브리드 블록 선택 전략(top-k와 top-p CDF 임계값의 결합)이 쿼리별 희소성을 설정합니다.
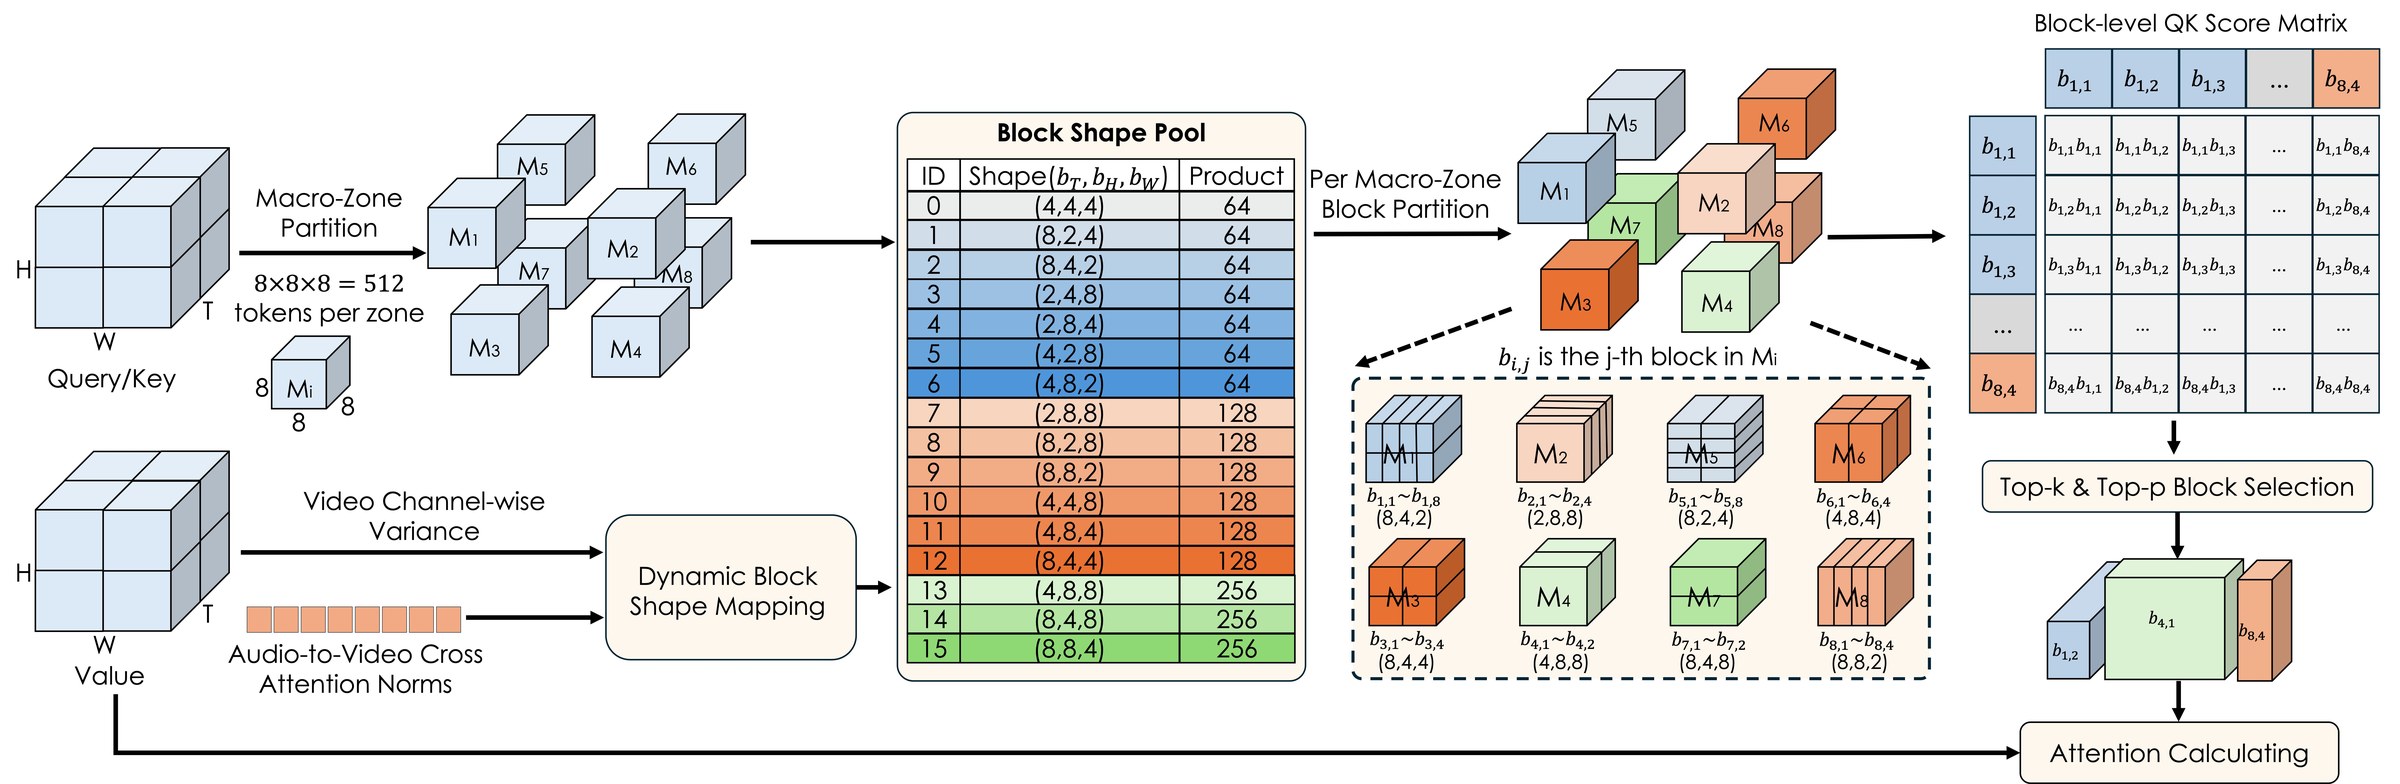
공식 모델 카드에 소개된 Prism 프레임워크.
공개된 항목
이 프로젝트는 단일 체크포인트가 아니라 전체 학습 및 추론 스택으로 제공됩니다.
- 미리보기 체크포인트. MOVA 아키텍처를 기반으로 한
Prism-preview-alpha(안정 버전)와Prism-preview-beta(모션 버전)로, 720p, 1080p, 2K에서 네이티브 공동 비디오-오디오 생성을 지원합니다. - 코드. 잠재 데이터 추출과 디코드를 포함한 데이터 전처리, 학습, 전체 파인튜닝 및 추론, 그리고 멀티 노드 실행을 위한 분산 런치 스크립트.
- 보고서. 기술 보고서는 arXiv에 있으며, 모델 카드와 저장소에서 링크되어 있습니다.
공개된 미리보기 체크포인트의 생성 결과.
공개된 체크포인트는 참조 이미지를 조건으로 이미지-오디오-비디오 생성도 지원합니다.
 |  |
|---|---|
| 공식 이미지-오디오-비디오 사례 입력 | 공식 이미지-오디오-비디오 사례 입력 |
Prism-pro 체크포인트는 프로젝트 로드맵에 남은 항목으로 표시되어 있으며 아직 공개되지 않았습니다.
사용 가능 여부
미리보기 가중치는 Hugging Face에 있고, 코드와 스크립트는 Tencent-Hunyuan/Prism에, 보고서는 arXiv에 있습니다. 현재 추론은 프로젝트 자체 PyTorch 스크립트를 통해 실행됩니다. 아직 ComfyUI 노드나 패키징된 ComfyUI 체크포인트가 없으므로, 로컬에서 실행하려면 공식 저장소를 직접 사용해야 합니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.