FastH3 Trim: 8GB GPU를 위한 8단계 프루닝 MiniMax H3
FastVideo가 FastH3 Trim을 공개했습니다. 50개 블록 중 8개를 제거한 프루닝 MiniMax H3로, 최소 8GB의 GPU 메모리에서 오디오가 포함된 8단계 비디오를 실행하며 ComfyUI 리팩 파일도 함께 제공됩니다.
Trim이 바꾸는 것
베이스 H3는 세 개의 네트워크로 구성됩니다. Qwen3-VL 텍스트 인코더, 비디오와 오디오 latent를 함께 디노이즈하는 50블록 diffusion transformer, 그리고 두 개의 VAE입니다. BF16에서는 137.7GiB로 32GB 카드에 들어가지 않습니다. FastH3 V2는 양자화로 이를 줄였고, Trim은 여기에 더해 블록을 제거합니다.
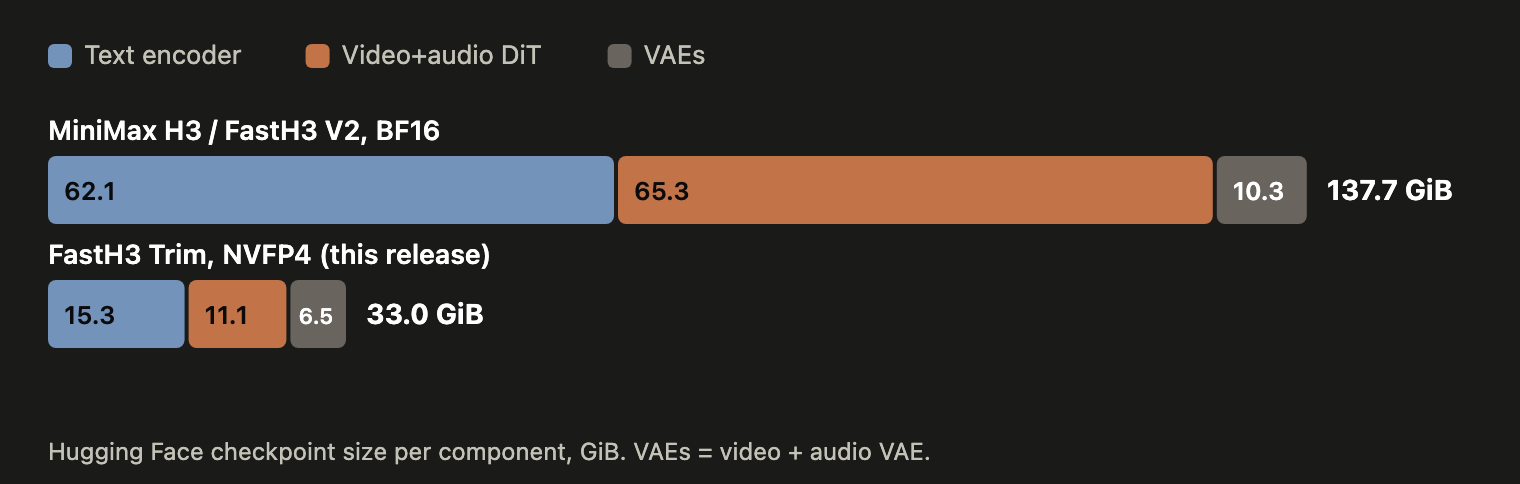
구성 요소별 체크포인트 크기. BF16 H3는 137.7GiB이고, FastH3 Trim NVFP4 릴리스는 33.0GiB이며 트랜스포머는 11.1GiB입니다.
- 블록 프루닝: 팀은 베이스 H3에서 한 번에 하나의 블록을 건너뛰고 비디오와 오디오 예측이 얼마나 변하는지 기록했습니다. 네 가지 예시 유형(모션, 음성, 음악, 사운드 이벤트)과 세 가지 노이즈 레벨에 걸쳐 총 600회를 측정했습니다. 각 블록은 어떤 조건에서든 유발한 최대 변화량을 기준으로 순위가 매겨졌기 때문에, 비디오나 오디오 중 하나에라도 중요한 블록은 유지됩니다. 제거된 8개 블록은 모두 네트워크의 전반부에 있으며, 첫 번째와 마지막 블록이 출력을 가장 크게 변화시켰습니다.
- 타임스텝 조건화: H3는 2,688차원 시간 임베딩을 여섯 개의 변조 벡터로 매핑하는 AdaLN 프로젝션을 통해 모든 블록을 diffusion 타임스텝에 조건화하며, 이 프로젝션들은 50개 블록에 걸쳐 BF16으로 24GiB를 차지합니다. Trim은 이를 하나의 공유된 2,688 → 16 기저와 블록별 소형 프로젝션으로 대체하고, BF16이 약 1.7배 더 큰 재구성 오류를 내기 때문에 FP16으로 저장합니다.
- 학습: 새로운 42블록 모델은 FastH3 V2 목적 함수를 사용해 8단계 DMD2로 직접 학습되었습니다. 베이스 H3가 고정된 teacher와 학습 가능한 critic을 모두 초기화하며, 어텐션은 80% 희소하고, 샘플러 스텝은 999, 874, 749, 624, 500, 375, 250, 125입니다.
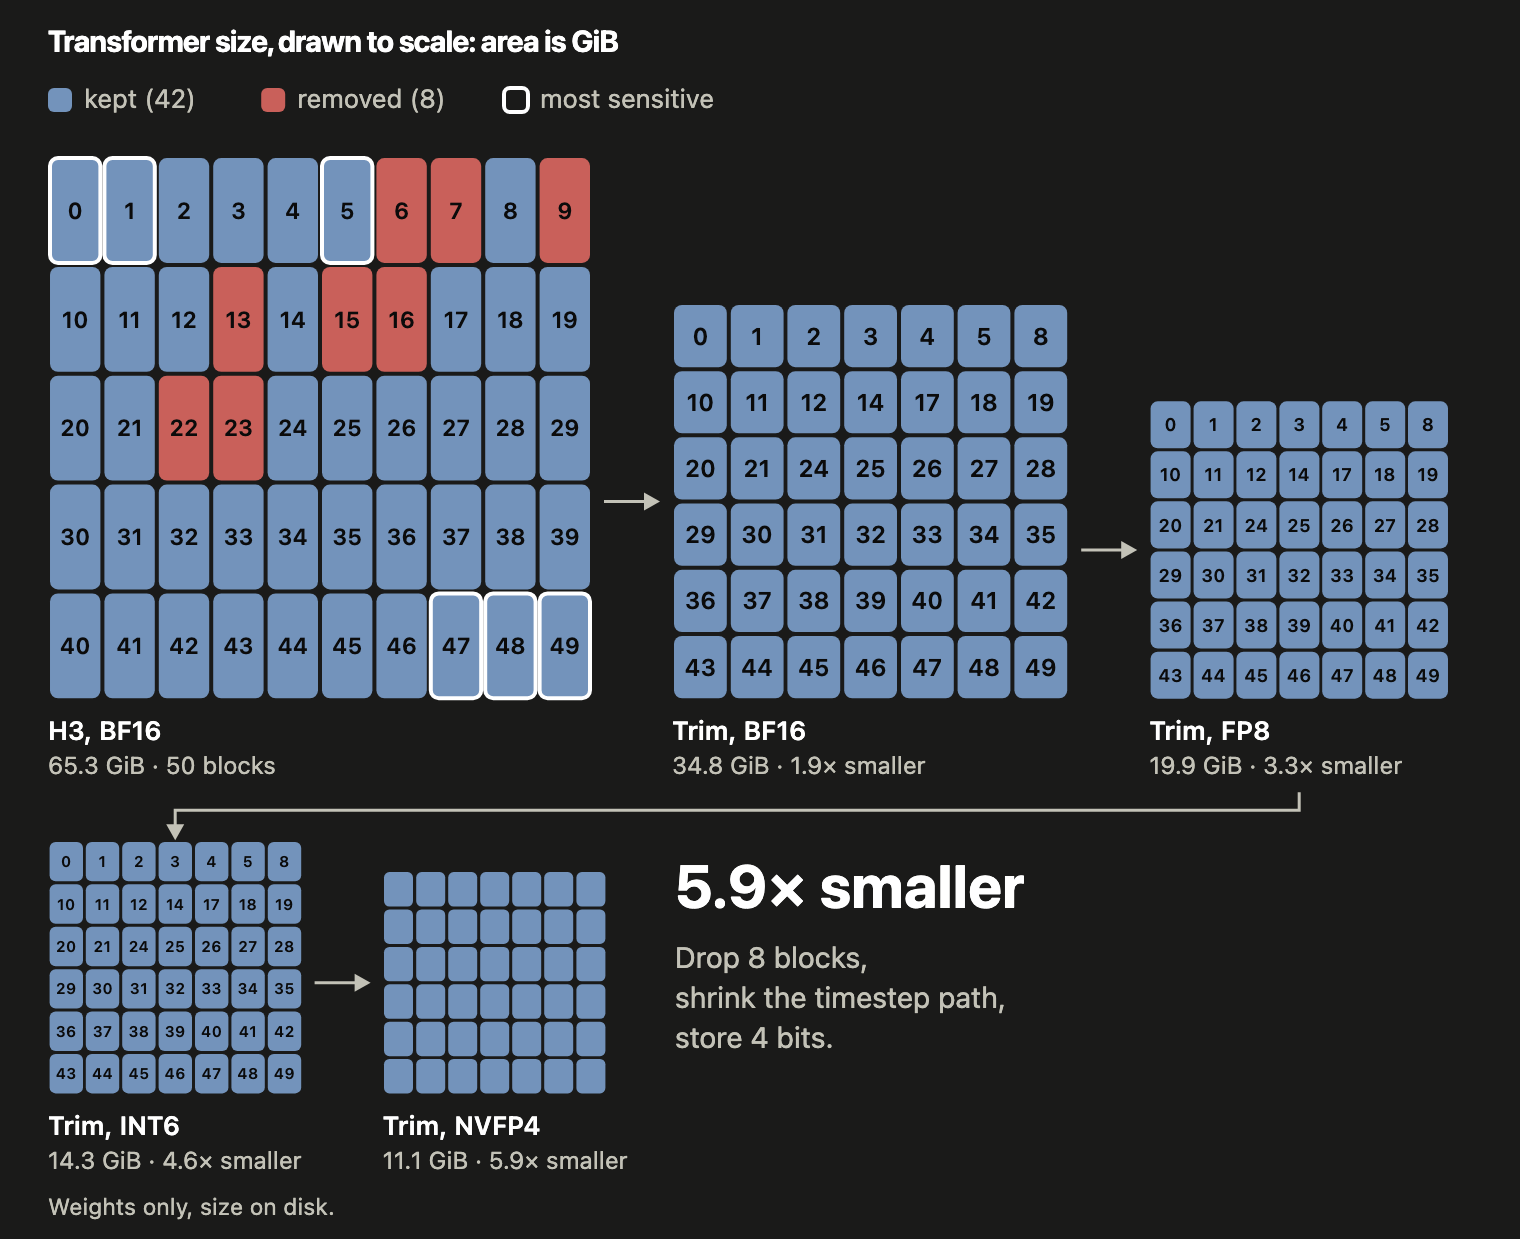
배포되는 각 포맷의 FastH3 Trim 트랜스포머를 실제 비율로 그린 그림입니다. 면적이 체크포인트 크기입니다.
ComfyUI 리팩에 포함된 내용
이 릴리스는 FastVideo/FastVideo-FastH3-Trim-Comfy에서 ComfyUI용으로 재패키징되었습니다. diffusion 모델 파일 하나와 이에 맞는 텍스트 인코더를 선택하세요:
| Diffusion 모델 | 크기 | 사용 대상 |
|---|---|---|
fastvideo_fasth3_trim_8step_nvfp4.safetensors | 11.9 GB | NVIDIA Blackwell: RTX 50 시리즈, RTX PRO 6000, DGX Spark |
fastvideo_fasth3_trim_8step_fp8.safetensors | 19.7 GB | NVIDIA Ada 이상: RTX 40 시리즈 |
fastvideo_fasth3_trim_8step_int8_convrot.safetensors | 18.9 GB | 최신 NVIDIA GPU 전반, 템플릿 기본값과 일치 |
fastvideo_fasth3_trim_8step_bf16.safetensors | 37.5 GB | 참조 품질 또는 다른 포맷으로 변환할 때 |
이 저장소에는 Qwen3-VL 텍스트 인코더(BF16, INT8 ConvRot, NVFP4 AWQ)와 MiniMax H3 비디오 및 오디오 VAE도 포함되어 있습니다. 모든 NVFP4 레이어는 1,000개의 프롬프트로 캘리브레이션한 활성화 스케일을 사용하며, Trim은 294개의 캘리브레이션된 레이어를 가집니다.
ComfyUI에서 실행하기
ComfyUI(0.36.0 이상)와 함께 제공되는 FastVideo FastH3: Text to Video 템플릿을 사용하고, UNETLoader에서 Trim diffusion 모델 중 하나를 선택하세요. 템플릿의 샘플러 설정은 그대로 유지하세요: 8 steps, res_multistep, simple, 그리고 비디오에는 10, 오디오에는 3으로 설정한 MiniMaxH3SigmaShift 노드입니다.
실행 속도
오디오가 포함된 5초 클립의 엔드투엔드 소요 시간(초)이며, 두 개의 프롬프트마다 두 번 실행한 값의 중앙값입니다. 블로그 글에서 발췌:
| 기기 | V2, 480p | Trim, 480p | V2, 768p | Trim, 768p |
|---|---|---|---|---|
| RTX PRO 6000 96 GB | 13.5 | 12.0 | 36.5 | 32.5 |
| RTX 5090 32 GB | 14.8 | 13.4 | 38.6 | 35.4 |
| RTX 4090 24 GB | 54.6 | 43.9 | 154.6 | 132.8 |
| RTX 4090, 16 GB 제한 | 79.9 | 72.1 | 153.7 | 139.9 |
| RTX 4090, 12 GB 제한 | 91.2 | 74.1 | 170.7 | 147.1 |
| RTX 4090, 8 GB 제한 | - | 82.0 | - | - |
| DGX Spark 128 GB 통합 메모리 | 141.4 | 125.8 | 340.1 | |
| 2x DGX Spark | 87.2 | 78.3 | ||
| Mac, M4 Max 36 GB 통합 메모리 | 925.2 |
8GB, 12GB, 16GB 행은 GPU 메모리를 제한한 동일한 RTX 4090입니다. 메모리가 더 적은 실제 카드는 더 느립니다. 블로그에 따르면 4090에서 FP8 경로는 사용할 FP4 텐서 코어가 없으므로, 더 느린 토큰별·채널별 FP8 matmul을 퓨즈드 per-tensor 커널과 출력 스케일링으로 우회하고, 스코어 연산을 위해 쿼리와 키를 INT8로 양자화합니다.
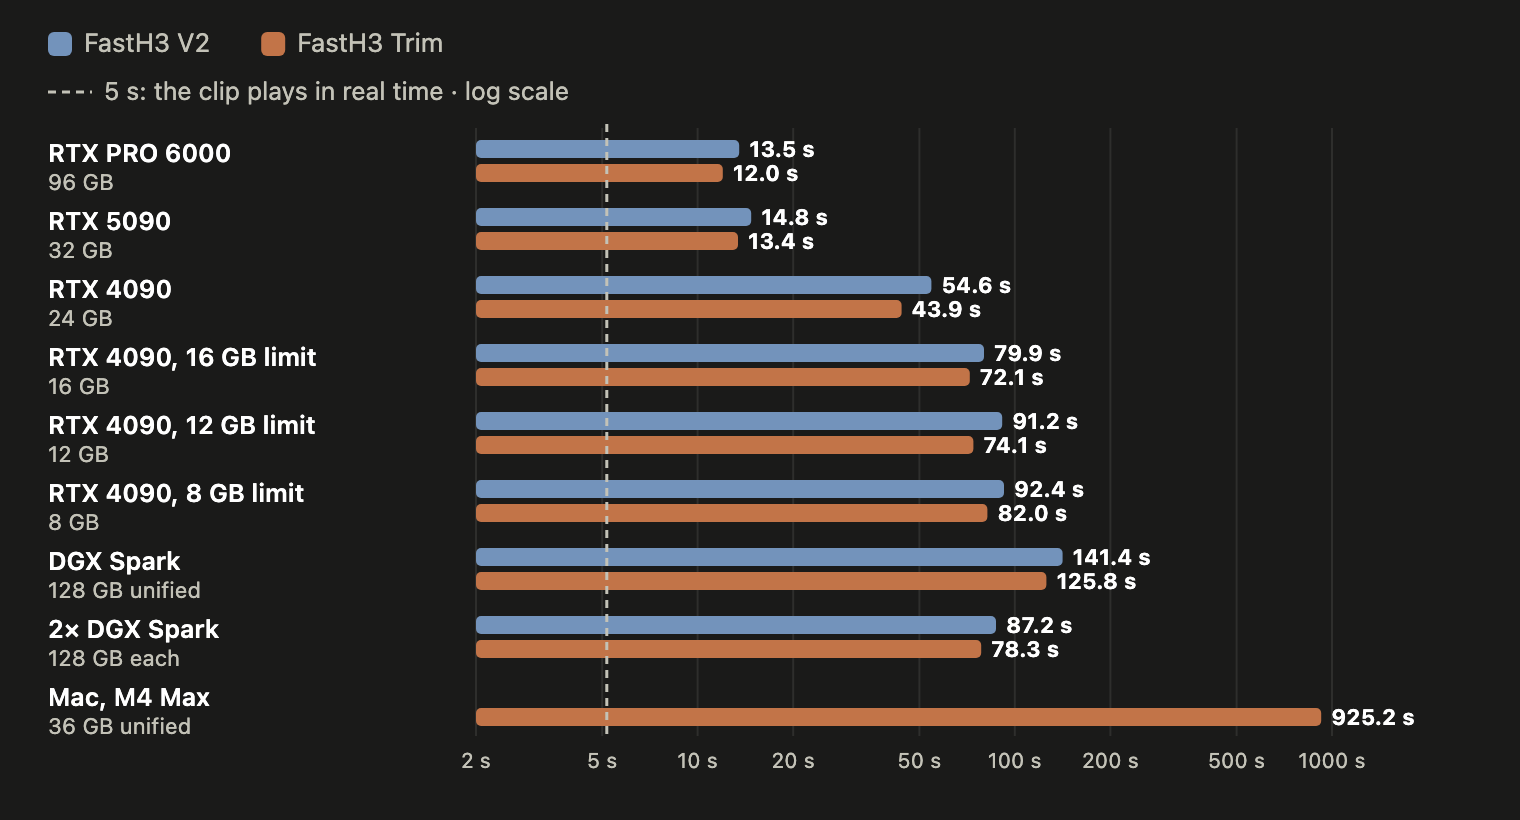
오디오가 포함된 5초, 832x480 클립의 기기별 엔드투엔드 시간.
RTX 5090에서 동일한 프롬프트와 시드로, 먼저 FastH3 V2, 다음으로 FastH3 Trim:
RTX 5090에서의 FastH3 V2.
동일한 RTX 5090, 동일한 프롬프트와 시드에서의 FastH3 Trim.
한계
- Trim은 품질 최강자가 아니라 실험으로 표시됩니다. 블로그는 블록을 제거하면 모델이 더 빠르고 작아지지만 품질이 일부 희생된다고 밝히며, 품질이 가장 중요할 때는 FastH3 V2를 권장합니다.
- 8GB 수치는 메모리를 제한한 카드에서의 Trim 전용 NVFP4 수치입니다. 테스트한 구성에서 V2는 12GB에 들어가지 않습니다.
- Trim은 8단계 FastH3 라인에만 존재합니다. 여전히 50블록 트랜스포머 전체가 필요한 베이스 MiniMax H3 모델 자체는 바뀌지 않습니다.
- ComfyUI 경로는 ComfyUI 0.36.0 이상에 포함된 FastH3 템플릿에 의존합니다.
다운로드
ComfyUI 리팩: FastVideo/FastVideo-FastH3-Trim-Comfy
소스 가중치: FastVideo/FastVideo-FastH3-Trim-8-Step
블로그 글: FastH3 on Consumer Hardware
코드: hao-ai-lab/FastVideo
품질 우선 대응 모델: FastVideo/FastVideo-FastH3-8-Step-V2
베이스 모델: MiniMaxAI/MiniMax-H3
댓글
GitHub로 로그인하고 토론에 참여하세요.