AcademiaSD LoRAlab: 9종 LoRA 학습기를 하나의 런처로 통합한 ComfyUI 도구
AcademiaSD LoRAlab Trainer Studio는 Qwen-Image 2.1, FLUX.2 Klein, Krea 2, Z-Image, MiniMax-H3 등 여러 모델의 LoRA 학습기를 하나의 런처에 묶은 도구로, 4GB VRAM부터 실행됩니다.
models/loras 폴더로의 원클릭 내보내기까지 동일한 웹 인터페이스를 사용합니다.
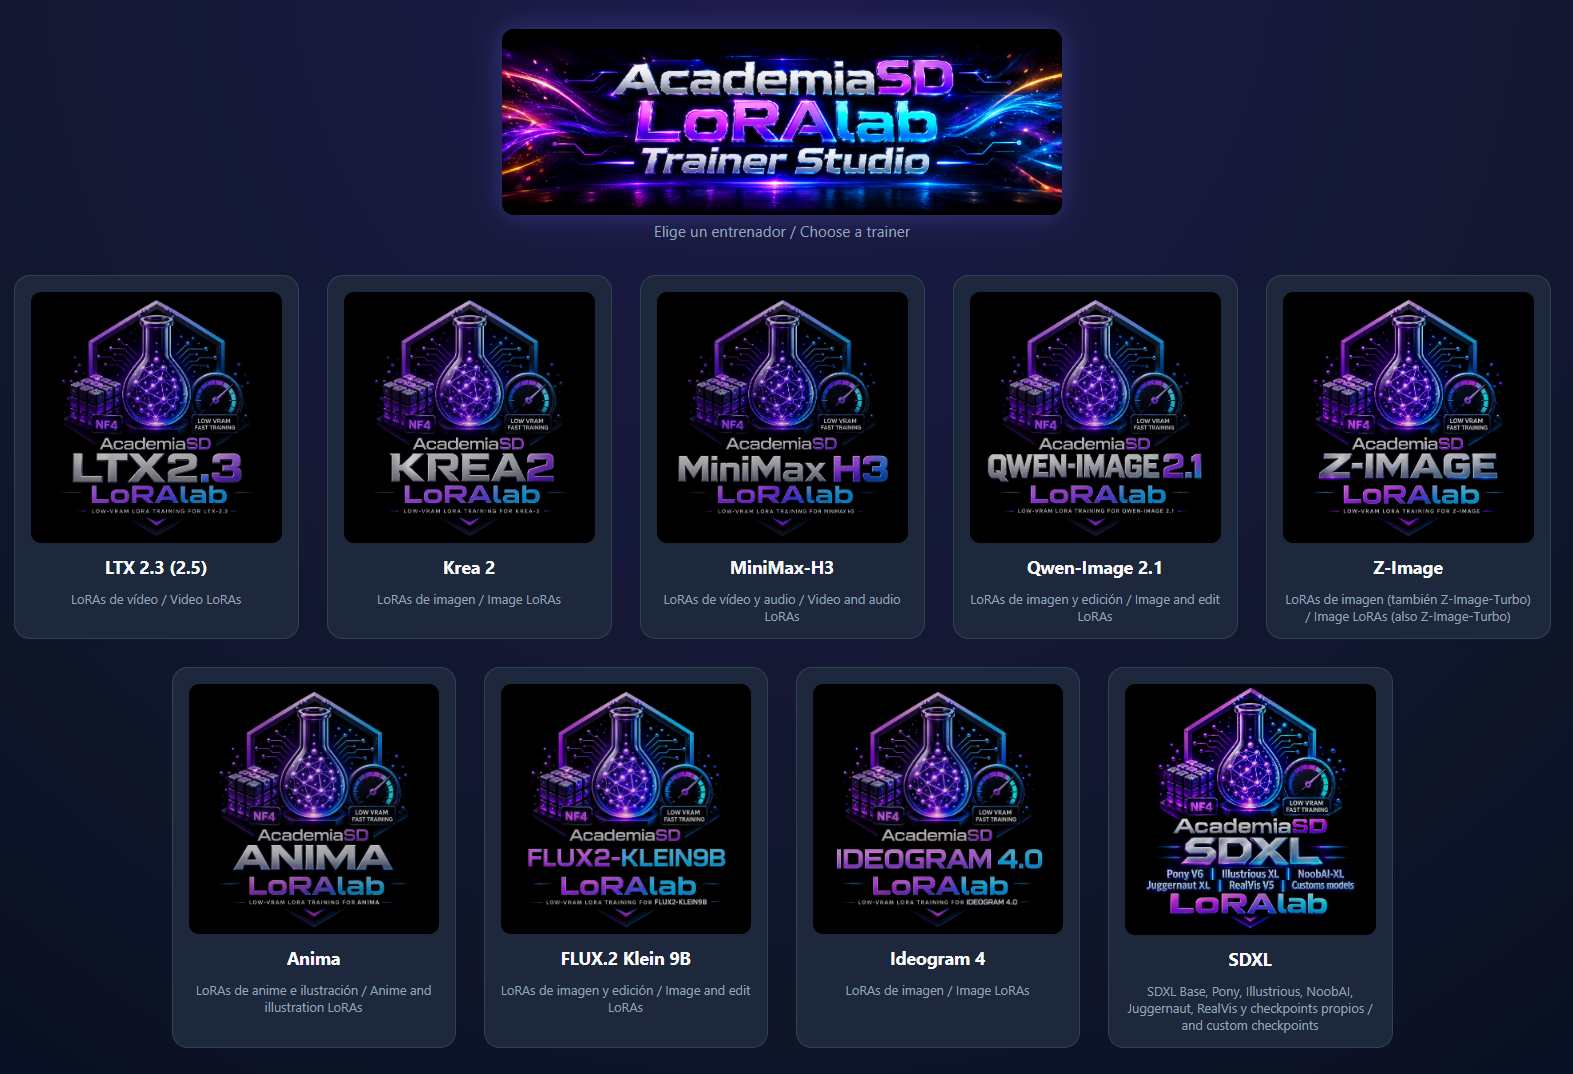
런처에서 학습기를 고르면 브라우저에서 열리며, 모델과 프로젝트, 설정은 그대로 공유됩니다.
무엇을 학습하며, VRAM은 얼마나 필요한가
| 학습기 | 학습 대상 | 최소 VRAM |
|---|---|---|
| Qwen-Image 2.1 | 캐릭터, 오브젝트, 스타일 LoRA와 편집 LoRA(이전 → 이후) | 8 GB |
| Krea 2 | Krea 2 Raw 및 Turbo용 캐릭터, 오브젝트, 스타일 LoRA | 8 GB |
| Z-Image | Z-Image 및 Z-Image-Turbo용 캐릭터, 오브젝트, 스타일 LoRA | 8 GB |
| Anima | 애니메이션 및 일러스트 캐릭터, 스타일 LoRA | 4 GB (NF4) / 6 GB (BF16) |
| FLUX.2 Klein 9B | 캐릭터, 오브젝트, 스타일 LoRA와 편집 LoRA | 12 GB |
| Ideogram 4 | 캐릭터, 오브젝트, 스타일 LoRA, JSON 캡션 지원 | 12 GB |
| SDXL | SDXL Base, Pony, Illustrious, NoobAI 및 기타 SDXL 체크포인트용 LoRA | 4 GB (NF4) / 12 GB (BF16) |
| LTX-2.3 (및 LTX-2.5) | LTX 비디오 모델용 캐릭터, 스타일 LoRA, 이미지로 학습 | 12 GB |
| MiniMax-H3 | 이미지, 클립, 오디오로 만드는 비디오 LoRA와 학습이 필요 없는 RefMods | 8 GB |
최소 사양은 컴퓨트 성능 7.5 이상의 NVIDIA GPU(RTX 20xx / GTX 16xx 이상), CUDA 13용 580 시리즈 이상 드라이버, 16 GB 시스템 RAM입니다. MiniMax-H3 비디오 클립을 다루려면 ffmpeg가 PATH에 있어야 합니다. GTX 10xx 카드는 제외됩니다. CUDA 13용 PyTorch는 RTX 20xx 세대부터 지원하기 때문입니다.
학습기마다 하나의 인터페이스
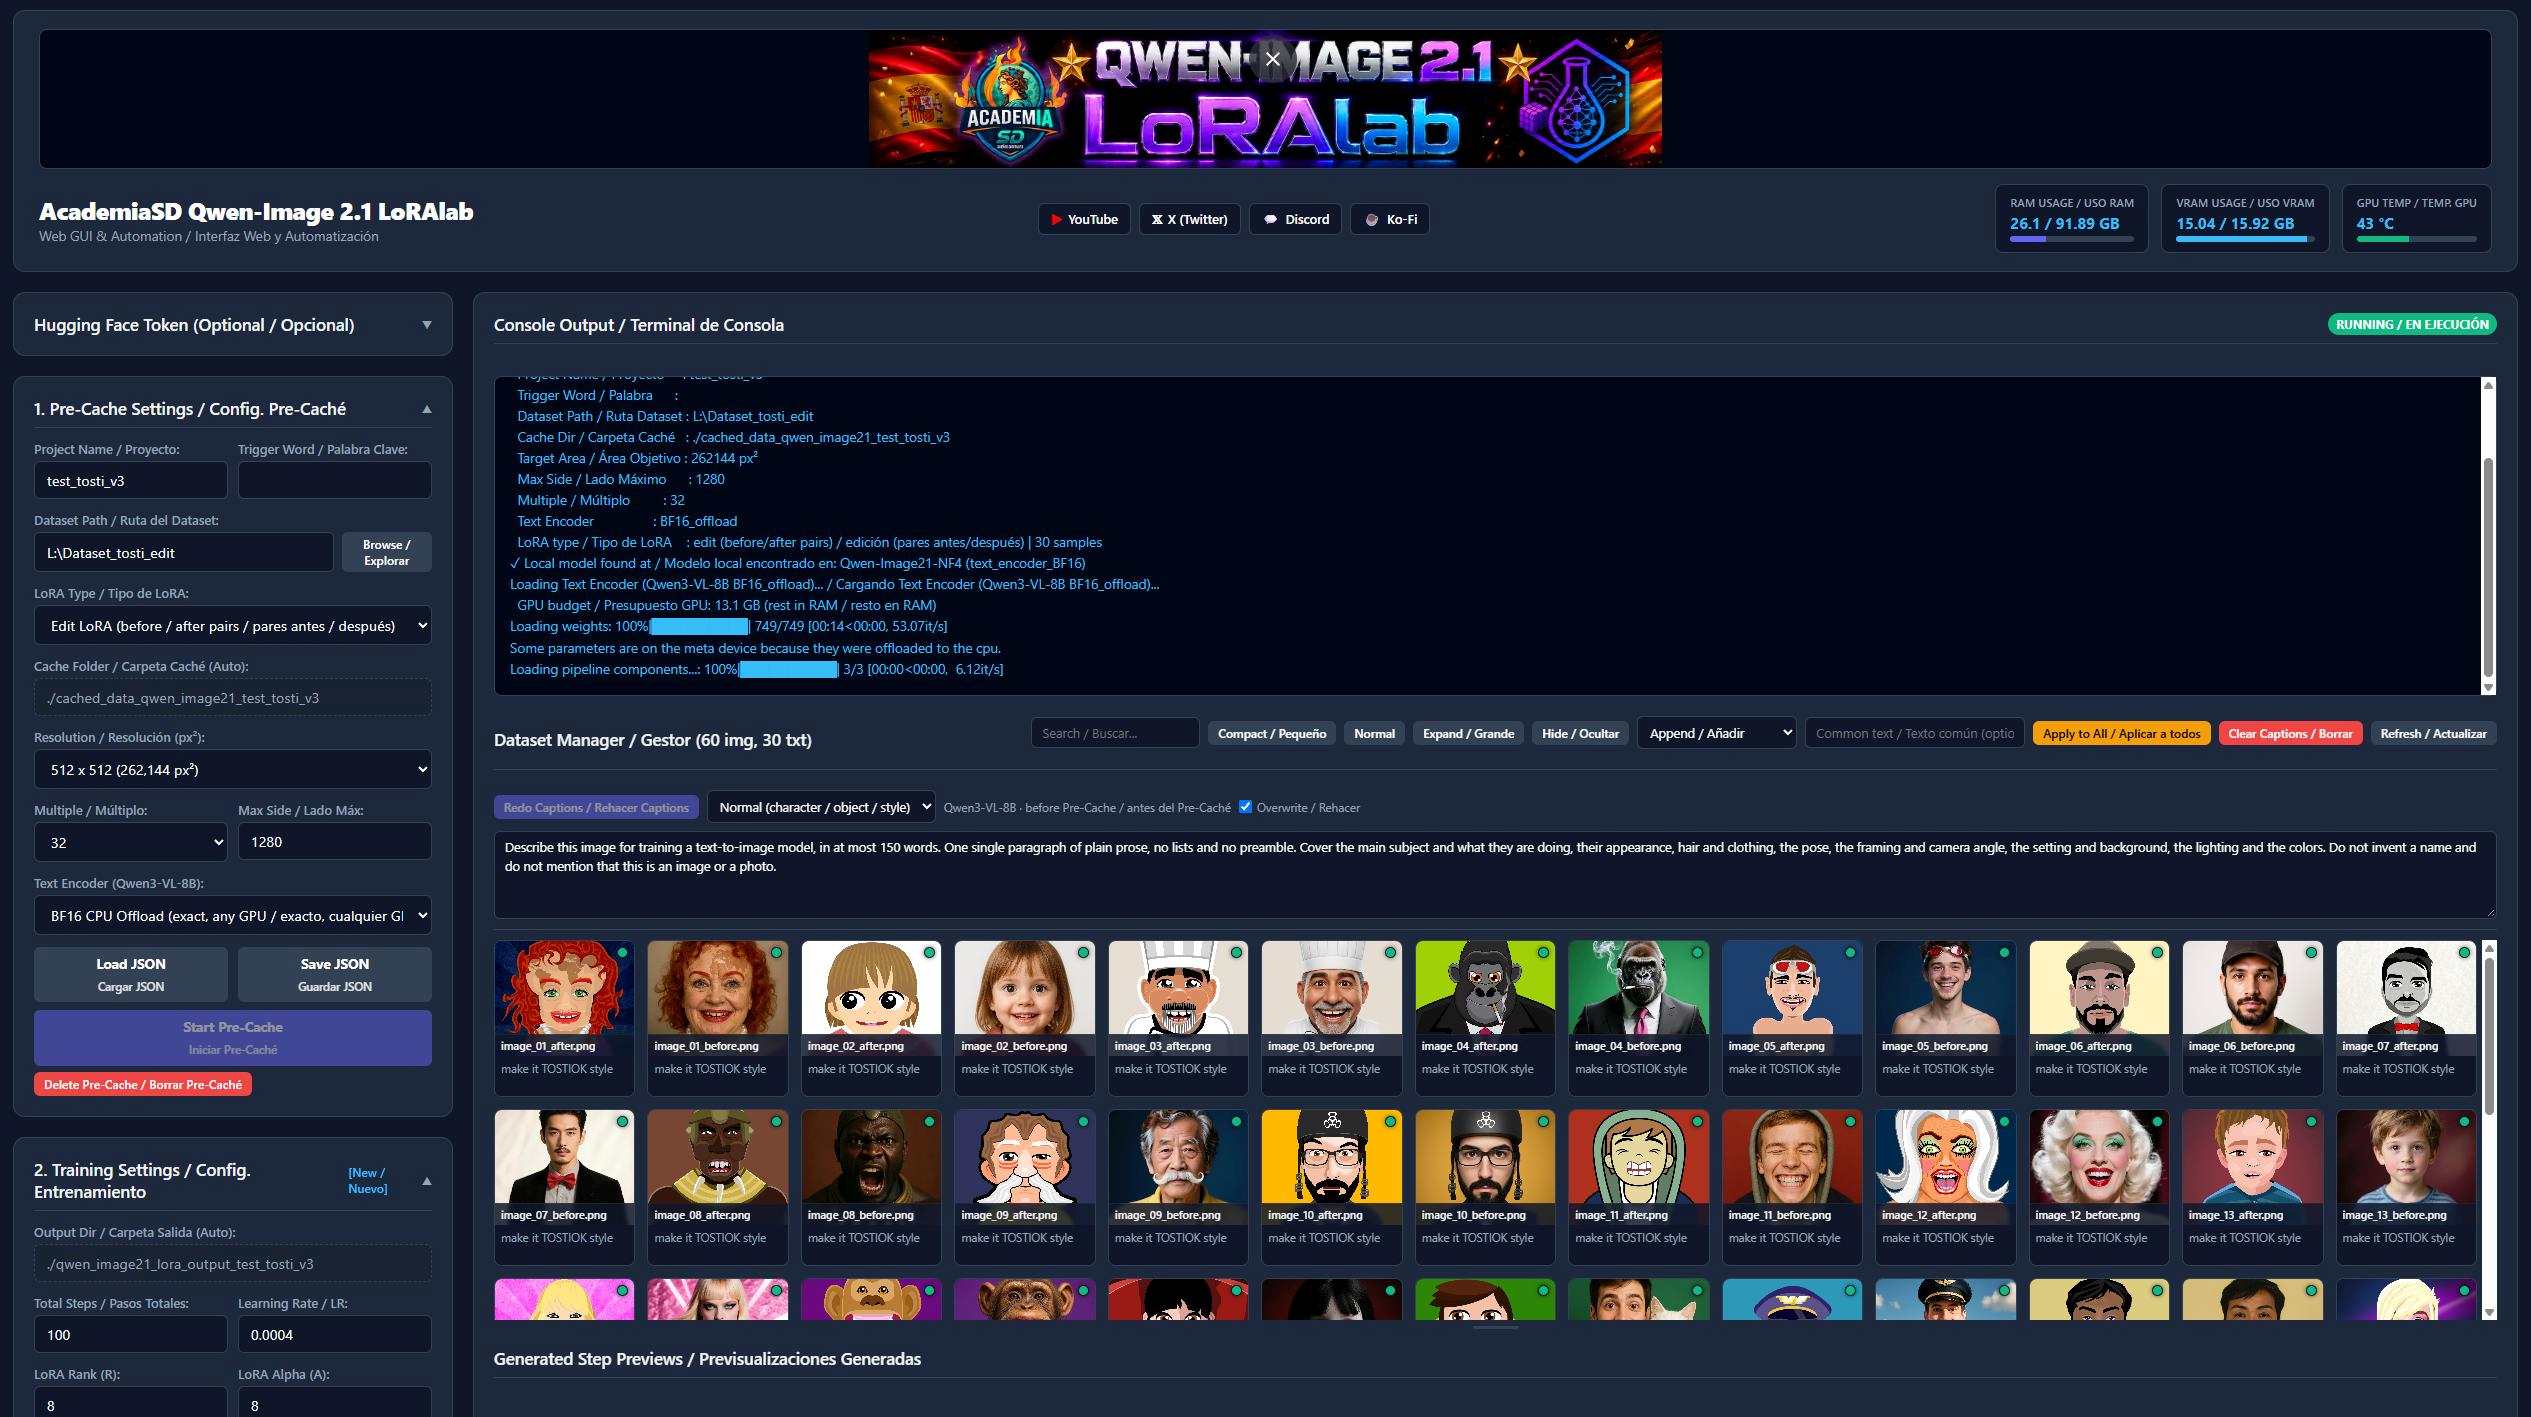
Qwen-Image 2.1 학습기. 아홉 개 학습기 모두 동일한 패널을 사용합니다.
모든 학습기는 같은 다섯 단계를 따릅니다.
- 프로젝트와 데이터셋. 프로젝트 이름을 정하고, 선택 사항인 트리거 단어를 추가한 뒤 데이터셋 폴더를 지정합니다. 각 이미지에는 같은 이름의
.txt캡션이 필요하며, 이미지는 폴더나.zip으로 끌어다 놓을 수 있습니다. - 캡션(선택 사항). 비전-언어 모델이 트리거 단어를 맨 앞에 둔 캡션을 모든 이미지에 작성합니다. 프롬프트는 편집할 수 있고, 기존 캡션을 덮어쓰지 않는 한 그대로 유지됩니다.
- 사전 캐시. 텍스트 인코더와 VAE를 선택한 해상도로 한 번 실행하고 그 출력을 디스크에 저장합니다. 다시 실행하면 변경되지 않은 이미지는 건너뛰며, 이후에는 GPU의 100%가 학습에 쓰입니다.
- 학습. 스텝, 학습률, 랭크와 알파를 설정한 뒤 시작합니다. 설정은 실행 중에도 바꿀 수 있고 다음 스텝부터 적용되며, Stop Training은 정확한 스텝을 저장하므로 며칠 뒤에도 한 스텝도 잃지 않고 이어서 학습할 수 있습니다.
- 내보내기.
Send to Models는 LoRA를 스튜디오가 학습기 전체에 걸쳐 기억하는 ComfyUI(또는 Forge / A1111)models/loras폴더로 복사합니다. 스텝 체크포인트를 브라우저에서 다운로드할 수도 있으며, 내보낸 LoRA에는 Civitai와 LoRA 매니저가 읽는 kohya 스타일 메타데이터가 포함됩니다.
스튜디오는 같은 네트워크의 다른 컴퓨터에서도 사용할 수 있습니다. 런처에 사용자 이름과 비밀번호를 쓰는 원격 접속 모드가 있어, 노트북에서 데이터셋을 업로드하고 학습된 LoRA를 다시 내려받을 수 있으므로 학습 PC를 직접 건드릴 필요가 없습니다.
학습 중에도 선명한 미리보기
이 모델들 중 일부는 샘플링을 지켜봐야 할 만큼 느리고, Qwen-Image 2.1, Krea 2, FLUX.2에 대한 ComfyUI 기본 Latent2RGB 미리보기는 각진 색상 블록으로 나옵니다. README에서 권장하는 조합은 kijai의 KJNodes와 ComfyUI/models/vae_approx/에 넣는 AcademiaSD의 초소형 오토인코더입니다. TAE-Qwen-Image-2.1, TAE-Krea-2, TAE_Flux2_AcademiaSD를 모델과 샘플러 사이의 Model Preview Override 노드에 넣으면 됩니다.
설치
플랫폼마다 설치 프로그램이 하나씩 있고, 모든 학습기가 하나의 venv를 공유합니다(CUDA 13.0의 PyTorch 2.14, GitHub의 Diffusers, Transformers, PEFT, bitsandbytes, Flask).
git clone https://github.com/AcademiaSD/AcademiaSD_LoRAlab-TrainerStudio.gitWindows에서는 Install_LoRAlab-TrainerStudio.bat을 더블 클릭하면 됩니다. Linux에서는 모든 .bat에 대응하는 .sh가 있으며 런처가 알맞은 것을 고릅니다. Triton과 SageAttention 2.2를 원한다면 Install_Triton&SageAtten220.bat을 실행하세요. 업데이트는 Update_LoRAlab-TrainerStudio.bat 하나로 끝나며, 모델과 데이터셋, 프로젝트, 설정은 그대로 유지됩니다. 이 프로젝트는 클라우드 학습용 RunPod 템플릿과 Docker 이미지도 제공합니다.
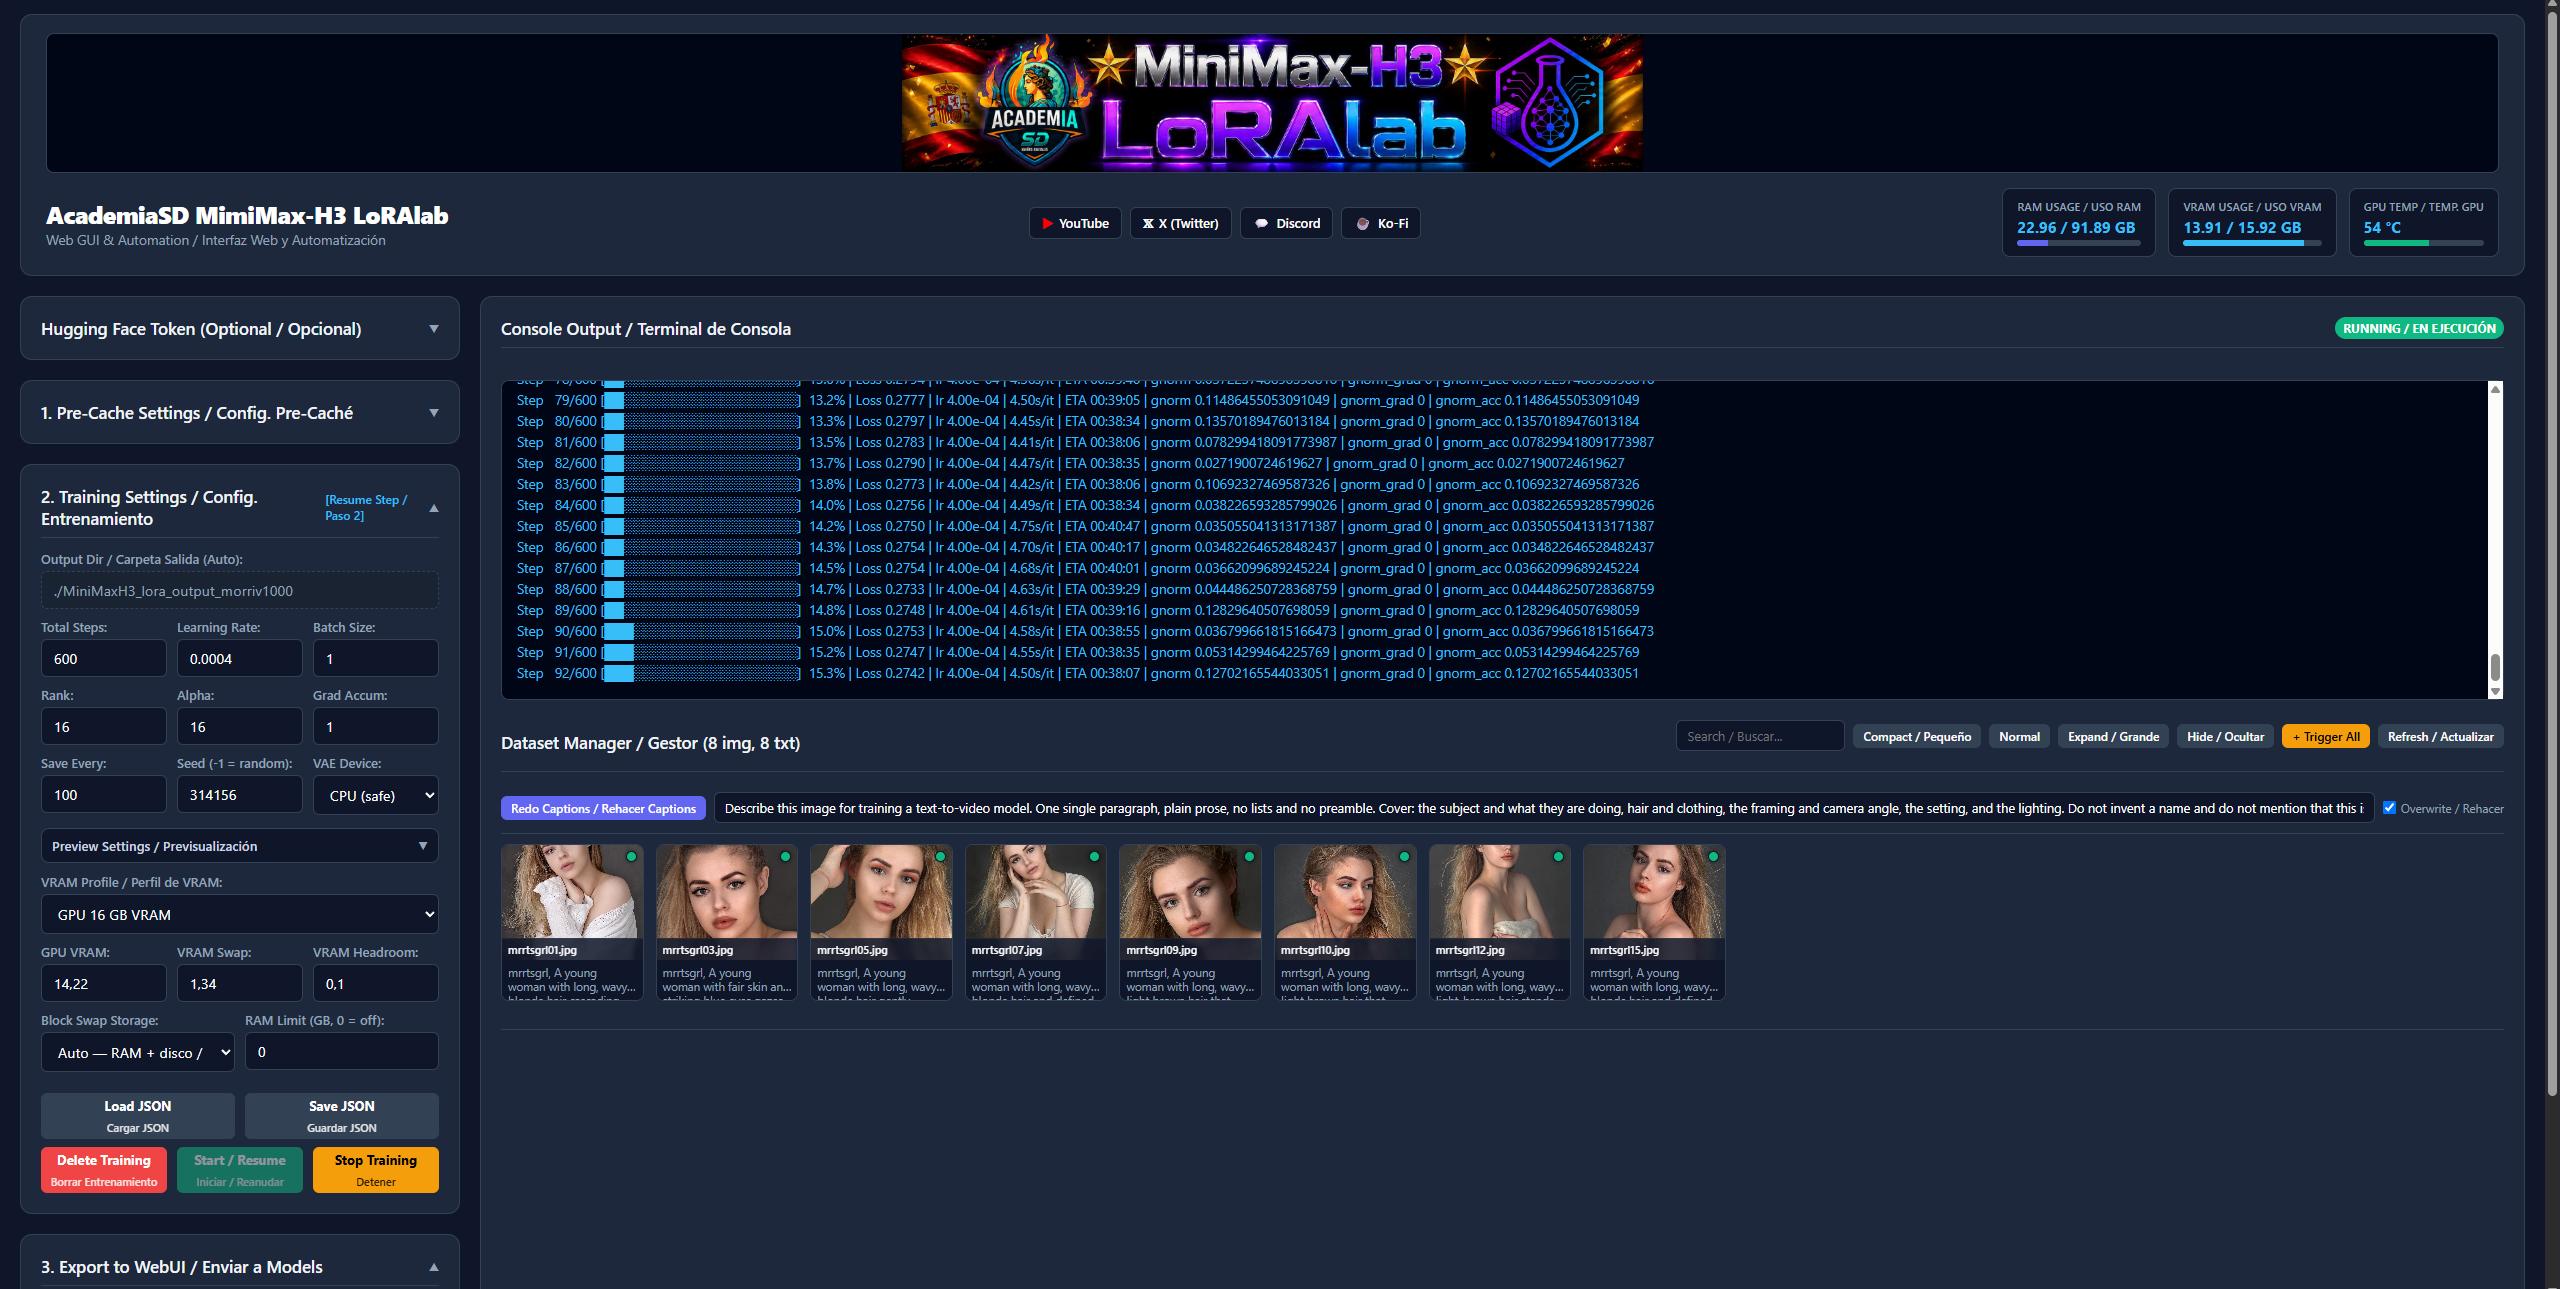
스튜디오의 두 비디오 학습기 중 하나인 MiniMax-H3 학습기.
작성자는 이 스튜디오를 초기 단계 작업이라고 밝힙니다. 학습기들이 빠르게 연달아 추가되었기 때문에 기본 학습 및 미리보기 설정이 모든 모델에 맞지 않을 수 있으며, 문제가 생기면 이슈로 알려주는 것이 의도된 방법입니다.
다운로드 및 사용 가능 위치
AcademiaSD LoRAlab Trainer Studio는 github.com/AcademiaSD/AcademiaSD_LoRAlab-TrainerStudio에 있으며, Hugging Face에는 AcademiaSD/Qwen-Image-2.1-NF4-for-LoRA-Training 같은 사전 양자화된 학습 패키지가 있습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.