DMAD: ComfyUI용 4스텝 MiniMax H3 오디오-비디오 LoRA
ByteDance와 Texas A&M이 DMAD를 공개했습니다. rank-128 LoRA로 MiniMax H3를 4스텝으로 줄여 오디오-비디오 동시 생성이 가능하며, Kijai의 ComfyUI 변환본도 제공됩니다.
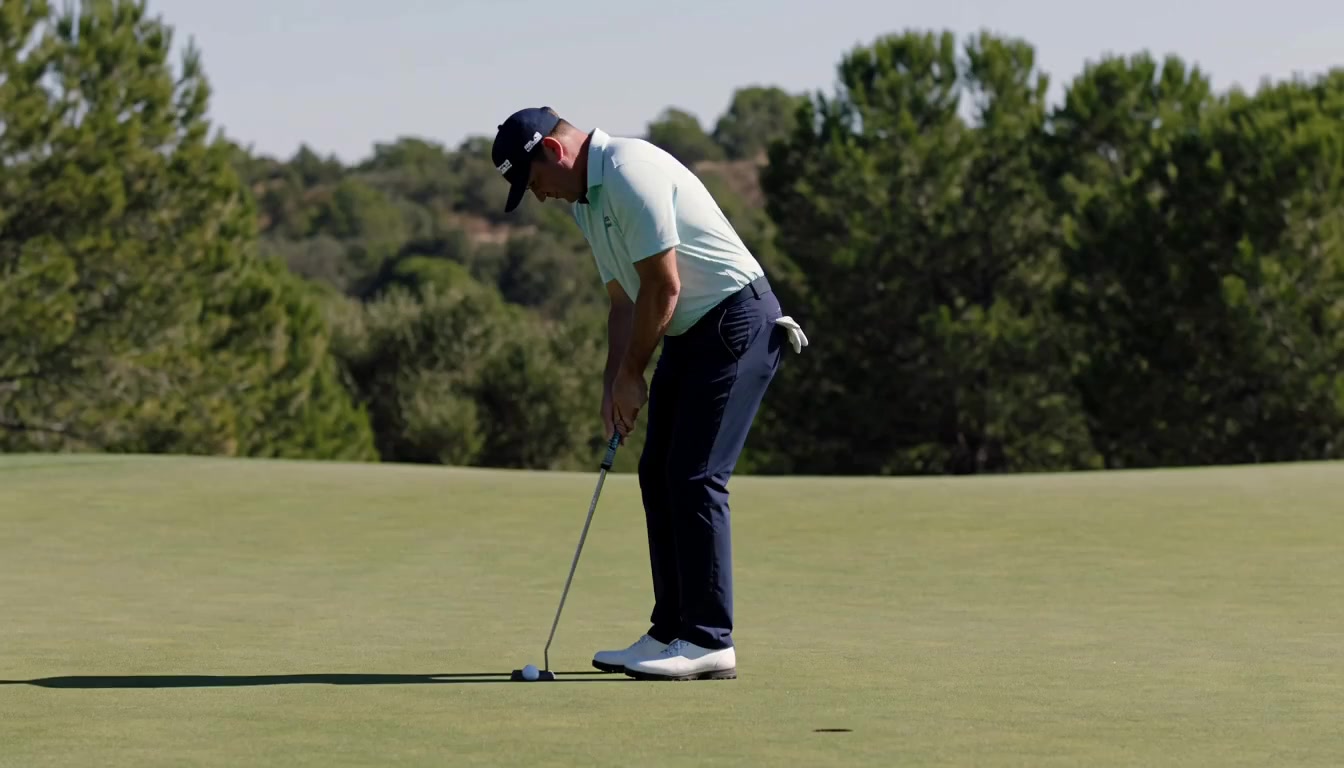 | 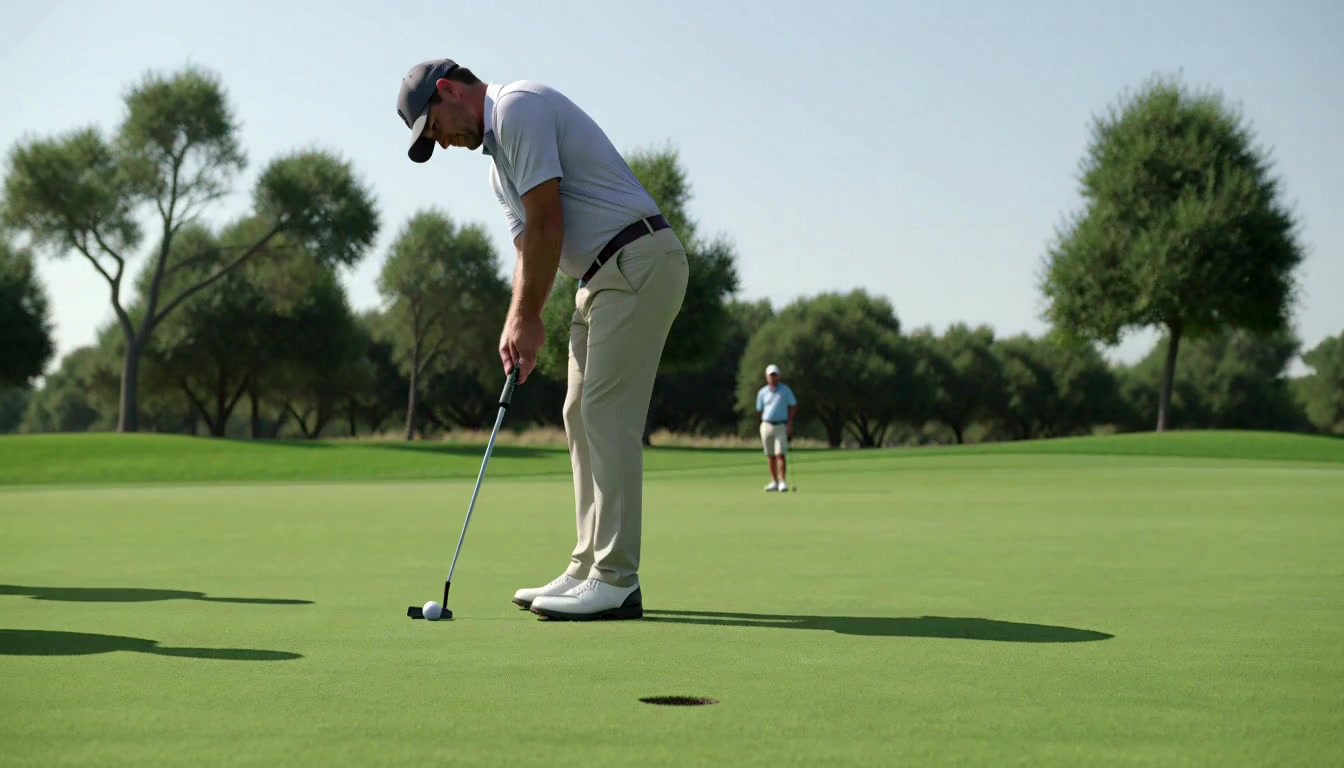 |
|---|---|
| 50스텝 MiniMax H3 교사 | 같은 프롬프트를 사용한 4스텝 DMAD 학생 |
프로젝트 페이지의 MiniMax H3 비교 그리드에서 가져온 동일 프레임입니다. 학생 모델은 50번의 모델 평가 대신 4번만 실행하면서도 구도와 피사체를 유지합니다.
DMAD가 바꾸는 것
디퓨전을 위한 소수 스텝 증류는 보통 DMD를 따릅니다. 즉 교사와 학생의 스코어 차이로 학생을 학습시키는 방식이며, 이는 학생의 변화하는 분포에 맞춰진 두 번째 디퓨전 모델을 유지해야 하고 메모리와 연산 비용을 치러야 한다는 뜻입니다. DMAD는 그 보조 모델을 제거합니다.
이 방법은 분포 매칭을 분류로 재구성합니다. 두 개의 판별기 헤드가 하나의 백본을 공유하며, 실제 샘플과 교사 샘플을 학생의 샘플과 구분하도록 학습됩니다. 그다음 판별기 로짓에 대한 선형 손실이 스코어 피팅 없이 학생을 직접 학습시킵니다. 논문은 판별기 최적점에서 이 손실들이 DMD가 의존하는 분포 매칭 그래디언트를 복원한다는 사실을, 판별기 로짓과 로그 밀도 비율을 연결하는 항등식을 사용해 보입니다.
두 번째 구성 요소인 갭 기반 재가중은 교사가 각 노이즈 레벨을 얼마나 강하게 감독하는지를 설정합니다. 고정된 스케줄을 사용하는 대신, 실제 데이터 헤드에서 실제 샘플과 교사 샘플 사이의 경험적 로짓 갭을 읽고 그로부터 가중치를 조정합니다.
공개된 내용
이번 릴리스는 이 방법의 MiniMax H3 쪽입니다. 두 개의 rank-128 LoRA가 H3 텍스트-오디오-비디오 트랜스포머에 적용되며, 각각 약 1.4 GB입니다.
| 파일 | 설명 |
|---|---|
minimax_h3/dmad_minimax_h3_4step_lora_critic.safetensors | 논문의 체크포인트: 메인 실행의 800번째 반복에서 얻은 학생의 EMA |
minimax_h3/dmad_minimax_h3_4step_full_critic.safetensors | 크리틱 백본이 LoRA로 고정되지 않고 완전히 학습된 변형. 카드에는 더 높은 AVGen-Bench 점수가 보고됩니다 |
두 어댑터 모두 rank 128과 알파 128을 가지며, 50개 트랜스포머 블록 전체와 2개 토큰 리파이너 블록의 어텐션 프로젝션 및 2개 피드포워드 레이어에 적용됩니다. 총 312개 모듈이며 Diffusers 키 레이아웃(<module>.lora.down.weight, <module>.lora.up.weight)을 따릅니다. safetensors 메타데이터에는 rank, 알파, 융합 규칙이 기록됩니다.
추론은 4스텝 텍스트-오디오-비디오 생성이며, 비디오에는 time shift 12, 오디오에는 2를 사용합니다. MiniMax H3가 이미 가이드 증류되어 있으므로 classifier-free guidance는 사용하지 않습니다. 기본 출력은 1344x768, 124프레임(24 fps에서 약 5.2초), 32 kHz 스테레오 오디오로, 학생 모델이 학습된 설정입니다.
결과
논문은 세 가지 백본에서 이 방법을 보고합니다. 이번 릴리스에서는 MiniMax H3 학생만 공개되었으며, SDXL, EDM, Wan2.1 수치는 논문 자체 실행에서 나온 것입니다.
| 백본 | 설정 | 점수 |
|---|---|---|
| SDXL | 4스텝, COCO-10K | 14.47 FID |
| Wan2.1-T2V-14B | 4스텝 | 85.15 VBench 종합 |
| MiniMax-H3-33B | 4스텝, 오디오-비디오 동시 생성 | DMD2 대비 전체 인간 선호도 79.1%, rCM 대비 84.6% (동점 제외) |
초록에서는 또한 투영 판별기를 사용한 ImageNet-64x64에서의 1스텝 생성에 대해 1.04 FID를 보고하며, 해당 지표에서 소수 스텝 학생들이 비교 대상 소수 스텝 방법과 멀티 스텝 교사를 능가한다고 밝힙니다.
ComfyUI에서 실행하기
공식 릴리스는 노드가 아니라 Diffusers를 대상으로 합니다. inference.py는 학생들이 학습된 re-noise 스텝 규칙으로 샘플링하고, run_diffusers_pipeline.py는 이를 공식 MiniMaxH3ModularPipeline에 넣습니다. 베이스 모델은 33B H3 트랜스포머와 Qwen3-VL-32B 텍스트 인코더로, 구성 요소가 약 170 GB이며, 참조 문서는 유휴 시 CPU offload를 사용하는 80 GB GPU 한 장을 권장합니다.
ComfyUI에서는 변환만 하면 어댑터가 일반 LoRA가 됩니다. Kijai는 rank를 축소한 변환본인 minimax_h3_DMAD_4step_full_lora_avg_rank_39_bf16.safetensors를 Kijai/MiniMax-H3-experimental에 공개했으므로, 커스텀 노드 없이 표준 H3 LoRA 경로로 로드됩니다. 원본 diffusers 파일의 커뮤니티 변환본도 유통되고 있으며, 두 체크포인트와 샘플러 설정이 카드와 일치해야 한다는 통상적인 주의 사항이 따릅니다.
서핑보드 위의 수달. 4스텝 MiniMax H3 학생이 생성했습니다. 비디오와 오디오는 동일한 4스텝 패스에서 나옵니다. 전체 데모 릴은 YouTube에서 볼 수 있습니다.
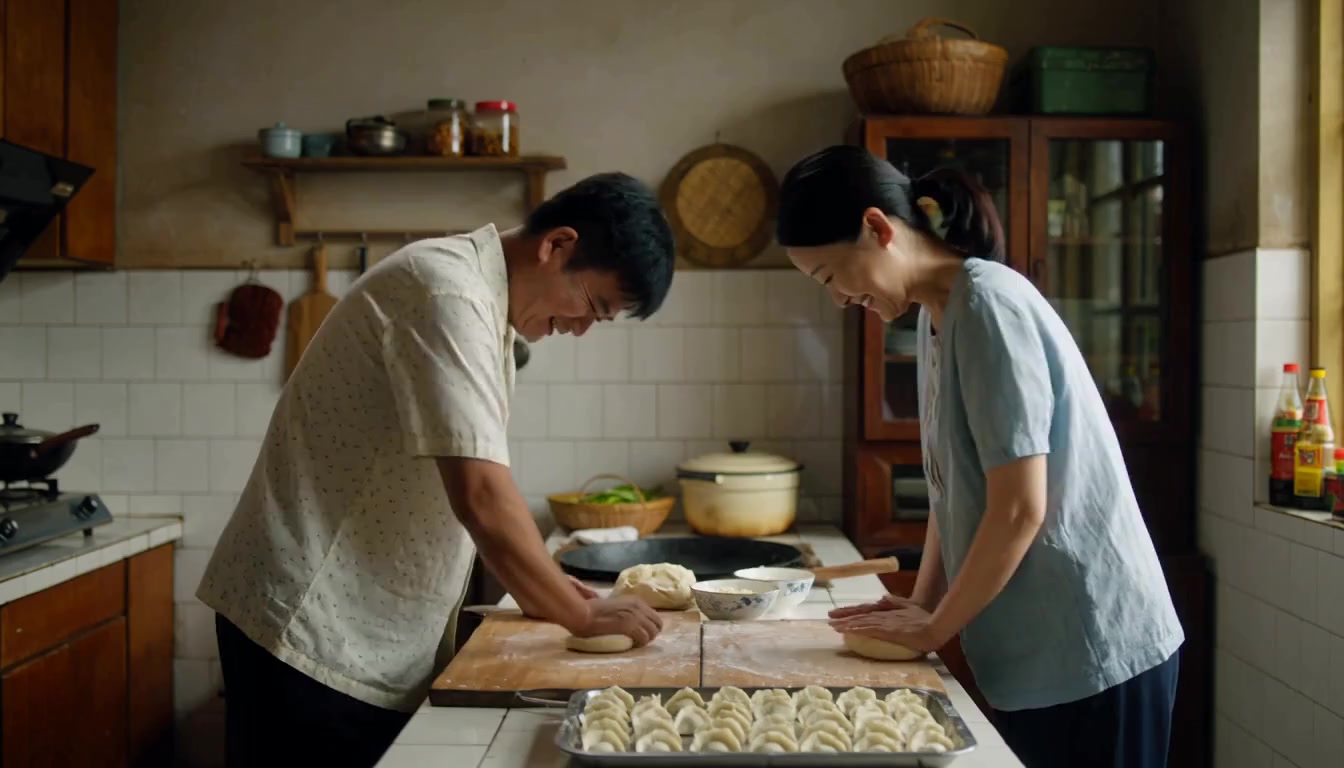 | 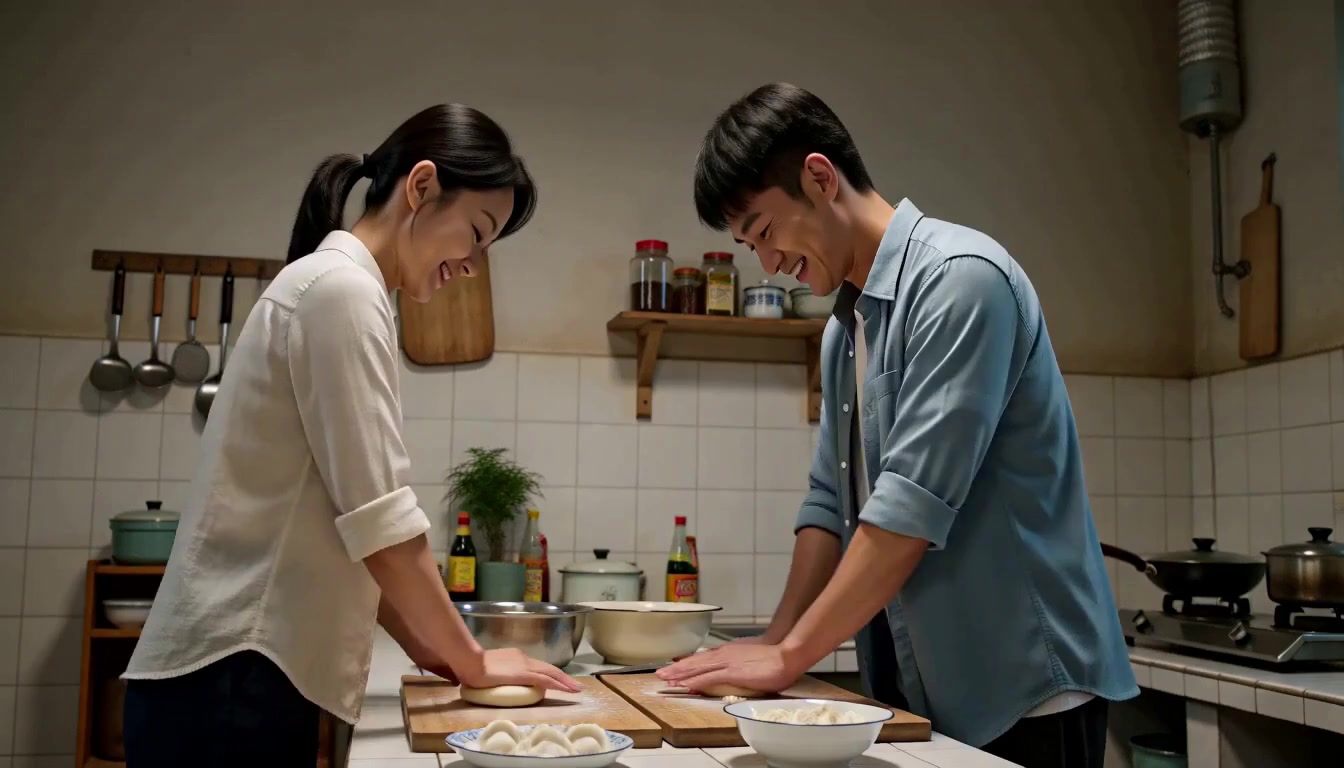 |
|---|---|
| 교사, 50스텝 | DMAD 학생, 4스텝 |
프로젝트 페이지의 MiniMax H3 그리드에서 가져온 두 번째 동일 쌍입니다.
한계
- 공개된 학생 모델은 1344x768, 124프레임, 32 kHz 스테레오 오디오로 학습되었으며, 카드에서는 이를 여러 설정 중 하나가 아니라 운용 지점으로 제시합니다.
- H3 선호도 수치는 동점을 제외하며, 비교 대상에는 이번 릴리스에서 제공되지 않는 방법들이 섞여 있으므로, SDXL과 Wan2.1의 직접 비교 수치는 공개 파일이 아니라 논문의 실행 결과입니다.
- 릴리스에 공식 노드나 워크플로 JSON이 없어 ComfyUI 지원은 커뮤니티 변환본에 의존하며, 그 rank 축소와 키 레이아웃은 논문이 평가한 것과 다릅니다.
- 전체 H3 스택은 큽니다(33B 트랜스포머와 32B 텍스트 인코더). 따라서 4스텝은 모델을 담는 데 필요한 메모리가 아니라 샘플링 비용을 줄여줍니다.
이용 가능
프로젝트 페이지: yzmblog.github.io/projects/DMAD
논문: arXiv 2610.02188
코드: Yzmblog/DMAD
가중치: ZhengmingYu/DMAD
데모 비디오: YouTube
ComfyUI 변환: Kijai/MiniMax-H3-experimental
베이스 모델: MiniMaxAI/MiniMax-H3
댓글
GitHub로 로그인하고 토론에 참여하세요.