MiniMax H3 X2 Detail VAE: 2-in-1 업스케일 및 디테일 릴리스
MiniMax H3를 위한 실험적 2-in-1 릴리스입니다. 2X 비디오 VAE와 레퍼런스 디테일 향상 노드를 제공하며, 검증된 ComfyUI 워크플로와 네거티브 결과 분석 글을 함께 담았습니다.
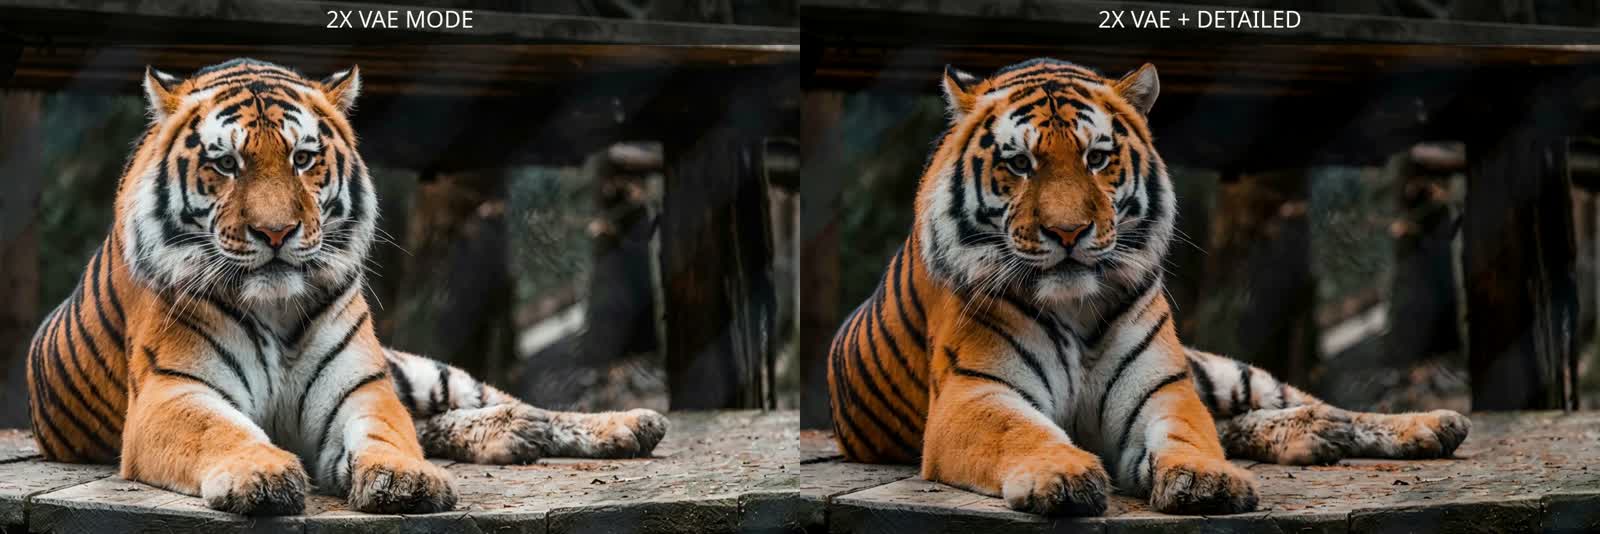
릴리스의 비교 클립 프레임: 한쪽은 일반 2X VAE 디코드, 다른 쪽은 동일한 잠재 데이터에 디테일 향상 경로를 적용한 결과입니다.
하나의 파일에 담긴 두 가지 도구
위키에 있는 대부분의 H3 VAE 작업은 디코드를 더 빠르게 만드는 것이었습니다. 이 릴리스는 반대 방향으로, 디코드를 더 선명하게 만들 수 있는지 묻고, 그 탐색에서 살아남은 결과를 공개합니다. 동일한 체크포인트 MiniMax-H3-X2-Detail-v1.safetensors는 두 가지 방식으로 사용됩니다:
| 모드 | 입력 | 기능 | 커스텀 노드 필요 여부 |
|---|---|---|---|
| 2X VAE | H3 비디오 잠재 데이터 | 패킹된 12채널 출력과 PixelShuffle을 통해 두 배 공간 해상도로 디코딩 | 예, 고속 디코드 노드에만 필요 |
| 디테일 향상기 | RGB 레퍼런스 이미지 | 레퍼런스 기반 비디오 생성 이전에 인코더 초기 탭에서 추가 공간 구조를 재구성 | 예, 릴리스에 포함됨 |
두 모드는 서로 바꿔 쓸 수 없습니다. 2X 경로는 생성된 잠재 데이터에 작동하며 레퍼런스 이미지가 필요 없습니다. 디테일 경로는 기존 RGB 이미지가 필요합니다. 사용하는 추가 정보가 일반 잠재 데이터 병목 이전의 H3 인코더에서 추출되기 때문입니다.
모드 1: 2X VAE 디코드
체크포인트를 ComfyUI/models/vae/에 넣고 표준 VAE 로드 노드에서 선택합니다. 실제 디코드에는 ComfyUI의 일반 VAE Decode 노드를 TripleHeadedMonkey/ComfyUI-MiniMaxH3_LatentUpscaler의 MiniMax H3 VAE Decode (fast) 노드로 교체합니다. 이 노드가 패킹된 출력을 전체 해상도 RGB로 변환합니다.
H3 video latent
   ↓
MiniMax H3 VAE Decode (fast)   ← MiniMax-H3-X2-Detail-v1
   ↓
packed 12-channel X2 decode
   ↓
PixelShuffle ×2
   ↓
2X RGB / video frames
이 워크플로에는 검증된 시작 설정이 포함되어 있습니다: tiling = true, tile_size = 256, tile_overlap = 64, output_device = cpu, temporal_tiling = false.
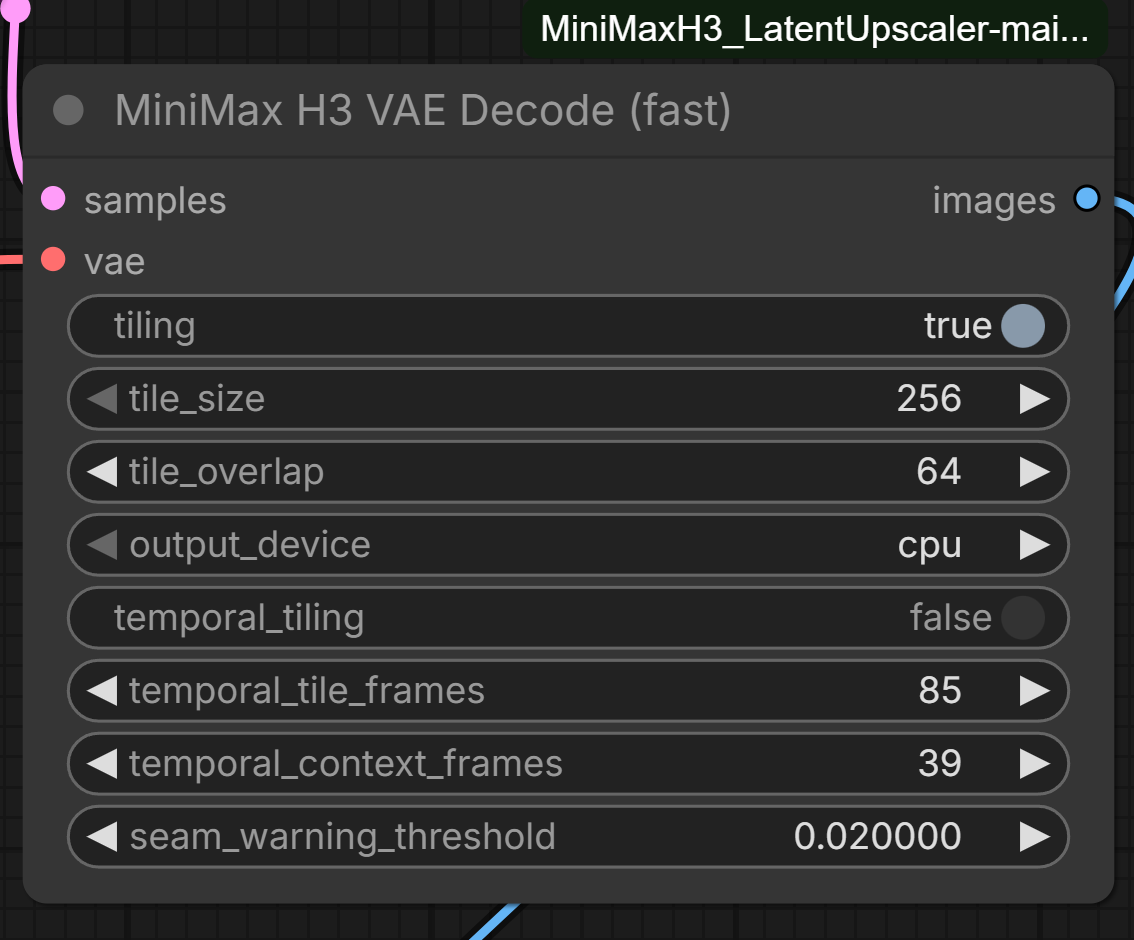
릴리스 README에 나온 필수 MiniMax H3 VAE Decode (fast) 노드입니다.
모드 2: 레퍼런스 디테일 향상
이미지 레퍼런스 워크플로에서는 동일한 체크포인트를 MiniMax H3 VAE 2X (Detailed Upscale) 안에서 두 번째로 로드합니다. 이 노드는 ComfyUI-H3-X2-Detailed.zip으로 묶여 제공되는 작은 커스텀 노드입니다. 소스 이미지와 MiniMax H3 참조 → 비디오 사이에 위치하며, detail_strength = 1.0이 테스트된 기준값입니다. 최종 비디오 디코드는 동일한 X2 VAE를 사용하는 MiniMax H3 VAE Decode (fast)를 통해 여전히 수행됩니다.
예시 워크플로
릴리스에는 두 역할을 동시에 보여주는 2-in-1 그래프가 포함되어 있습니다. 디테일 노드가 레퍼런스 기반 비디오 생성 전에 RGB 레퍼런스를 향상하고, 생성된 H3 잠재 데이터는 마지막에 MiniMax H3 VAE Decode (fast)를 통해 디코딩됩니다.
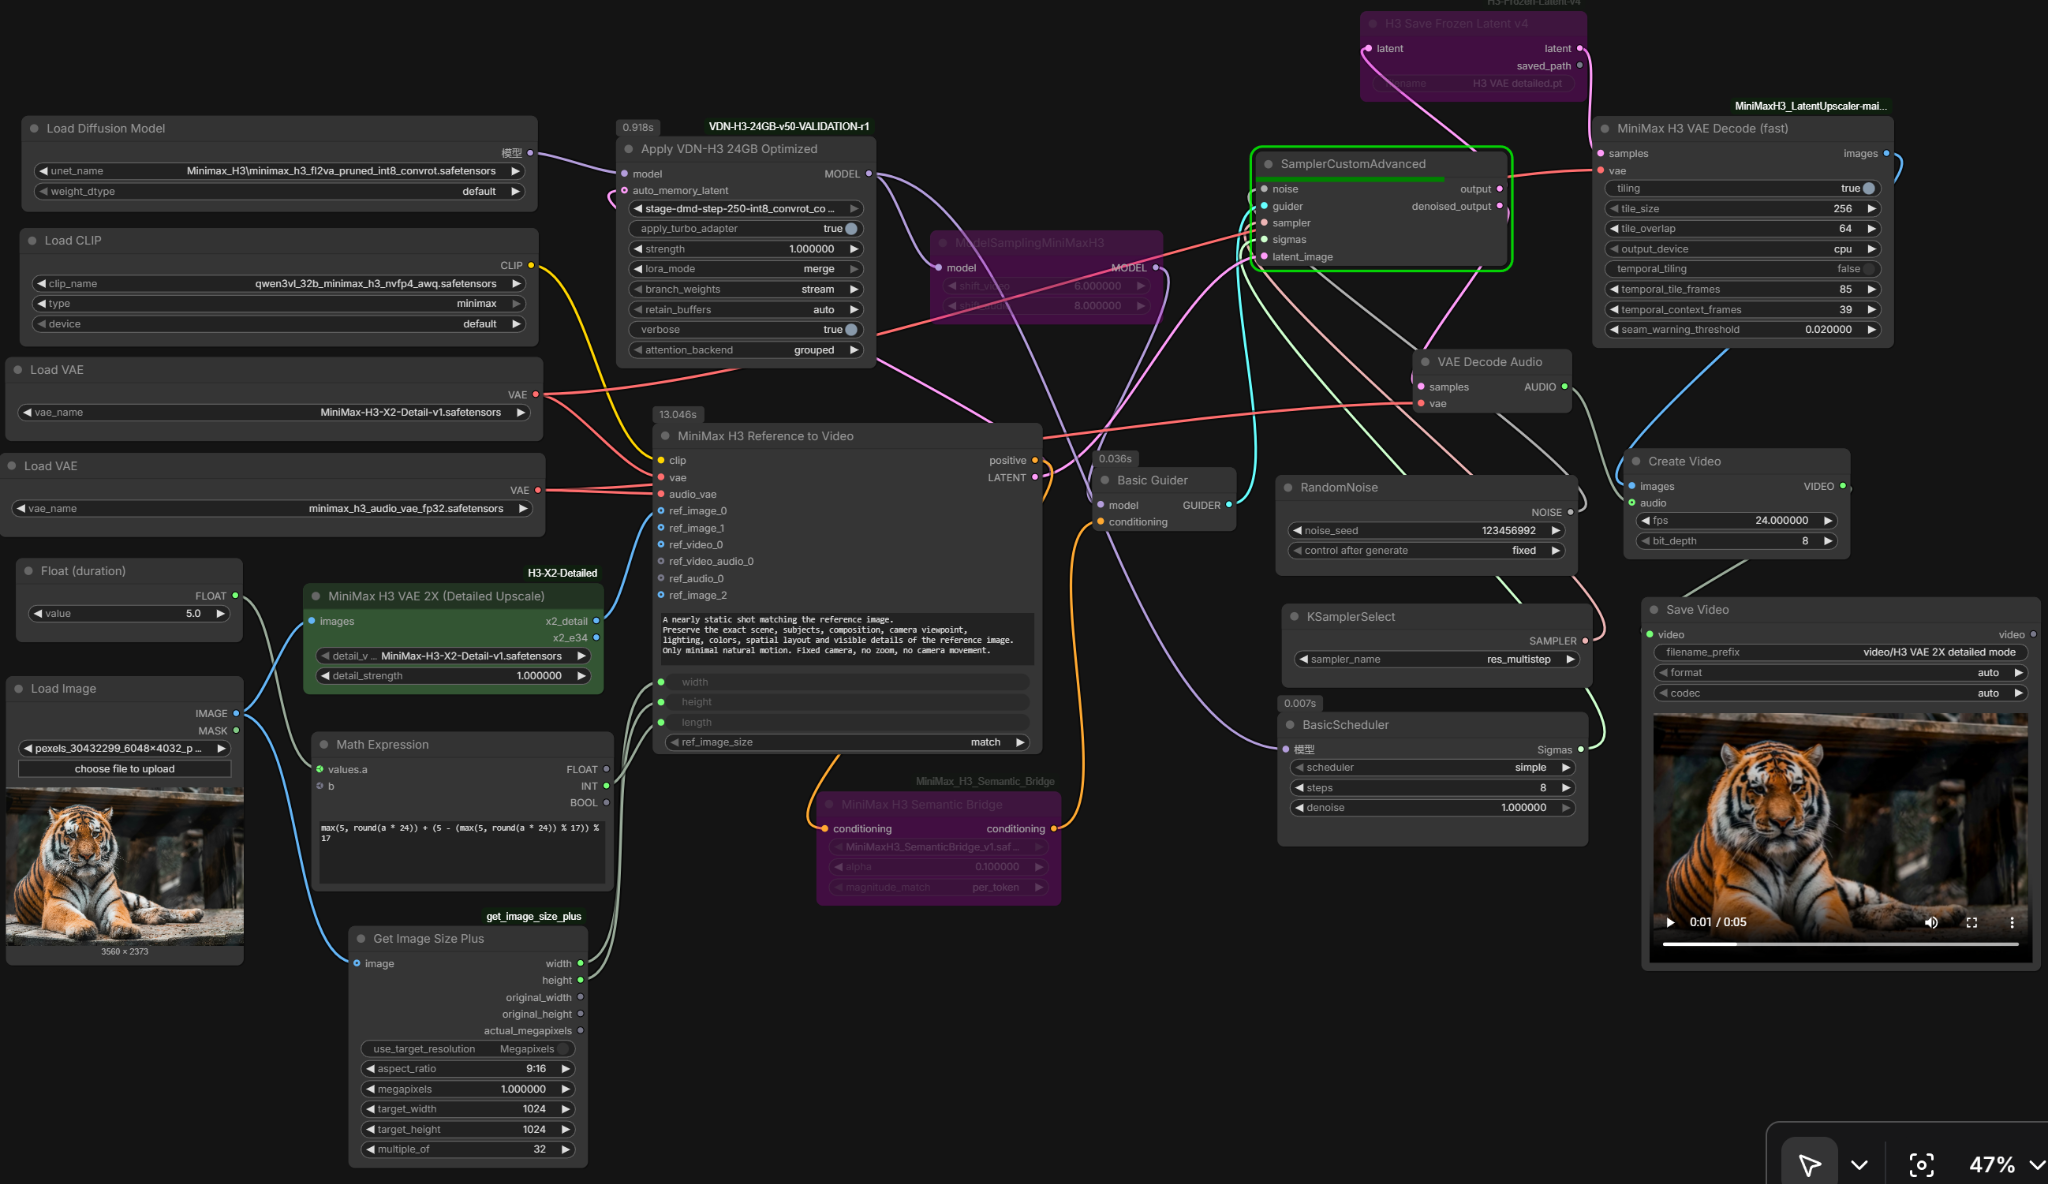
모델 카드에 있는 완전한 2-in-1 워크플로 스크린샷입니다.
직접 비교
아래 두 클립은 동일한 모델의 두 가지 공개 모드를 같은 생성 설정으로 실행한 것입니다. 왼쪽은 2X VAE 단독이고, 오른쪽은 2X VAE에 디테일 경로를 더한 것으로, 여기서는 레퍼런스가 먼저 B32 디테일 브랜치를 거칩니다.
비교 01: 2X VAE 디코드와 디테일 향상 경로를 더한 2X VAE.
비교 02: 두 번째 클립에서의 동일한 두 모드.
왜 "HQ VAE"는 없는가
이 글은 결과에 대해 이례적으로 솔직합니다. 출발점은 이미 작동하는 H3 2X VAE였지만, 더 커진 출력이 그에 비례해 더 많은 실제 디테일을 담지는 못했습니다. 그래서 프로젝트는 추가된 픽셀에 의미를 부여하는 것을 목표로 삼았습니다. 디코더 측 블록, 디테일 대상 손실, 잠재 데이터의 "디테일 방향", 더 강력한 점진적 디코더는 모두 실패했고, 그중 몇 가지는 수치상 손실을 개선하면서도 가장자리 헤일로, 판화 같은 구조, 혹은 눈에 보이는 변화가 전혀 없는 결과를 낳았습니다.
분명하게 효과가 있었던 단 하나의 브랜치는 고정된 H3 인코더의 down.1.block.1에서 압축된 32채널 표현을 가져왔고, 10개의 홀드아웃 프레임 모두에서 RMSE, HP3, 그래디언트 지표를 개선했습니다. 또한 이는 잠재 데이터 병목 이전의 원본 RGB 이미지에서 나온 것으로, H3가 텍스트 기반 비디오 생성 중에 새로운 잠재 데이터를 만들 때는 존재하지 않는 정보입니다. 작성자의 결론은 좁고 명확합니다. 디테일 향상은 표준적으로 생성된 H3 잠재 데이터만으로는 재현할 수 없으므로, 프로젝트가 목표로 삼았던 잠재 데이터 전용 드롭인 VAE가 될 수 없었습니다. 남은 것은 실험적인 2-in-1 도구이지, 해결된 병목이 아닙니다.
요구 사항 및 파일
MiniMax-H3-X2-Detail-v1.safetensors체크포인트(5.2 GB)는ComfyUI/models/vae/에 넣습니다.- ComfyUI-MiniMaxH3_LatentUpscaler는
MiniMax H3 VAE Decode (fast)를 제공하며 2X 워크플로에 필요합니다. ComfyUI-H3-X2-Detailed.zip은 레퍼런스 경로용 선택적MiniMax H3 VAE 2X (Detailed Upscale)노드를 추가합니다.H3_VAE_Detailed_and_2X_VAE_2in1.json은 예시 워크플로입니다.
공개 정보
가중치 및 에셋: speach1sdef178/MiniMax-H3-X2-Detail-VAE
ComfyUI 파일: models/vae/의 MiniMax-H3-X2-Detail-v1.safetensors
필수 노드 팩: TripleHeadedMonkey/ComfyUI-MiniMaxH3_LatentUpscaler
베이스 모델: MiniMaxAI/MiniMax-H3
댓글
GitHub로 로그인하고 토론에 참여하세요.