Viggle Turbo v0.3: ComfyUI에서 Qwen-Image 2.1을 6스텝과 9스텝으로 실행하는 방법
Viggle의 Qwen-Image 2.1 v0.3 증류 모델은 9스텝 모드를 추가하고, 6스텝 생성 및 편집을 위한 공식 ComfyUI 노드와 워크플로, 병합된 단일 파일 가중치를 제공합니다.
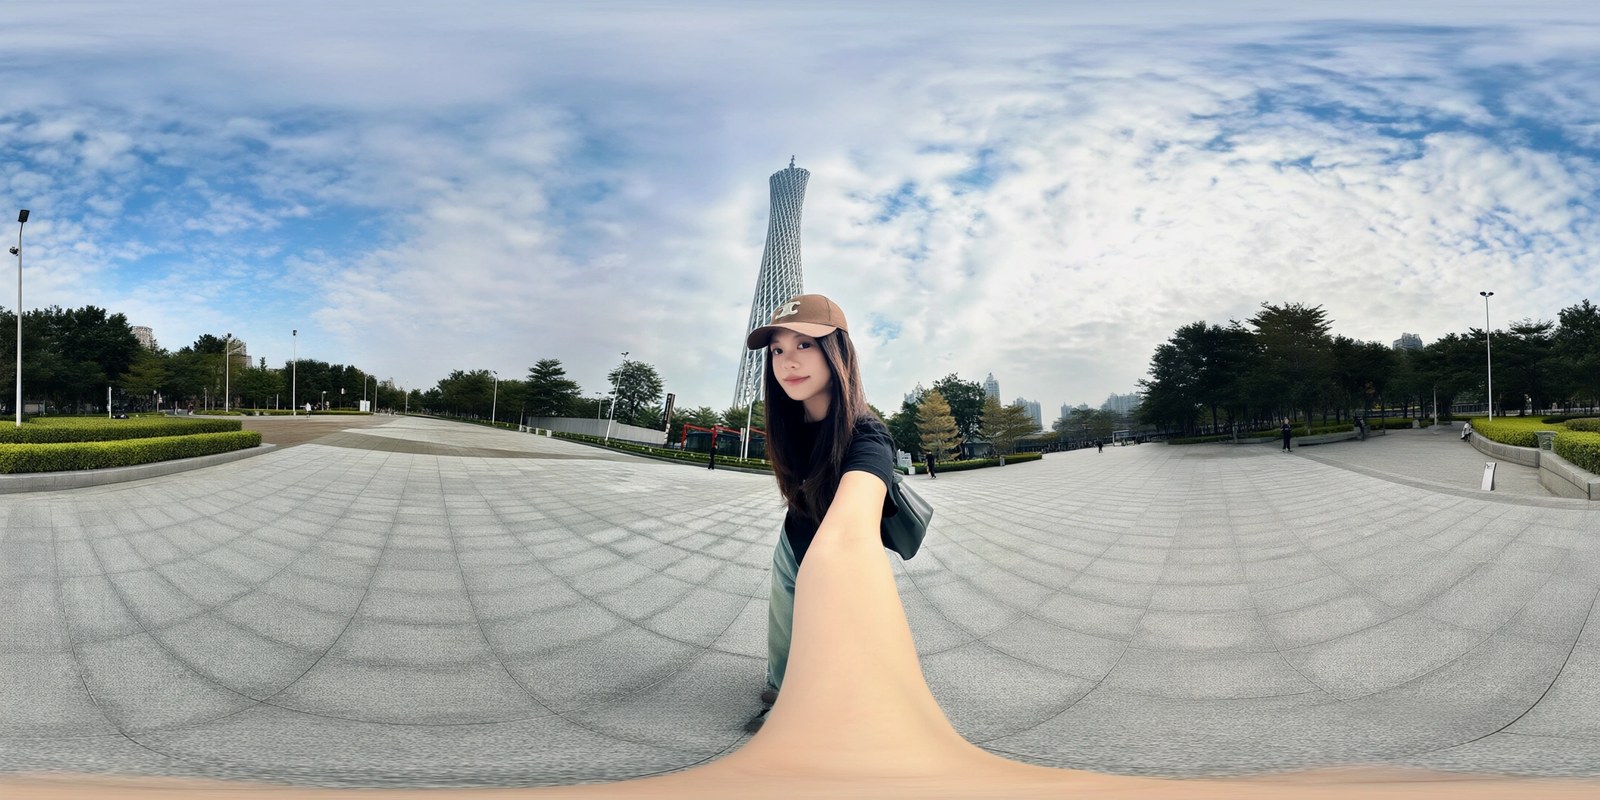
하나의 원근법 사진으로 만든 360도 등장방형 파노라마로, v0.3가 2176x1088 해상도에서 9스텝으로 생성했습니다. 출처: Viggle 데모 Space의 비교 탭.
v0.3에서 달라진 점
증류 방식 자체는 변하지 않았습니다. 베이스 Qwen-Image 2.1 트랜스포머에 적용한 rank-256 LoRA이며, true_cfg_scale=1.0과 네거티브 프롬프트 없이 고정된 시그마 스케줄로 샘플링합니다. v0.3는 방법이 아니라 균형을 옮긴 버전입니다.
- 6스텝, 재조정. v0.2.1과 비교하면 결과의 입자감이 줄고 평탄한 표면이 더 깨끗해졌지만, 미세한 텍스처는 다소 부드러워졌습니다. Viggle은 이것이 엄격한 업그레이드가 아니라고 분명히 밝힙니다. 더 선명한 v0.2.1의 느낌을 선호했다면 그 어댑터는 저장소에 그대로 남아 있습니다.
- 새로운 9스텝 모드. 7번의 turbo 스텝을 거친 뒤 LoRA를 끄고 수정되지 않은 베이스 모델이 마지막 두 스텝을 마무리합니다. 디테일이 더 정교하고 작은 렌더링 텍스트가 제대로 나올 확률이 더 높습니다. 6스텝보다 약 1.4~1.5배 오래 걸리지만, 여전히 40스텝 베이스보다 약 3.5배 빠릅니다.
- 명시된 한계. Viggle은 6스텝이 이 student 모델이 할 수 있는 것에 거의 근접했다고 밝힙니다. v0.2.1 이후 찾아낸 모든 개선은 무언가를 맞바꾼 것이며, 더 선명해지면 입자감이 늘고 입자감이 줄면 더 부드러운 느낌이 됩니다. 그 지점을 넘어서는 품질은 스텝으로 지불해야 하며, 그것이 바로 9스텝 모드가 하는 일입니다.
9스텝 모드
9스텝 경로는 단순히 더 긴 스케줄이 아닙니다. 파이프라인은 텍스트와 참조 K/V를 한 번 계산해 재사용하는데, 7번의 turbo 스텝이 그 캐시를 채우므로 LoRA가 비활성화되고 베이스가 넘겨받기 전에 첫 베이스 모델 스텝이 이를 다시 계산해야 합니다. diffusers에서는 이것이 스텝 콜백과 transformer forward를 감싸는 래퍼를 의미하며, 둘 모두 모델 카드에 나와 있습니다:
SIGMAS_9 = [1.0, 0.9583, 0.9167, 0.875, 0.75, 0.5, 0.25, 1 / 6, 1 / 12]6스텝 스케줄은 저노이즈 노드 0.875, 0.75, 0.5, 0.25를 유지하고 고노이즈 쪽에만 스텝을 추가합니다. 5스텝은 [1, 0.875, 0.75, 0.5, 0.25], 7스텝은 [1, 0.9583, 0.9167, 0.875, 0.75, 0.5, 0.25]입니다. 대신 저노이즈 노드를 옮기면 결과가 더 부드러워지고, 시그마 목록 없이 스텝 수만 전달하는 방식은 작동하지 않습니다.
9스텝은 현재 diffusers와 데모 Space에서만 실행됩니다. ComfyUI 워크플로는 6스텝 스케줄을 구현합니다.
공식 ComfyUI 지원
이것이 v0.2에 없던 부분입니다. 이번 릴리스에는 모델 저장소의 comfyui/ 폴더에 ComfyUI 포트가 포함되어 있으며, Qwen-Image 2.1을 네이티브로 지원하는 ComfyUI 0.37.0에서 테스트되었습니다:
- **
viggle_turbo.py**는 두 개의 노드를 추가합니다. 이 파일을ComfyUI/custom_nodes/에 복사하고 재시작하세요. - **
Viggle Turbo Sigmas**는 파이프라인의 해상도 의존 시프트가 적용된 6스텝 스케줄을 제공하며, KSampler scheduler 대신 euler와BasicGuider와 함께 사용하고 CFG와 네거티브 프롬프트는 사용하지 않습니다. - **
Viggle Turbo LoRA (unmerged)**는 diffusers가 하는 방식으로 런타임에 어댑터를 적용합니다. 기본 LoRA 로더는 이를 가중치에 병합하는데, Viggle의 측정에 따르면 bf16에서는 이 어댑터 업데이트의 약 30%가 손실되고 int8에서는 노이즈가 추가됩니다. unmerged 노드는 스텝당 10~25% 더 많은 시간이 걸립니다. - 텍스트 기반 이미지 생성 및 편집용 워크플로와, 병합된 단일 파일 가중치 및 GGUF용 변형도 포함됩니다.
int8 기본값에 r128 LoRA와 프롬프트 향상 기능을 켠 상태에서 워크플로는 1248x832에서 약 26GB의 VRAM을 최대로 사용합니다. 모델 카드는 또한 ComfyUI 포트가 대부분 AI 코딩 어시스턴트로 작성되었기 때문에 거친 부분이 있을 수 있으며 수정을 환영한다고 밝히고 있습니다.
병합된 단일 파일 트랜스포머
LoRA를 아예 로드하고 싶지 않다면, v0.3는 rank-256 어댑터를 fp32로 미리 병합한 뒤 한 번 양자화한 베이스 트랜스포머도 제공합니다. 파일은 models/diffusion_models/에 넣습니다. GGUF 버전은 ComfyUI-GGUF가 필요하며, 모든 경로에서 커스텀 노드의 Viggle Turbo Sigmas가 여전히 필요합니다. 이 방식으로는 6스텝 모드만 사용할 수 있습니다.
| 형식 | 크기 | ComfyUI 로더 | LPIPS v0.3 | LPIPS v0.2.1 |
|---|---|---|---|---|
| GGUF Q8_0 | 7.7 GB | Unet Loader (GGUF) | 0.051 | 0.054 |
| int8, Comfy-Org convrot 레시피 | 7.3 GB | 확산 모델 로드 | 0.057 | 0.060 |
| GGUF Q6_K | 6.0 GB | Unet Loader (GGUF) | 0.055 | 0.067 |
| fp8 e4m3fn, 가중치 전용 | 7.3 GB | 확산 모델 로드 | 0.068 | 0.070 |
| GGUF Q5_K_M | 5.1 GB | Unet Loader (GGUF) | 0.076 | 0.083 |
| GGUF Q4_K_M | 4.3 GB | Unet Loader (GGUF) | 0.100 | 0.118 |
| int8 + r128 LoRA (LoRA 워크플로) | 8.0 GB | 확산 모델 로드 | 0.041 | 0.044 |
LPIPS는 동일한 프롬프트, 입력, 시드, 노이즈를 사용한 96개의 홀드아웃 요청에 대해, rank-256 LoRA를 실행하는 diffusers를 기준으로 측정한 Viggle의 평균 VGG 거리입니다. 값이 낮을수록 더 가깝습니다. 참고로 LoRA를 로드하지 않은 상태에서 ComfyUI와 diffusers의 차이는 약 0.03~0.04입니다.
병합된 가중치는 LoRA 경로와 비슷하지만 완전히 동일하지는 않습니다. 96개 요청 중 약 8개에서 병합된 int8 또는 Q8_0 빌드가 다른 구도나 의상을 만들어내며, LoRA 워크플로는 35개입니다. Q4_K_M은 96개 중 2329개로 눈에 띄게 더 많이 흔들리며, Viggle은 메모리에 더 큰 것이 들어가지 않을 때만 이를 권장합니다.
40스텝 베이스와 6스텝·9스텝 비교
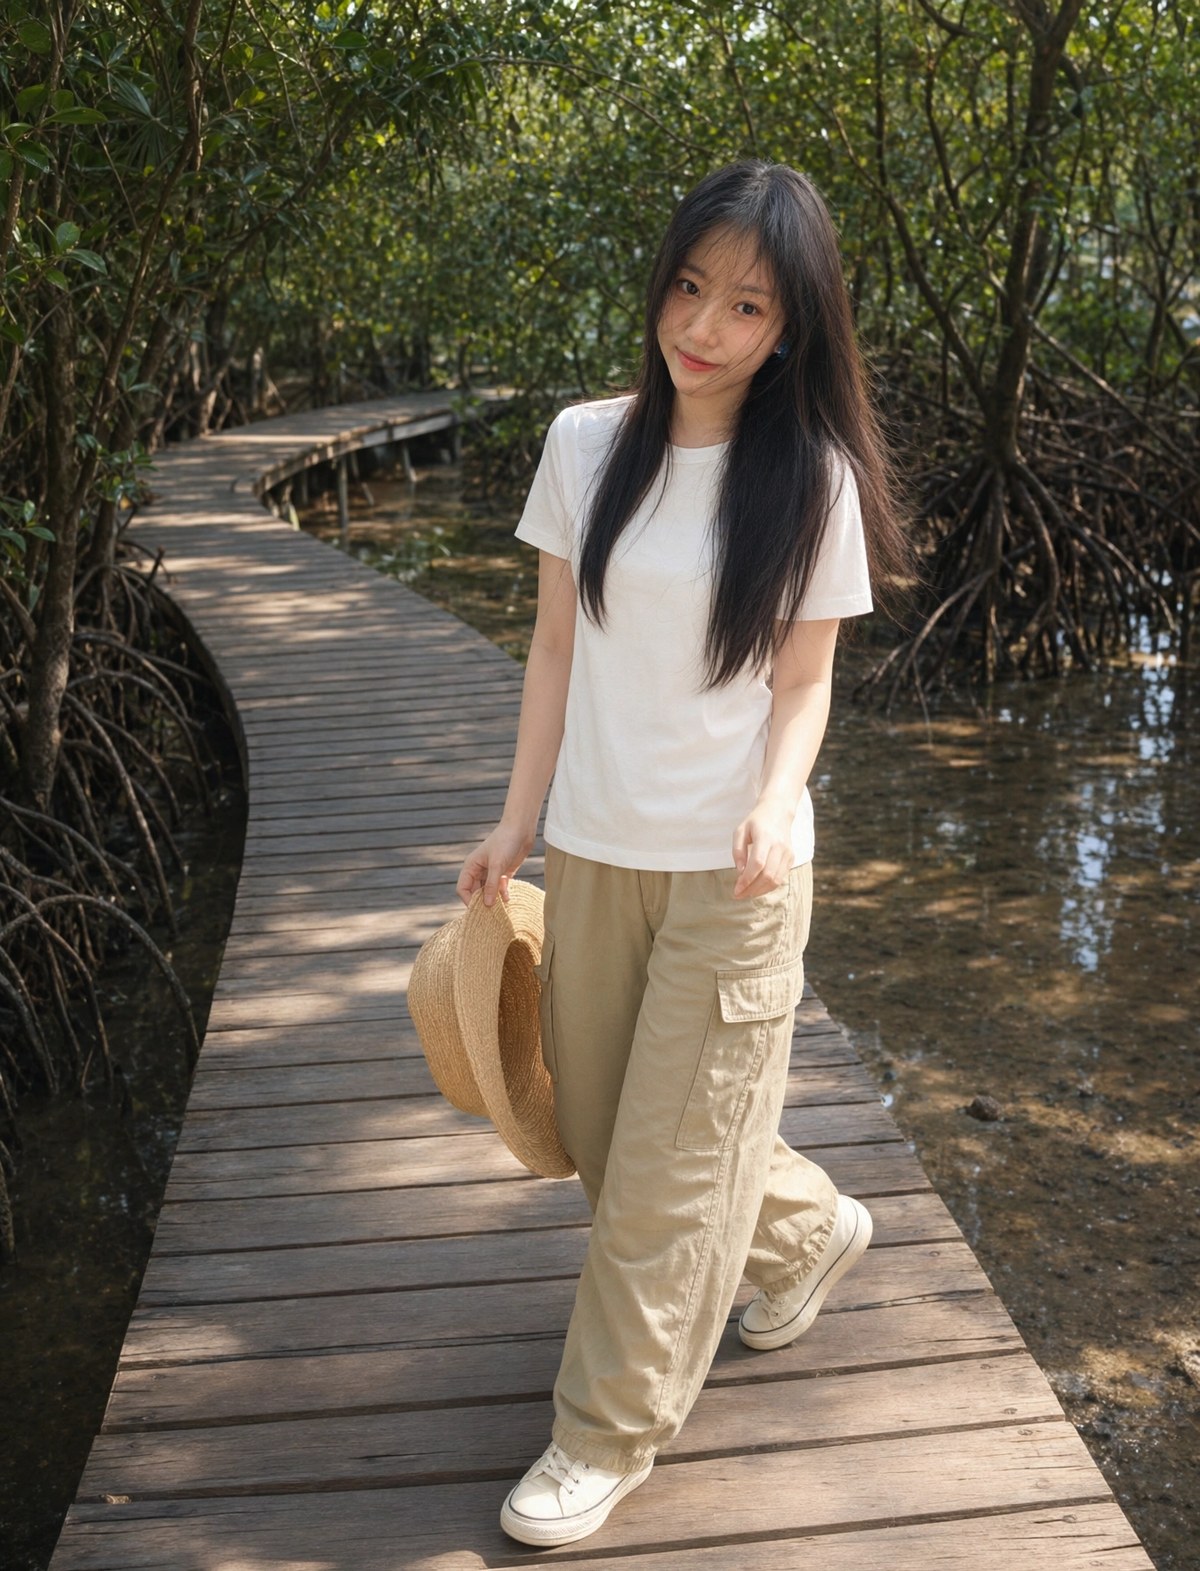
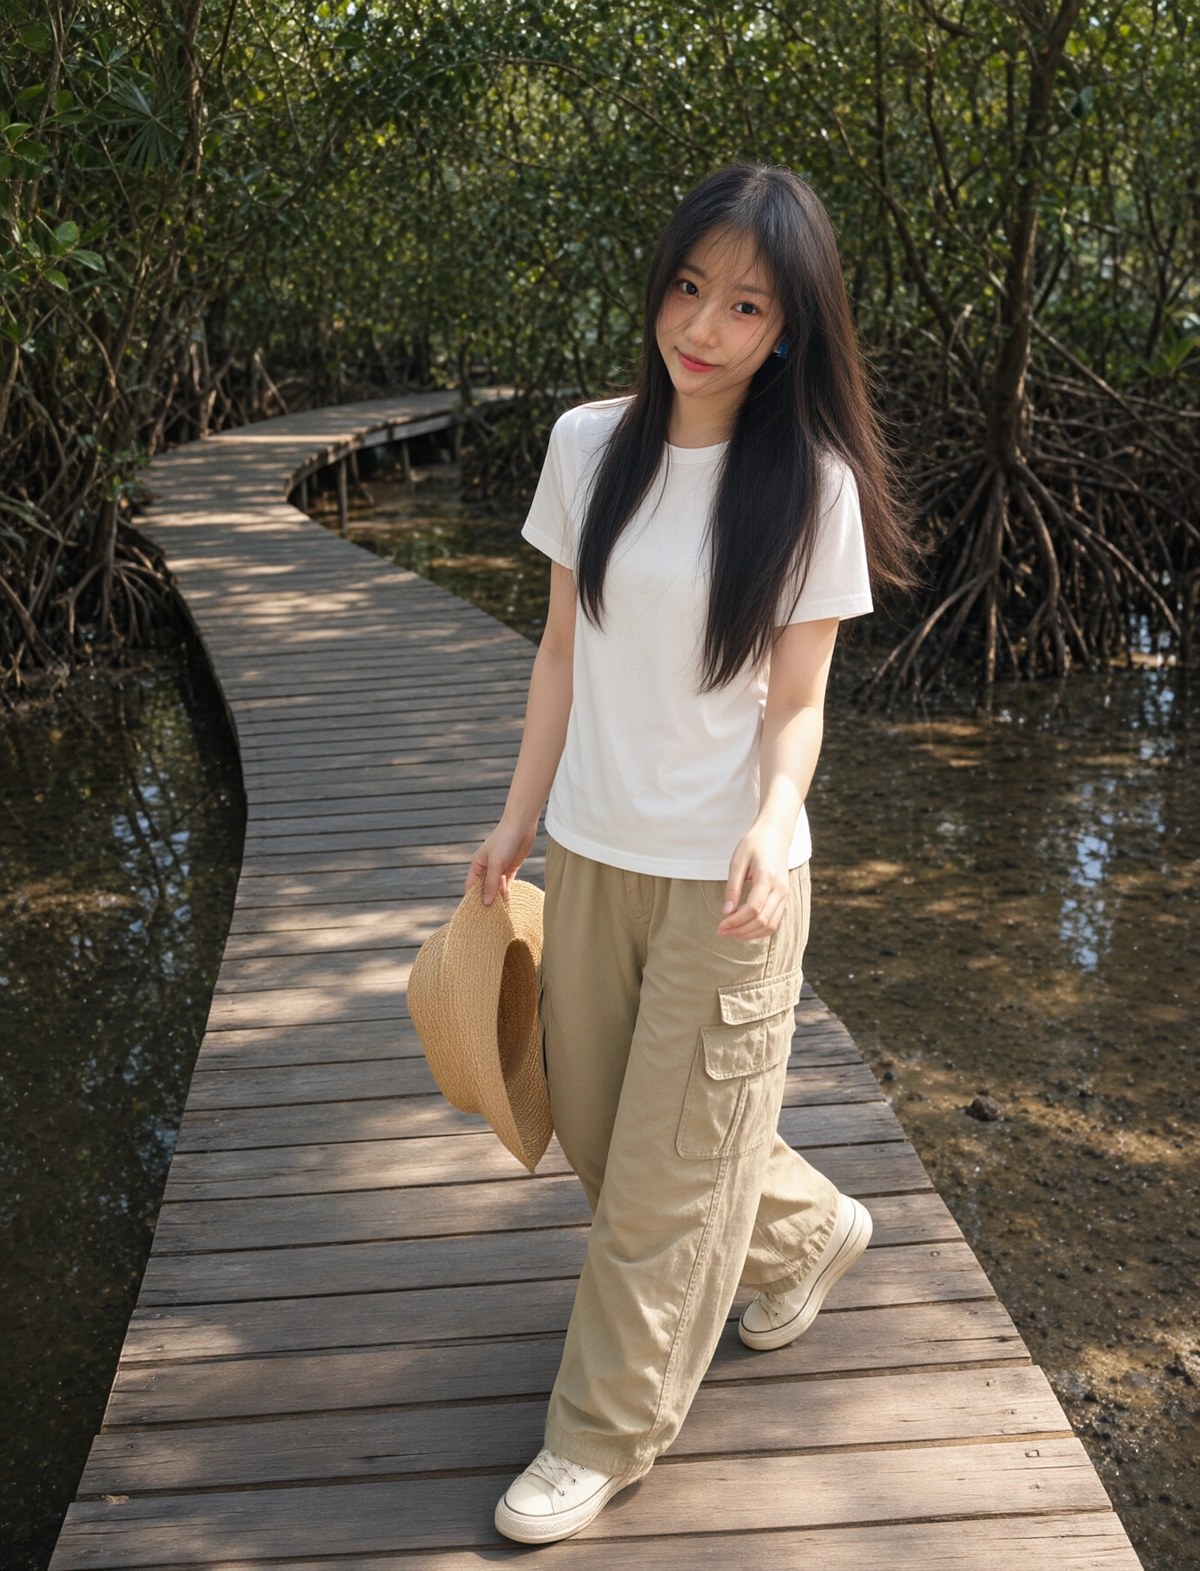
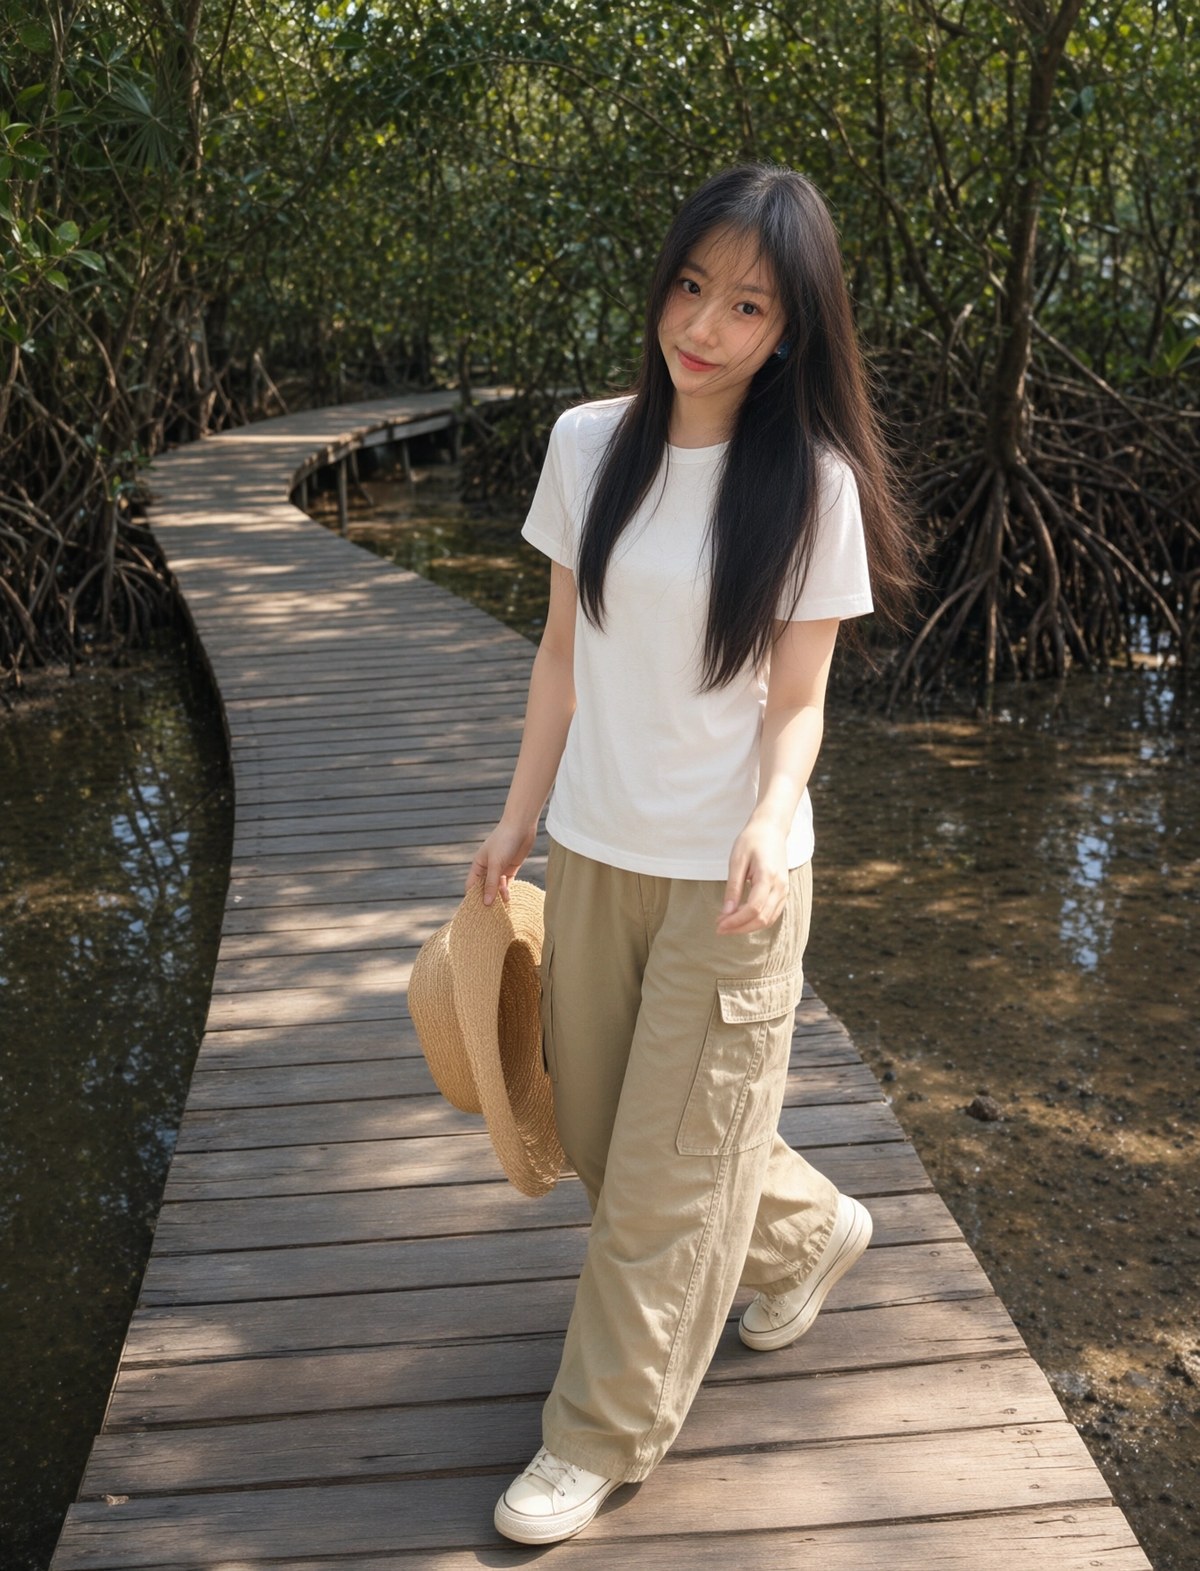
아래 예시는 Viggle 자체 데모 Space의 비교 탭에서 가져온 것입니다. 모든 열은 동일한 프롬프트, 입력, 시드, 노이즈를 사용합니다.
 |  |  |
|---|---|---|
| 베이스 모델, 40스텝 | v0.3, 6스텝 | v0.3, 9스텝 |
캐릭터 참조를 맹그로브 보드워크 장면으로 옮긴 1344x1760 결과. 6스텝 결과가 두 turbo 열 중 가장 깔끔하며, 9스텝은 미세한 텍스처 일부를 되살립니다.
9스텝 모드는 6스텝 student가 여전히 베이스 모델에 뒤지는 두 가지, 즉 빽빽한 렌더링 텍스트와 작은 디테일을 겨냥합니다. 작은 인터페이스 텍스트가 많은 1536x2720 수직 앱 스크린샷은 적절한 스트레스 테스트이며, 비교 탭에서 이 테스트를 실행합니다.
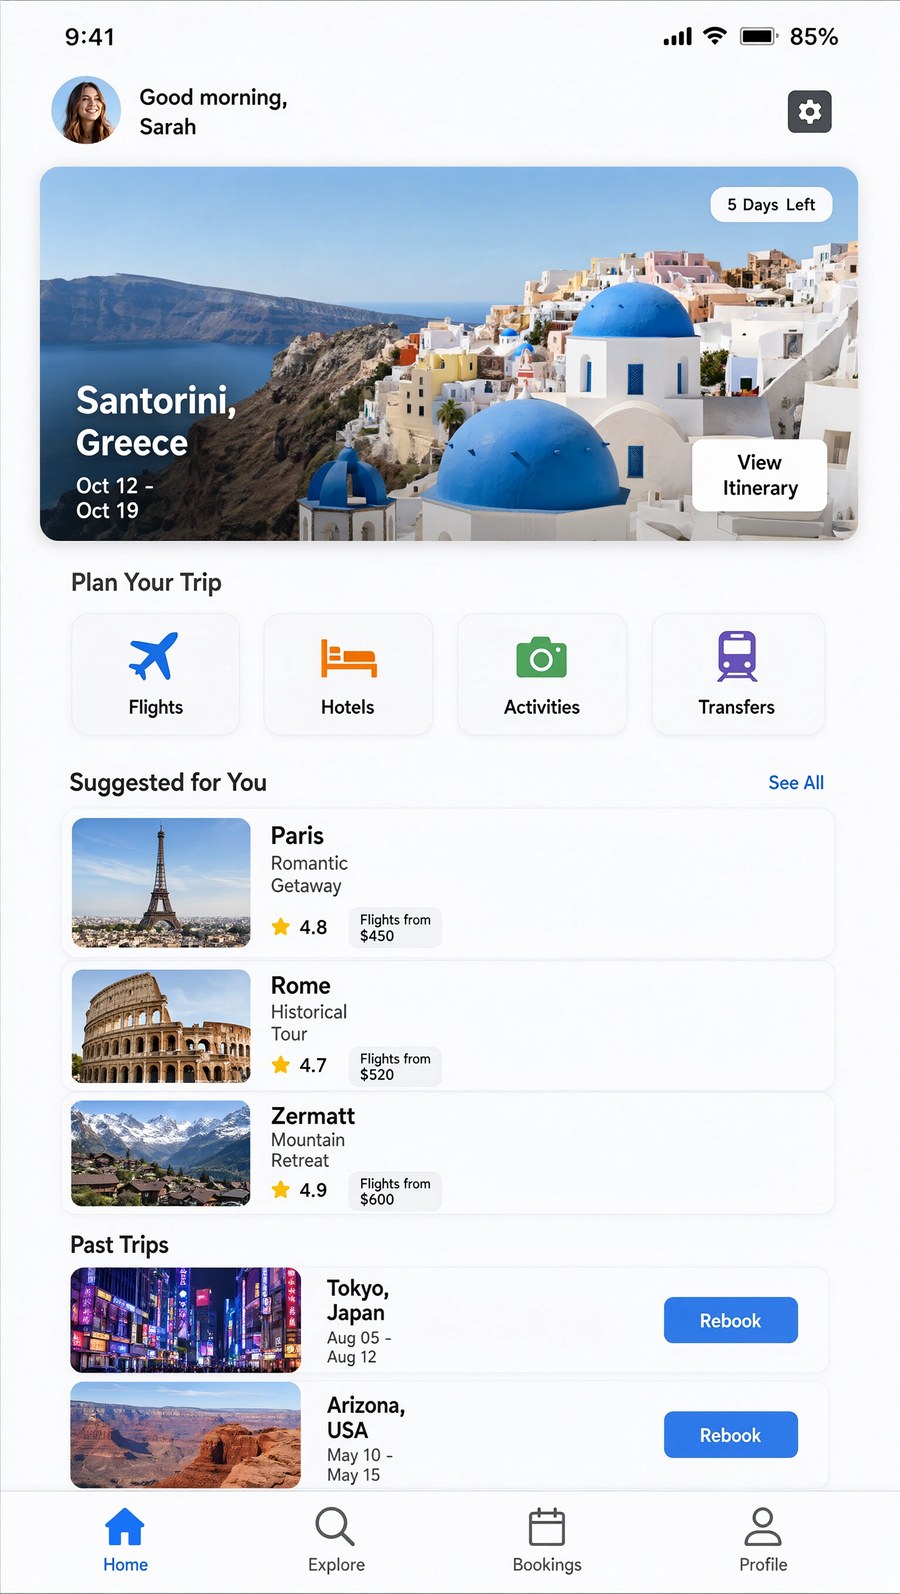 | 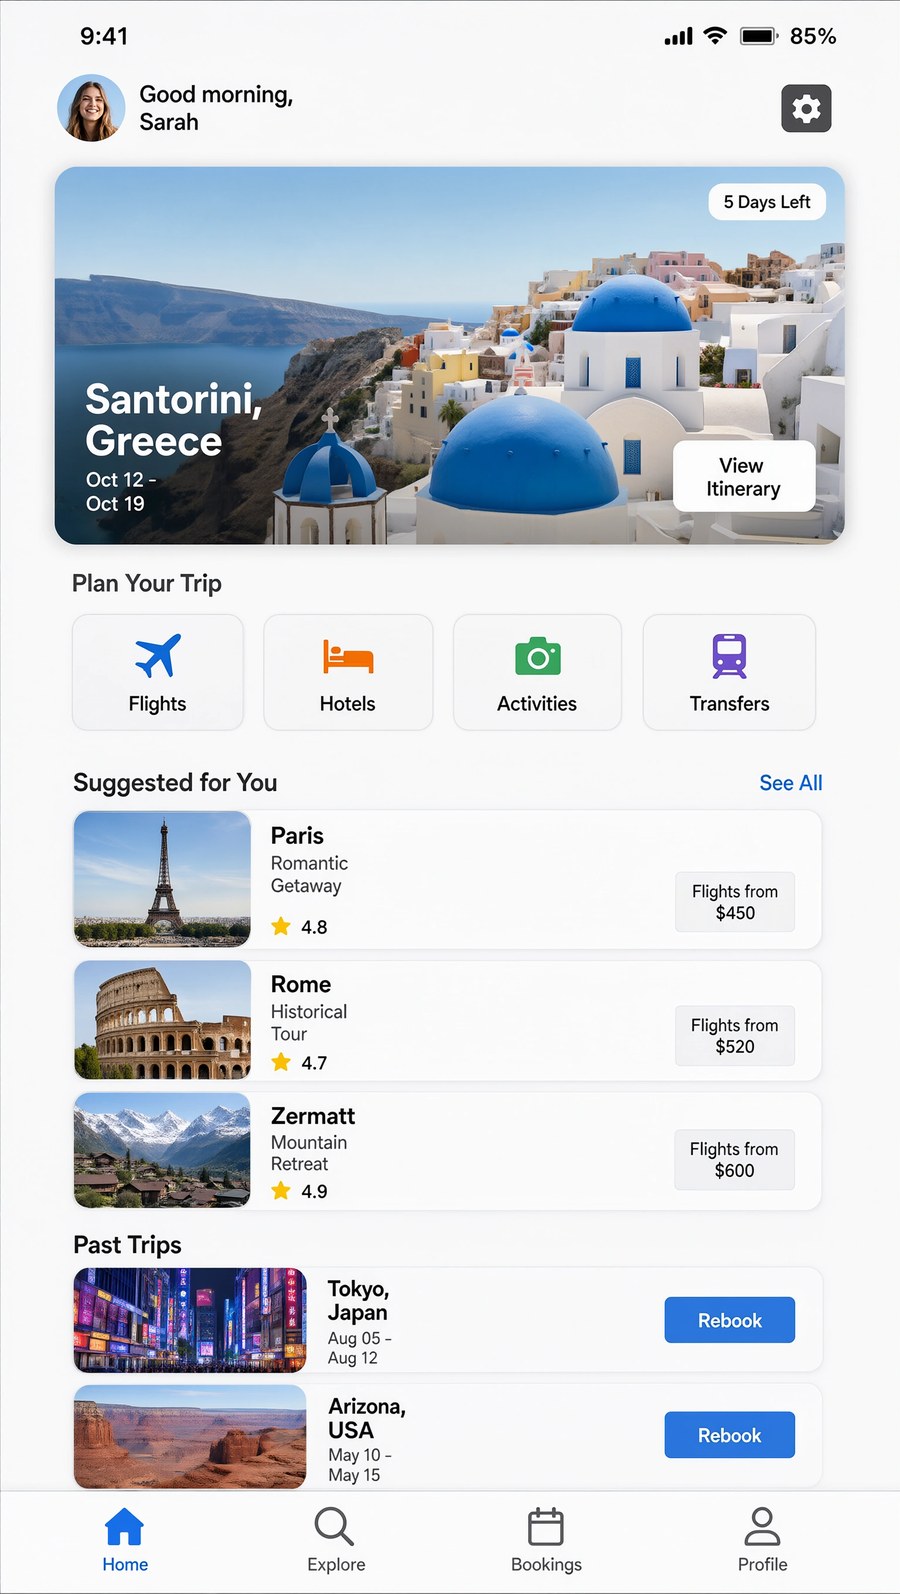 |
|---|---|
| 베이스 모델, 40스텝 | v0.3, 9스텝 |
증류 모델은 diffusers에서 최대 3개의 참조 이미지로도 실행되며, 아래의 6인 그룹 초상화가 그 경로를 시험합니다. 6개의 정체성, 하나의 프롬프트, 하나의 바 내부입니다.
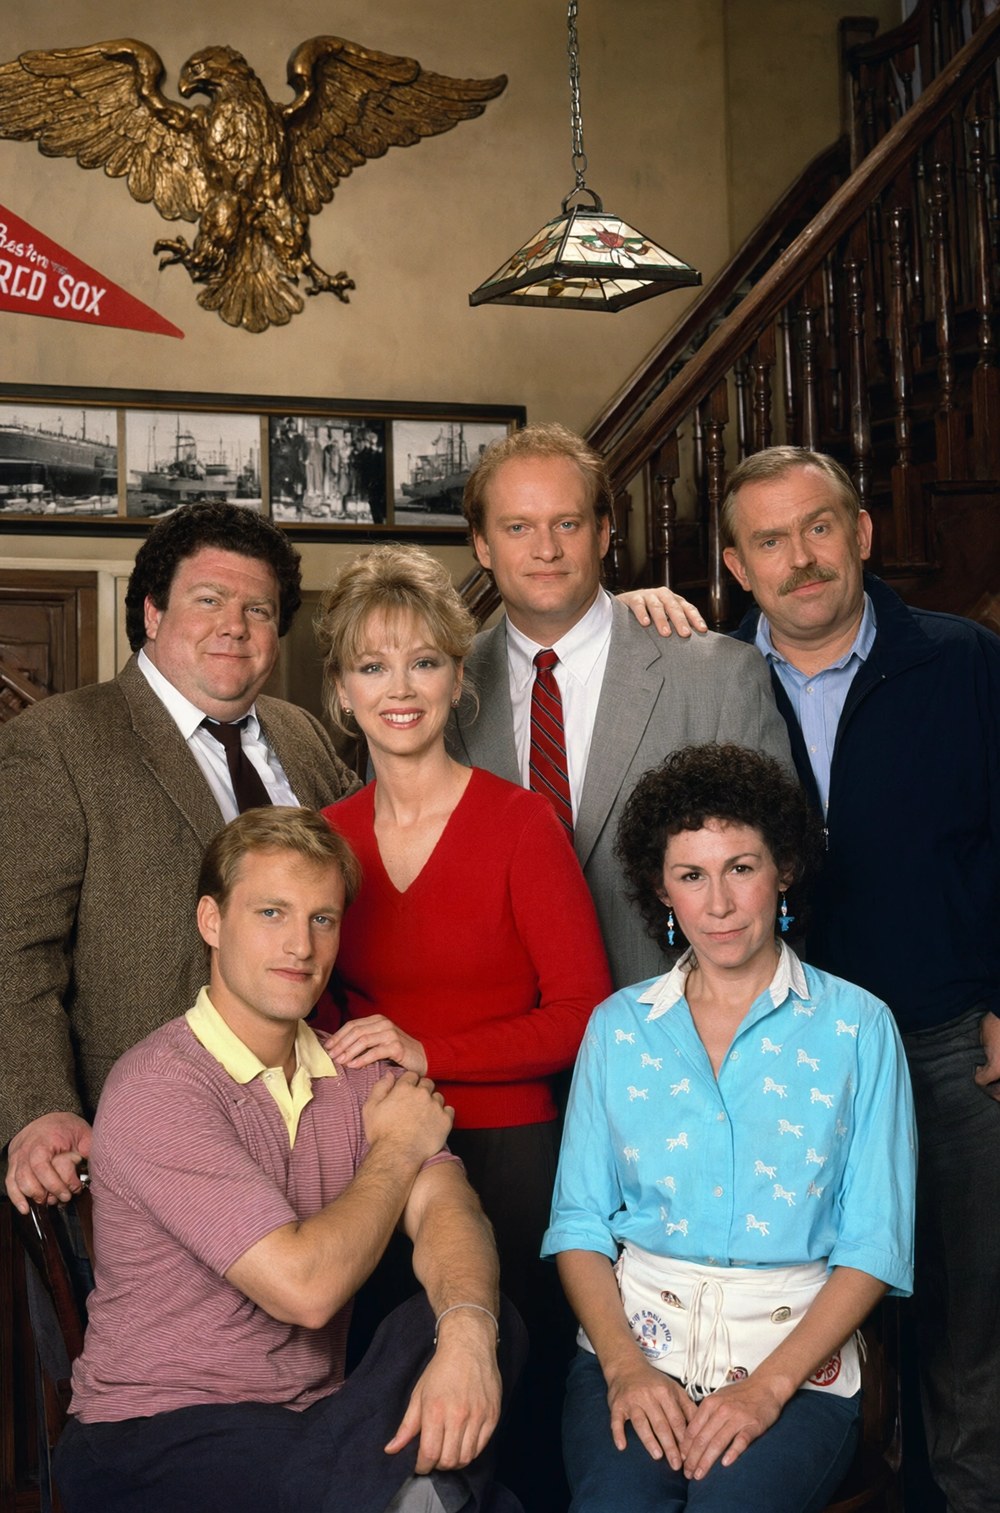 | 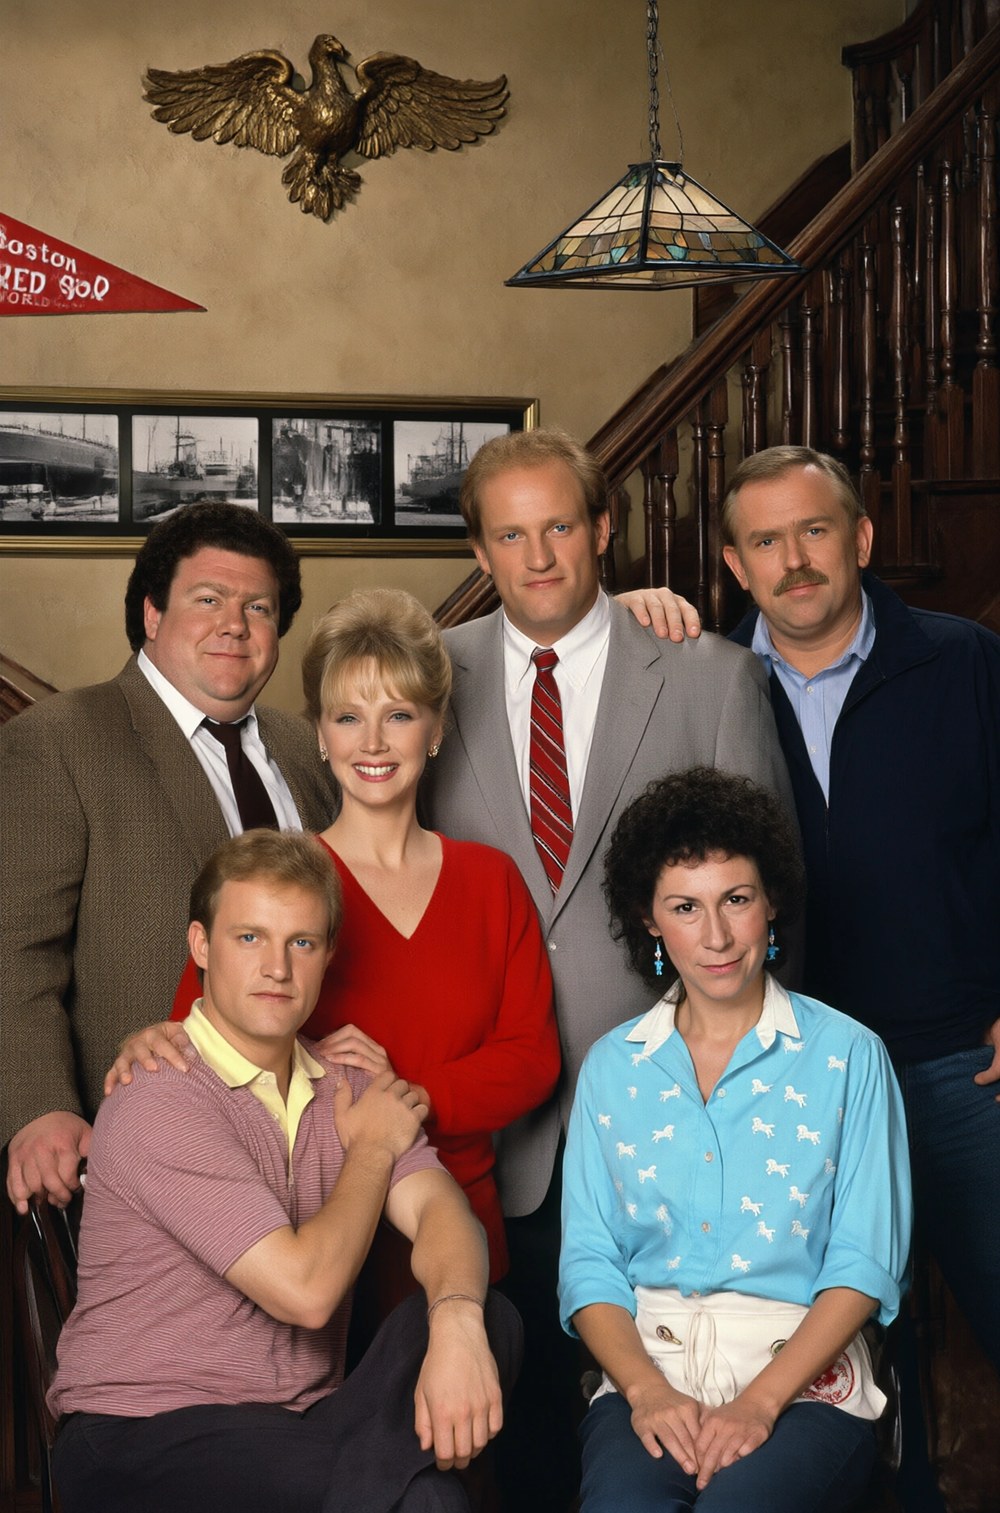 |
|---|---|
| 베이스 모델, 40스텝 | v0.3, 6스텝 |
속도
동일한 비교에서 데모 Space에 보고된 이미지당 초 단위 시간:
| 사례 | 해상도 | 베이스, 40스텝 | v0.3, 6스텝 | v0.3, 9스텝 |
|---|---|---|---|---|
| 참조 기반 초상화 | 1344x1760 | 14.0초 | 2.9초 | 4.0초 |
| 6개 참조 그룹 초상화 | 1248x1888 | 25.8초 | 5.9초 | 8.8초 |
| 빽빽한 앱 스크린샷 | 1536x2720 | 26.9초 | 4.9초 | 6.8초 |
| 360도 파노라마 | 2176x1088 | 14.3초 | 2.9초 | 4.1초 |
아직 하지 못하는 것
모델 카드는 남은 격차에 대해 이례적으로 솔직하게 설명합니다. 복잡한 편집은 여전히 student가 뒤처지는 부분입니다. 다중 참조 구성, 얼굴 교체, 정체성 보존 지시는 인물이 복제되거나 잔상처럼 겹치고 정체성이 흔들리는 결과를 낼 수 있습니다. 작거나 긴 렌더링 텍스트는 베이스 모델보다 더 자주 깨지며, 9스텝이 도움이 되지만 완전히 해결하지는 못합니다. 색상은 몇 퍼센트 정도 채도가 낮게 나옵니다. 2K 출력, RGBA 출력, 마스크 기반 편집, 3개를 초과하는 참조를 사용하는 편집은 비교 탭에서 육안으로만 확인되었으며, 벤치마크는 주장하지 않습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.