Looped-DiT: 260M 모델이 6.5배 큰 모델을 능가하는 방법
SenseTime의 OpenSenseNova가 Looped-DiT를 공개했습니다. 각 디노이징 단계 안에서 공유 transformer 블록을 여러 번 실행해, 작은 모델이 훨씬 큰 모델을 앞설 수 있습니다.
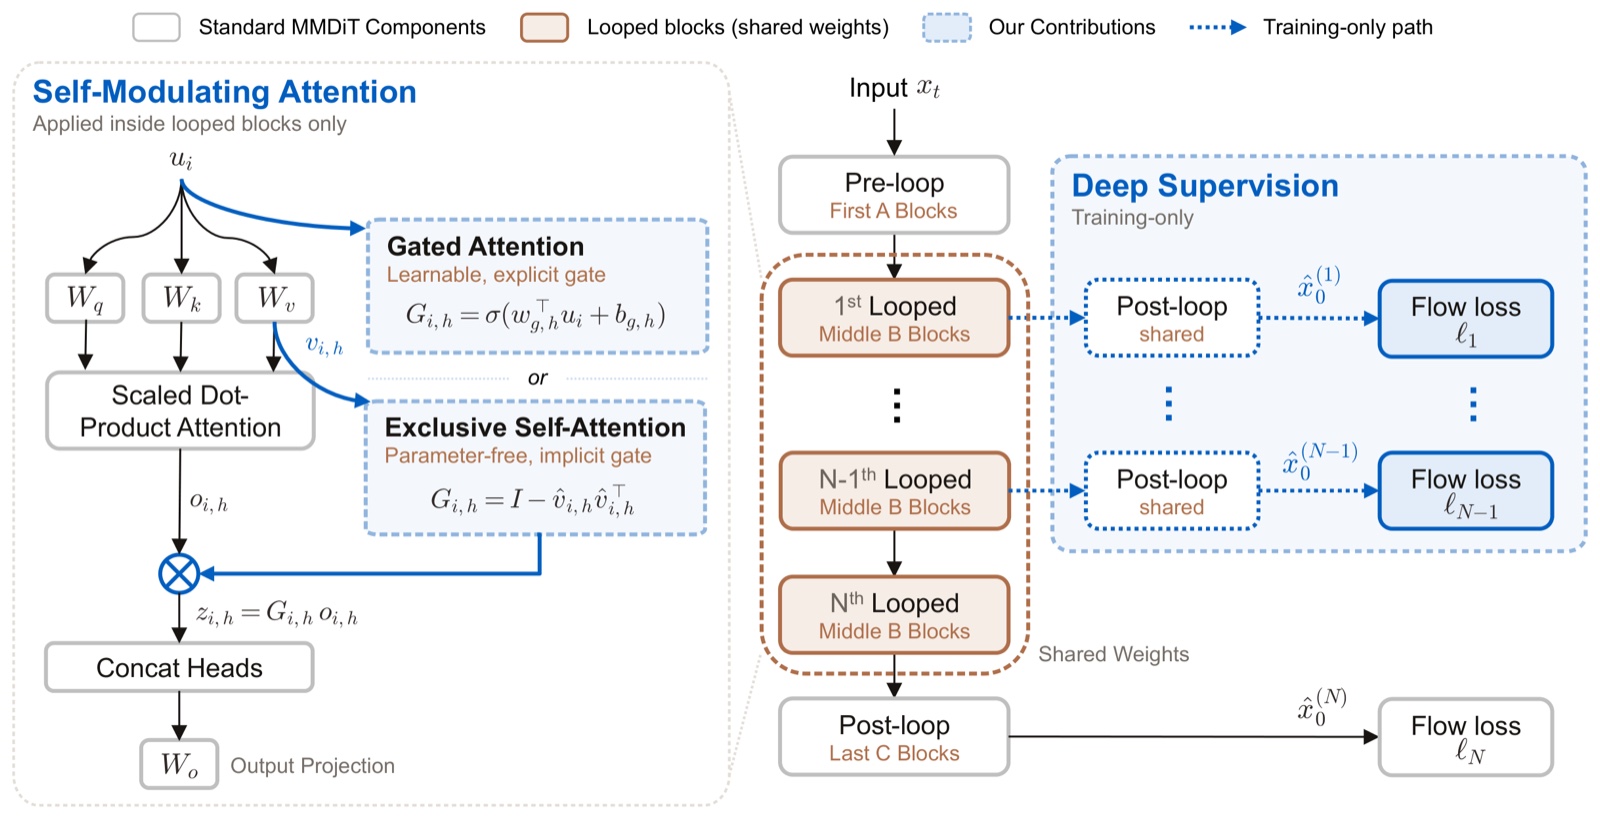
이 방법은 공유 블록 그룹을 디노이징 단계마다 N번 반복 실행하며, 자기 변조 어텐션으로 루프를 조절하고 심층 지도 학습으로 매 회차 이후의 상태를 학습합니다.
단순 반복이 실패하는 이유
같은 블록을 두 번 실행한다고 해서 diffusion transformer가 안정적으로 개선되지는 않습니다. 논문은 그 원인을 두 가지 문제로 추적합니다. 중간 루프 전반의 약한 지도 학습과, 루프 횟수가 늘어날수록 국소 정보를 점진적으로 침식하는 어텐션 업데이트입니다. Looped-DiT는 이를 해결하기 위해 두 가지 구성 요소를 추가합니다.
- **심층 지도 학습(Deep Supervision)**은 매 루프 이후의 상태를 post-loop 블록을 통해 디코딩하고, 그 각각의 예측을 동일한 clean-image 대상에 대해 학습시킵니다.
- **자기 변조 어텐션(Self-Modulating Attention)**은 루프 내부의 어텐션 업데이트를 조절하며, exclusive self-attention(XSA) 또는 헤드별 어텐션 게이트를 사용합니다.
백본은 MiniT2I의 픽셀 공간 MMDiT이며, 동결된 FLAN-T5-Large로 조건화됩니다. 저장소는 B/32, B/16, L/16 학습, 임의의 루프 깊이에서의 추론, 6개 벤치마크 전반의 평가, 각 학습 데이터셋에 대한 데이터셋 준비 스크립트를 포함합니다.
결과
점수는 EMA 가중치, Euler 100 스텝, 가이드 6.0, 루프 깊이 4를 사용했습니다.
| 모델 | Patch | GenEval | DPG | PRISM | CoRe | Spatial | TIIF | 평균 |
|---|---|---|---|---|---|---|---|---|
| Looped-DiT B/32 | 32 | 85.1 | 85.3 | 54.4 | 44.5 | 52.3 | 76.1 | 66.3 |
| Looped-DiT B/16 | 16 | 87.4 | 87.0 | 67.0 | 53.5 | 54.6 | 79.7 | 71.5 |
가장 중요한 주장은 논문 초록에 있습니다. 파라미터를 맞춘 설정과 연산량을 맞춘 설정 모두에서 루프 설계가 비루프 베이시스라인을 일관되게 능가하며, 고정된 추론 예산 아래에서는 더 깊은 루프가 추가 디노이징 스텝보다 더 많은 것을 얻는다는 것입니다. 저자들은 또한 더 깊은 루프가 이전 루프에서 발생한 실수를 점진적으로 교정한다고 보고하며, 이를 잠재 데이터 추론을 시사하는 동작이라고 설명합니다.
실행 방법
두 체크포인트는 PyTorch 파일로 공개되어 있으며, sensenova/Looped-DiT-B16과 sensenova/Looped-DiT-B32입니다. 추론은 단일 모듈 호출입니다. --loops가 루프 깊이를 설정하고, 여러 깊이를 전달하면 각각 한 행씩 출력되어 하나의 프롬프트에서 깊이를 비교할 수 있습니다.
hf download sensenova/Looped-DiT-B16 looped-dit-b16.pt --local-dir checkpoints

python -m looped_dit.sample --checkpoint checkpoints/looped-dit-b16.pt \
    --prompt "a red cube on top of a blue sphere" --loops 1 2 3 4 --out loops.png
논문의 주요 결과는 bfloat16의 EMA 가중치에서 Euler 100 스텝, 가이드 6.0, 512x512에서 루프 깊이 4를 사용합니다. 깊이 4가 학습된 깊이이지만, 저자들은 재학습 없이 다른 깊이도 작동한다고 언급합니다. 따라서 루프 횟수는 체크포인트의 고정된 속성이 아니라 추론 시점의 조절 값입니다.
사용 가능 여부
이것은 연구용 릴리스이며 ComfyUI 통합이 아닙니다. 현재 ComfyUI 노드도, Comfy-Org 재패키징도, diffusers 파이프라인도 없습니다. 따라서 실행하려면 저장소 자체의 Python 환경이 필요합니다. PyTorch 2.1 이상의 CUDA 빌드, requirements.txt, 그리고 벤치마크 데이터와 Mask2Former 가중치가 함께 제공되지 않으므로 별도로 설치해야 하는 평가 스택(mmdet, vLLM, modelscope)입니다. 릴리스 날짜와 지금까지 모은 GitHub 스타 51개를 고려하면 커뮤니티 포팅이 나와도 놀랍지 않겠지만, 이 글을 쓰는 시점에는 아무것도 존재하지 않습니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.