Fizgig H3 Still: ComfyUI에서 MiniMax H3 단일 프레임 스틸 이미지 생성
ComfyUI-Fizgig-H3-Still은 진정한 1프레임 MiniMax H3 잠재 데이터를 만들고 밴딩 없이 디코드하는 두 개의 노드를 추가하여 3 MP 이상에서 깔끔한 스틸 이미지를 제공합니다.
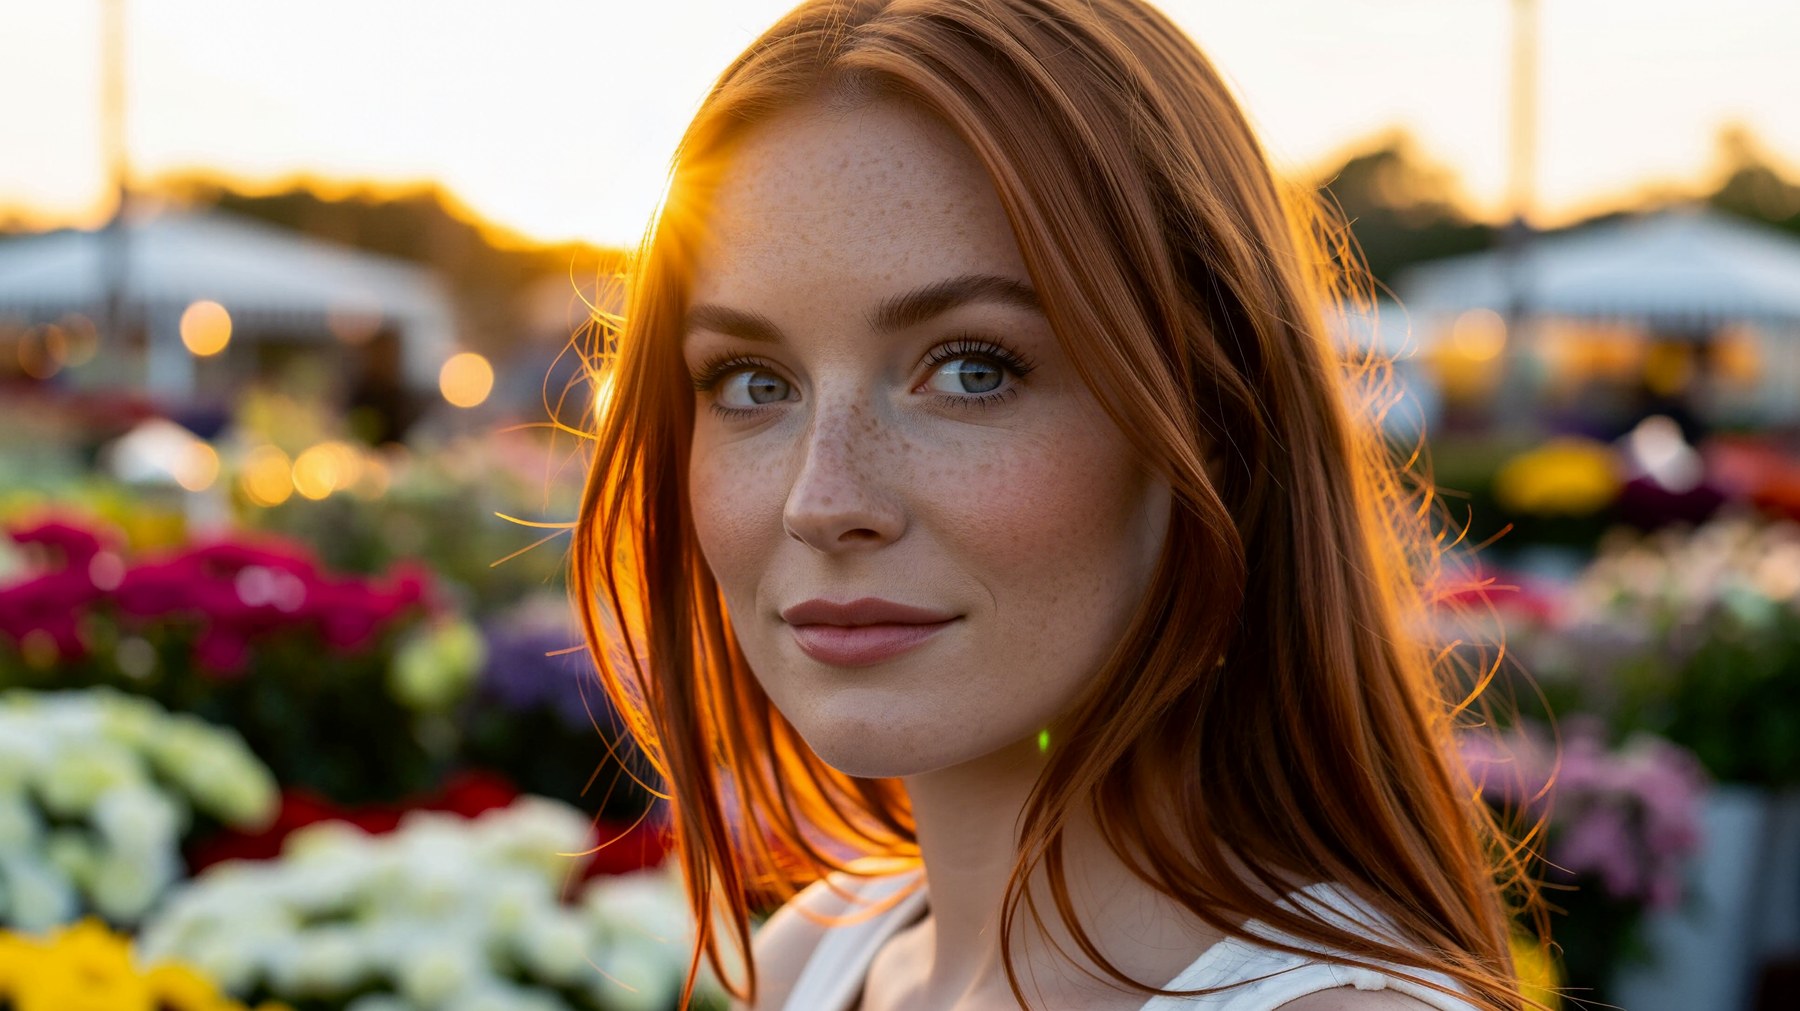
3872x2176 스틸, Turbo LoRA 없음, 50 스텝, er_sde. Fizgig H3 Still Latent + Fizgig H3 Still Decode, 저장소의 8 MP 예제에서 가져옴.
비디오 모델에 스틸 파이프라인이 필요한 이유
H3의 기본 이미지는 단일 프레임이지만, 기본 제공 파이프라인은 이를 단일 프레임으로 취급하지 않습니다. 일반적인 H3 잠재 데이터는 최소 5프레임 길이이므로, "스틸"은 사실상 짧은 클립의 첫 프레임입니다. 그 단 하나의 프레임을 기본 제공 VAE Decode 노드로 디코드하면 밴딩과 줄무늬가 있는 출력이 나오며, 그래서 일반적인 우회 방법은 5프레임을 렌더링하고 그중 하나만 남기는 것이었습니다.
이 팩은 문제를 두 개의 노드로 나누는데, 이는 Fizgig가 자체 H3 스틸 미리보기를 렌더링하는 방식에서 비롯되었습니다.
- Fizgig H3 Still Latent는 진정한 1프레임 잠재 데이터를 생성합니다.
- Fizgig H3 Still Decode는 그 단일 프레임을 밴딩 없이 디코드합니다.
둘 다 ComfyUI의 내장 MiniMax H3 지원 위에서 실행되며 추가 Python 의존성이 필요하지 않습니다. 작성자의 자체 테스트에서는 MiniMax H3 Single-Frame VAE 500K에서 다루는 전용 단일 프레임 VAE와도 비교했는데, 해당 checkpoint는 더 느리고 피부 디테일이 적은 더 부드러운 결과를 내므로, 이 노드들이 권장 경로입니다.
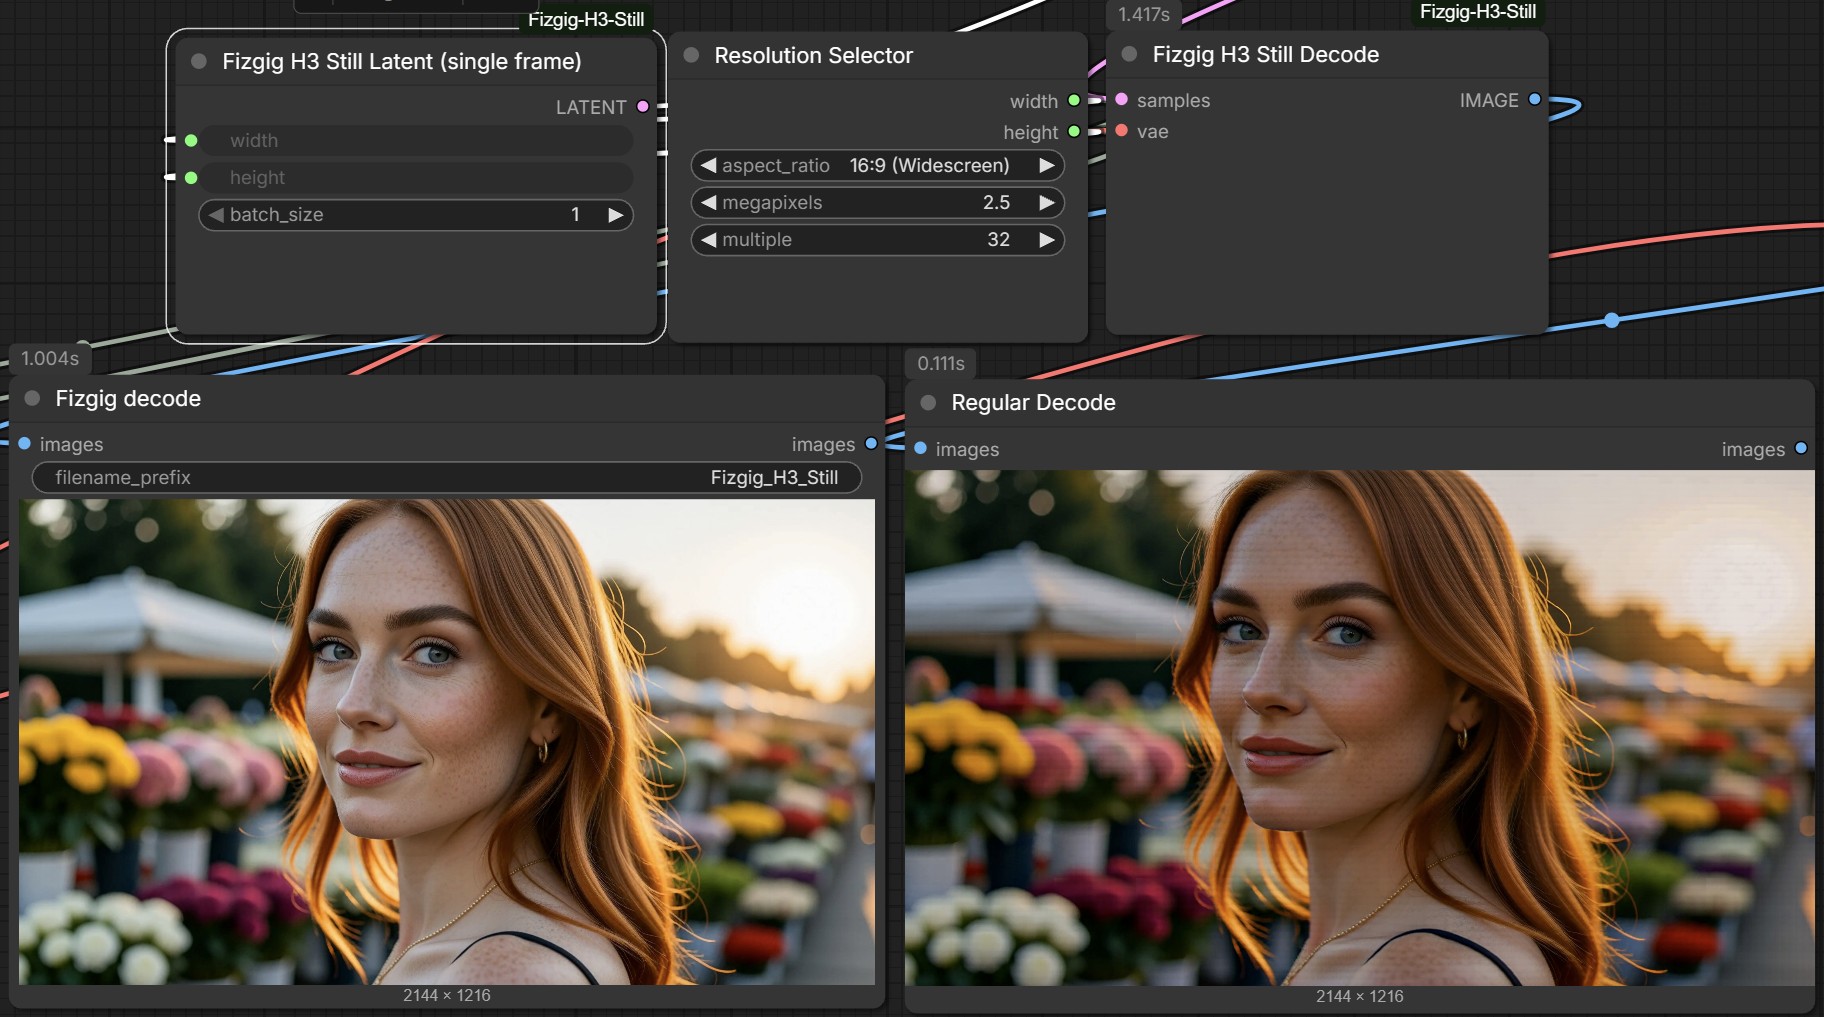
동일 시드, 2144x1216: Fizgig H3 Still Decode(왼쪽)와 기본 제공 VAE Decode(오른쪽).
H3 그래프에 연결하기
LATENT 출력은 연결하지 않습니다. 대신 Fizgig H3 Still Latent를 샘플러의 잠재 데이터 입력에 연결하고, 조건화 노드와 동일한 너비와 높이를 사용합니다.
디코더 교체
VAE Decode를 Fizgig H3 Still Decode로 교체합니다. 이 노드는 샘플러 출력과 비디오 VAE를 받으며, 교체하는 노드와 동일한 입력입니다.
선택적으로 Turbo LoRA 추가
모델 전용 LoRA 로더를 통해 larryvrh/MiniMax-H3-Turbo-Lora의 LoRA를 추가합니다. 기본 제공 설정은 v4 step-600 EMA 파일을 strength 0.38, 20 스텝, er_sde 샘플러로 사용하며, 8 MP 예제는 Turbo 없이 50 스텝으로 렌더링합니다.
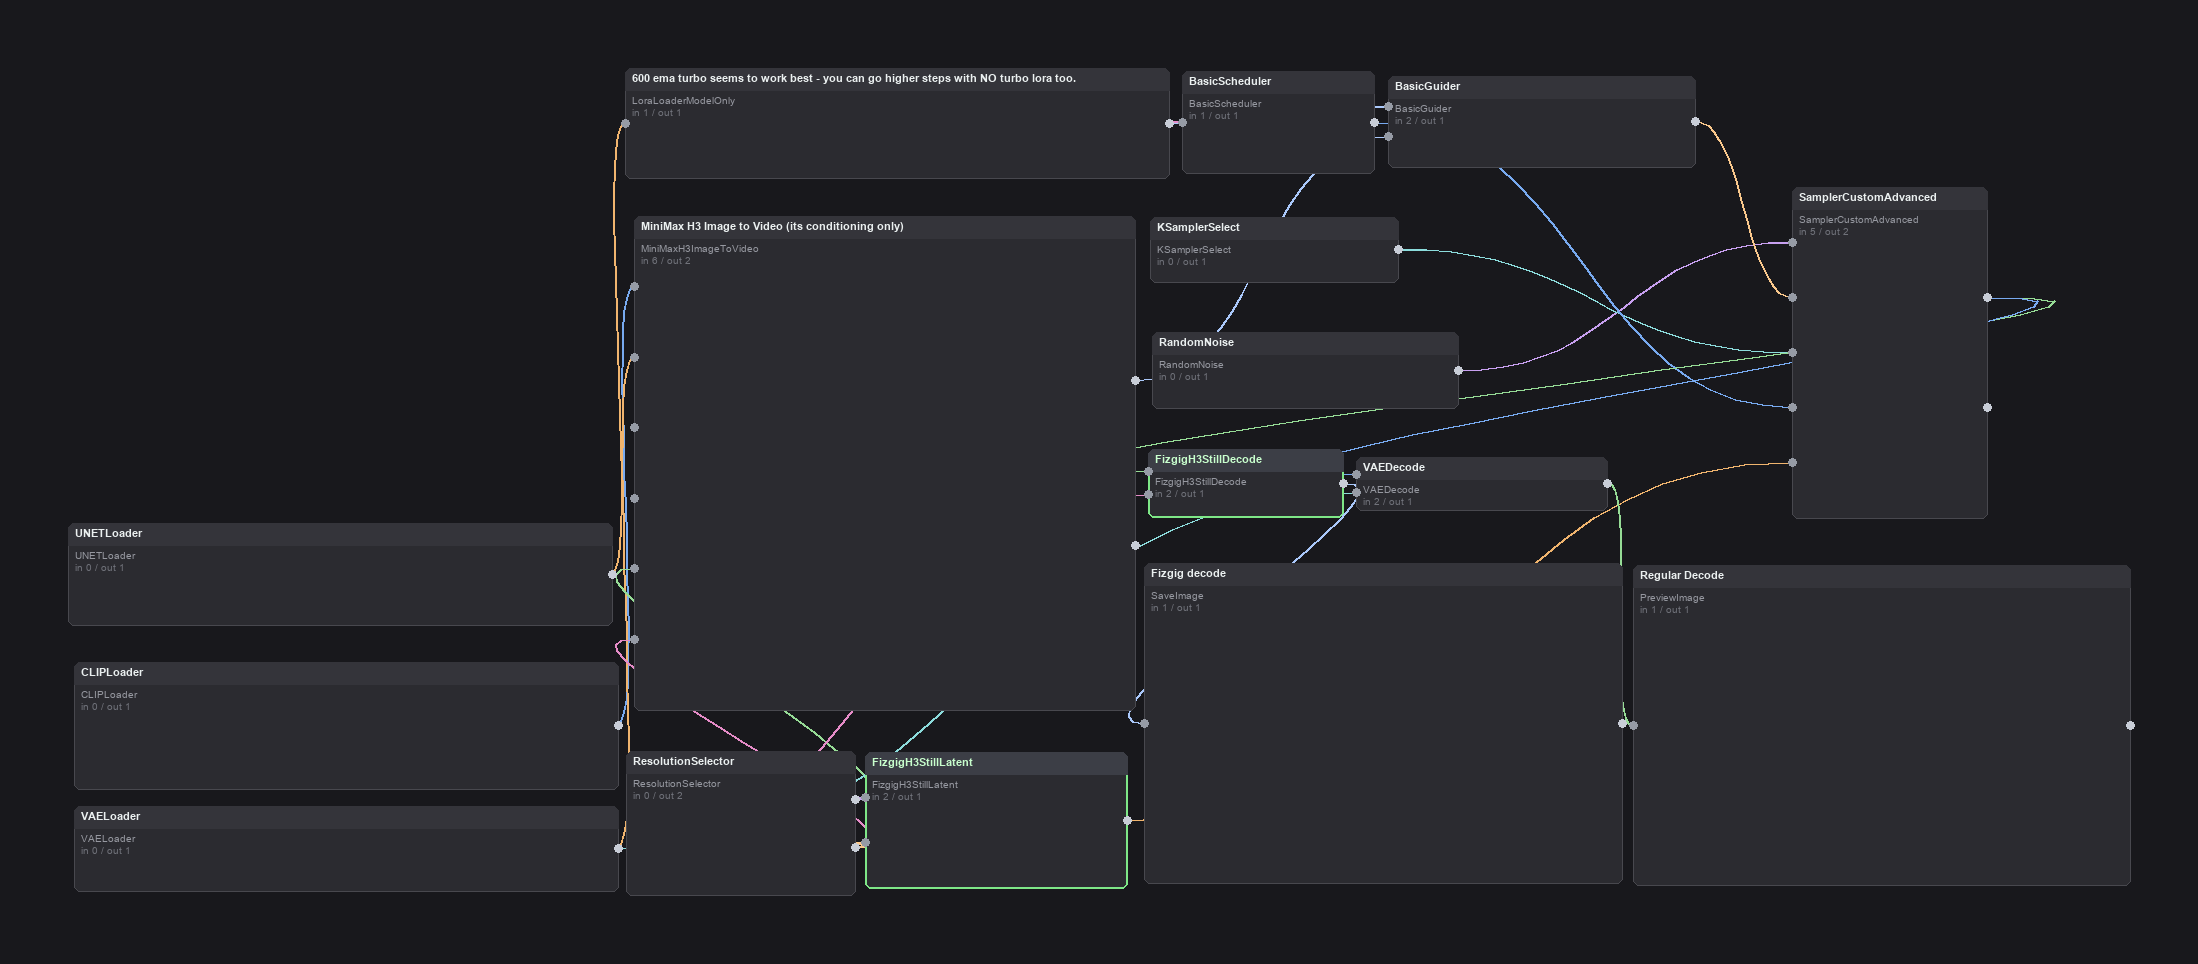
저장소에 포함된 워크플로 JSON에서 렌더링한 h3_still_text_to_image 예제입니다. Fizgig H3 Still Decode와 기본 제공 VAE Decode로 각각 한 번씩 두 번 디코드하므로 두 출력을 나란히 비교할 수 있습니다.
32의 배수인 너비와 높이는 모두 작동하지만, 결과는 3 MP 이상에서 가장 잘 유지됩니다. 작은 이미지는 눈에 띄게 약하게 나옵니다. 디코드는 타일 방식이므로 한 번에 몇 개의 타일씩, VRAM이 부족할 때는 한 번에 하나씩 처리하며, 따라서 큰 스틸 이미지에 큰 그래픽 카드가 필요하지 않습니다. 비디오에 이 그래프를 재사용하기 전에 알아둘 점이 있습니다. 잠재 데이터 노드는 스틸 이미지 전용인 반면, 디코드 노드는 1프레임보다 긴 것은 무엇이든 기본 제공 디코드로 그대로 전달하므로, 클립 워크플로에 남겨 두어도 문제가 없습니다.
이 팩에는 사진을 MiniMax H3 참조 → 비디오에 넣고 프롬프트에서 <Picture 1>로 참조하는 편집 예제도 포함되어 있으며, H3 편집은 그 크기에서 가장 잘 작동하는 것으로 보이므로 먼저 2.5 MP로 업스케일합니다.
자매 팩: H3 Tweaks
같은 작성자의 이전 노드 팩인 ComfyUI-Fizgig-H3-Tweaks는 학습 없는 노브로 동일한 탐구의 비디오 측면을 다룹니다. 피부 질감 제어, sub-seed를 유지하면서 장면 다시 롤링, Turbo 렌더링을 위한 프롬프트 강도 다이얼입니다. 09-25 업데이트에서는 스틸 작업과 함께 H3 Latent와 VAE Decode 노드 변형이 추가되었습니다.
커뮤니티 반응
이 노드들은 2026-09-26에 r/comfyui에서 화제가 되었고, 한 독립 테스터가 주말 동안 8 MP 그래프를 30 스텝으로 실행했습니다. 그들의 메모: 스틸 파이프라인은 마침내 작은 타이포그래피를 사용 가능하게 만들었지만 아주 미세한 글자에는 그렇지 않았고, 렌더링 결과는 일반 출력보다 더 매끄러웠으며 블록 형태의 픽셀 이음새나 "스캔 라인"이 없었습니다. 또한 색상 변화도 측정했습니다. 스틸 경로는 일반 출력의 약간의 세피아 따뜻함 대신 순수한 흑백 필름 누아르 느낌을 반환했습니다.
설치
cd ComfyUI/custom_nodes
git clone https://github.com/shootthesound/ComfyUI-Fizgig-H3-Still
ComfyUI를 재시작하면 두 노드가 Fizgig 카테고리에 나타납니다. 예제는 Comfy-Org H3 파일을 사용합니다. models/diffusion_models의 minimax_h3_fl2va_pruned_int8_convrot.safetensors, models/text_encoders의 qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors, models/vae의 minimax_h3_video_vae_int8_convrot.safetensors입니다. 편집 예제는 추가로 ComfyUI-RMBG의 AILab_ImageResize를 사용합니다.
저장소: shootthesound/ComfyUI-Fizgig-H3-Still
자매 팩: shootthesound/ComfyUI-Fizgig-H3-Tweaks
관련 항목: Fizgig v6 RefMods, MiniMax H3 Video VAE Optimization
베이스 모델: Comfy-Org/MiniMax-H3
댓글
GitHub로 로그인하고 토론에 참여하세요.