MiniMax H3 TRT VAE: ComfyUI에서 H3 디코드 1.7배 가속
ComfyUI 노드 팩이 MiniMax H3 비디오 VAE를 TensorRT 엔진으로 컴파일해 VAE 인코드 및 디코드 시간을 최대 1.7배 단축합니다. 저 VRAM을 위한 w4a16 디코더도 제공합니다.
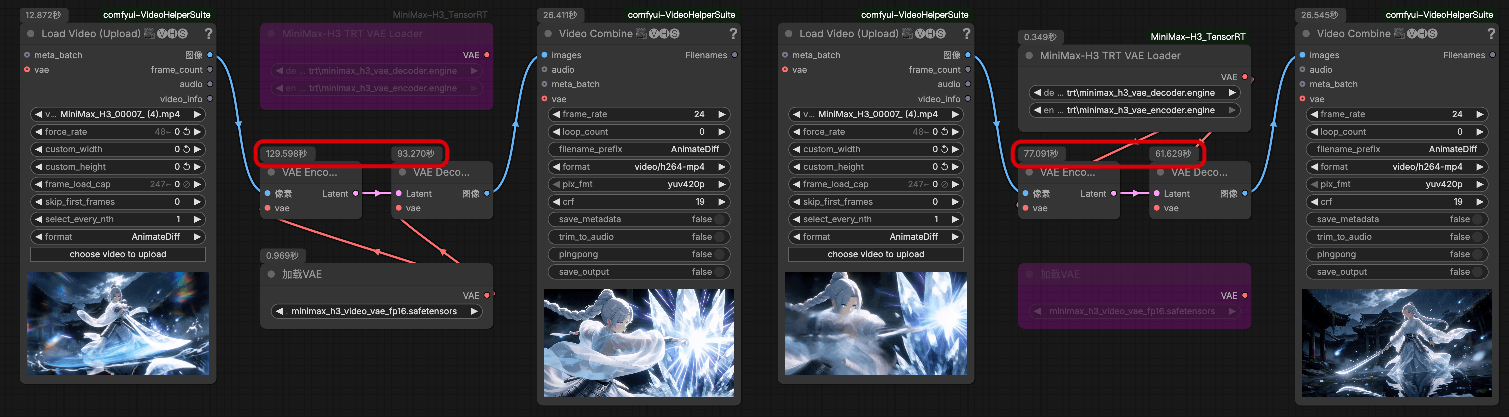
프로젝트 README의 미리보기: ComfyUI 그래프 안의 TRT VAE 컴파일 및 로드 노드.
VAE 디코드는 모든 H3 실행에서 고정 비용입니다. 내장 ComfyUI 커널이 이미 PyTorch 측에서 그 비용을 줄여 주었고, 이 노드는 다른 방식을 택해 VAE를 컴파일된 TensorRT 엔진에 넘깁니다.
이 노드가 하는 일
이 팩은 두 개의 노드와 엔진으로 가는 ONNX 경로를 제공합니다.
- MiniMax-H3 TRT VAE Compiler는 ONNX 인코더와 디코더를 받아 TensorRT 엔진을 빌드합니다. 이는 한 번만 수행하는 단계이며, 컴파일된 엔진은 이후에 재사용됩니다.
- MiniMax-H3 TRT VAE Loader는 컴파일된 엔진을 로드해 일반 VAE 대신 사용할 수 있게 합니다.
가중치는 Hugging Face에 ONNX 파일로 공개되어 있으며 ComfyUI/models/vae에 넣으면 됩니다. 이 팩에는 ComfyUI 외부에서 엔진을 빌드하기 위한 독립 실행형 compile.py도 포함되어 있는데, 컴파일 단계가 UI를 막지 않아야 할 때 유용합니다.
설정
| 단계 | 작업 |
|---|---|
| 1 | ComfyUI/custom_nodes에 git clone https://github.com/lihaoyun6/ComfyUI-H3VAE_TRT로 복제하고 requirements.txt를 설치 |
| 2 | ONNX 인코더와 디코더를 ComfyUI/models/vae에 다운로드 |
| 3 | MiniMax-H3 TRT VAE Compiler를 한 번 실행해 엔진 빌드 |
| 4 | 워크플로의 VAE를 MiniMax-H3 TRT VAE Loader로 전환 |
ONNX 저장소에는 w4a16_awq 디코더 변형도 있습니다. README는 GPU의 VRAM이 12GB 이상이 아닐 때 이 변형을 권장합니다.
이슈 트래커에서 나온 참고 사항
TensorRT 빌드는 설치된 스택에 민감하므로 컴파일 전에 저장소의 이슈를 읽어볼 가치가 있습니다.
- 엔진 컴파일은 느립니다. 한 신고에서는 단일 빌드에 5시간이 넘게 걸렸다고 측정했으므로, 첫 컴파일은 세션 도중이 아니라 미리 해두는 것이 좋습니다.
- TensorRT와 CUDA 버전이 일치해야 합니다. TensorRT 11.2와 CUDA 13.0 조합에 대한 미해결 신고가 있으며, 다른 환경에서는
IBuilder::buildSerializedNetworkAPI 사용 오류가 보고되었습니다. - 컴파일된 인코더가 첫 프레임, 마지막 프레임, 참조 프레임에 남기던 그리드 패턴이 신고되어 9월 초에 수정되었으므로, 현재
main에서 빌드하면 이 문제를 피할 수 있습니다.
이용 가능 여부
노드 팩과 ONNX 가중치 모두 공개되어 있습니다.
노드 팩: lihaoyun6/ComfyUI-H3VAE_TRT
ONNX 가중치: lihaoyun6/MiniMax-H3-VAE-ONNX
베이스 모델: MiniMaxAI/MiniMax-H3
이 팩에는 예제 워크플로가 포함되어 있지 않습니다. 컴파일러와 로더는 표준 VAE 노드 대신 기존 H3 그래프에 그대로 넣으면 됩니다.
댓글
GitHub로 로그인하고 토론에 참여하세요.