MOSS-Image 4ステップLoRA: eDMD蒸留で細部を保持
rank-64のComfyUI LoRAを使えば、MOSS-Image-SFTをCFG 3の50ステップではなくCFG 1の4ステップで実行でき、細かいテクスチャは50ステップの教師モデルを上回ると測定されています。
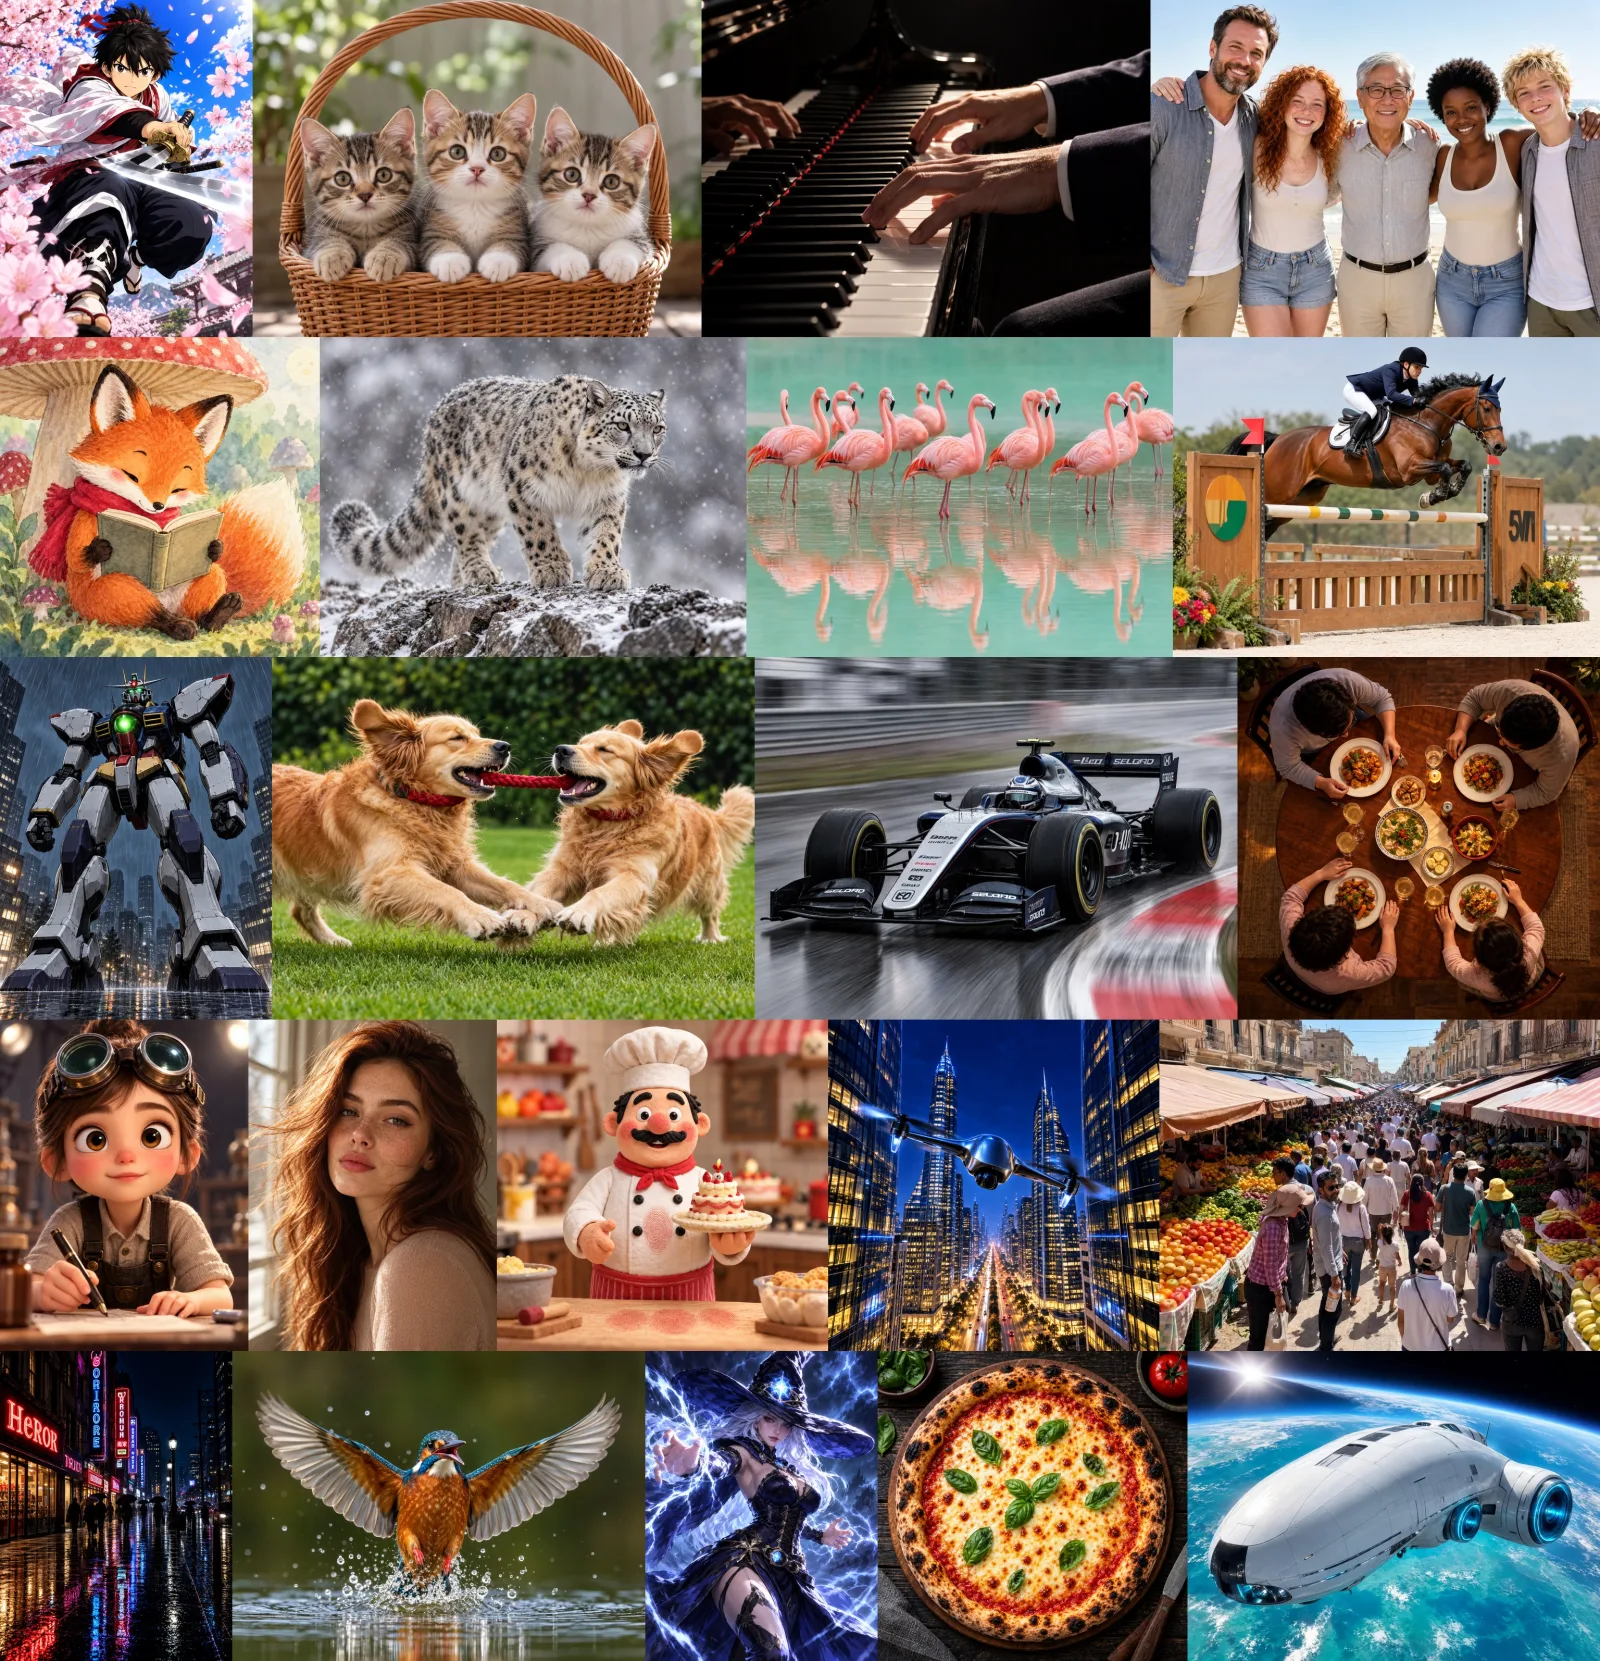
LoRAを4ステップで実行して生成した22個のテストプロンプト。ソース: lvladikov
4ステップのコストと保持されるもの
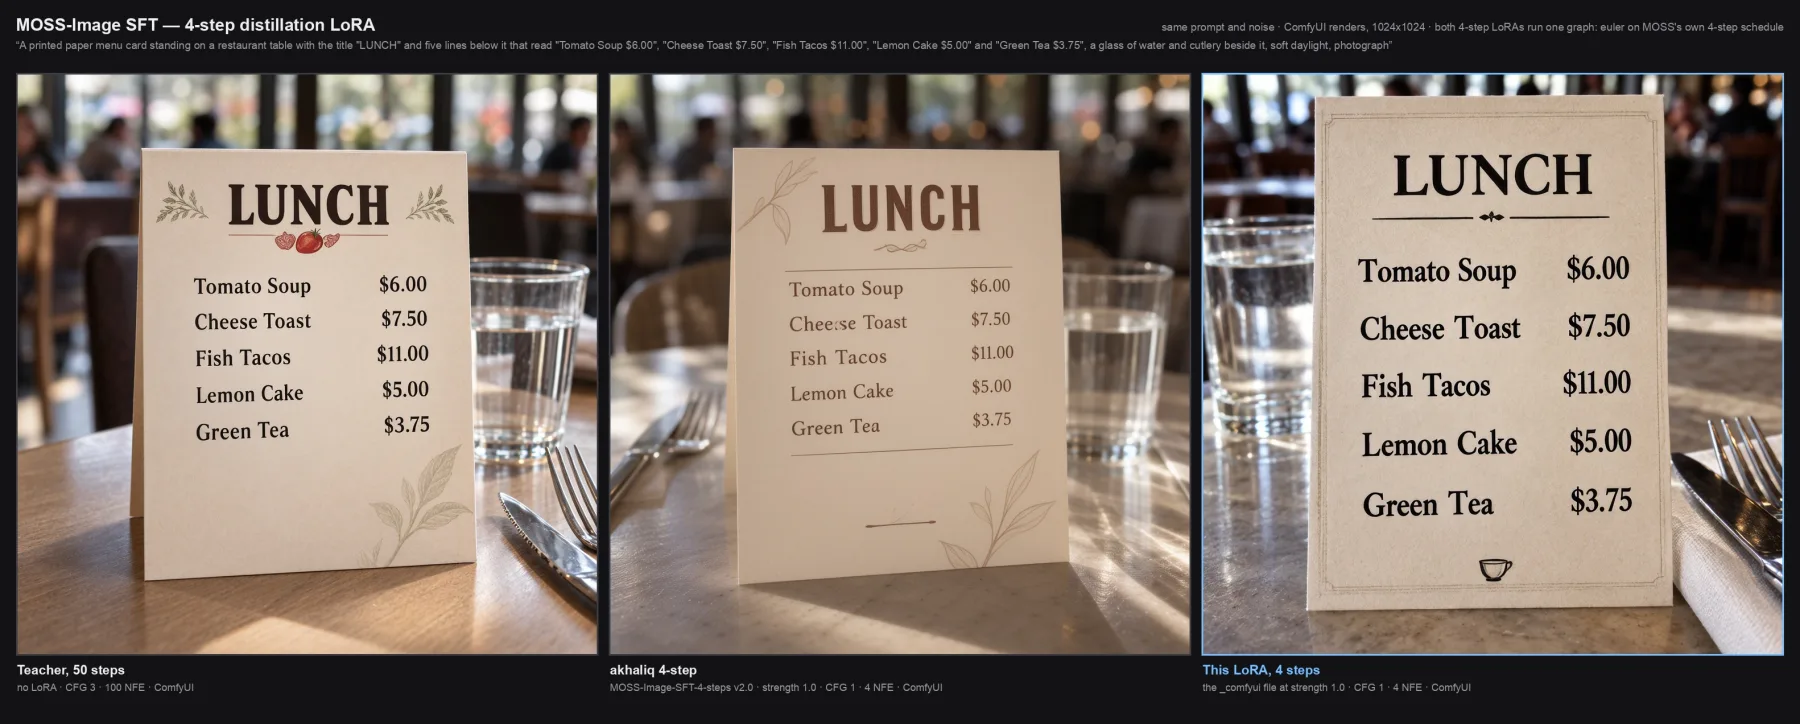
作者自身の計測では、1024²の22枚が387.3秒ではなく26.6秒で完了し(Comfy Cloudの課金対象GPU時間)、トレーニングで教師モデルの画像と約8,000枚のキャプション付き写真クロップを混ぜているため、細かいテクスチャは平均で50ステップの教師モデルの1.22倍になります。2つ目の主張はテキストレンダリングです。15個のテキストプロンプトのうち14個で、要求したすべての文字列が正しく出力され、akhaliqの4ステップLoRAでは12個でした。
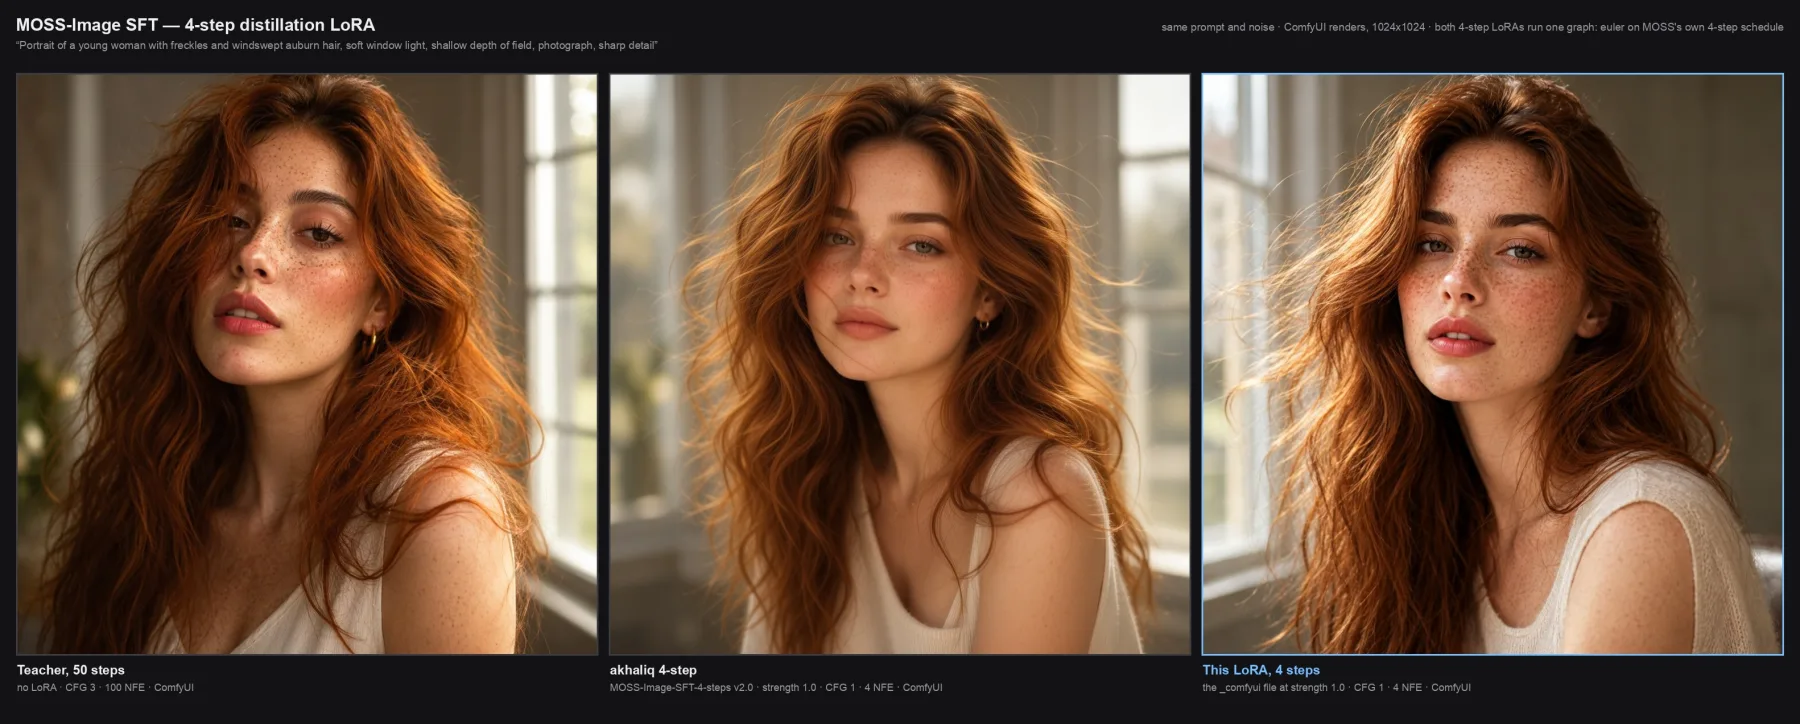
これらは作者の数値です。独立した検証が1件あります。あるユーザーが9つのMOSS turbo LoRAを古典絵画のテクスチャ(罅割れ、キャンバスの織り目、紙の質感)で50ステップのベースラインと比較し、12ステップの候補を抑えてこのLoRAをベースラインに最も近いと評価しました。
 |
|---|
| 1つのプロンプト、1つの開始ノイズ: 50ステップの教師モデル · akhaliq 4ステップ · このLoRA。ソース: lvladikov |
弱点となる場面
このLoRAは教師モデルの出力をコピーするのではなく、エンドポイントクリティックを用いた分布マッチング(eDMD)と潜在敵対蒸留(LADD)によってトレーニングされています。柔らかな絵画調のスタイルや密な写真ディテールは教師モデルを下回ります。水彩のテストでは細かいテクスチャが0.66倍、ポートレートと市場の人混みは0.80〜0.85倍です。
初期の報告も一致しています。4ステップの編集ワークフローは動作し、レイアウトプロンプトも維持されますが、フォトリアルな顔は弱く、あるユーザーは時折欠けた手足が見られると報告しています。別のユーザーは明確な勝利ではなく「lodestonesの最新LoRAと同等」と評しています。
 |
|---|
| 5行の印刷文字と価格が入ったメニュー: 教師モデル · akhaliq 4ステップ · このLoRA。ソース: lvladikov |
ComfyUIで実行する
通常のファイルではなく_comfyuiファイルを使用してください。ComfyUIはLoRAをbf16の重みに加算して合計を丸めるため、配布されているComfyUI用ファイルはアルファ値に実測1.18の係数が組み込まれています。strength 1.0、4ステップ、CFG 1で読み込み、50ステップの教師モデルのレイヤースキップやネガティブプロンプトの設定は追加しないでください。
| ファイル | フォルダー |
|---|---|
moss_sft_4step_rank_64_lora_comfyui.safetensors | ComfyUI/models/loras/ |
moss_image_sft_bf16.safetensors | ComfyUI/models/diffusion_models/ |
qwen3.5_9b_w4a8_gptq.safetensors | ComfyUI/models/text_encoders/ |
flux2-vae_small.safetensors | ComfyUI/models/vae/ |
3つのベースファイルはComfy-Org/MOSS-Imageから取得できます。このLoRAは768×512と512×768から1824×1024と1024×1824までの12種類の解像度でトレーニングされているため、それ以外のアスペクト比はトレーニングセットの範囲外です。
入手方法
- LoRAと8つのワークフロー: lvladikov/MOSS-SFT-Distill-4step-LoRA。テキストから画像へ、レイアウトから画像へ、画像編集、PiD 4×アップスケールを、ローカルComfyUIとComfy Cloudそれぞれ向けに用意しています。
- ベースモデル: OpenMOSS-Team/MOSS-Image-SFT、ComfyUI向けの再パッケージはComfy-Org/MOSS-Image。
- 以前の4ステップの選択肢: akhaliq/MOSS-Image-SFT-4-stepsは、DMADベースのアダプターとともにMOSS-Image few-step LoRAsで紹介しています。
コメント
GitHubでサインインしてディスカッションに参加しましょう。