LongCat Video Avatar 1.6がComfyUIで動作可能に
Meituanの音声駆動アバターモデルがComfyUIで動作します: Comfy-Orgによる重みの再パッケージ化、コミュニティ製ネイティブノードパック、レビュー中のコアサポートを解説します。
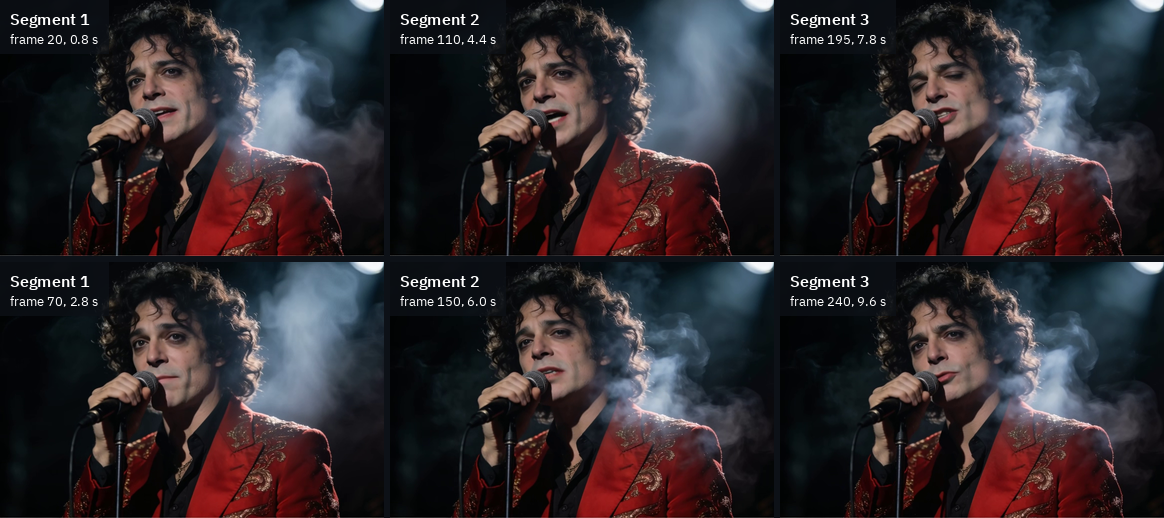
93フレームの3セグメントそれぞれから2フレームずつ。各セグメントは前のセグメントの最後の13フレームから続きます。
3つの導入経路
| 経路 | 状態 | 内容 |
|---|---|---|
| Comfy-Orgの重み | ダウンロード可能 | 公式int8 DiT、2つのLoRA、Whisperエンコーダー、Wan 2.1の共有VAEとテキストエンコーダー |
| ComfyUI-LongCat-Avatar(コミュニティ) | 今日から動作 | Pedro(LatentSpacer)によるネイティブノードパック。8ステップ蒸留版と50ステップベース版の動画ノード |
| コアサポート(CORE-720、Kijai) | PR 17831、オープン | comfy/ldm/wan/model_longcat.pyと音声エンコーダーの配線を追加。まだマージされていません |
ノードパックはComfyUI-ManagerからLongCat Avatar Nativeとしてインストールするか、comfy node install longcat-avatar-nativeでインストールできます。ComfyUI 0.44でテスト済みで、ComfyUI本体以外のパッケージは不要です。
ダウンロードするもの
Comfy-Org/LongCat-Video-AvatarのフォルダーはComfyUI/modelsに対応しています:
| ファイル | フォルダー | サイズ |
|---|---|---|
longcat-avatar-1.6_int8_convrot.safetensors | diffusion_models | 14.9 GiB |
longcat-avatar-1.6_dmd_lora_rank128_bf16.safetensors | loras | 1.2 GiB |
longcat-avatar-1.6_opsd_lora_rank128_bf16.safetensors | loras | 1.2 GiB |
umt5_xxl_int8_convrotまたはumt5_xxl_fp16 | text_encoders | 5.3または10.6 GiB |
whisper_large_v3_encoder_fp16.safetensors | audio_encoders | 1.2 GiB |
wan_2.1_vae.safetensors | vae | 242 MiB |
テキストエンコーダーとVAEはWan 2.1のファイルなので、既存のComfyUI環境にはすでにある可能性が高いです。
4090 1枚での速度
移植版の作者は、768×512、int8 ConvRotとComfyUIのck attentionで、継続ステップあたり5.1秒を計測しました。253フレームのクリップ(10.1秒の音声)を3セグメントに分けて処理すると約162秒かかりました。またW6A8とW4A8のコピーも公開しており、それぞれ12.3 GiBと8.8 GiB(int8は14.9 GiB、bf16は29.5 GiB)で、どちらのLoRAもすべてのバリアントに適用できます。
ノードパックによる1本のクリップ。3セグメントすべてで口が音声に追従します。
ベースの50ステップノードはテキストガイダンスと音声ガイダンス付き、LoRAなしで動作し、各ステップでモデルを3回実行するため、蒸留版の経路より何倍も遅くなります。
入手先
- ComfyUI用の重み: Comfy-Org/LongCat-Video-Avatar
- ノードパック: ComfyUI-LongCat-Avatar、重みのミラーはPedroMarinhoDev/LongCat-Video-Avatar-1.6-ComfyUI
- コアサポート: Comfy-Org/ComfyUI PR 17831
- オリジナルモデル: meituan-longcat/LongCat-Video-Avatar-1.6
コメント
GitHubでサインインしてディスカッションに参加しましょう。