Direct3D-V3: ComfyUIで動く潜在空間不要のボクセルメッシュリファインメント
Direct3D-V3はVAEの代わりに潜在空間を使わないボクセル拡散で粗い3Dメッシュをリファインします。コミュニティ製のComfyUIノードパックがWindows GPUで動作するようになりました。
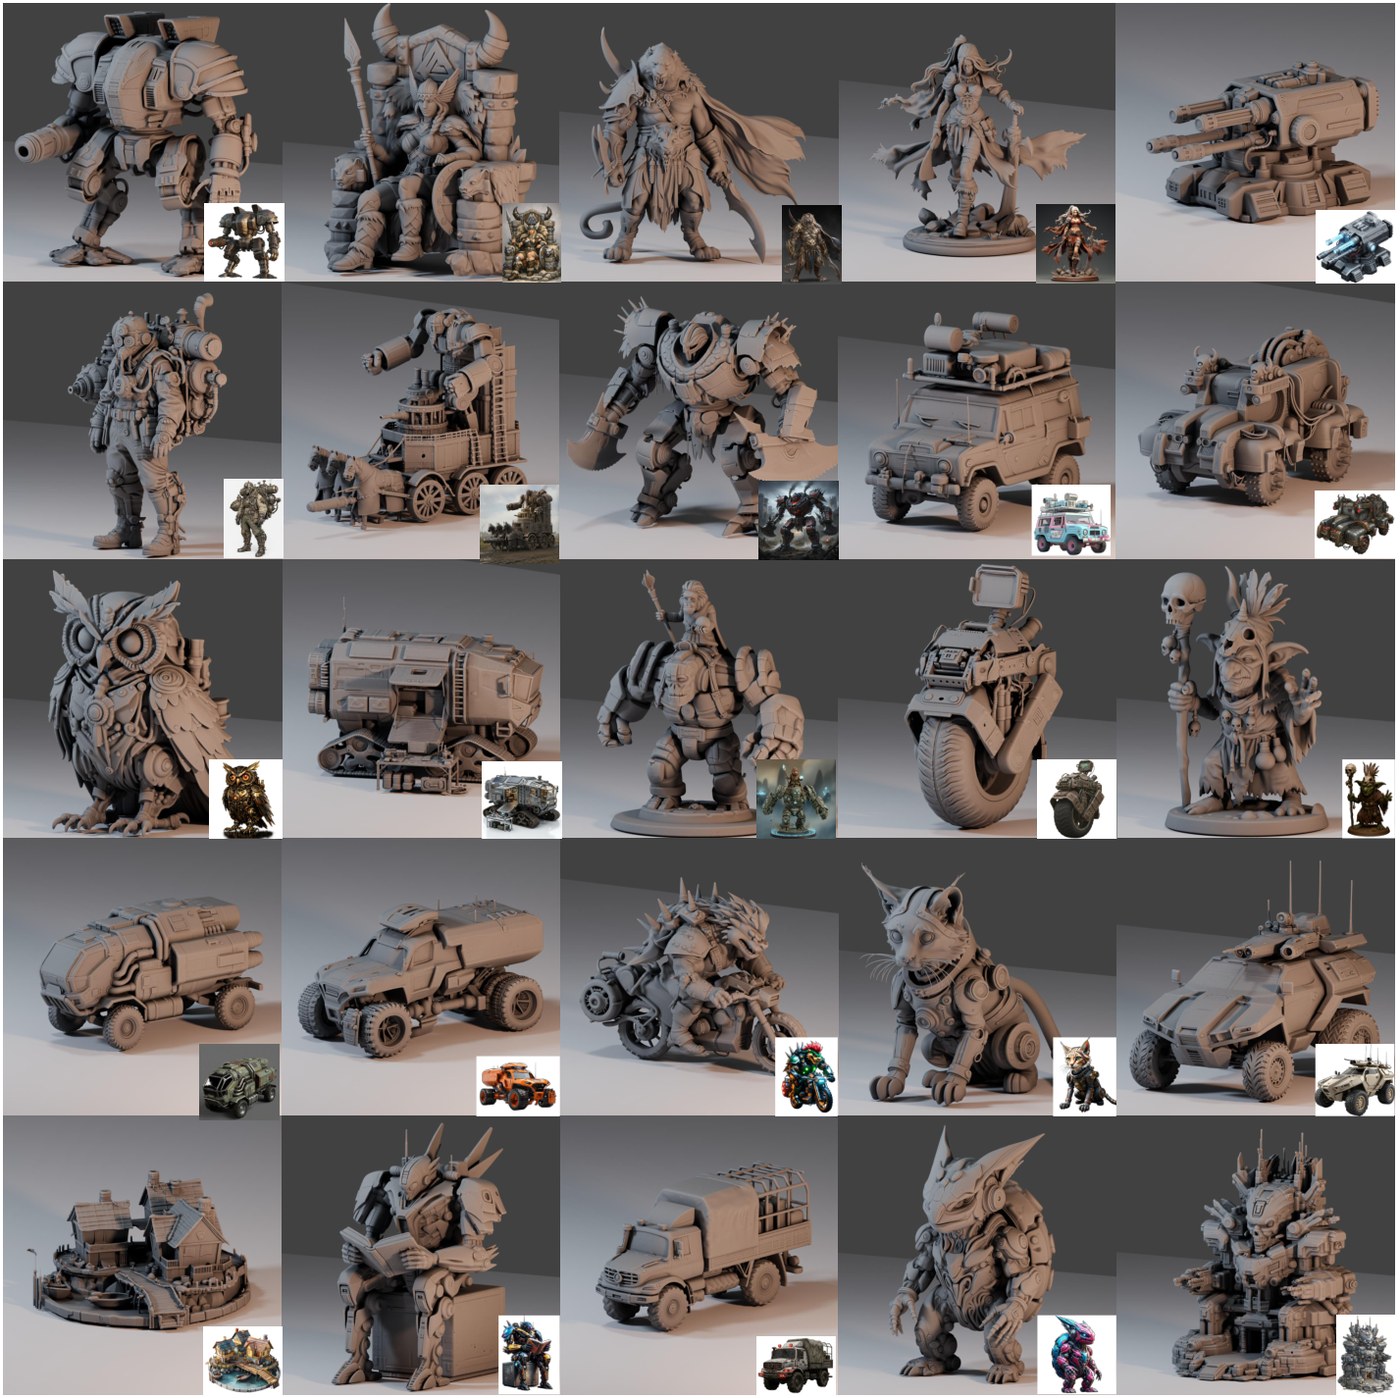
生成されたメッシュと表面ディテール(論文の追加結果より)。
できること
参照画像と同じ向きの粗いメッシュを入力すると、形状をリファインします。粗いステージで平滑化されて失われた溝、ベベル、細い構造、シャープな辺などが復元されます。陰的な多様体正則化によりサーフェスは閉じたまま保たれます。メッシュはデフォルトで200万三角形に簡略化され(target_faces)、GLBとしてエクスポートできます。
論文の主張は、潜在拡散に基づく画像to 3Dのスタックはすべて微細なジオメトリを2回捨てているというものです。1回目はVAEが形状を圧縮するとき、2回目はVAEが再構成用に、生成器が分布マッチング用にトレーニングされているためです。Direct3D-V3はVAEを排除し、生のSDFボクセルグリッドをdiffusion transformerで直接モデリングします。さらに隣接ボクセルに対するマニフォールド正則化と、補助的なカメラ予測タスクを追加することで、条件付け画像と生成されたジオメトリの位置合わせを行います。
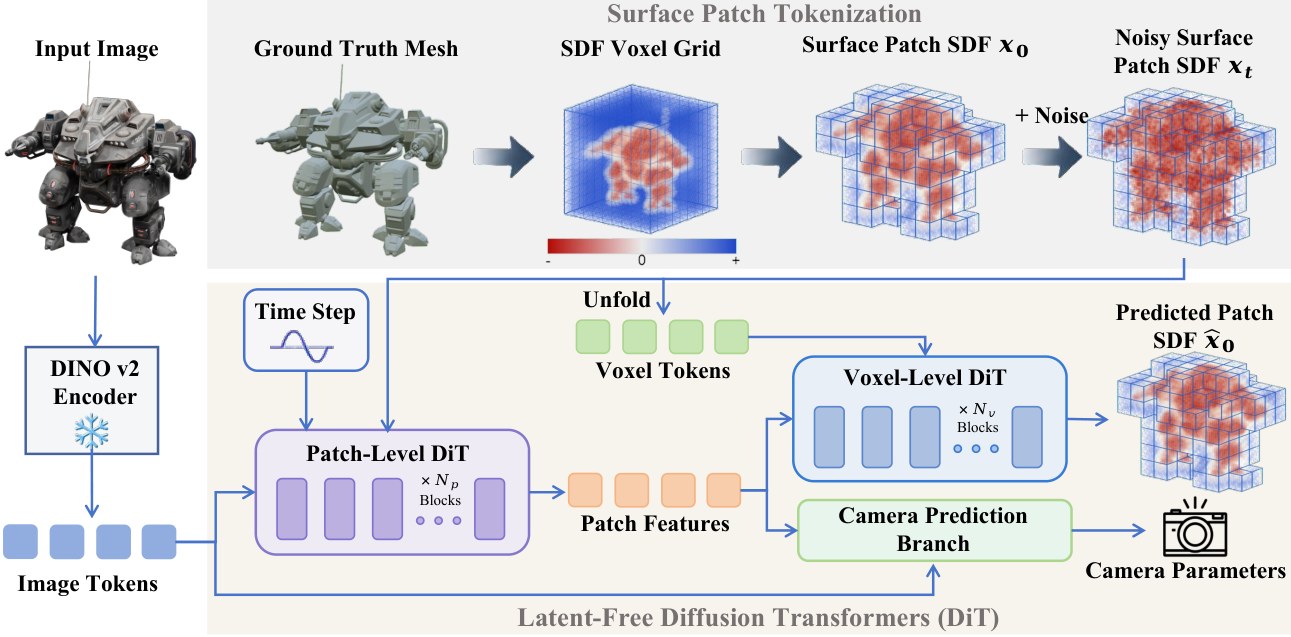
トレーニングとサンプリングはボクセルグリッド上で直接行われ、メッシュはMarching Cubesを通して出力されます。
512、1024、1536の3つのチェックポイントが提供されます。カスケードとしても単一ステージとしても実行でき、開始時の目安となる数値は512と1024で15ステップ、CFG 4です。
ComfyUIで実行する
- Direct3D-V3_Comfyui_Nodes からWindows向けビルドを入手し(Python 3.12とPyTorch 2.8向けがcu128、Python 3.13とPyTorch 2.12.1向けがcu130)、フォルダーを
ComfyUI/custom_nodesに展開します。 - Hugging FaceでDINOv3 ViT-H+へのアクセスをリクエストします。このノードはこれを画像エンコーダーとして使用し、セットアップ時に読み取りトークンの入力を求められます。
- ノードフォルダー内の
setup.cmdを実行します。専用の.runtimePython環境を構築し、PyTorch、DINOv3、1536チェックポイントをダウンロードします。数GBのディスク容量を確保しておく必要があります。 - Direct3D-V3 Clean | Mesh File Path と Refine (Mesh File, Low VRAM) を追加し、メッシュパス、参照画像、前景マスクを接続して、
resolution = 1536とstage_mode = single_stageから始めます。
どちらのノードビルドも自己完結型です。CUDA ToolkitやVisual Studioは不要で、RTX 20から50シリーズ向けのビルド済みボクセライザーを同梱し、ComfyUIは独自のPythonとPyTorchを保持します。アテンションはデフォルトで efficient です。cudnn_fp16 はFP16で高速ですが丸めが変わるため、エクスポートを比較する際はシードを固定してください。
テスターの報告
- ノードパックを開発したMostAadTechは、114,832のボクセルパッチで1536ステージを実行し、予約VRAMピーク6,008 MiB、cuDNNプリセットでドラゴン全体を9分56秒で完了し、縮小はゼロでした。
- 2回目の実行では415万頂点 / 830万三角形が報告され、プロンプトは325秒で完了しました。
- Kijaiは約10万トークンでアクティベーションピーク約4.9 GBを計測し、そのうち約2 GBは常駐し続けるスキップトークンです。
- 実際のフルパイプラインはリファイナー単体より長くなります。Pixal3DまたはTRELLIS.2で粗いメッシュを作り、Qwen-Image-2.1でノーマルマップを生成し、次にDirect3D-V3、最後にUltraTexでテクスチャリングします。
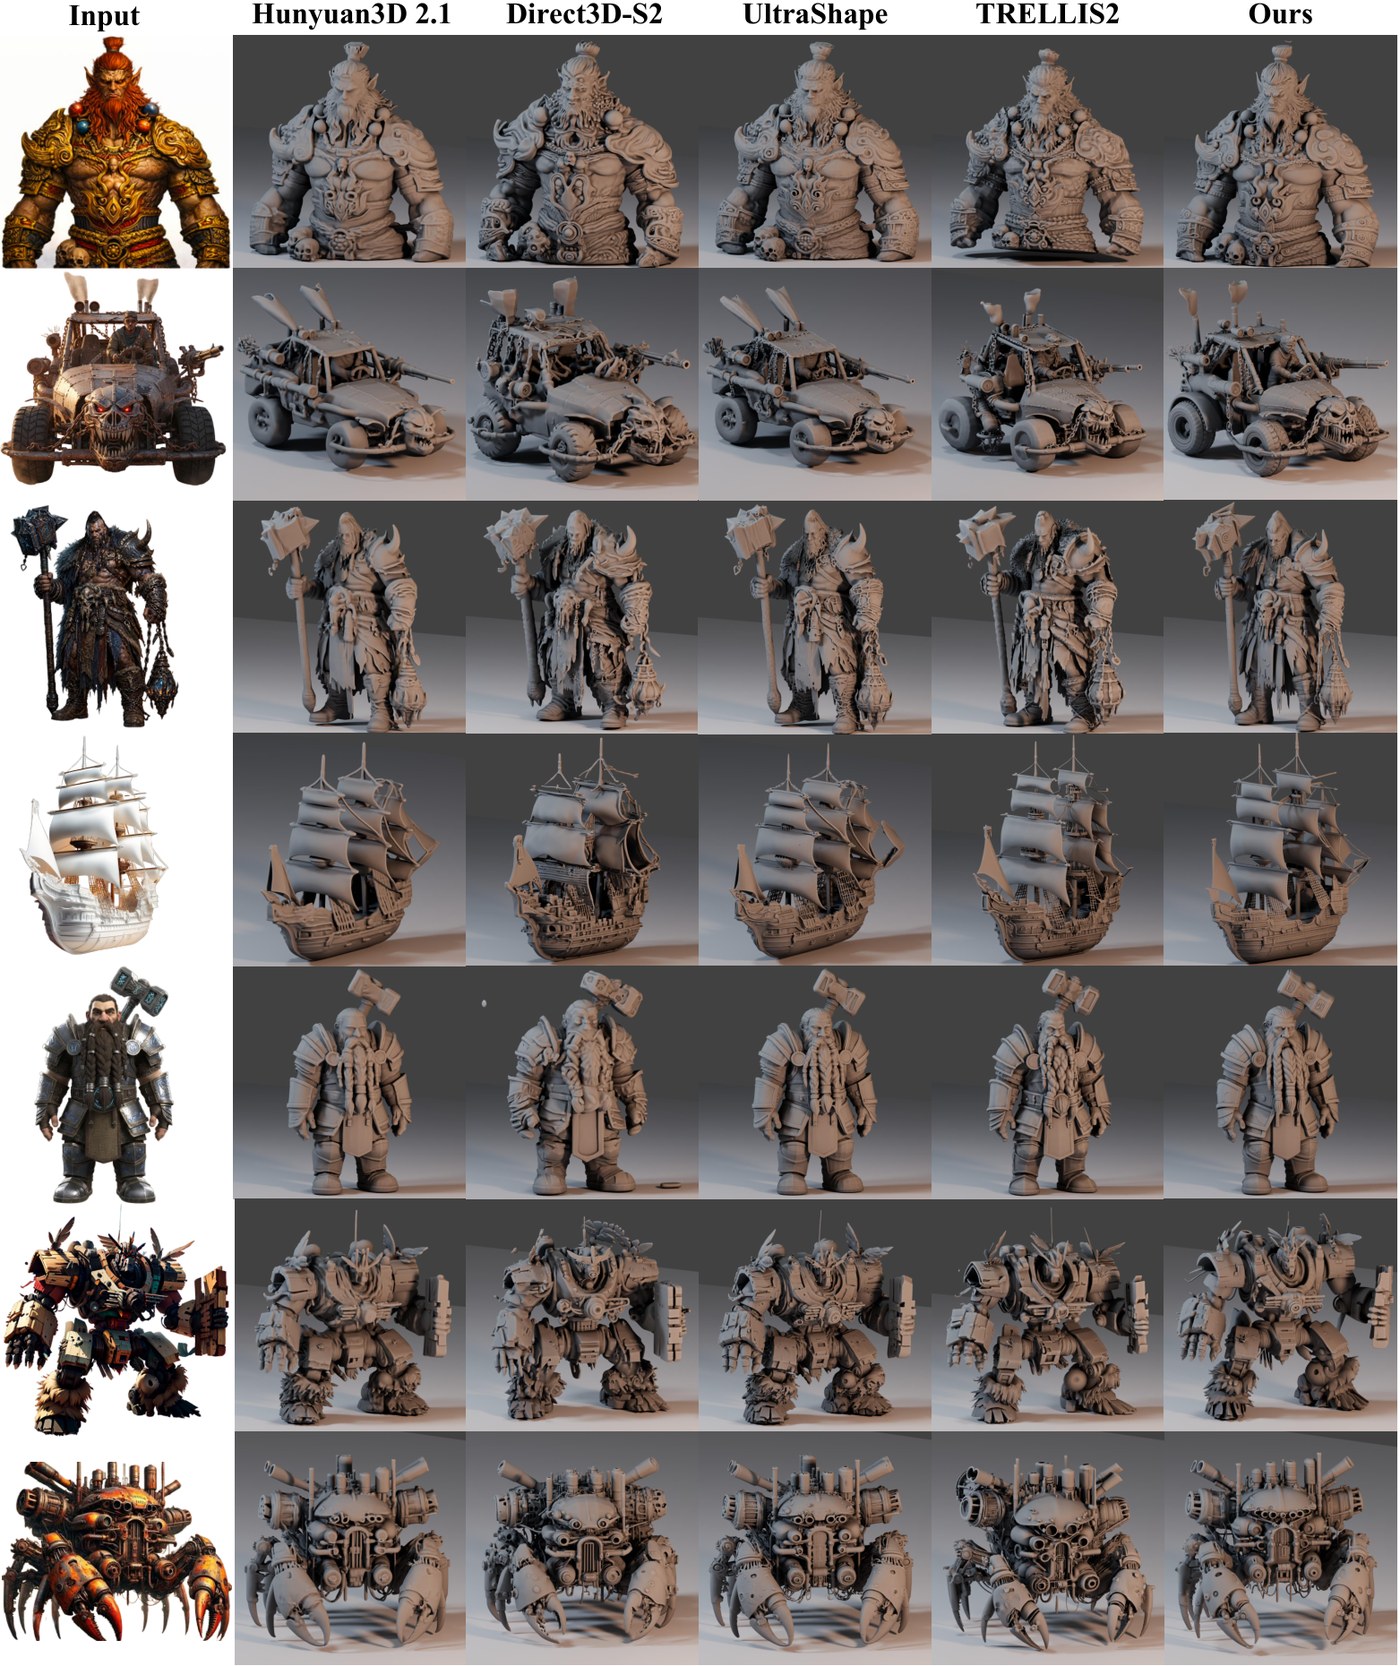
他のオープンソース画像to 3D手法との定性的比較(論文より)。
始める前に
- 今回のリリースに粗いステージは含まれていません。 著者は初期メッシュ用にHunyuan3D-2.1またはUltraShape-1.0を挙げており、独自の粗いモデルはまだToDoリスト上にあります。
- 参照画像の重要性は通常より高くなります。 サーフェスノーマルマップや白いクレイレンダーの方が、テクスチャ付きRGB画像よりも明らかに細かいディテールが得られます。リポジトリではその変換にChatGPT(GPT Image 2.5)またはLotus-2を推奨しており、Qwen-Image-2.1も無料の選択肢として使えます。
- 公開された重みは論文より新しいものです。 公開されたチェックポイントはDINOv3の4レイヤーとMuonオプティマイザーを使用し、論文で評価されたモデルより細かいサーフェスを生成すると著者は述べているため、論文の図は現在の出力を過小評価しています。
- テクスチャリングとトレーニングのコードはまだ公開されていません。 このリリースにはメッシュのリファインメントのみが含まれるため、テクスチャは別のモデルから生成します。
入手先
- 重み: wushuang98/Direct3D-V3(512、1024、1536ステージのチェックポイント)
- 公式コード、Gradioデモ、推論サンプル: DreamTechAI/Direct3D-V3
- 論文: SIGGRAPH Asia 2026、arXiv 2611.26511、結果はプロジェクトページに掲載
- ComfyUIアダプター(Windows): Mstafa-awad/Direct3D-V3_Comfyui_Nodes
コメント
GitHubでサインインしてディスカッションに参加しましょう。