TaoMate-FVSR: 音声からAI動画の顔を復元するComfyUIノード
TaoMate-FVSRは音声をガイドとして生成済み動画のぼやけた口元や誤った口元を再構築し、吹き替え用にリップシンクを合わせます。公式の重みを使うComfyUIノードで動作します。
comfyui分岐があり、ノード、4つのサンプルワークフロー、モデルダウンローダーを備えているため、変換済みcheckpointなしでComfyUI内で動作します。
これは生成済み動画で見られる特定の失敗を対象にしています。顔がぼやけて描画され、歯が白い塊に溶け合い、口元がセリフに追従しない、というものです。そこにあるものを強調すると壊れた形状が残り、顔を再生成すると別人になってしまいます。TaoMate-FVSRは両方を同時に行い、音声で口元を駆動し、参照フレームで同一性を保ち、以前に生成されたフレームでショットを安定させます。
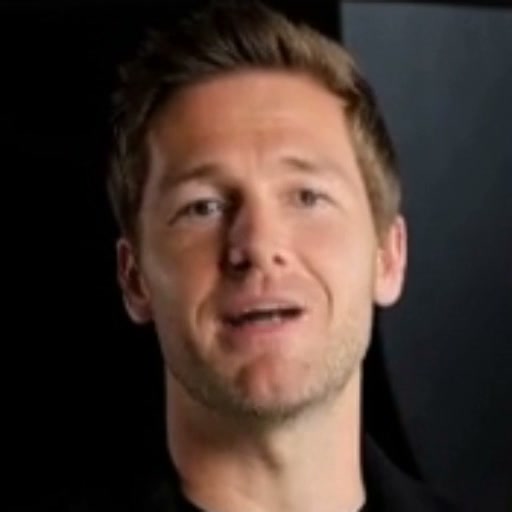 | 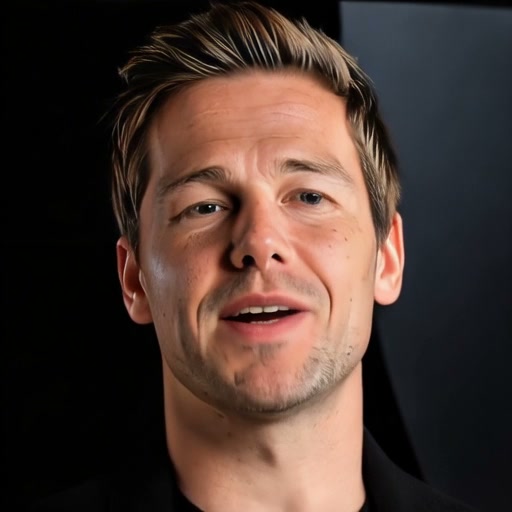 |
|---|---|
| 入力 512×512 の顔クロップ | TaoMate-FVSRの出力、同じフレーム |
プロジェクトによる同期された比較クリップ、25 fpsの顔クロップ。
クリップに対して行うこと
- フルシーンモード。 頭部をクロップして復元し、色とマスクをブレンドしてから元に貼り付けます。出力はソースの解像度、フレームレート、音声を維持するため、既存の編集にそのまま組み込めます。
- ビジュアルダビング。 元のトラックの代わりに差し替え音声を入力すると、口元がその音声に合わせて再タイミングされます。
- 参照フレーム。 デフォルトでは最初のフレームがGPENを一度通って同一性参照を構築します。自分で編集した最初のフレームを指定することもでき、論文の「Ours+」バリアントではGPT-Imageで強化したフレームを使っています。肌とディテールは良くなりますが、ピクセルは正解データからより離れます。
150クリップのトーキングヘッドベンチマークでは、比較対象の復元ベースラインの中で最高のLPIPS(0.0793)とDISTS(0.0858)を記録し、リップシンクスコア(Sync-C 7.413)でも最高でした。数値を判断する前に知っておくべき注意点が1つあります。強化ベースのバリアントはPSNR(23.52)で低いスコアになる一方、知覚品質(MUSIQ 77.62)で最高スコアを記録しています。つまり、ここでは「復元された」ことと「正解データに一致する」ことは同じではありません。
ComfyUIで実行する
ComfyUI/custom_nodesでcomfyui分岐をクローンします:git clone --depth 1 --single-branch --branch comfyui https://github.com/TaoLiveAIGC/TaoMate-FVSR.git ComfyUI-TaoMate-FVSR- ComfyUI自身のPythonで要件をインストールします。既存のCUDA PyTorchビルドは維持してください。
- モデルファイルを取得します:
python scripts/download_models.py --dest ../../models/TaoMate-FVSR --gpen-source-dir ../../models/TaoMate-GPEN-source。サイズとSHA256を確認し、途中までのダウンロードを再開します。 - 4つのサンプルワークフローのいずれかを開きます。
yolo-gpen-workflowは顔の自動クロップを伴うフルシーンの経路で、cropped-face-workflowは準備済みの512×512の顔から開始します。
モデルと設定ファイルで約14.89 GB、テストした最長のクリップではシステムRAM 32 GBを見込んでください。16 GB VRAMという目標値はメモリ上限を設定したH20で測定されたもので、コンシューマー向けカードではありません。8/12 GBでの動作は未テストです。Linux、Python 3.10、PyTorch 2.9が動作確認済みの構成で、Windowsのパスは文書化されていますが未確認です。
1×か2×か
モデルは2つのスケールで動作します。1×は顔クロップを512×512に保つデフォルトで、2×は1024×1024でより多くのディテールを得る代わりにVRAMを多く必要とし、結果は貼り戻す前に512×512へ縮小されます。デフォルト値はconfig.jsonにあり、10ステップ、ノイズ0.8、shift 5.0、音声ガイダンス4.0、参照ガイダンス1.7、シード42です。
入手先
- 重み: TaoLiveAIGC/TaoMate-FVSR、単一の
TaoMate-FVSR.safetensorsとconfig.json。 - コードとComfyUIノード: TaoLiveAIGC/TaoMate-FVSR、インストールガイドは英語と中国語。
- 論文: arXiv 2611.03393。さらに多くの比較はプロジェクトページにあります。
ComfyUI分岐は実験的とされています。手動インストールで、ComfyUI Managerには登録されておらず、ノード専用のcheckpointを提供するのではなくオリジナルの重みを再利用します。
コメント
GitHubでサインインしてディスカッションに参加しましょう。