ComfyUI v0.45.0でQwen3.xのテキスト生成が2倍高速化:RTX 5090では毎秒219トークン
ComfyUI Wikinews
ComfyUI v0.45.0はQwen3.xのテキスト生成を書き換えました。RTX 5090上のQwen3.5 9Bは毎秒106トークンから219トークンへ高速化。適応ツリーMTPとINT8アテンションを採用しています。
Comfy Orgは11月11日にComfyUIのエンジニアリング記事を公開しました。Qwen3.xのテキスト生成パスが書き換えられ、同じGPU上で同じチェックポイントが最大2倍高速に動作します。モデル自体や生成されるテキストに変更はありません。ここで扱われている内容はすべてComfyUI v0.45.0で提供されます。
ComfyUIでのプロンプト強化、画像キャプション生成、ストーリー執筆はいずれもテキスト生成であるため、この高速化の恩恵をそのまま受けられます。設定が必要なのはGenerate Textノードのmtpオプションだけで、デフォルトではautoのままです。
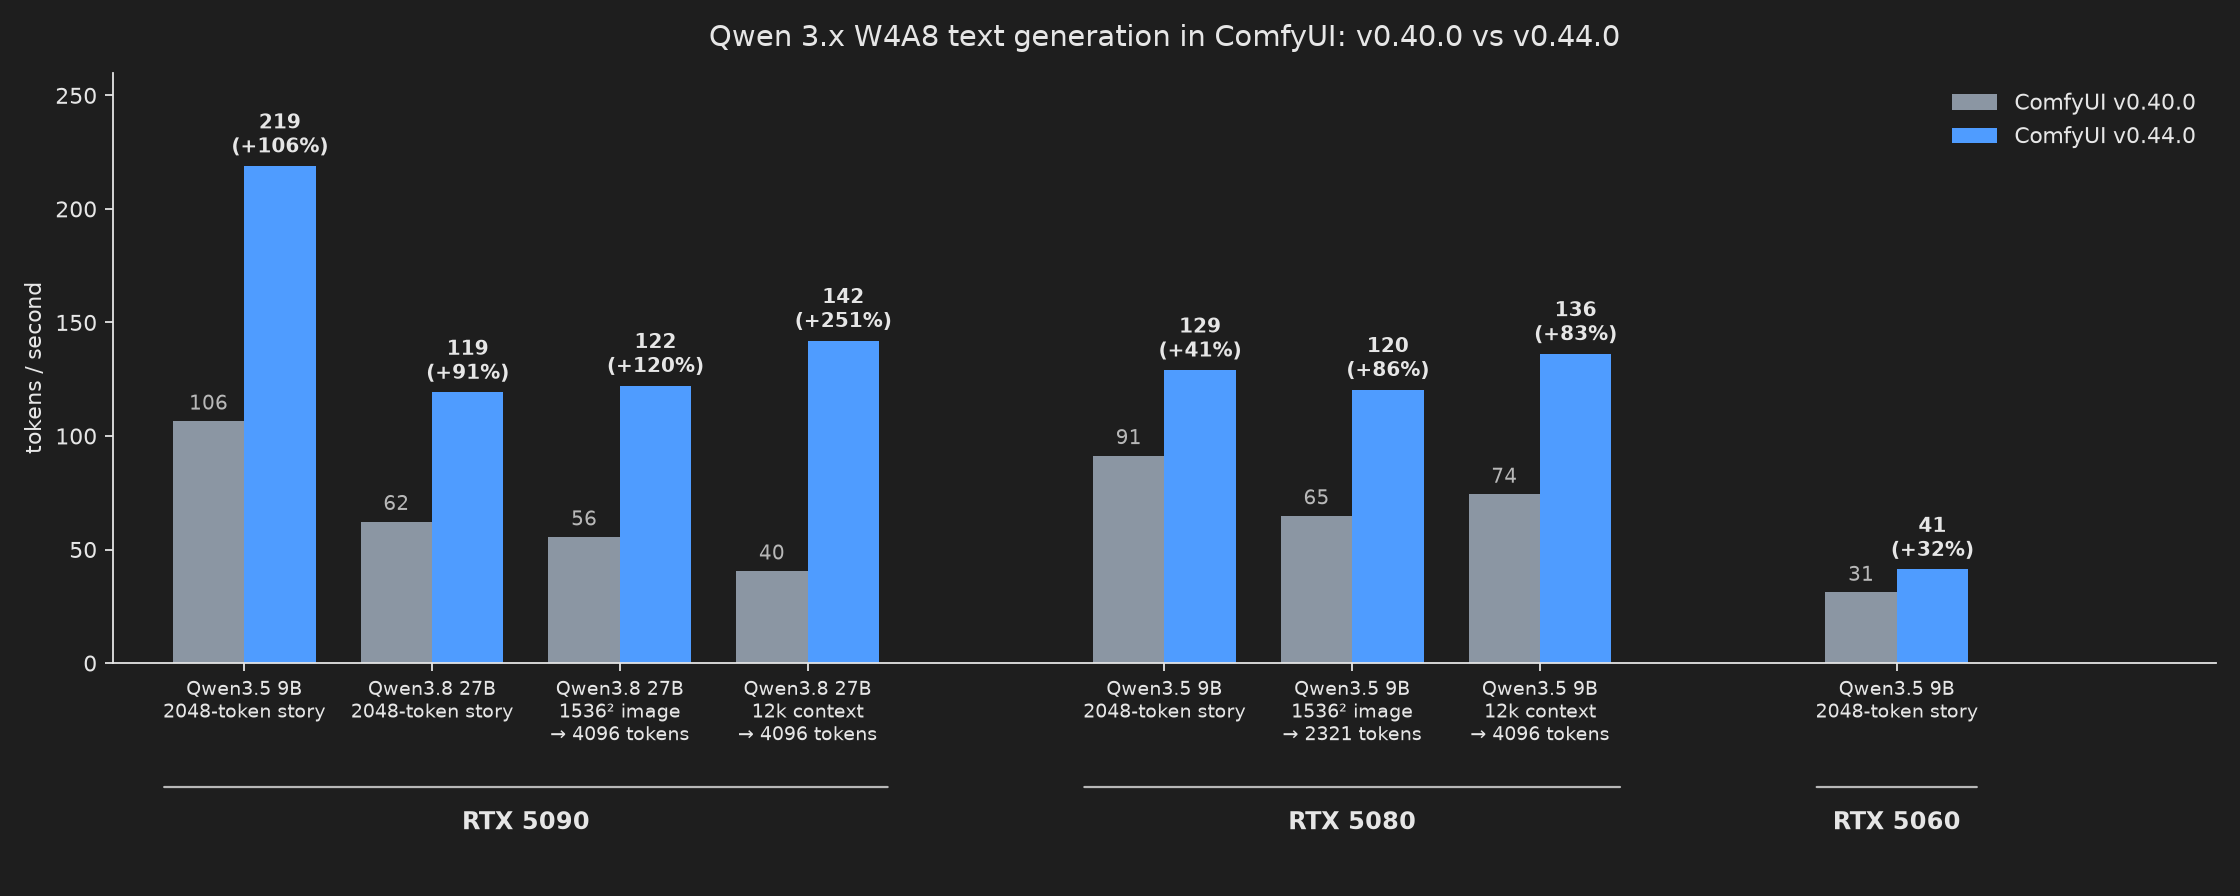
書き換えを発表したComfy-Orgのエンジニアリング記事より。
計測されたトークン速度
| チェックポイント | GPU | 変更前 | v0.45.0 |
|---|---|---|---|
| Qwen3.5 9B | RTX 5090 | 106 tok/s | 219 tok/s |
| Qwen3.5 9B | RTX 5080 | 91 tok/s | 129 tok/s |
| Qwen3.8 27B(1536×1536画像の説明時) | RTX 5090 | 55 tok/s | 122 tok/s |
Qwen3.8 27B W4A8は、RTX 5090上で1500×1500の画像を説明しストーリーを執筆する際に毎秒137トークンに達しました。
変更点
- 行列ベクトルカーネル: W4A8とW6A8の重みは、カーネルが読み込む順序でグループごとのスケールとインターリーブされるようになりました。これにより各スレッドブロックは2つのテンソル間を行き来するのではなく、連続した領域を1回でストリーミングできます。再レイアウトはモデル読み込み時に1回だけVRAM上で行われ、追加のRAMやVRAMコストはかかりません。
- 適応ツリーMTP: multi-token-predictionヘッドは単一の推測チェーンをドラフトしなくなりました。次点のトークンを兄弟として保持し、最大8行を1パスで検証し、32ステップごとにツリーの形状を再計画します。コード、リスト、出力内で再利用されるプロンプトは深さが有利に働き、創作的な文章では広さが有利に働きます。
- Comfy-Kitchenアテンション: LLMのアテンションパスに対するINT8アテンションとKVキャッシュのサポートにより、KVキャッシュのVRAM使用量を削減し、長いプロンプトやシステムプロンプトのプリフィルを高速化します。
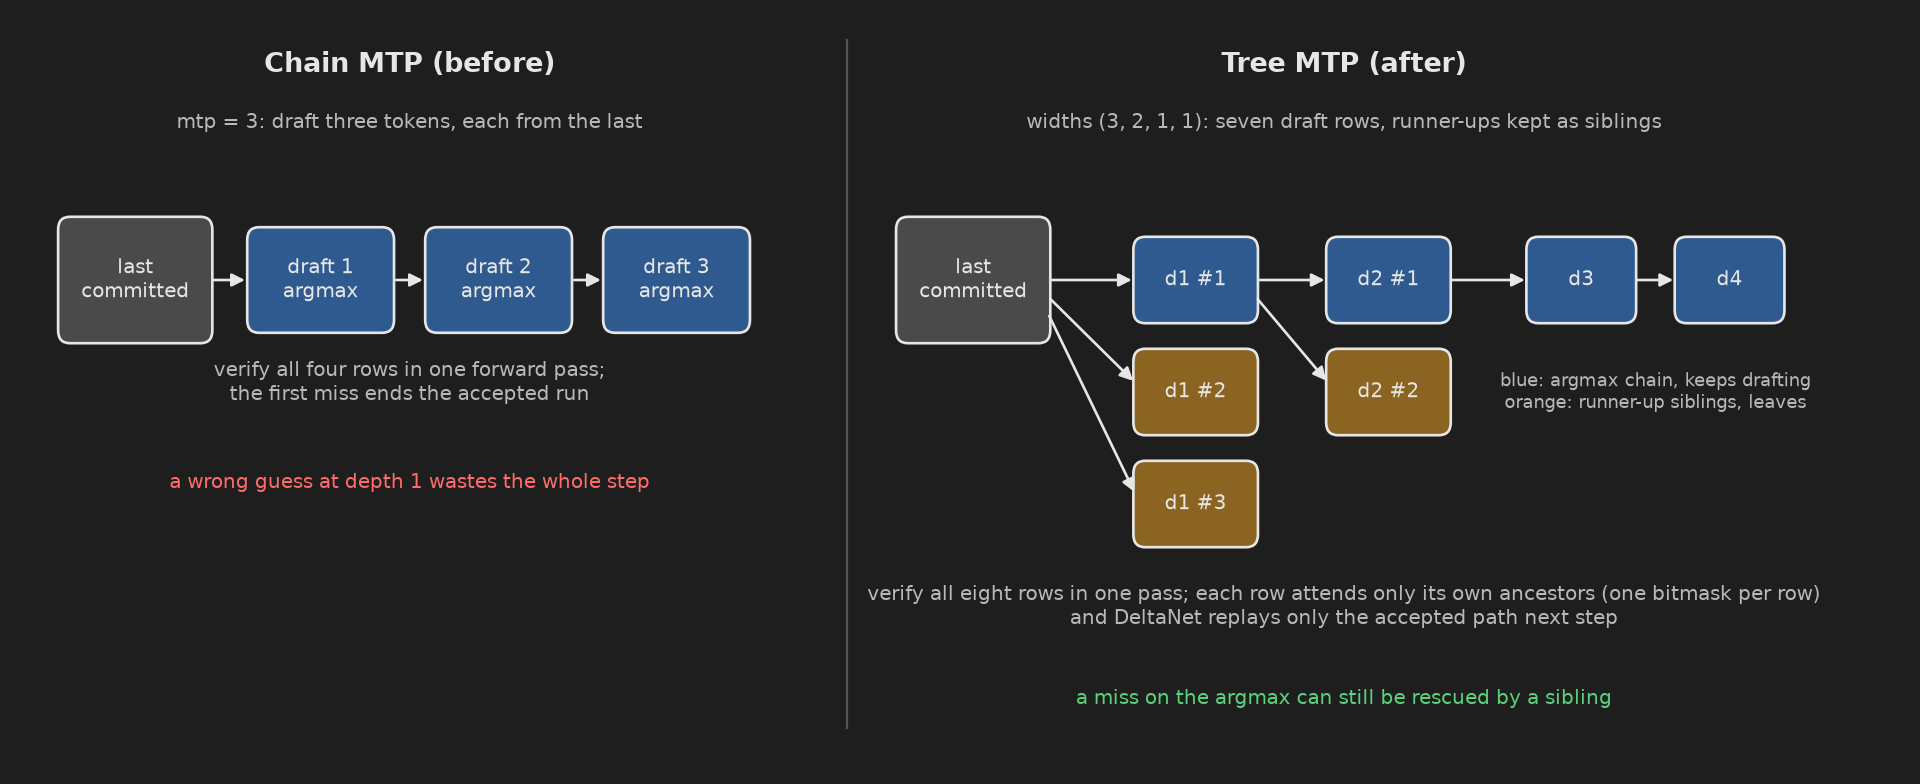
チェーンMTPは1つのパスをドラフトしますが、ツリーMTPは次点のトークンを兄弟として保持し、まとめて検証します。
有効化の手順
- ComfyUI v0.45.0以降に更新します。
- Qwen3.xのチェックポイントを読み込み、
Generate Textノードで実行します。 mtpはautoのままにします。ピン留めした値2から5は引き続きドラフトの深さを固定し、tree*モードは広さと深さの両方を固定します。- 任意: Comfy-Kitchenアテンションを使うには、
--use-ck-attentionを付けてComfyUIを起動します。これにはアテンションをサポートしたComfy Kitchenのビルドが必要です。
上記はすべてNVIDIAとAMDのGPU、WindowsとLinuxで動作し、以前はメモリ不足になっていた長いコンテキストも収まるようになりました。ノードのツールチップにある1点の注意: MTPの出力は正しく分布したままですが、同じシードでも非MTPの出力とは異なります。
コメント
GitHubでサインインしてディスカッションに参加しましょう。