ComfyUIのWeVisOne-VL:1つのプロンプトからボックス、マスク、マットを生成
TencentのWeVisOne-VLがComfyUIコアで動作するようになりました。1つのDetectノードがテキストクエリからボックス、マスク、アルファマット、点、カウント、OCRボックスを生成します。
WeVisOne-VL はTencent WeChat Visionのビジョンモデルで、現在はComfyUIコアで動作します。このサポートは2026-11-09に PR 17632 として追加されました。画像とフレーズを渡すと、ボックス、マスク、アルファマット、点、カウント、またはOCRボックスが返ってきます。SAMもカスタムノードも、別個のセグメンテーションバックエンドも不要です。
2Bと4Bのチェックポイントは、960万パラメータのマスクデコーダを備えたQwen3-VLのファインチューニング版です。ノードはフレーズを読み取り、座標をプレーンなトークンとして書き出し、デコーダが該当するトークンをピクセルレベルの出力に変換します。
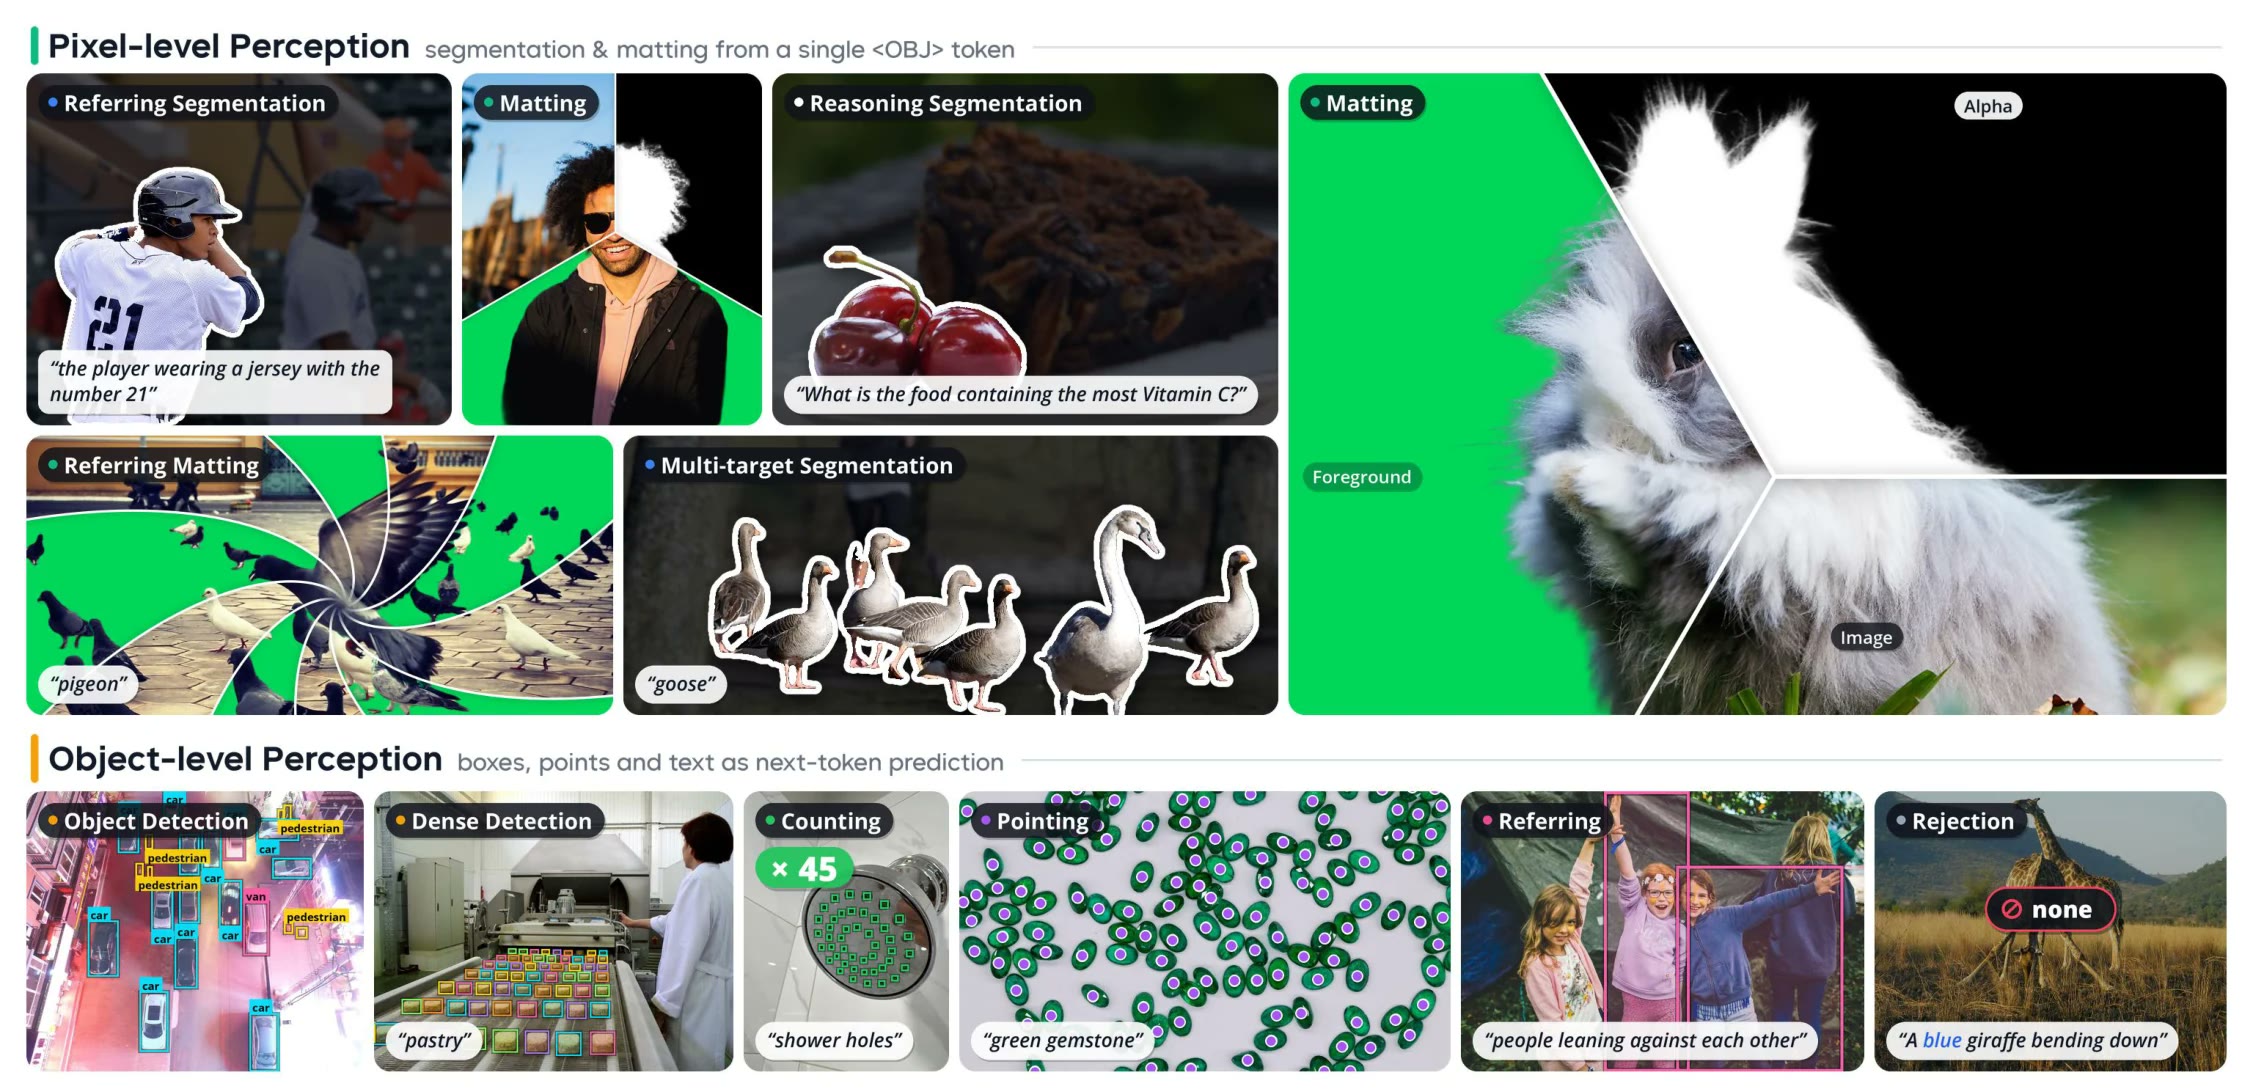
1つのモデルで点、ボックス、バイナリマスク、連続的なアルファマットをカバーします。ソース:プロジェクトページ
ノードが返すもの
WeVisOne-VL Detect は image/detection にあり、masks、bboxes、points(ピクセル座標のJSON)、および生の回答テキストの4つの出力を持ちます。何が得られるかは、選択するタスクによって異なります。
| タスク | 入力する内容 | 出力 |
|---|---|---|
segmentation | フレーズ(例:person) | ボックスとインスタンスごとのアルファマット |
detection | 1行に1ラベル | ボックス(Draw BBoxes にそのまま使用可能) |
referring | 対象を説明するフレーズ | 該当オブジェクトのボックス |
point | 1行に1ラベル | JSON形式の点座標 |
count_box / count_point | 対象(例:cars) | カウント(ボックスまたは点付き) |
ocr | 空欄のまま | すべての単語をボックスとして |
ocr_grounding | テキスト文字列 | そのテキストの位置 |
visual_prompt | 別の実行からの参照ボックス | 参照に類似したオブジェクト |
freeform | プロンプト全体 | 生の回答 |
individual_masks をオンにすると、単一の結合マスクではなく、ボックスごとに1つのマスクを保持します。切り抜きには、masks と画像を InvertMask + JoinImageWithAlpha に接続します。
すべての座標は <0> から <1000> までの1トークンであるため、ボックス1つにつき4トークンかかります。ソース:プロジェクトページ
実行方法
-
ComfyUIをアップデートします。 ノードはmasterにあり、最新タグ(v0.44.2)にはまだ含まれていません。
-
Comfy-Org/WeVisOne-VL から重みをダウンロード し、
ComfyUI/models/text_encoders/に配置します。リパックには4つのファイルが含まれています:ファイル サイズ wevisone_vl_4b_bf16.safetensors9.7 GB wevisone_vl_4b_int8_convrot.safetensors5.3 GB wevisone_vl_2b_bf16.safetensors4.9 GB wevisone_vl_2b_int8_convrot.safetensors2.9 GB -
CLIPLoaderをロード し、タイプをstable_diffusionに設定してこれらのファイルのいずれかを選択し、ノードのclip入力に接続します。
PRの3グループの例:人物のアルファマッティング、検出、OCR。3つの LoadImage ノードを自分の画像に差し替えてください。
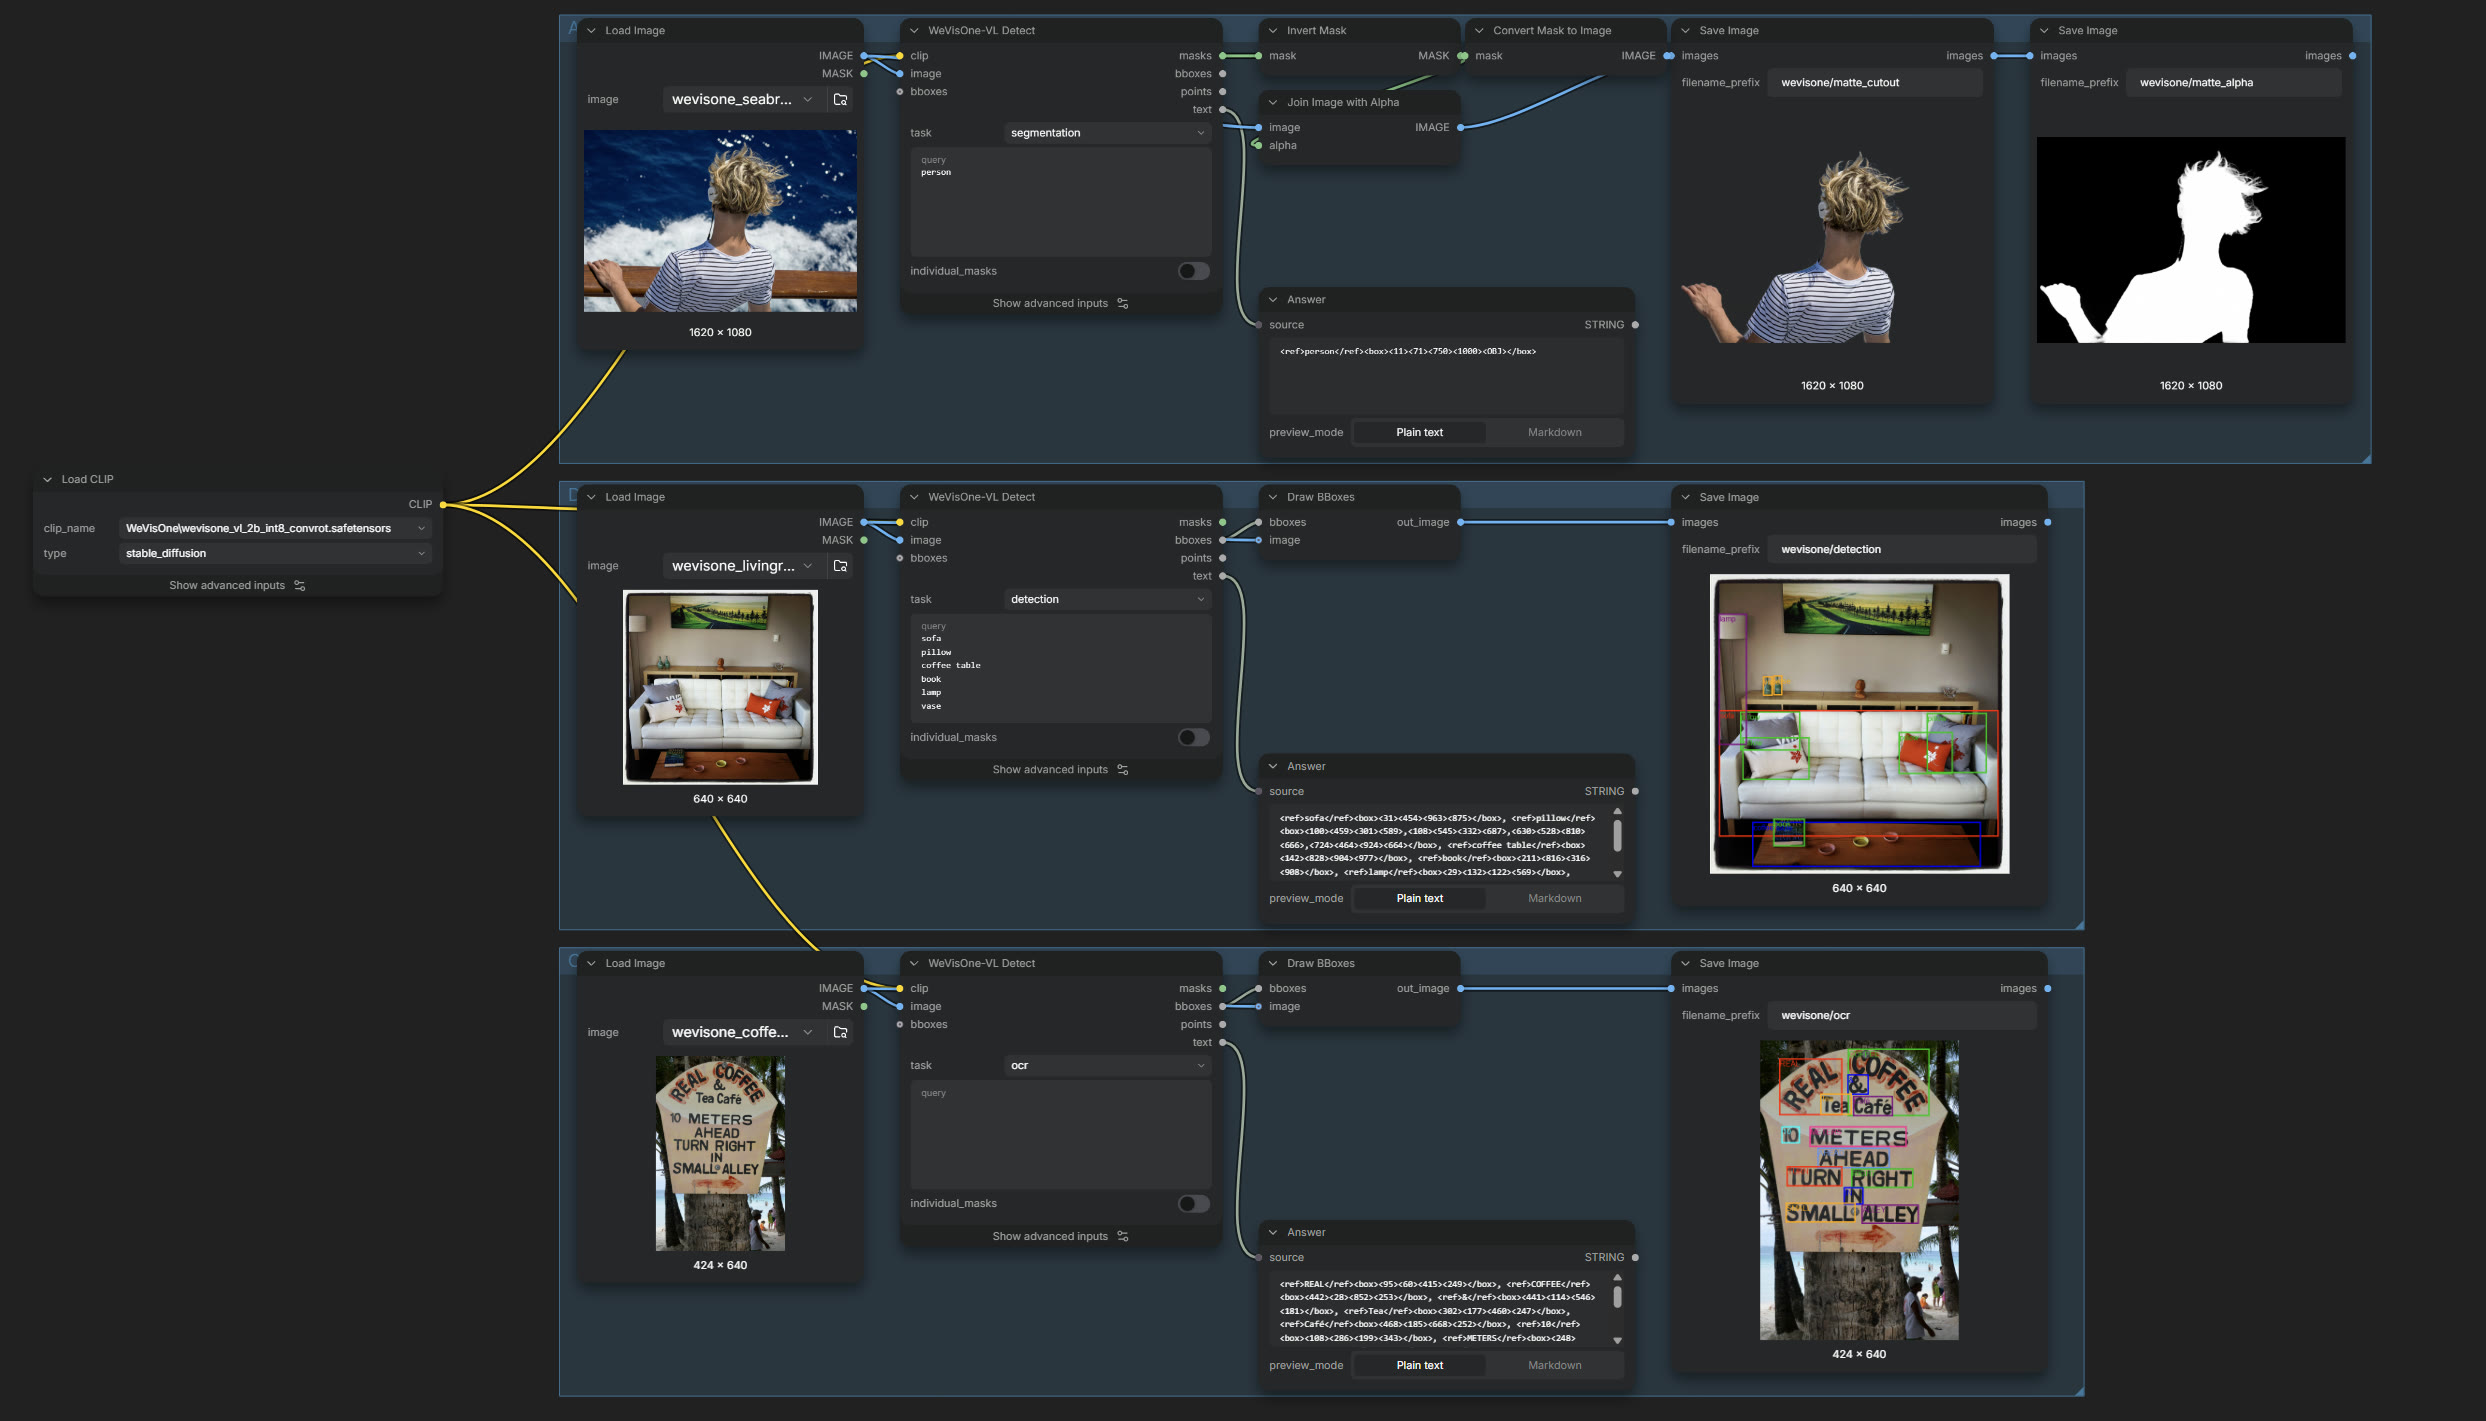
アルファマッティング、検出、OCRを1つのグラフで。ソース:PR 17632
性能
4Bモデルの主要な数値を、各ベンチマークで最強のオープンベースラインと比較します:
| タスク | ベンチマーク | ベースライン | WeVisOne-VL-4B |
|---|---|---|---|
| 検出 | LVIS, F1 | 50.7 | 55.3 |
| 存在しない対象の棄却 | WeRef-Bench | 73.0 | 96.4 |
| OCR | TotalText, F1 | 43.3 | 52.0 |
| 参照セグメンテーション | ReasonSeg, gIoU | 65.0 | 71.2 |
| ボックスマッティング | P3M-500-NP, MAD(低いほど良い) | 15.4 | 7.3 |
グラフの中で重要なのは棄却の行です:フレーム内に存在しないものを要求すると、モデルはボックスを捏造する代わりに None と書き出します。
制限
- 単一画像のみ。ピクセルデコーダは動画グリッドを拒否するため、これはトラッキングノードではありません。
- 重度のオクルージョンや透明な被写体では、細かいアルファの辺がずれることがあり、クエリの言い回しによって結果が変わります。
detectionとpointは1行に1ラベルを要求します。カンマ区切りのリストは1つのフレーズとして読み取られます。
オリジナルの重み:tencent/WeVisOne-VL-4B と 2B。読み込まれるのは上記のComfyUIリパックです。
コメント
GitHubでサインインしてディスカッションに参加しましょう。