Open-H3-Regenerate-2K-IC: 顔とテキストを保つH3ドラフトの2K/4KリファインLoRA
NVlabsがOpen-H3-Regenerate-2Kのin-context版を追加しました。MiniMax H3のドラフトを2Kまたは4Kで描き直しながら、顔、リップシンク、画面上のテキストをそのまま保つLoRAです。
Open-H3-Regenerate-2K-IC は、NVlabsによるオープンなMiniMax H3リファイナーの第2バージョンです。10月のリリースと同じ役割を果たし、1344x768のドラフトを3ステップで2Kまたは4Kに引き上げます。変更点はドラフトをどこに置くかです。最初のバージョンはドラフトに再度ノイズを加えて仕上げるため、顔や口の形、小さな文字がずれていました。ICバージョンはドラフトをRef2VA transformerのコンテキスト内でクリーンなまま保持し、その横でノイズから高解像度クリップを描画するため、同一性、リップシンク、看板のテキスト、レイアウトがドラフトに追従します。
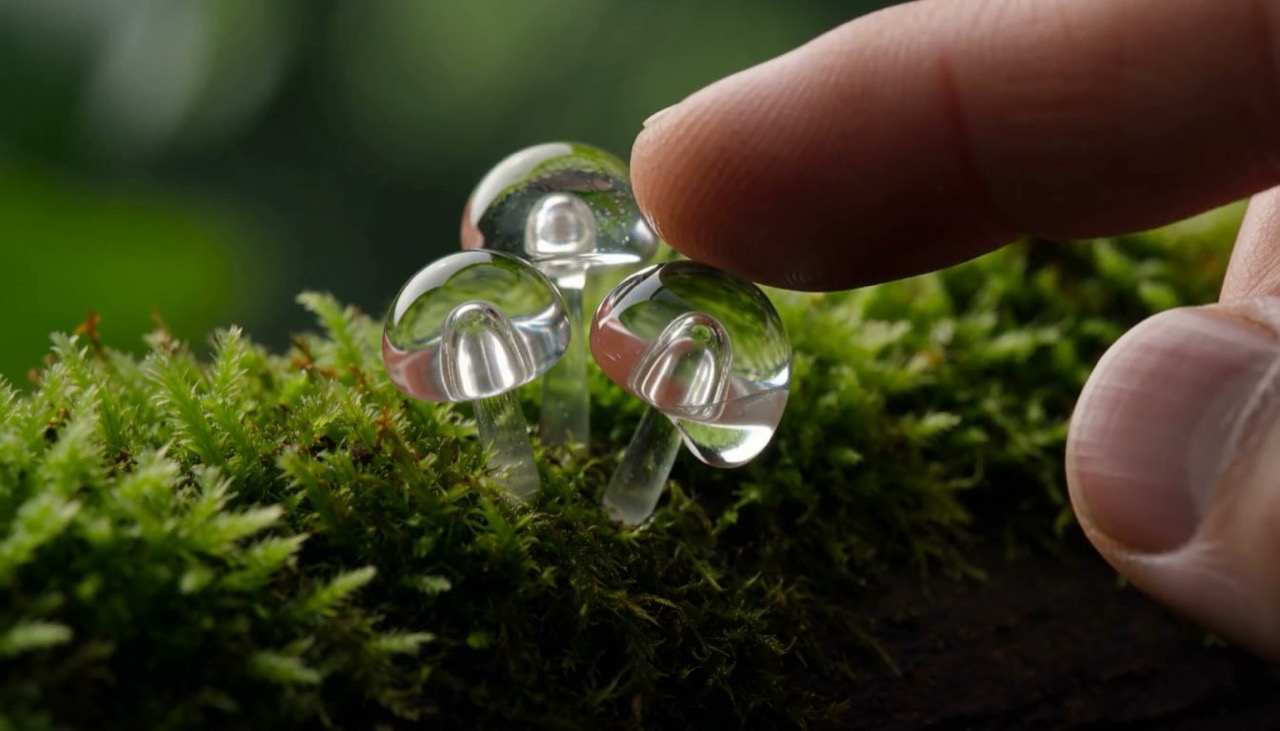 | 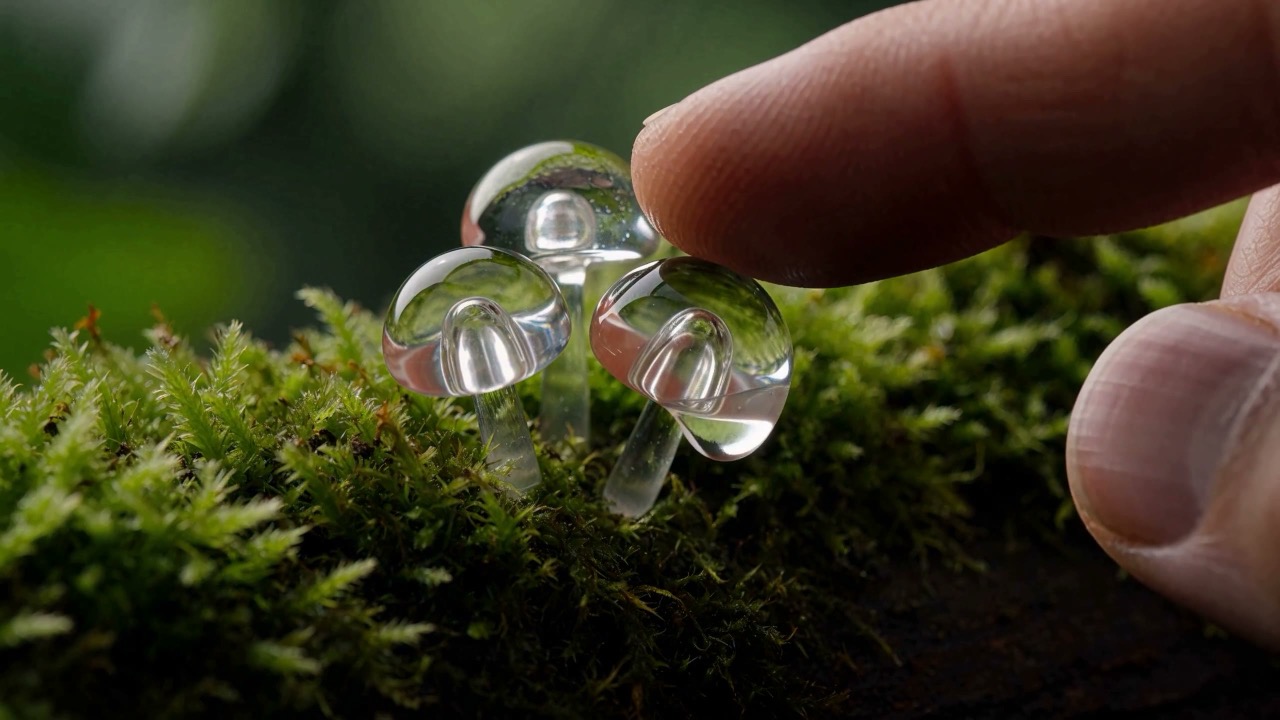 |
|---|---|
| H3ドラフト、1344x768 | ICパス後の同じフレーム、2560x1440 |
プロジェクト自身の比較クリップからのフレーム。ソース: プロジェクトページ
そのクリップのIC出力(2560x1440、ドラフトの音声付き)。ソース: プロジェクトページ
保持されるもの
公式のH3-Regenerate-2K APIと比較すると、プロジェクトの駐車場の比較が最も分かりやすい例です。APIでは看板が判読できない記号になるのに対し、ICバージョンでは「PRIVATE CAR PARK」と読めます。最初のオープンバージョンと比べると、IC出力は新しいテクスチャの追加は少ないものの、目、しわ、口の形をドラフトの位置のまま残します。
IC LoRAは、参照動画を追加トークンとして読み込むフローズン状態のRef2VA transformer上でトレーニングされています。各トレーニングペアは実際の768Pから4Kのクリップで、サイズを縮小したコピーがクリーンな参照として前面に置かれ、ターゲットは純粋なノイズからクリーンな状態まで任意のレベルでノイズ化され、損失はターゲットトークンにのみ適用されます。
実行方法
768Pのドラフトを <Video 1> として、それを生成したキャプションをそのまま添えて渡します。サンプラーは3種類で、いずれもCFG 1です。
up3(デフォルト): ドラフトの潜在が3D-conv潜在アップスケーラーを通り、sigma 0.835までノイズ化され、3回のtransformer呼び出しで完了します。up4: 同じアップスケール済みの開始状態をsigma 0.923で、4回の呼び出し。hf8: 純粋なノイズから、HyperFlowの8ステップすべて。
出力は1080p、2K(2560x1440、デフォルト)、4K(3840x2160)です。384P、512P、576Pのドラフトは768Pで返されます。音声はドラフトから変更なしでコピーされ、無音の音声潜在がウェイトとともに同梱されています。2Kの結果は高速なH3 VAEでデコードされ、4KではスタンダードなVAEを使用します。
ComfyUIでの利用
公式ノードはありませんが、すでに2つのコミュニティ製の方法があります。
- Kijaiが8.3 GBのFP32 LoRAを200 MBのrank-21 bf16ファイルに圧縮しており、Ref2VAモデルに通常のLoRAとして読み込めます。
- ComfyUI-OpenH3Regenerate2KIC は4つのノード(Prepare Draft、Official Prompt、Sigma Grid、Compose Target Latent)、フルランクの5.9 GBに変換されたLoRA、3つのワークフロー(テキストからドラフト、そして2Kへ/参照画像からドラフト、そして2Kへ/ドラフトから2Kへ)を提供します。
ウェイトと推論コードはHugging Faceに、参照用CLIはNVlabs/Sanaにあります。
コメント
GitHubでサインインしてディスカッションに参加しましょう。