Fizgig 9.2がMOSS-Image LoRAのトレーニングを20分に短縮
Fizgig 9.2はPyTorch 2.15と高速化したMuonステップへ移行しました。RTX 5090上でMOSS-Image LoRAが49分ではなく約20分でトレーニングでき、メモリ使用量は3分の1になります。LoRAはComfyUIで読み込めます。
11月8日にリリースされたFizgig 9.2は、すべてのトレーニングをより速く、より軽くします。中でもMOSS-Imageが最も大きな効果を得ています。RTX 5090では、MOSS-Image LoRA(94枚の画像、バッチ1、Muon、70エポック)が49分ではなく約20分で完了し、類似度スコアは同等かそれ以上でした(リリースノート)。
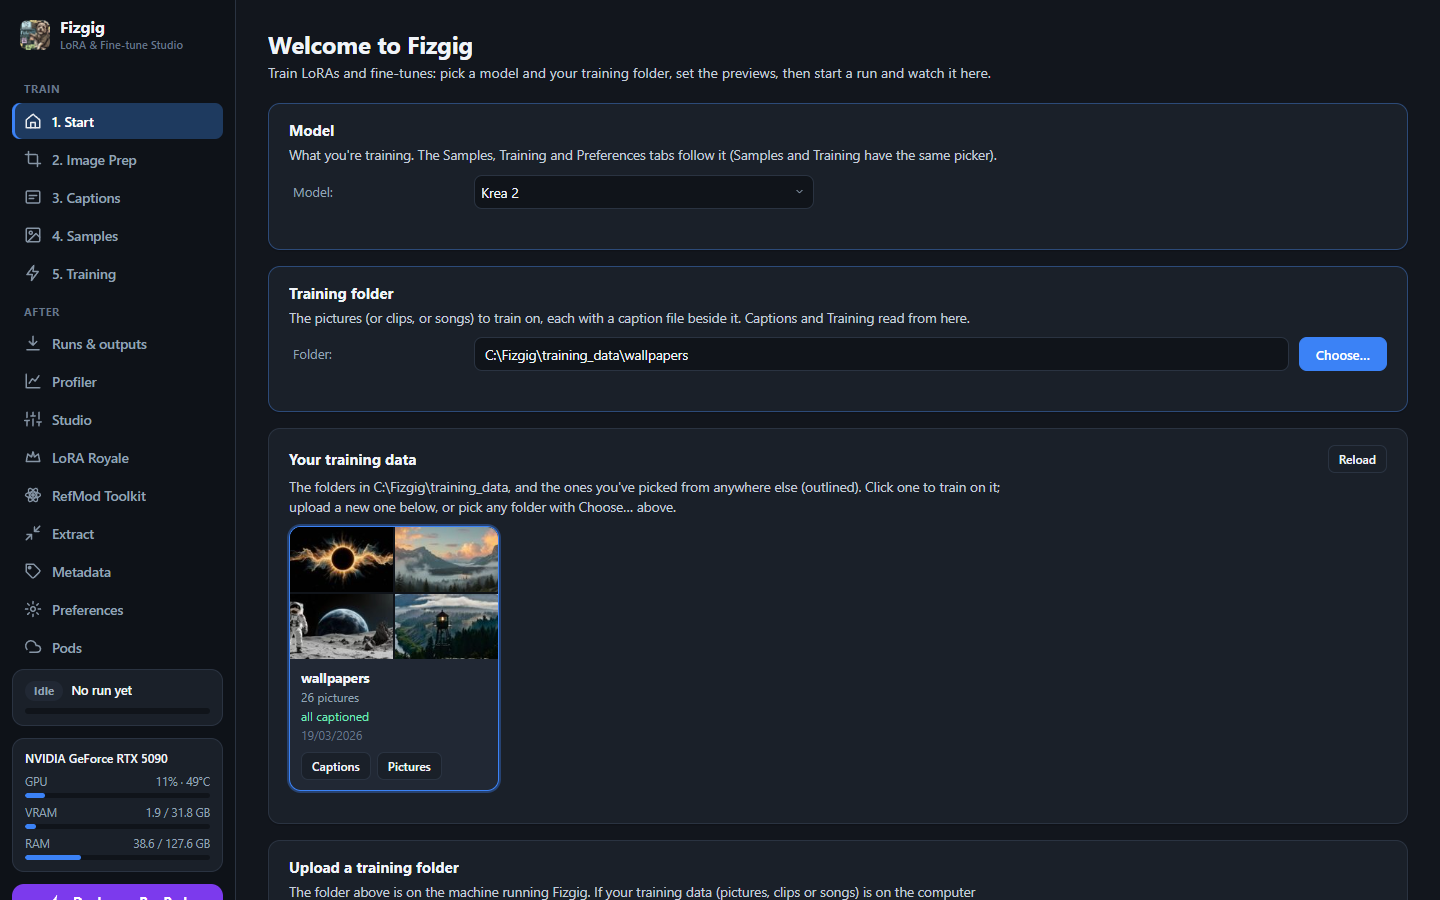
Fizgigの起動タブ。トレーナーは単独で動作し、kohya形式のLoRAをComfyUI/models/loras/に保存します。
数値
| RTX 5090でのMOSS-Image LoRA | 9.2 以前 | 9.2 |
|---|---|---|
| 94枚の画像、バッチ1、Muon、70エポック | 49分 | 約20分 |
| メモリ、バッチ3、gradient checkpointing | 21.7 GB | 7.1 GB |
バッチ3では、トレーナーは同じカードでOneTrainerの1ステップ1.07秒に並びながら、より少ないメモリ(7.4 GBに対して6.9 GB)で動作します。そのため、バッチ実行は妥協ではなく実用的な選択肢になっています。
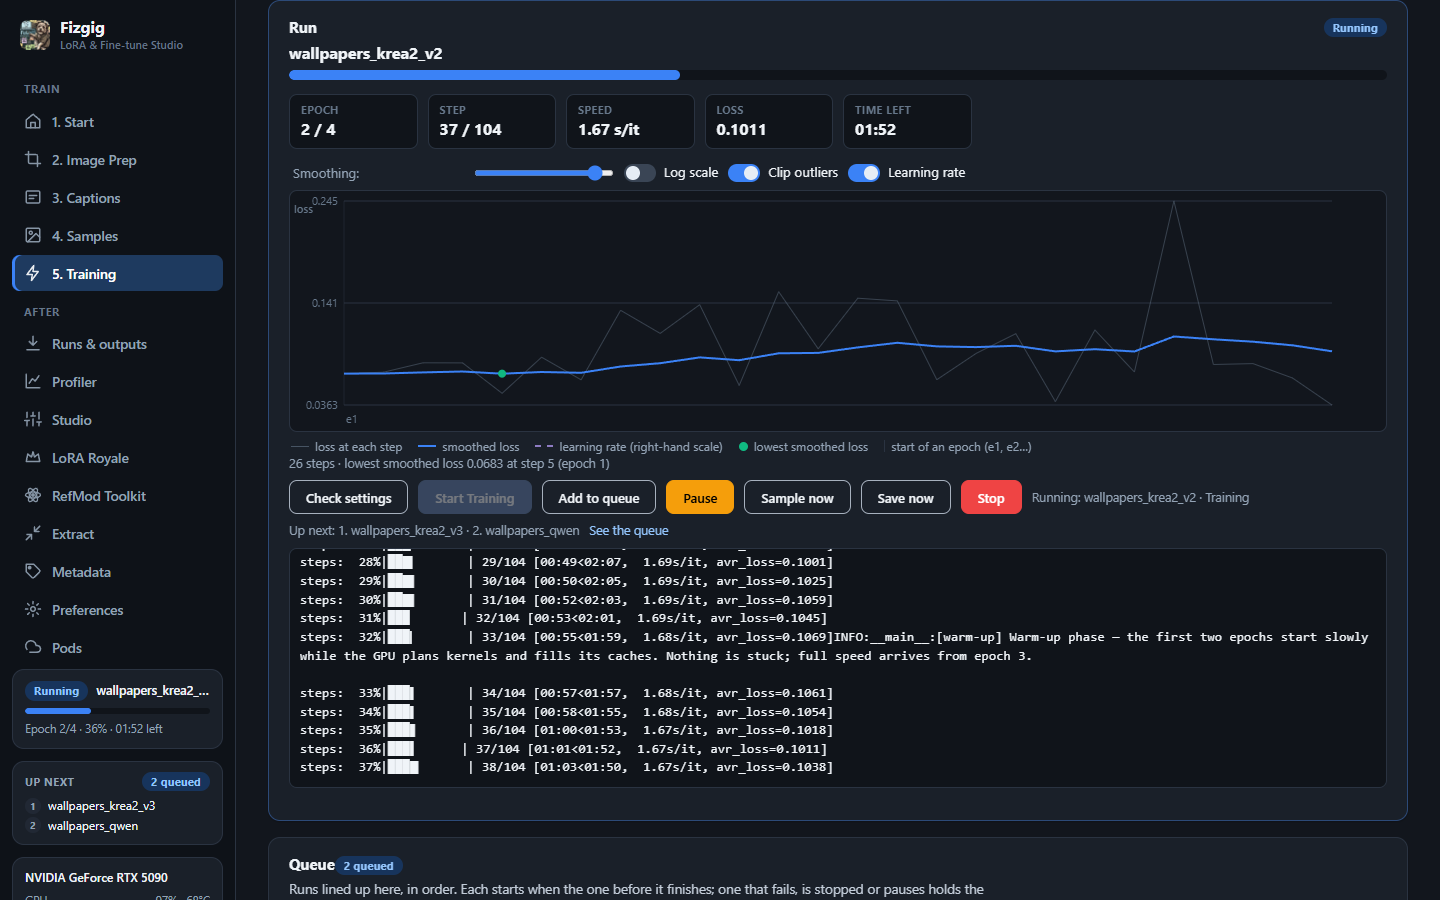
トレーニングタブでの実行の様子。サイドバーにキューが表示されています。
変更点
- PyTorch 2.15。 gradient checkpointingを有効にすると、メモリが大幅に削減されます。バッチ1のKrea 2は22.9 GBから14.9 GBになります。16 GBのノートPC向け4090では、Fibo 2.0のトレーニングが22%高速化し、Kleinが13%、Krea 2が11%高速化します。
- 高速化したMuonステップ。 LoRAの行列を1つずつではなくまとめて処理するようになりました。12倍高速で、結果は同じです。LoKRのトレーニングはすべてのモデルで4〜6倍高速になります。
- バッチの高速化。 長さの異なるキャプションがアテンションを遅くすることがなくなりました。MOSS-Imageではステップが18%高速化し、Krea 2では12%、Qwen-Image 2.1では9%高速化します。
MOSS-Image Turbo Train
バージョン9.2.5では、実験的なMOSS-Image Turbo Trainプリセットが追加されました。Fastプリセット(rank 16、0.25 MP、Muon)に、2e-4〜4e-4の範囲で動作するAdaptive LRを組み合わせ、画像ごとのトラッキングによって各画像が独自のペースで進みます。長い実行を始める前にLoRAがどこまで伸びるかを素早く確認する方法であり、良質なデータセットであれば十分に実用的です。
MOSS-Imageのプリセットも新しいClean-endシェア30:7:60:8:3に移行しました。エポック7まではステップの30%をほぼクリーンな画像で行い、エポック8以降は60%になります。保存済みの設定は古いスケジュールを保持するため、プリセットを再読み込みして反映してください。
更新
この更新ではPyTorch 2.15(約3 GB)をダウンロードするため、Python 3.11以降が必要です。NVIDIAドライバーはCUDA 13をサポートしている必要があり、バージョン580以降が必要です。更新後にFizgigがGPUを認識しない場合は、ドライバーを更新してください。AMDでは同梱のROCm PyTorchは変更されておらず、レンタルポッドは再起動後に新しいバージョンが適用されます。
.safetensorsファイルで、標準のComfyUI LoRAローダーで読み込めます。
コメント
GitHubでサインインしてディスカッションに参加しましょう。