P-H3-ImageがComfyUIでpDMD LoRAにより2ステップで動作
pDMDの2ステップLoRAでP-H3-Imageを8MP時に8ステップから2ステップへ短縮。単一ファイル、すぐ使えるComfyUIワークフロー、カスタムノード不要で、1枚あたり約2.9秒です。
 |  |
|---|---|
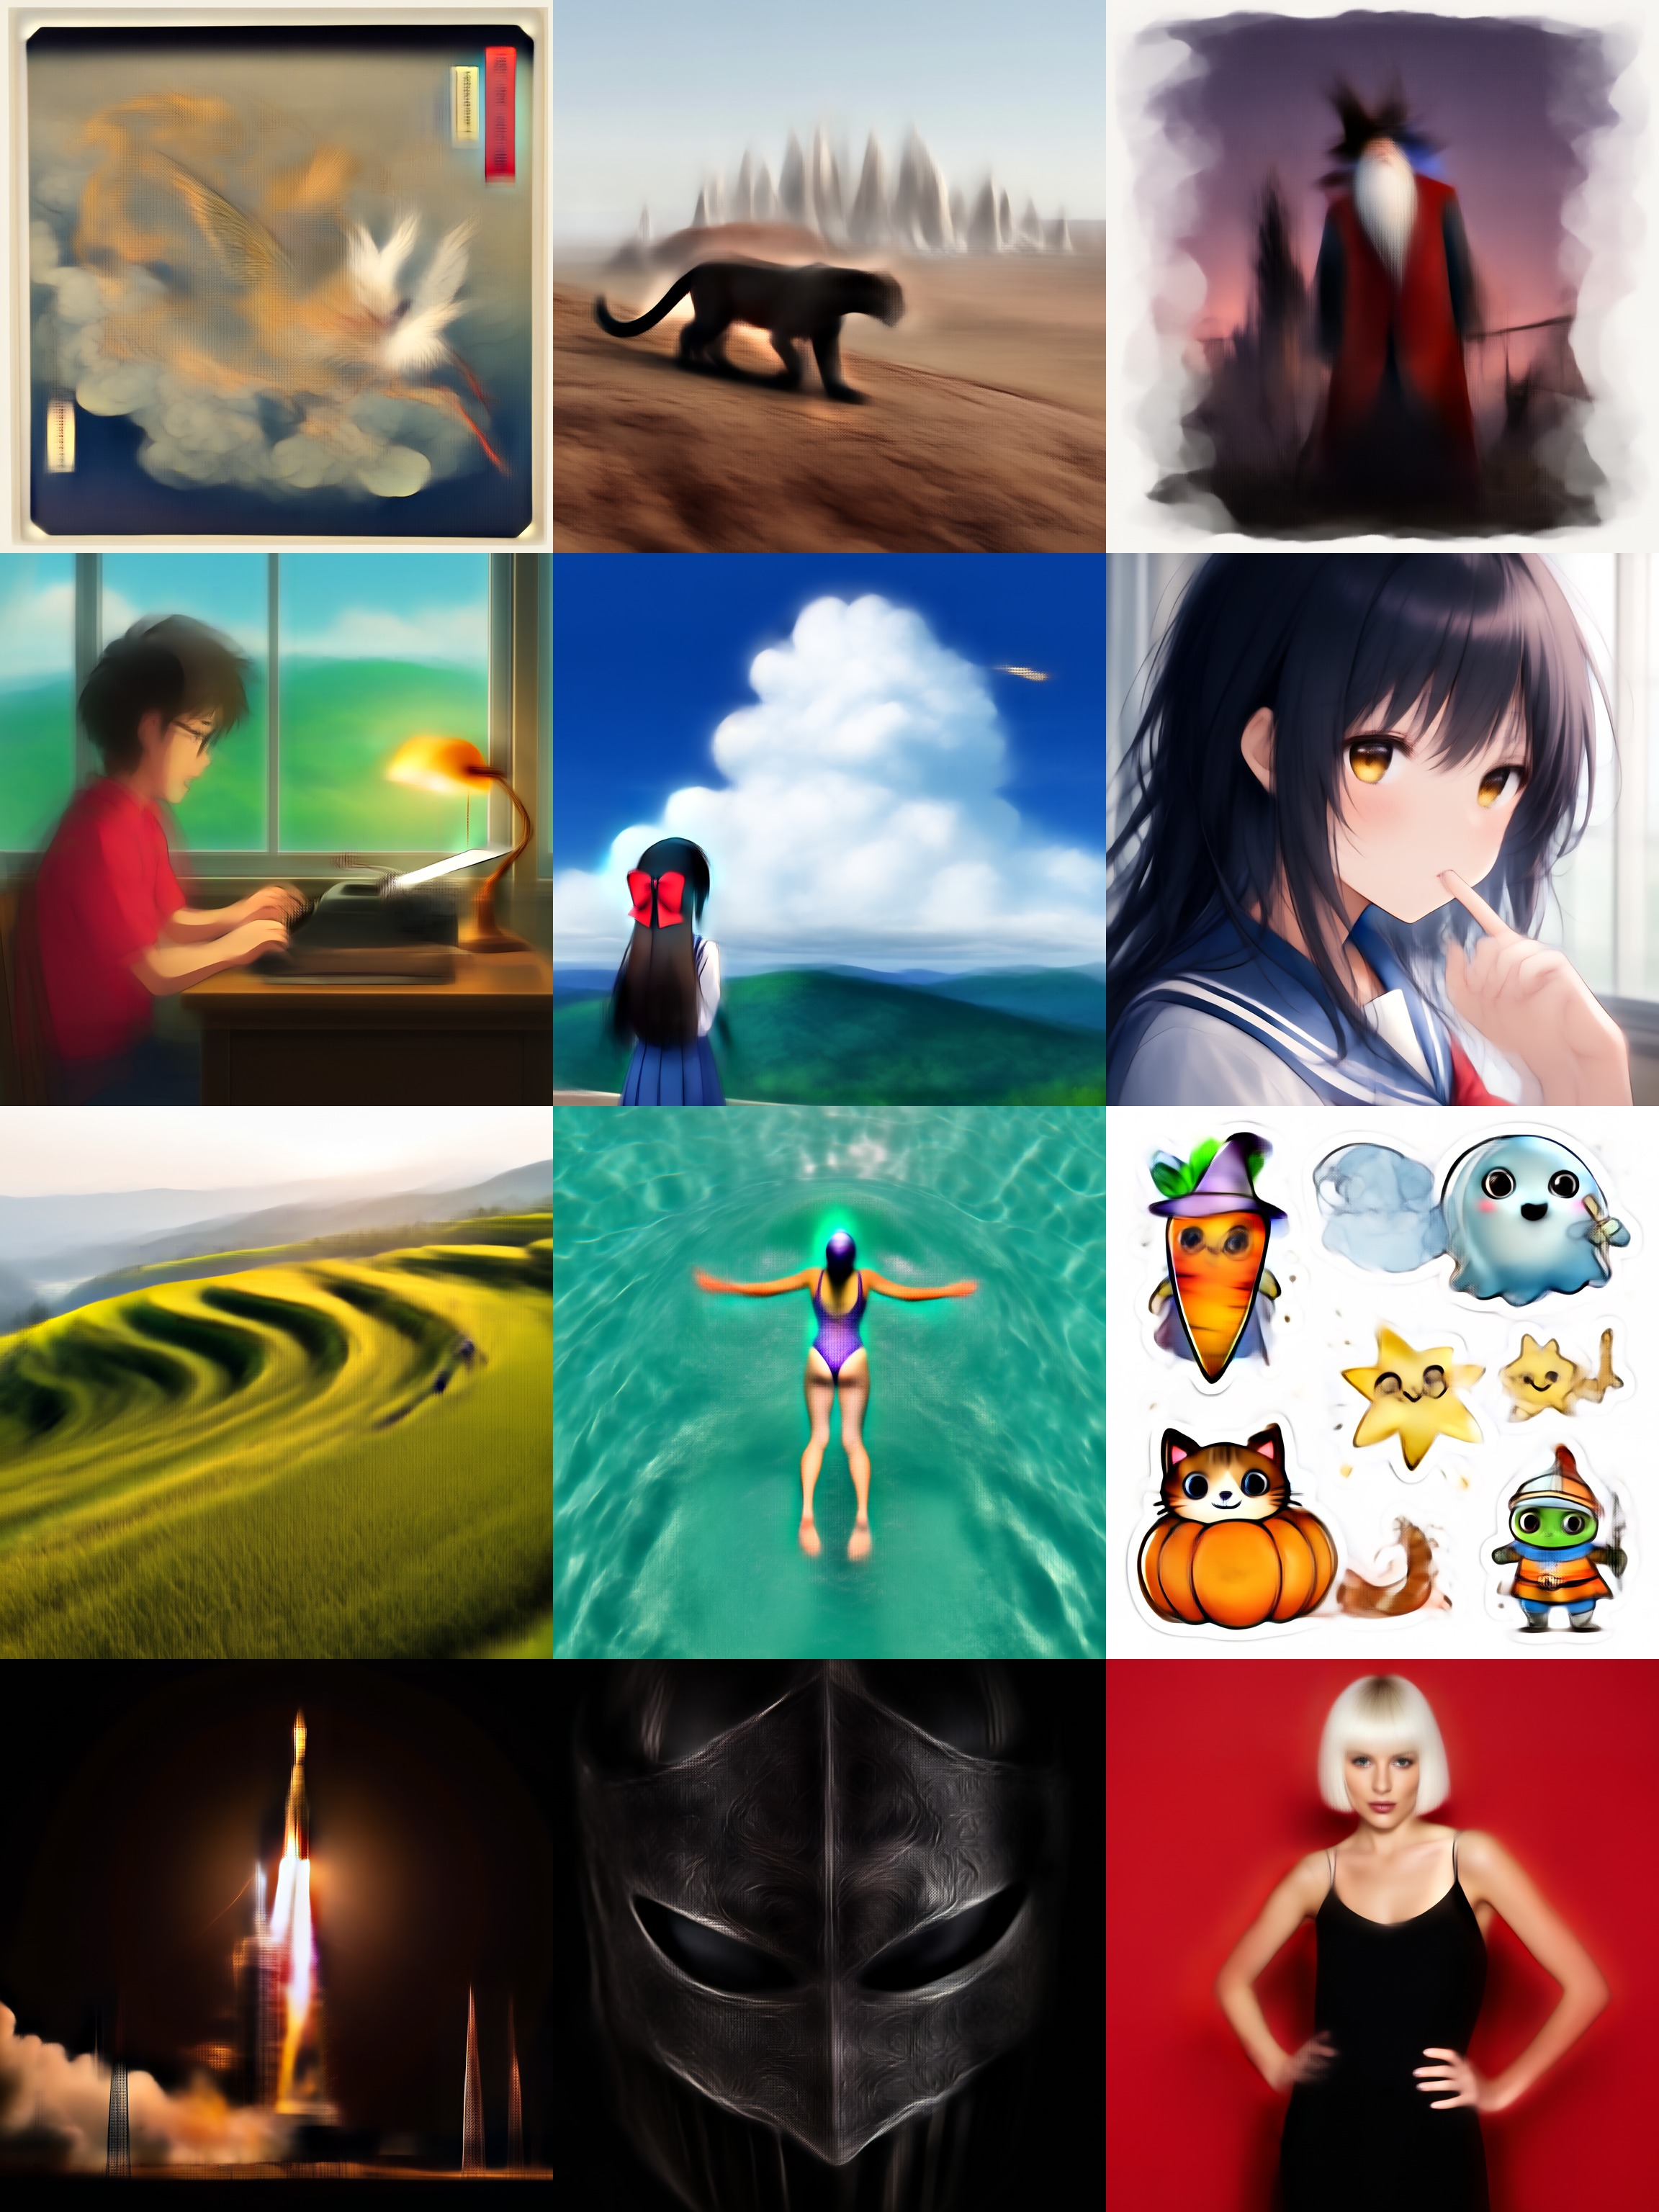
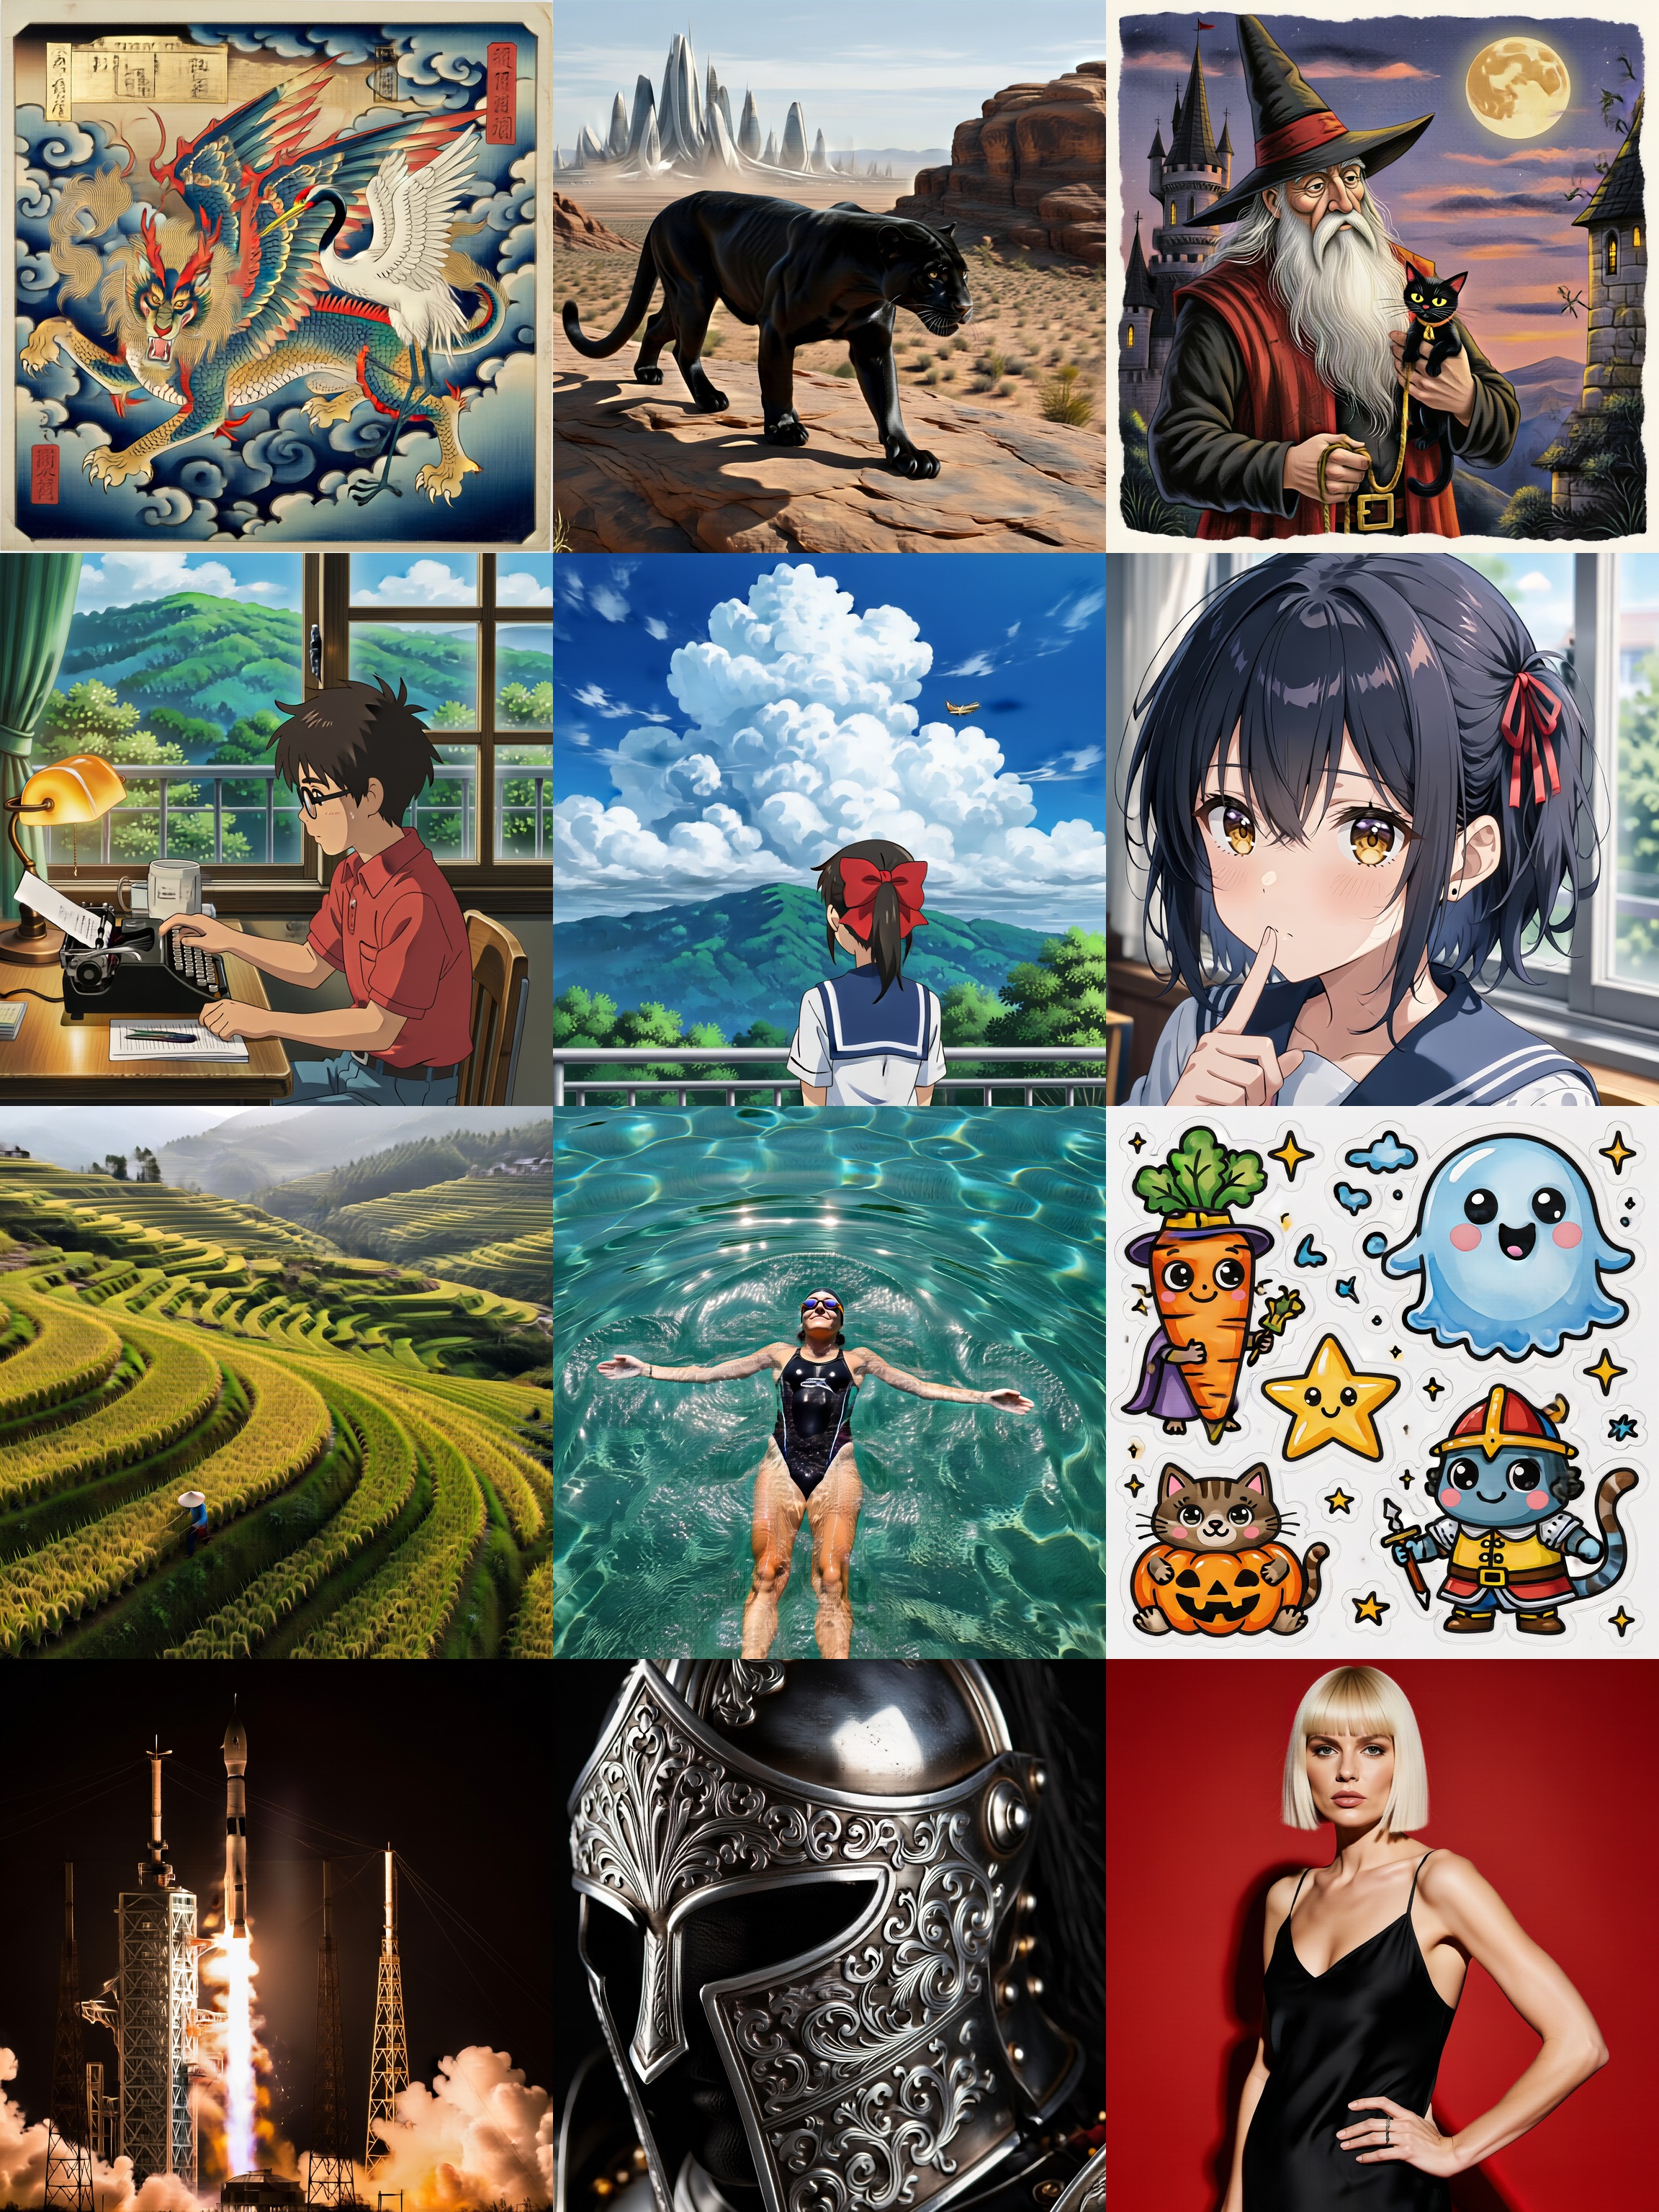
| 標準モデル、2ステップ | pDMD LoRA使用、2ステップ |
12個のプロンプト、2ステップ、shift 12、シード 3、作者のリポジトリから 2912 x 2912 でレンダリング。LoRA がない場合、2ステップではモデルはまだノイズ除去の途中です。
実行方法
- P-H3-Image-Comfy に従って P-H3-Image をセットアップし、ComfyUI を最新の master にアップデートします。
- LoRA を
ComfyUI/models/loras/にダウンロードします:hf download akhaliq/p-h3-image-pdmd-2step minimax_h3_pdmd_2nfe_comfyui.safetensors --local-dir ComfyUI/models/loras - 以下のワークフローを開きます。標準の8ステップグラフからの変更点は2つです。Load LoRA (Bypass, Model Only) を強度 1.0 で Load Diffusion Model とサンプラーの間に挿入し、8ステップの ManualSigmas グリッドの代わりに
simpleの BasicScheduler を 2ステップ、flow shift 12 で使用します。euler、基本ガイダー、CFG なしはそのまま保持します。
2、3、4ステップでのテキストから画像へ生成と単一画像編集用のブラウザデモもあります。
2、3、4ステップ
| ステップ | 結果 |
|---|---|
| 2 | 実用的: シャープで破綻はないが、構図は8ステップのベースラインからずれ、グラフィック系プロンプトでは疑似テキストが生成されることがある |
| 3 | 安全な中間設定 |
| 4 | ベースラインに最も近く、引用テキストやフラットなグラフィック向けの選択肢 |
この LoRA は pDMD 2-NFE アダプターです(rank 128、同じ312モジュールに対してアルファ 128、bf16、上流リリースから未改変)。H3 動画モデル向けに蒸留されたもので、ここでは代わりに P-H3-Image の画像トランスフォーマーへマージされます。
オプションのディテールパス
上に Regenerate-2K リファイナーを重ねると実際のディテールが加わります。2ステップで 2 MP のドラフトをレンダリングし、2倍にアップスケールしてから、リファイナー LoRA を sigma 0.7、Euler 3ステップで 8 MP に再生成します。作者の計測では全体で1枚あたり約 7秒、素の8ステップベースラインより約 1.7倍高速です。ポートレートには 0.5 を使うと、ディテールは減りますが顔がより良く保持されます。
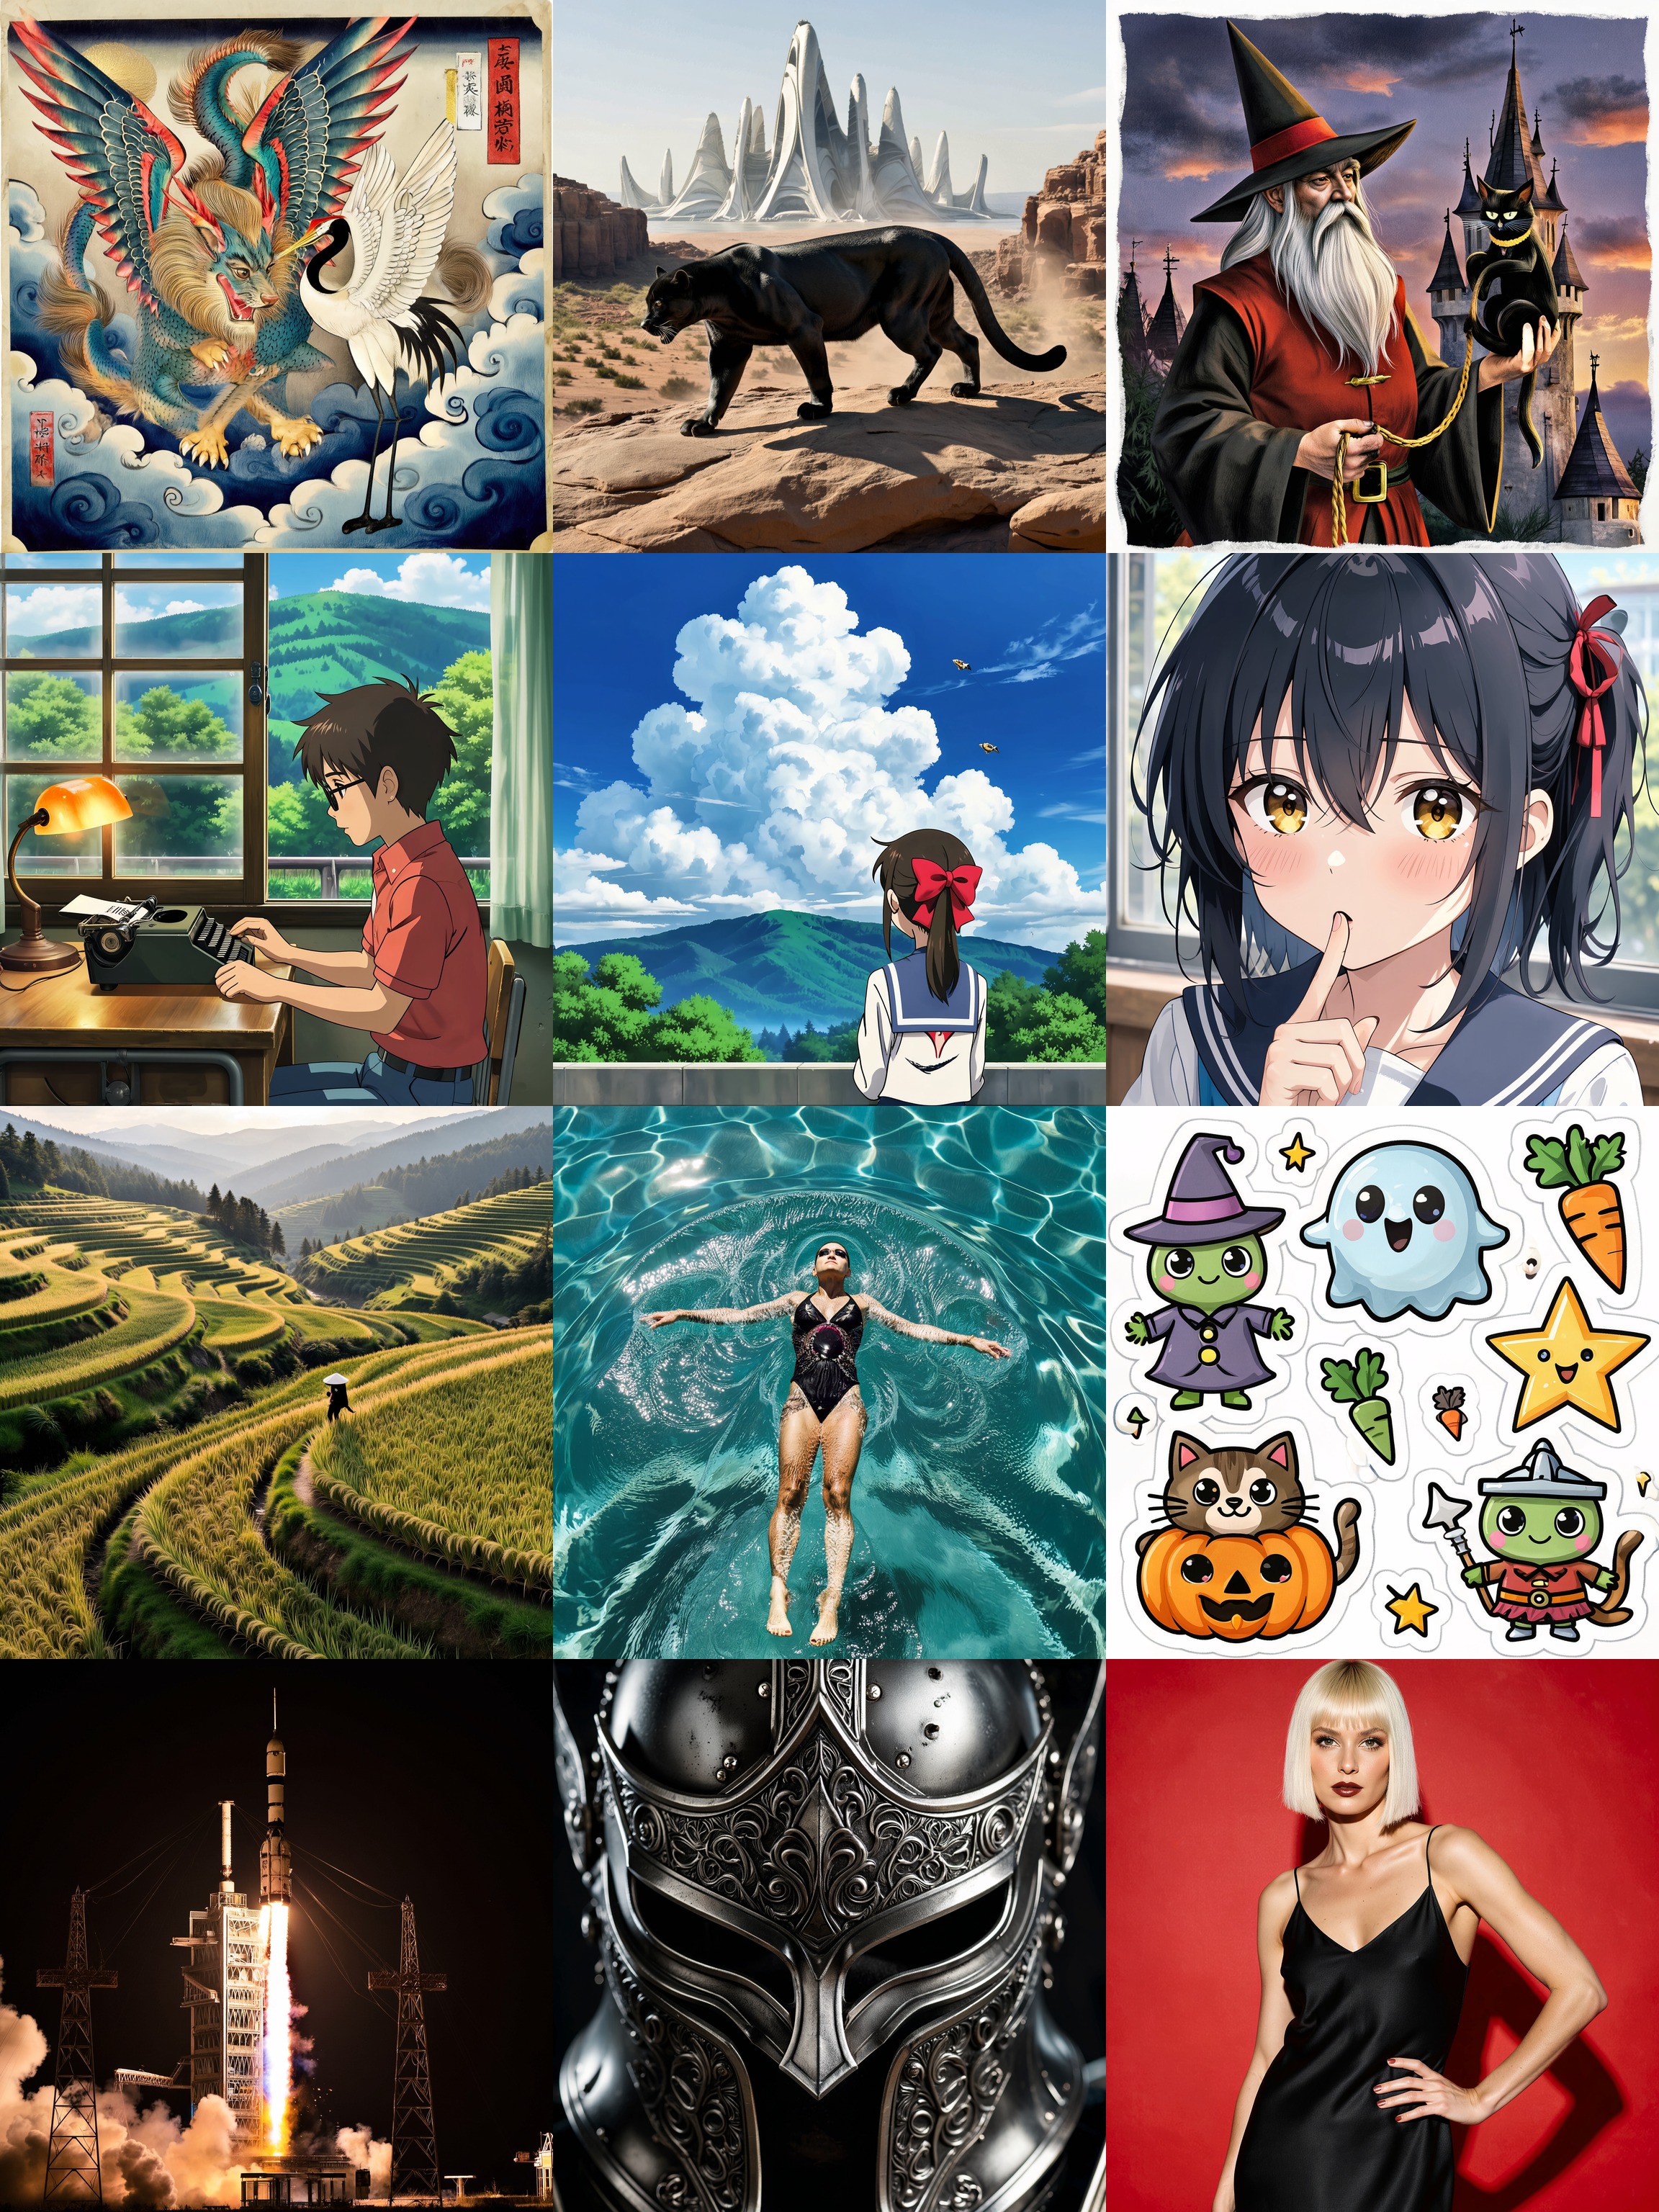
2ステップのドラフトに sigma 0.7 の Regenerate-2K パスを追加したもの。同じ12個のプロンプト。
VRAM は変わりません。LoRA は読み込み時にマージされるため、bf16 セットはプロンプトアップサンプラーなしで約 83 GB、ComfyUI のコンポーネントオフロードを使うと約 76 GB が必要です。
入手方法
- LoRA、ワークフロー、比較グリッド: akhaliq/p-h3-image-pdmd-2step
- デモ Space: akhaliq/p-h3-image-2step
- ベースモデル: PrunaAI/P-H3-Image、ComfyUI 用ファイルは P-H3-Image-Comfy
- 方法と論文: PDMD、arXiv 2609.35768
コメント
GitHubでサインインしてディスカッションに参加しましょう。