P-H3-Image: MiniMax H3の画像生成をComfyUIで使う
PrunaAIのP-H3-Imageは、CFGなしの8ステップで8 MP画像を生成し、最大8枚の参照画像で編集できます。ComfyUIは公開初日にネイティブサポートを追加しました。
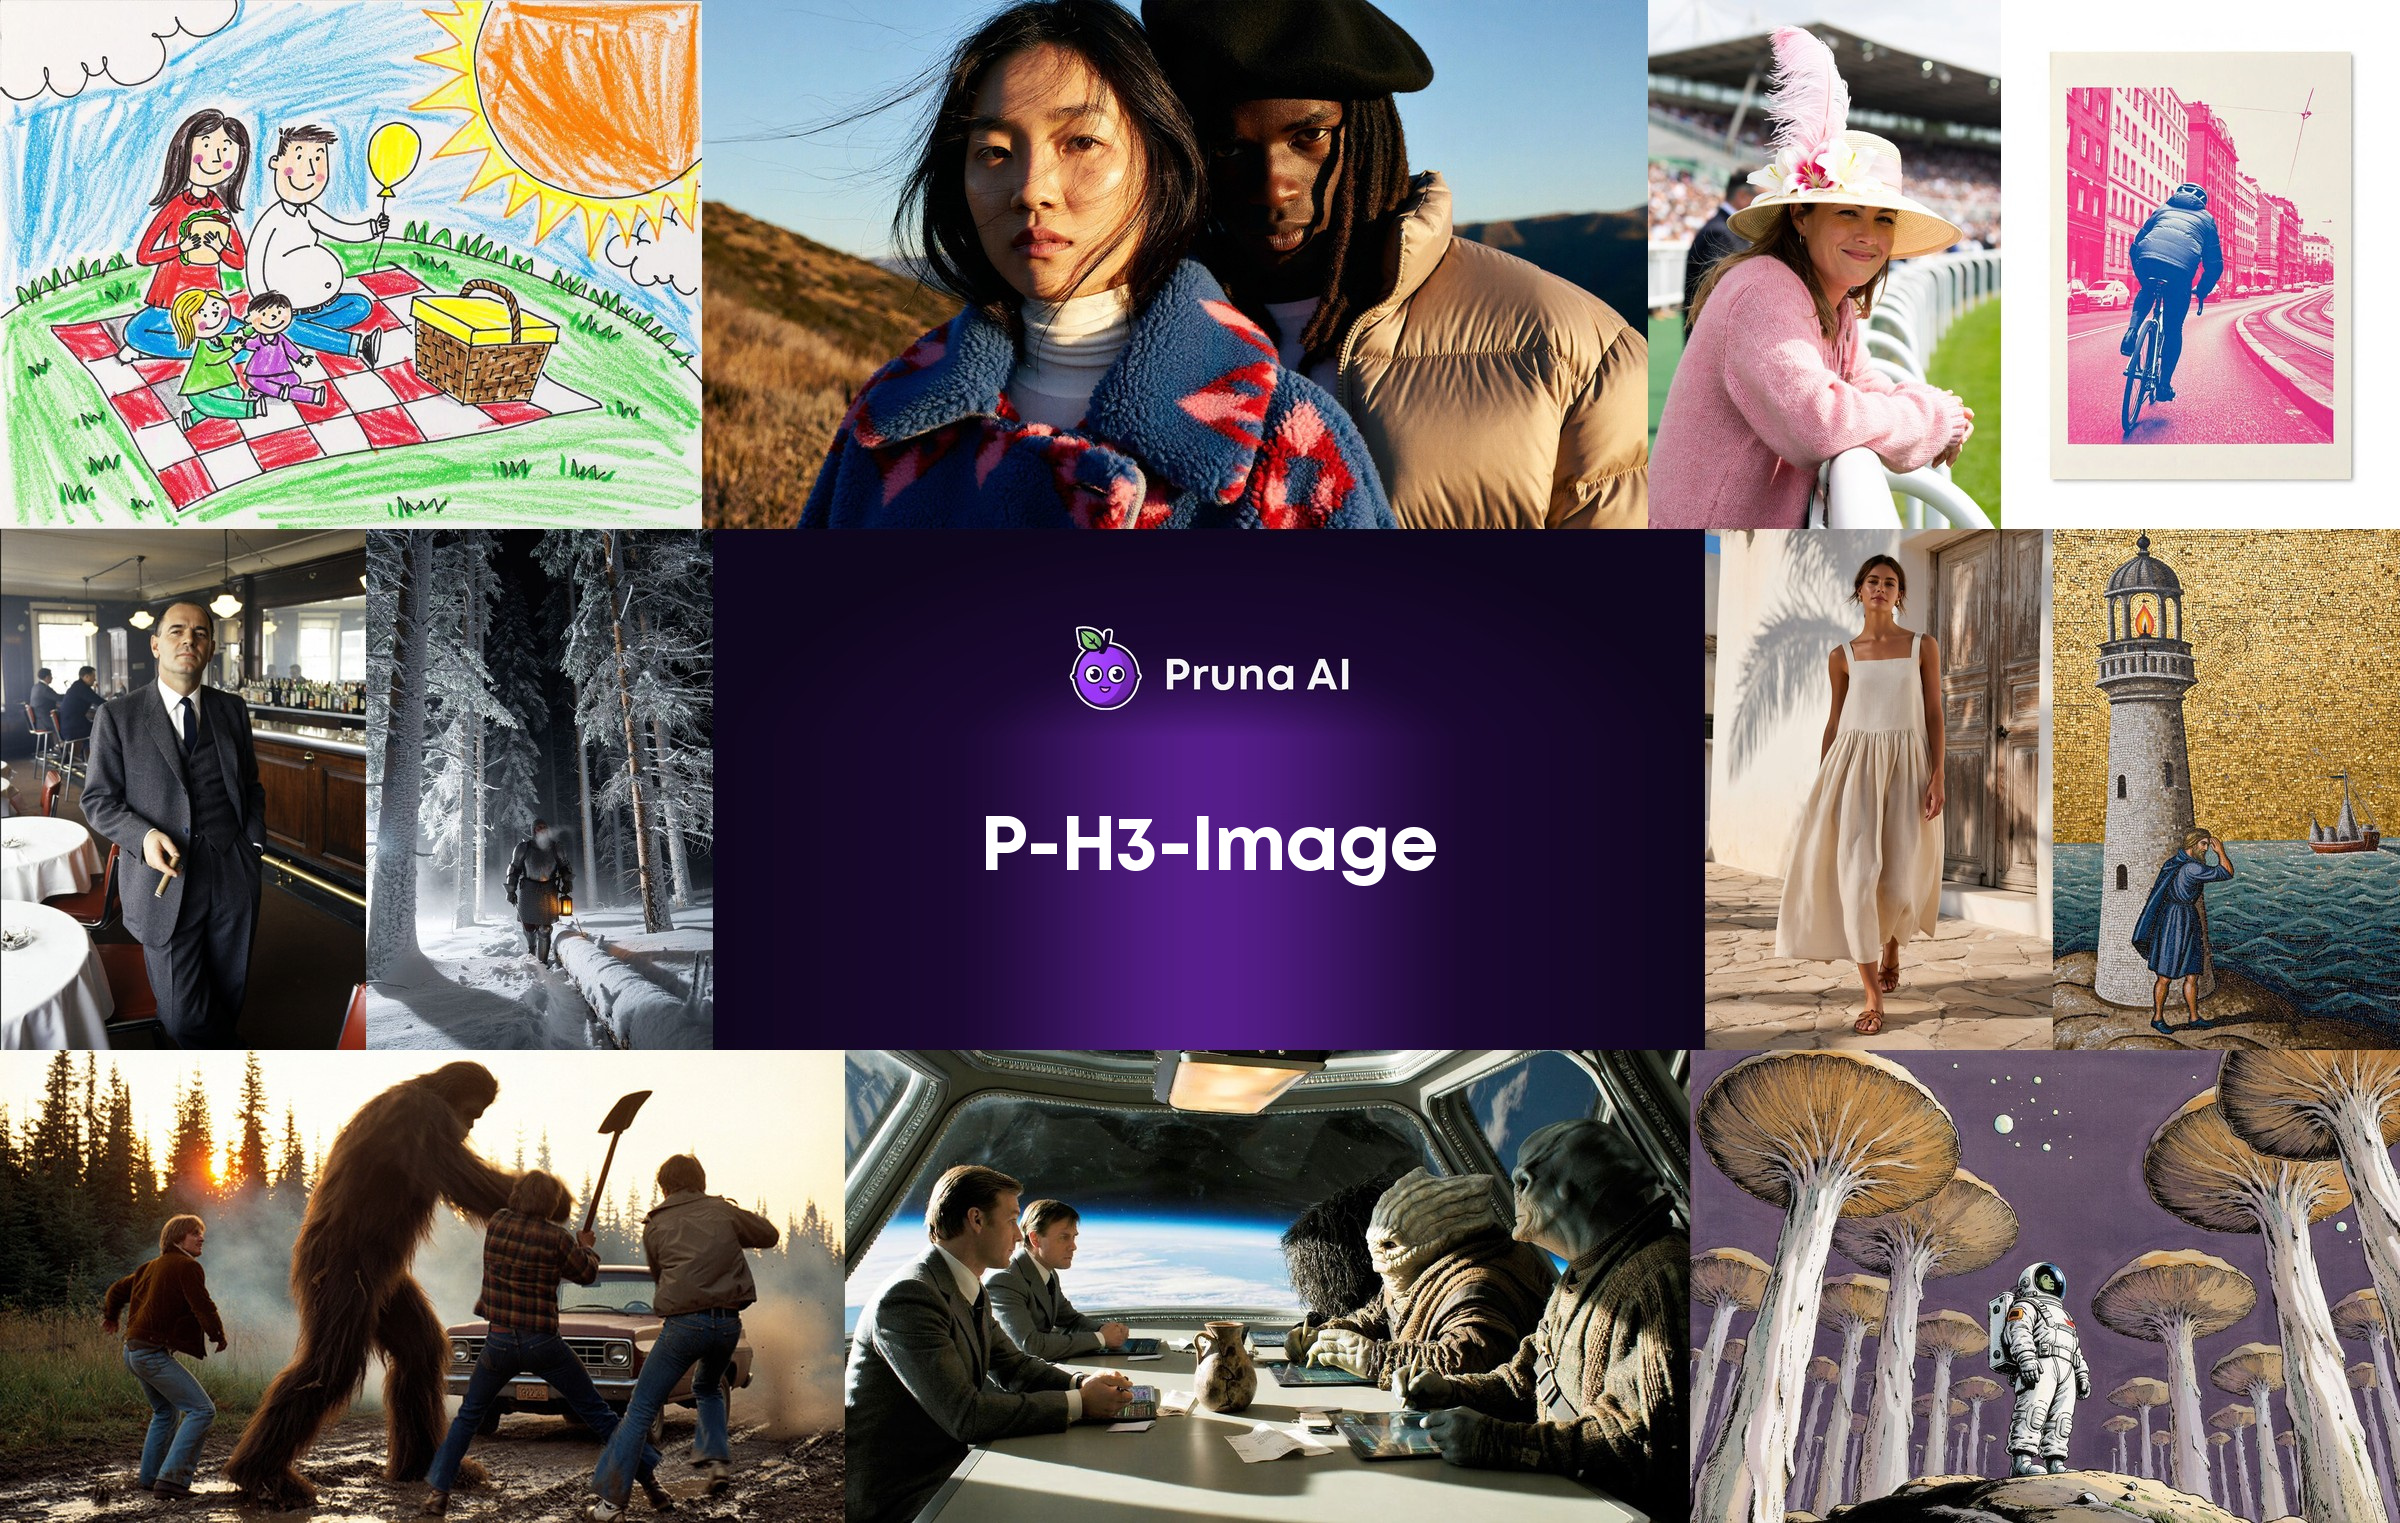
公式モデルカードのサンプル。カードでは、P-H3-Imageはフォトリアリズム、映画・エディトリアル風のルック、短い引用テキストを含むグラフィックスタイル向けと位置づけられています。
モデルの概要
今回のリリースは、4Bのテキストエンコーダ、VAE、独立したプロンプトアップサンプラーを備えた33.1Bパラメータのtransformerで、bf16で100 GBあります。新しいアーキテクチャではなくMiniMax H3のファインチューンであるため、H3のVAEとアテンションスタックを継承し、トレーニングの予算を動画ではなく静止画に振り向けています。
| タスク | テキストから画像への生成、および1〜8枚の入力画像による編集 |
| サンプリング | 8ステップ、CFGとネガティブプロンプトなし |
| 解像度 | テキストから画像へは8 MP、編集は4 MPまたは8 MP |
| プロンプトアップサンプラー | 含まれる(デフォルトで有効)、Qwen3.5-9Bベース |
| 重み | 33.1B transformer、4Bテキストエンコーダ、VAE、プロンプトアップサンプラー |
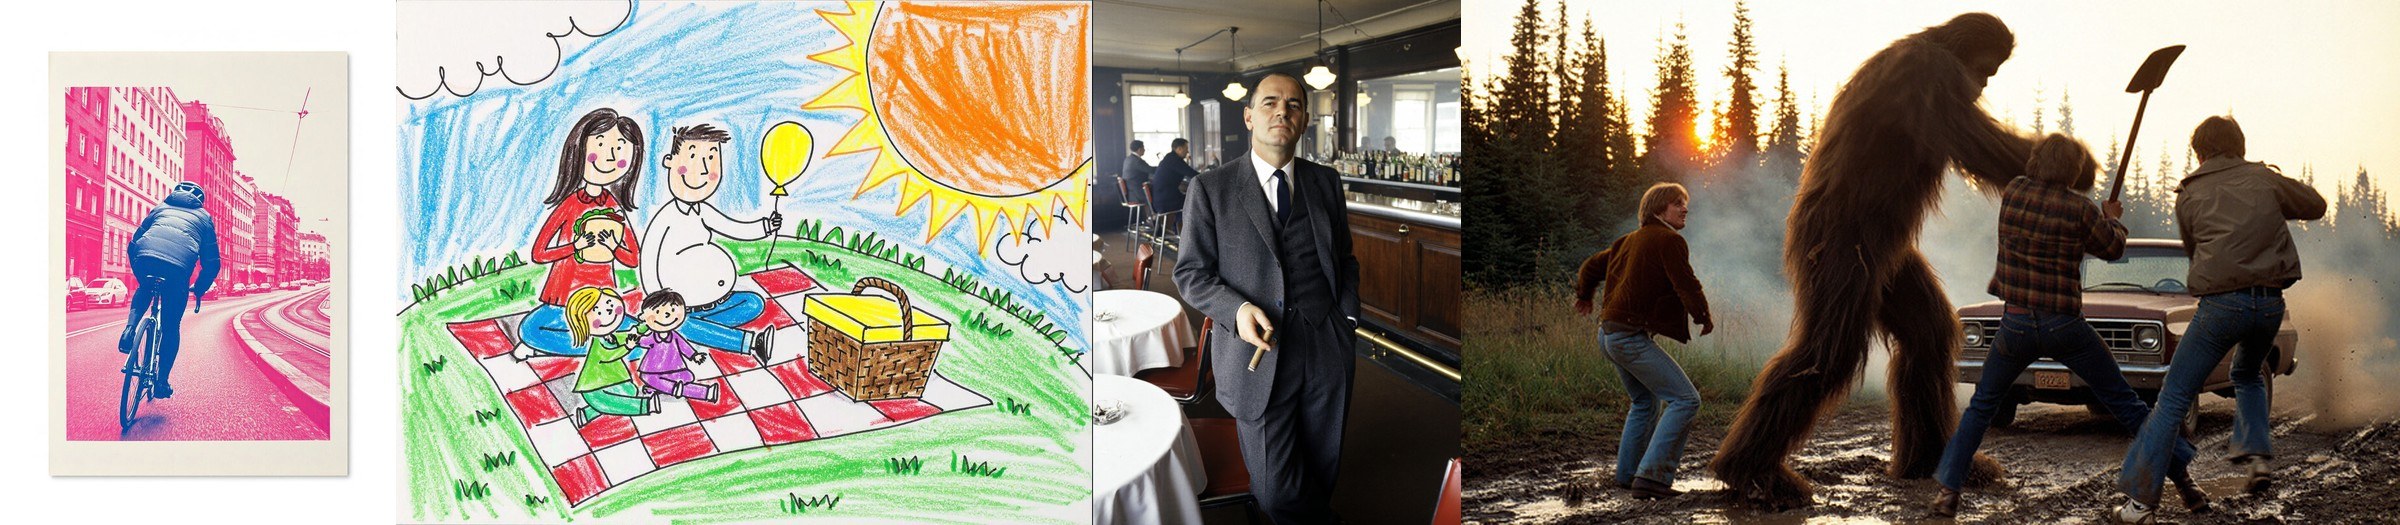
モデルカードのスタイル網羅性。8 MPでレンダリングされています。
公開初日からのネイティブComfyUIサポート
ComfyUIは2026-11-03、PR 17506(CORE-697)でPH3Imageのサポートをマージしました。PrunaAIが重みに update-for-launch リビジョンをプッシュしたのと同じ日です。Comfy-Org/workflow_templates にある2つの公式テンプレートはどちらも minComfyUIVersion: 0.44.0 を持つため、それより古いリリースでは開けません。
グラフは組み込みノードのみを使用します。拡散モデルを読み込むでcheckpointを読み込み、MiniMax H3 Sigma Shiftは両方のシフトで1.0として実行し、CLIPを読み込む(type minimax)でテキストエンコーダを読み込み、新しいp-h3-image Conditioningノードがプロンプトと任意の画像を条件付けとimage latentに変換します。サンプリングは8ステップのグリッド上のマニュアルシグマからSampler Custom Advancedへ、基本ガイダーとeulerを使い、CFGもネガティブプロンプトもありません。オプションのLoRAは、モデルのみに設定したLoRAローダーモデルのみで読み込みます。
ダウンロードするファイル
PrunaAI/P-H3-Image-Comfy は重みをComfyUIのネイティブ形式でミラーしており、各コンポーネントが同じ行から来ていれば精度は自由に混在できます。MiniMax H3自体は143 GBの重みで、P-H3-Imageの最小構成は20 GBのダウンロードで、8 MP時にピーク21 GBのVRAMです。
| コンポーネント | フォルダー | bf16 | int8 | w4a8 |
|---|---|---|---|---|
| 拡散モデル | diffusion_models/ | 40.5 GB | 21.2 GB | 13.4 GB |
| テキストエンコーダ | text_encoders/ | 9.1 GB | 5.1 GB | 3.6 GB |
| プロンプトアップサンプラー | text_encoders/ | 19.3 GB | 9.7 GB | 6.7 GB |
| VAE | vae/ | 5.6 GB | 3.1 GB | なし |
| セット | ダウンロード | 8 MP時のピークVRAM |
|---|---|---|
| bf16 | 55 GB | 56 GB |
| int8 | 30 GB | 31 GB |
| w4a8 + int8 VAE | 20 GB | 21 GB |
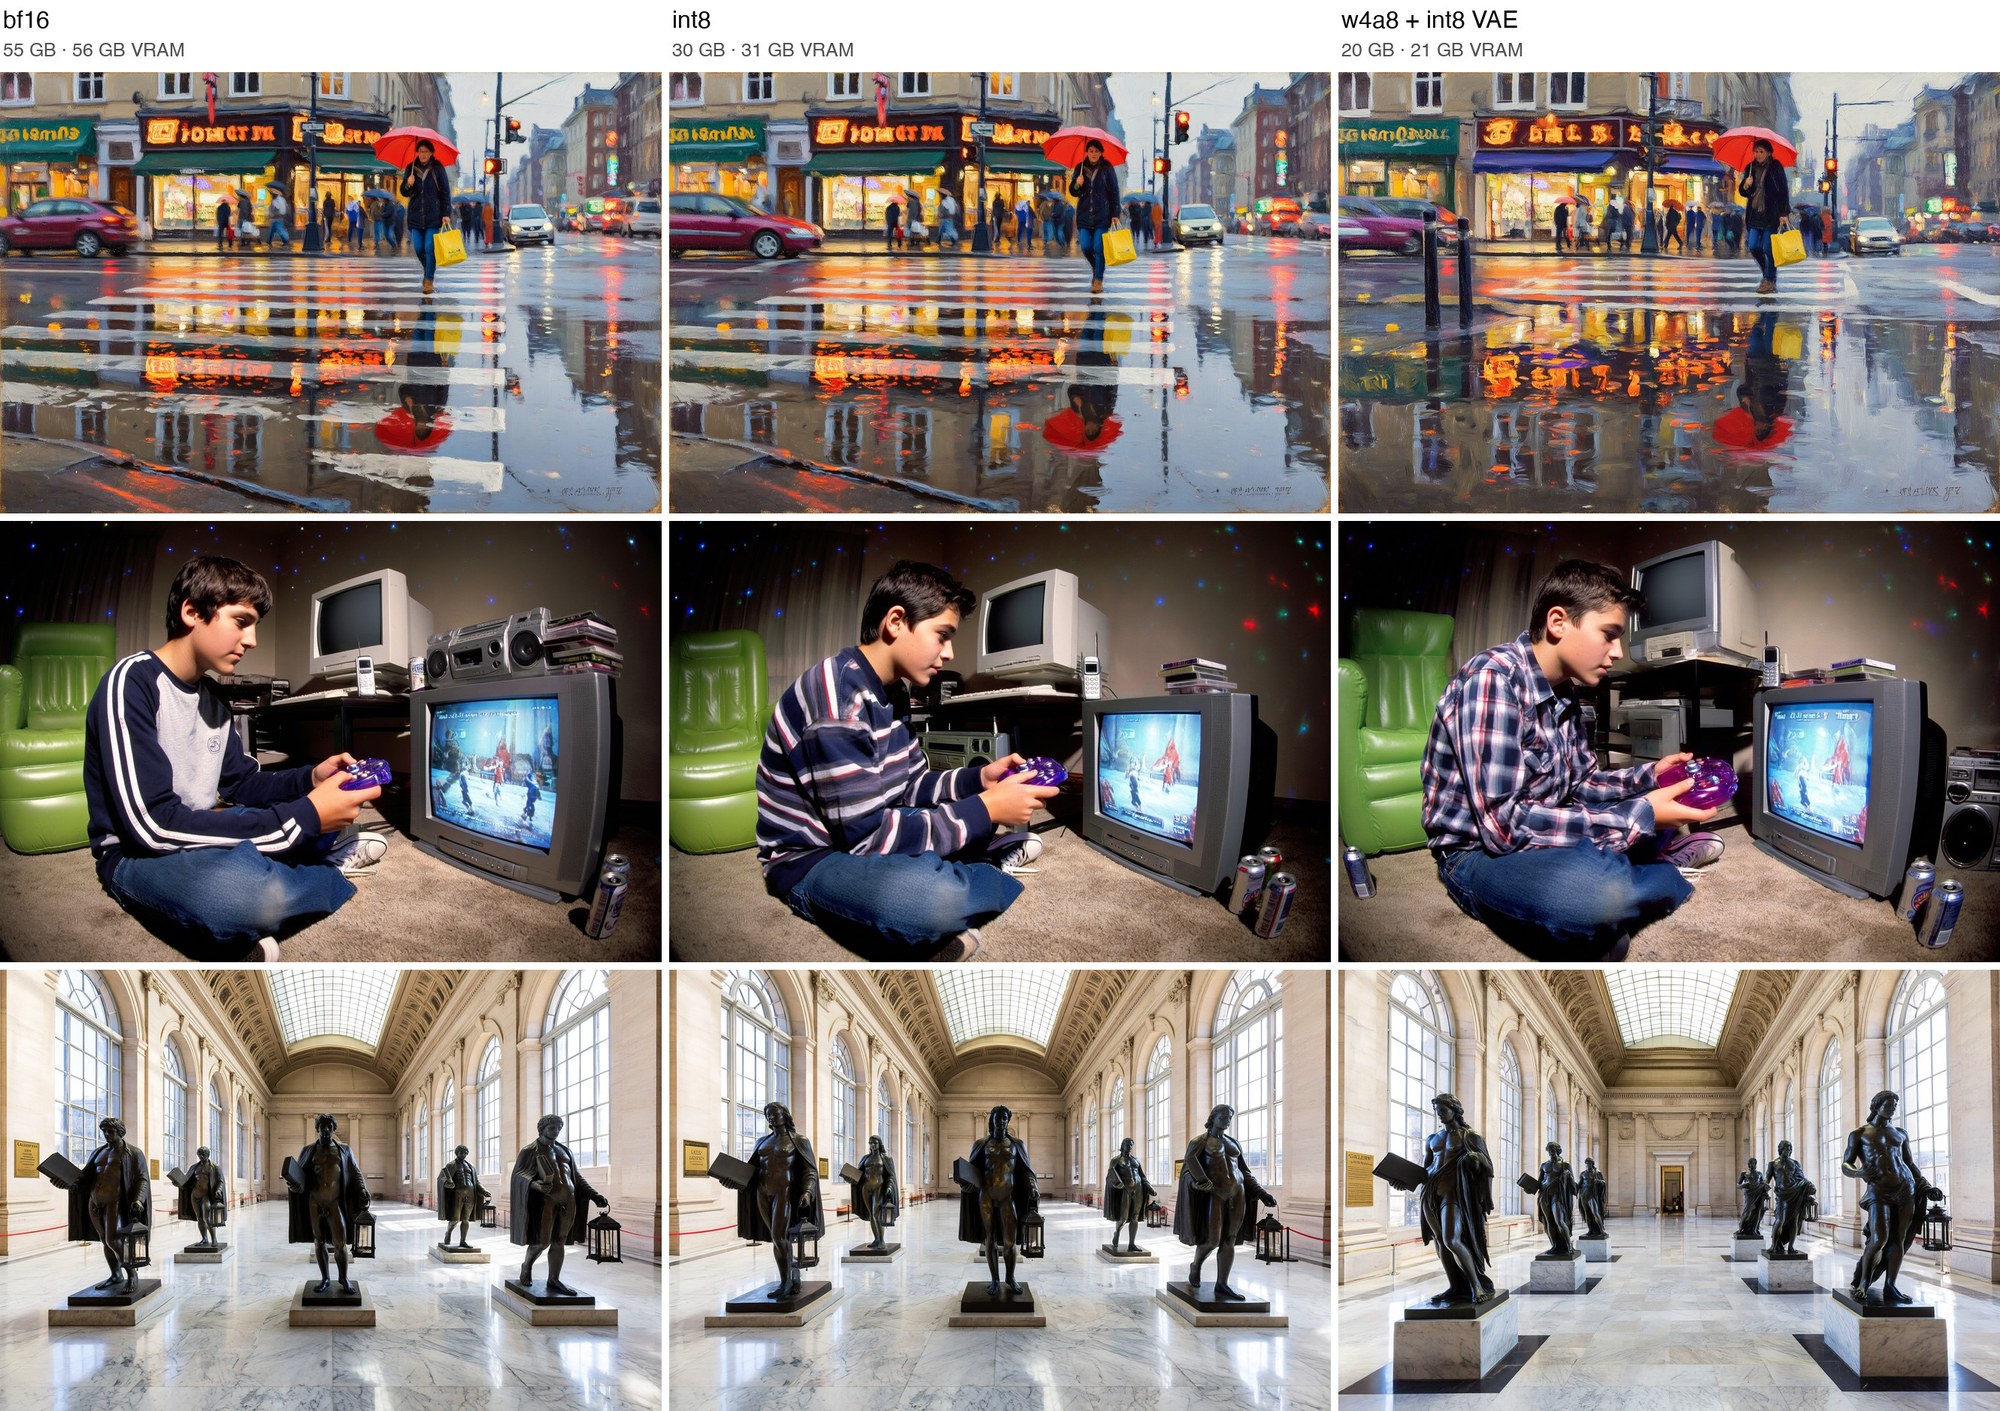
同じプロンプトとシードをbf16、int8、w4a8で8 MP生成したもの。各ヘッダーにダウンロードサイズとピークVRAMを示しています。
int8ファイルはbf16に非常に近く、しばしばほぼピクセル単位で一致します。w4a8は品質を保ちつつ、より多くのディテール、時には構図が変化します。どちらもComfyUI独自の量子化形式です。int8は外れ値に対してグループ化Hadamard回転を適用し、行ごとのスケールを保存しつつアクティベーションはオンザフライで量子化します。一方w4a8は4ビットの重みを16レベルのコードブックに載せ、16入力ごとにFP8スケールを持ち、敏感なレイヤーはint8のままにします。どちらもキャリブレーションデータを必要とせず、NVIDIA Ampere以降とAMD RDNA3/4向けのcomfy-kitchenのINT8カーネルで動作します。
loras/ には2.0 GBのLoRAもあり、フルcheckpointの代わりに自分のMiniMax H3の重みへ同じ挙動を適用します。リポジトリ内の4つのワークフローのうち2つはこれを中心に構成されています。
プロンプトアップサンプラーはモデルの一部
P-H3-Imageは、短いリクエストよりも完全で具体的なプロンプトをはるかにうまく描画するため、すべてのサンプルワークフローはまずアップサンプラーを実行します。ComfyUIでもカスタムノードではなく、type minimax のCLIPを読み込むと貪欲法デコードのTextGenerateを組み合わせるため、同じリクエストからは常に同じプロンプトが生成されます。
テキストから画像への生成では、テキスト整形が Aspect ratio: 1:1 と Request: ... を2行に構成し、thinking をオンにします。編集では画像ごとに <Picture N> ブロックを書き出し、image_1 は1 MP、参照画像は画像をバッチ処理でそのサイズにパディングされます。Use prompt upsampler のIf/Elseスイッチをfalseにすると、リクエストはそのままモデルに渡されます。
アップサンプラーは拡散モデルの前に実行され、P-H3-Imageがメモリを必要とするときはComfyUIがVRAMから退避させます。また出力はキャッシュされるため、リクエストや画像が変わったときにだけ再実行されます。bf16のアップサンプラーは19.3 GB、約21 GBのVRAMで推奨です。
最大8枚の画像による編集
編集では、変更する画像を image_1 として、そこに最大7枚の参照画像を加えます。順序は画像をバッチ処理と条件付けノードで同じにし、アップサンプラー入力にはそれぞれ <Picture N> ブロックを用意します。リクエスト内では自由に言及できるため、「2枚目の写真の帽子」は2番目の画像として解決されます。編集されるのはPicture 1のみで、残りはコンテキストです。
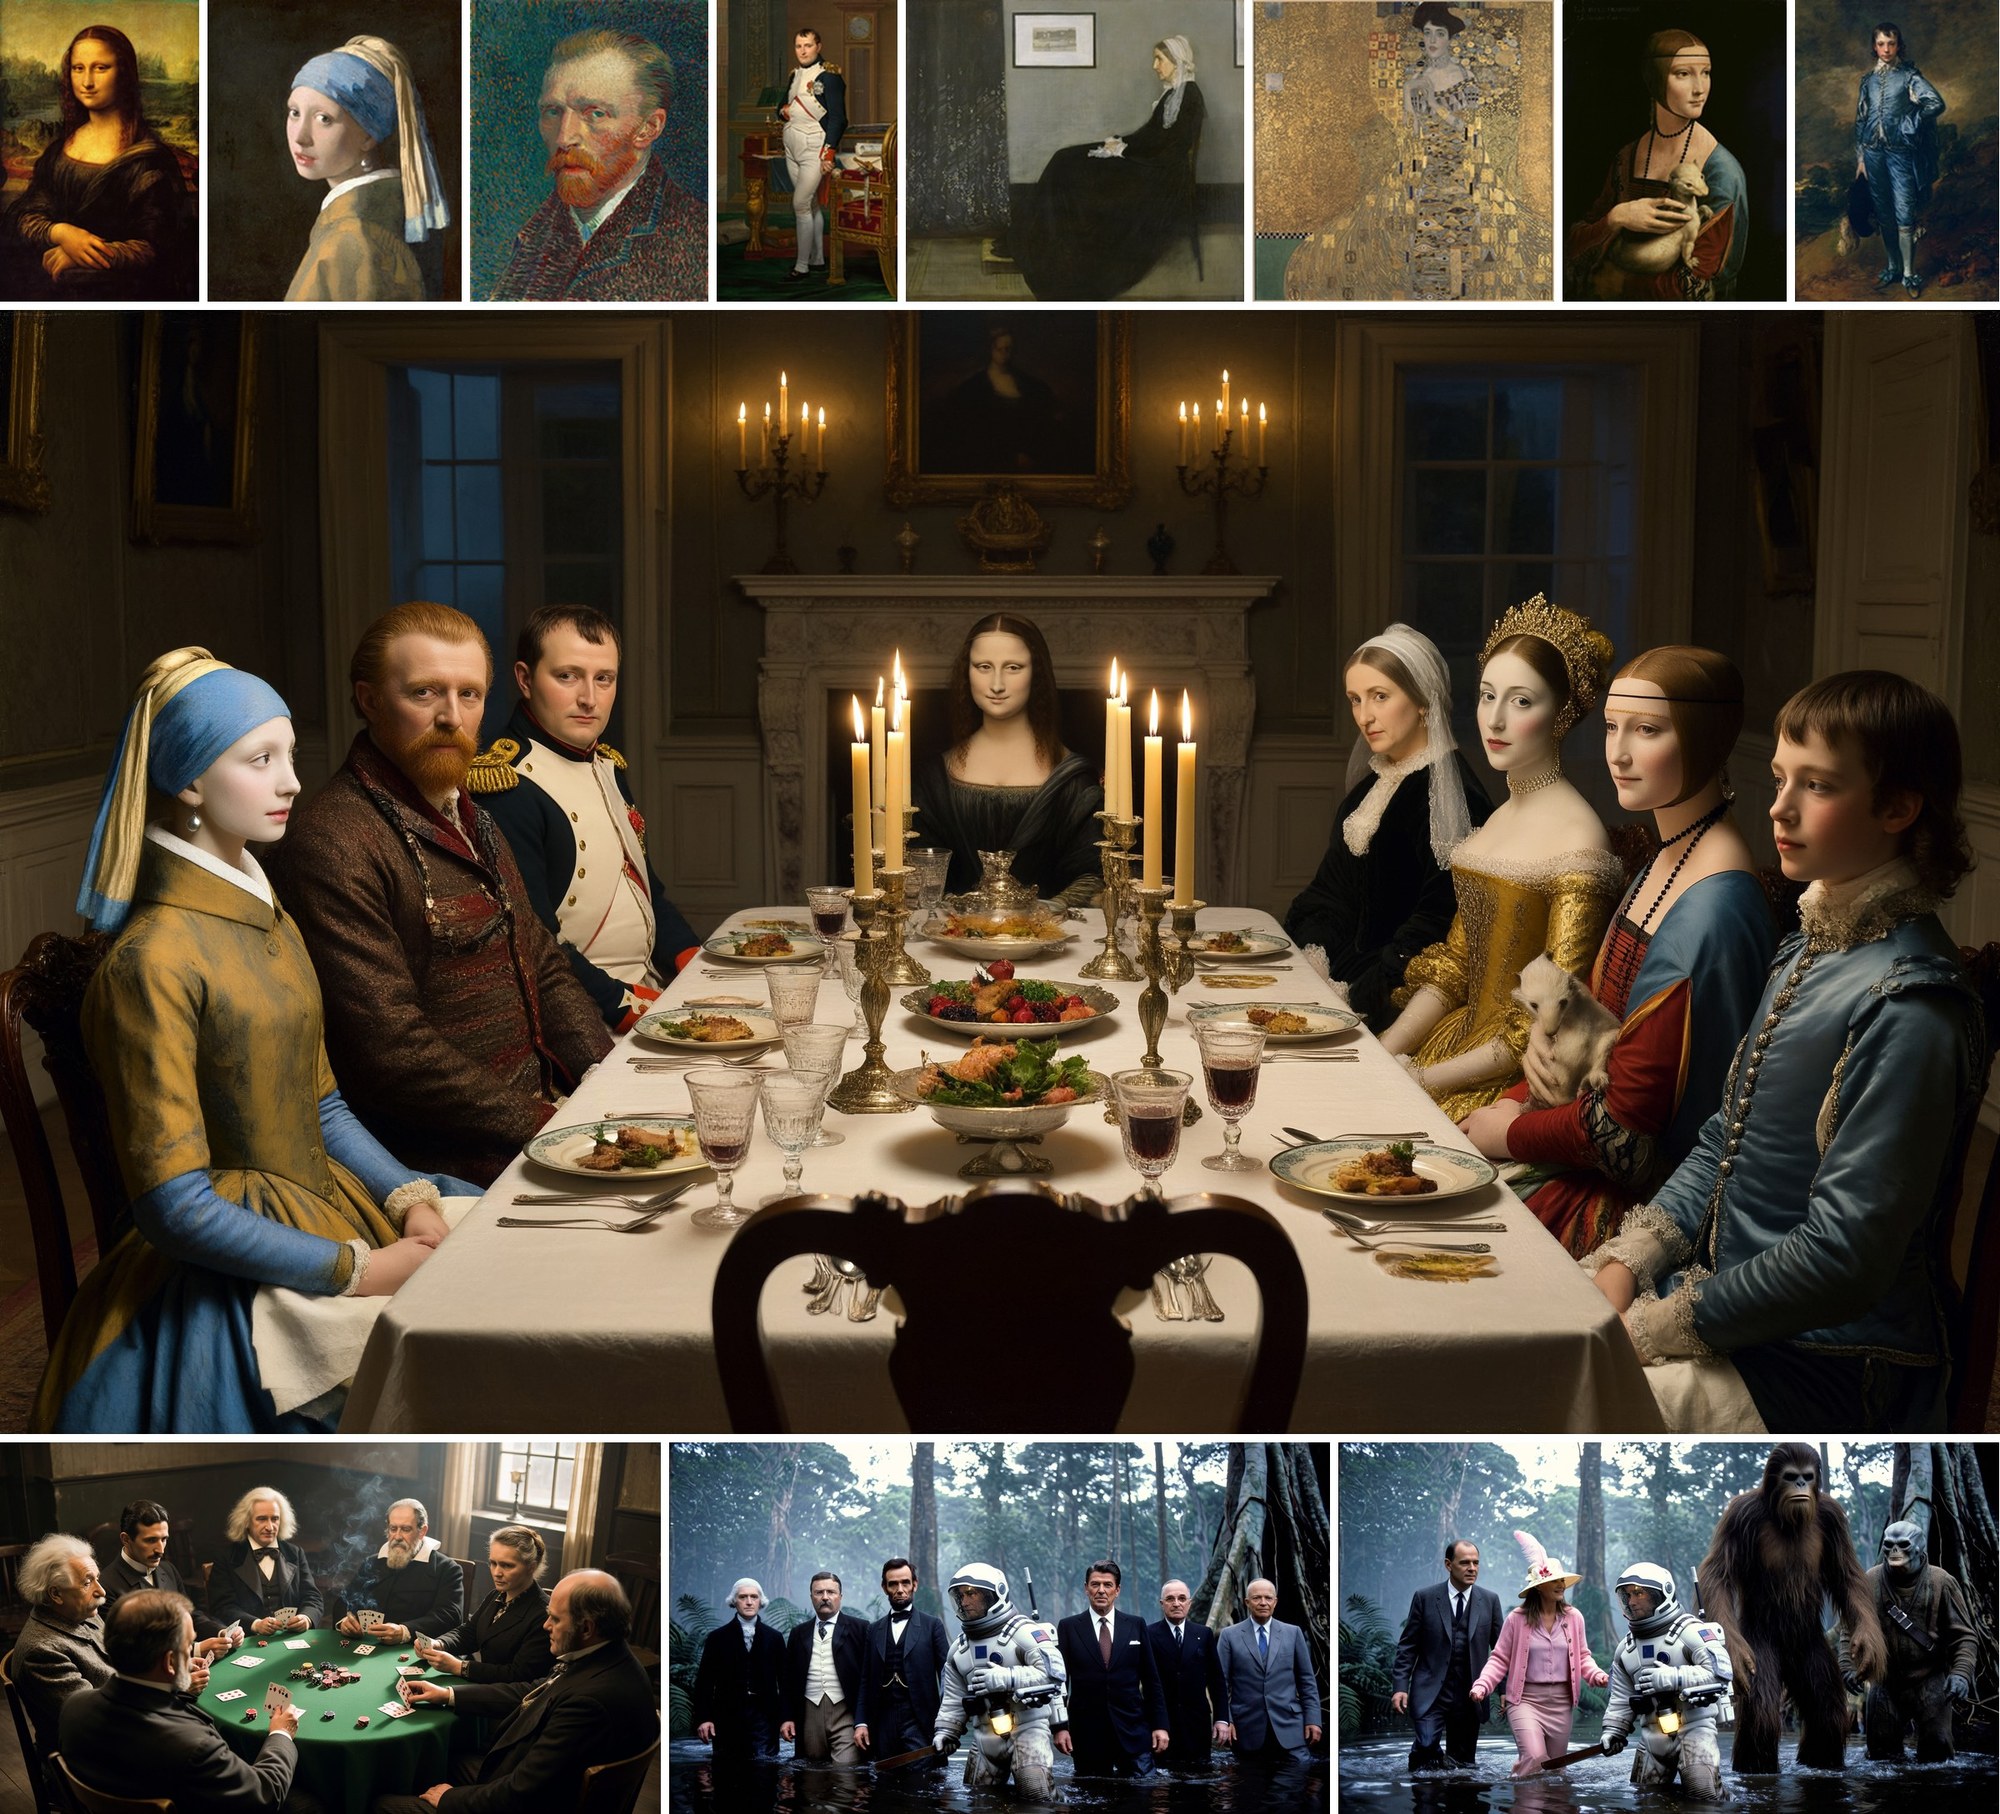
8枚のパブリックドメインのポートレートと、1回のリクエストでP-H3-Imageがそれらから構成したディナーパーティー。
公式カードの編集出力。
8 MPが動作点
このモデルは8 MPでトレーニングされており、カードは2 MPと4 MPでは品質が落ちると明言しています。アーティファクトは顔、手、小さなディテールで最も目立ちます。テキストから画像へのデフォルトサイズは2912 x 2912で、辺は32の倍数に丸められます。
| アスペクト比 | 8 MP(幅 x 高さ) | 4 MP(編集用) |
|---|---|---|
| 1:1 | 2912 x 2912 | 2048 x 2048 |
| 4:3 | 3360 x 2496 | 2368 x 1760 |
| 3:4 | 2496 x 3360 | 1760 x 2368 |
| 3:2 | 3552 x 2368 | 2496 x 1664 |
| 2:3 | 2368 x 3552 | 1664 x 2496 |
| 16:9 | 3872 x 2176 | 2720 x 1536 |
| 9:16 | 2176 x 3872 | 1536 x 2720 |
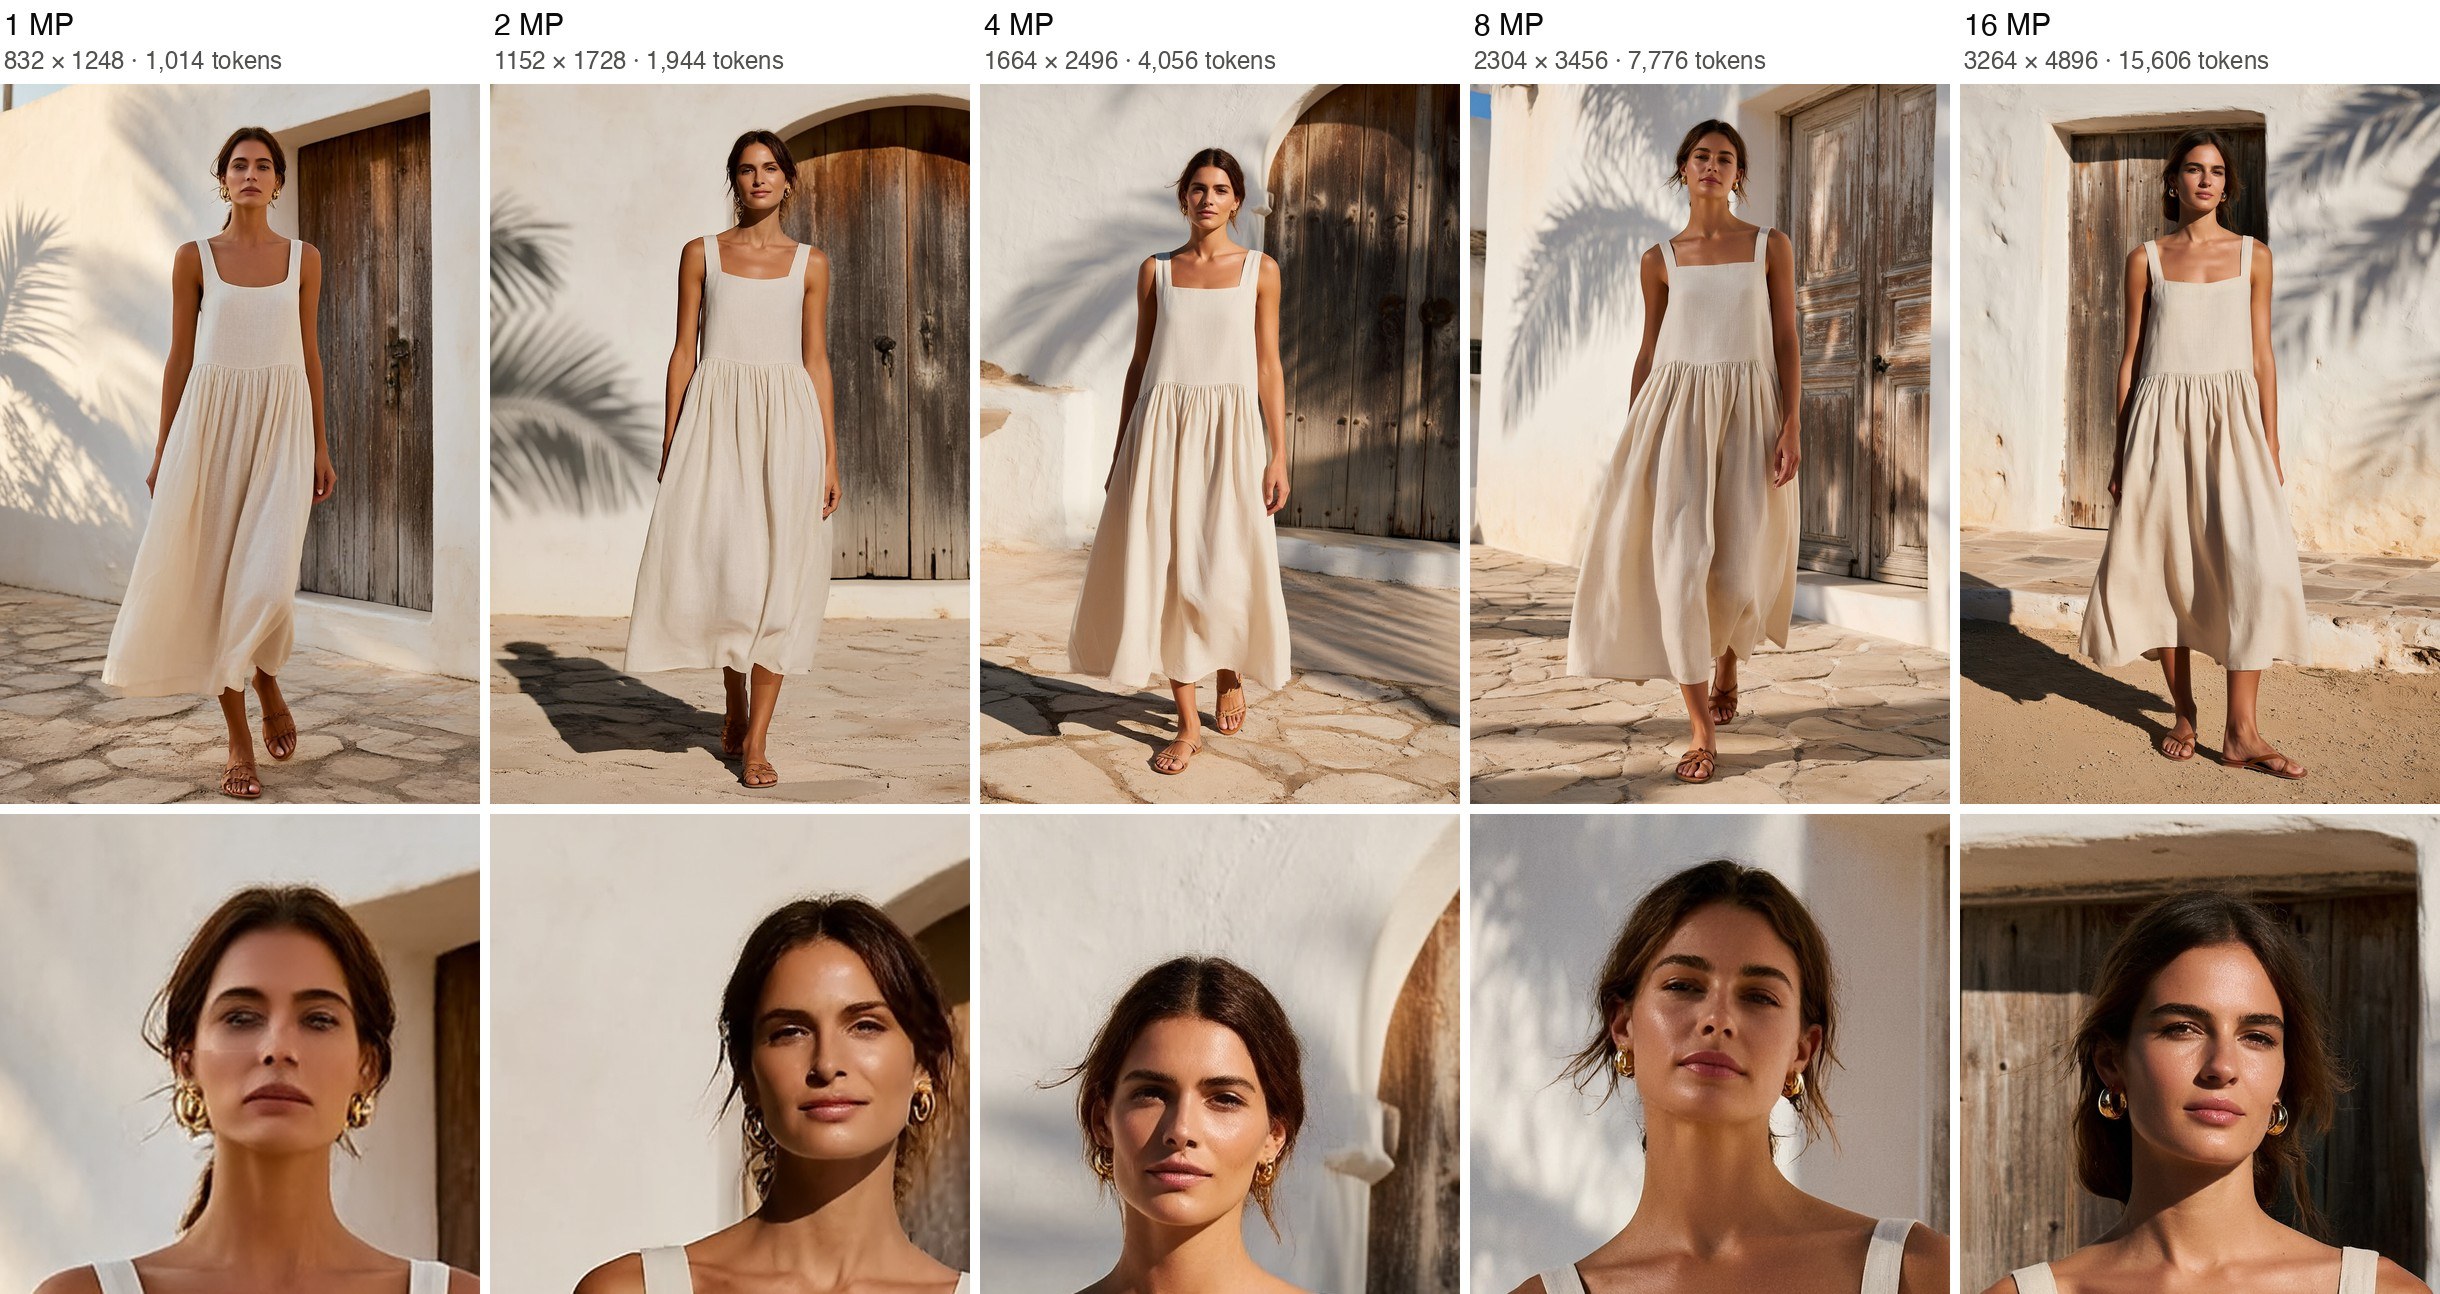
同じプロンプトとシードを1〜16 MPで生成し、顔を拡大したもの。1 MPでは肌が滑らかでワックスのようですが、8 MPからはテクスチャ、はみ出した髪、イヤリングが現れます。
幅と高さを指定しない編集はPicture 1のサイズで生成され、少なくとも4 MPまで拡大されます。2つのサイズを渡すと変わるのはキャンバスのサイズで、中の画像は変わりません。
入手方法
- 重みとdiffusersパイプライン: PrunaAI/P-H3-Image
- ComfyUI用ファイルとワークフロー: PrunaAI/P-H3-Image-Comfy
- ブラウザデモ: Hugging Face SpacesのPrunaAI/P-H3-Image
- ComfyUIサポート: PR 17506、v0.44.0に収録
コメント
GitHubでサインインしてディスカッションに参加しましょう。