Anima RGBAがComfyUIでAnimaに本物のアルファチャンネルを付与
Anima RGBAは4チャンネルのQwen-Image VAEとAnima LoRAを組み合わせ、カスタムノードなしでモデルが透明PNGをレンダリングできるようにします。ホールドアウトセットでのアルファMAEは0.0027です。
transparent background を入れると、VAE Decode がストレートなRGBとアルファを返し、Save Image がそれをRGBA PNGとして書き出します。カスタムノードは不要です。
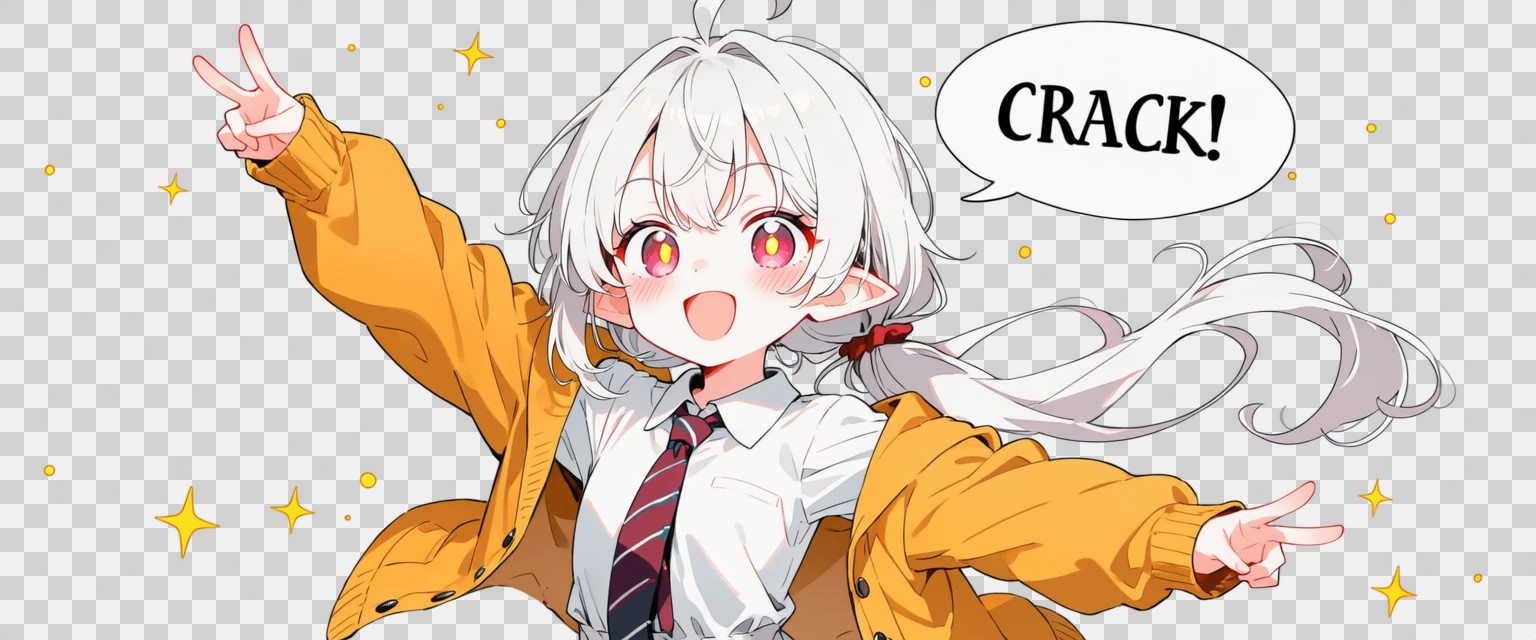
RGBA VAEとLoRAで生成し、チェッカーボード上に表示したもの。
AnimaはQwen-Image VAEを使用しており、これは3チャンネルにデコードします。そのため、モデルに透明な背景を要求すると、モデルが空だと想像するよう指示された背景の上に被写体が描かれ、切り抜きは後からマッティング処理で行われます。RGBA VAEはそれをデコーダー内に移します。最終層が3チャンネルではなく4チャンネルになるだけです。
3チャンネルVAEを4チャンネル化する
仕組みは見た目より小さいものです。VAEは16チャンネルの潜在を1/8解像度で保持するため、Animaの潜在空間は何も変わりません。エンコーダーは白背景で合成したRGBとアルファチャンネルを受け取り、デコーダーはストレートな、乗算前のRGBとアルファを出力します。
残りは初期化が担います。3チャンネルの重みがコピーされ、新しいアルファ入力列はゼロから始まり、新しいアルファ出力行はバイアス+1でゼロから始まります。そのためトレーニング前の時点では、モデルはオリジナルのVAEを再現し、すべてを不透明としてデコードします。その後トレーニングによって、同じ白合成に対する凍結されたオリジナルの潜在へと新しいエンコーダーが引き寄せられ、Animaがすでに動作する潜在空間が維持され、LoRAには学習すべき小さなアルファ残差だけが残ります。
白背景での合成は意図的な選択です。アルファがゼロの箇所ではRGBは未定義であり、透明背景プロンプトに対してAnimaがすでに描くのは白合成だからです。これによりRGBAの潜在はベースモデルが生成するものに近いまま保たれます。計測されたドリフトは潜在の標準偏差を単位とするRMS距離で0.058、1シグマの約6%であり、これがLoRAの埋めるギャップです。
数値が示すもの
VAEは512 pxのクロップでバッチ4、12,000ステップのトレーニングを行いました。損失はランダムな単色背景に対するL1合成損失、LPIPS 0.2、アルファL1、アルファSobel勾配項、そしてオリジナルのエンコーダーに対する参照潜在MSEです。各バッチの15%は正則化用の不透明画像でした。512 pxの透明画像200枚と不透明画像50枚からなるホールドアウトセット(いずれもトレーニングには使用していません)での結果は次のとおりです:
| 指標 | 値 |
|---|---|
| アルファMAE | 0.0027(約0.7 / 255) |
| アルファRMSE | 0.0157(約4 / 255、辺に集中) |
| 白背景で合成したPSNR | 34.94 dB |
| 黒背景で合成したPSNR | 33.17 dB |
| 不透明PSNR、オリジナルQwen-Image VAE | 34.26 dB |
| 不透明PSNR、Anima RGBA VAE | 34.74 dB |
不透明部分の再構成はオリジナルよりわずかに良い(悪化ではなく)というのが有用な結果です。VAEを交換しても通常の画像では何も失われません。
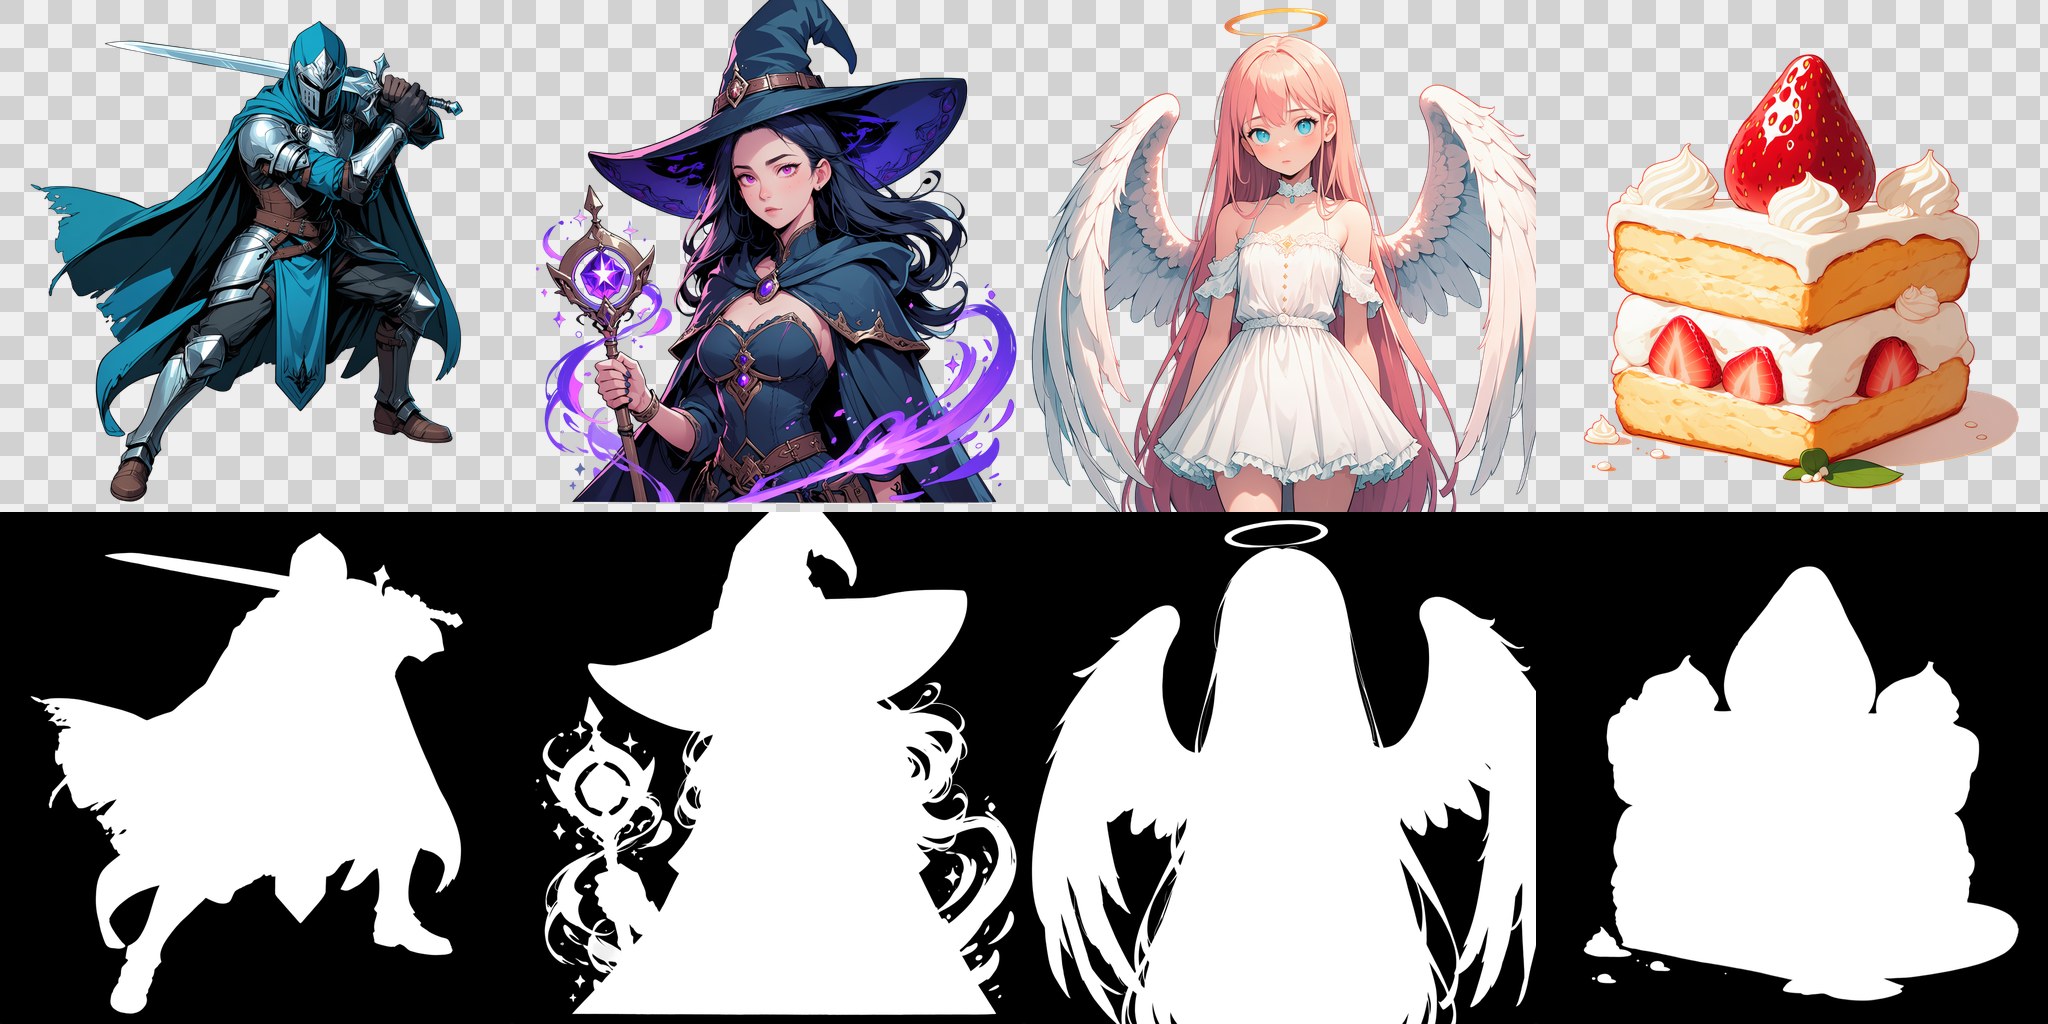
上段: チェッカーボード上のRGBA出力。下段: アルファチャンネル単体。
それでもLoRAが必要な理由
LoRAなしでもVAEはアルファチャンネルを生成しますが、それはぼやけたものです。キャラクターや白い衣服が半透明になってしまいます。ベースモデルの潜在が新しいデコーダーの期待と大まかにしか一致しないためです。LoRAはこのVAEの潜在に対して、rank 32、25,000ステップ、18,426枚の画像でトレーニングされ、Qwen3テキストエンコーダーとLLMアダプターは凍結されています。透明画像には transparent background と isolated on a transparent background の2種類のトリガー行が交互にキャプションとして付与され、不透明な正則化画像にはトリガーがありません。
モデルカードのテスト表(1024 x 1024で8プロンプト×2シード)は、パラメータを動かすと何が起きるかを示しています:
| LoRA強度 | トリガー重み | 透明 | 半透明ピクセル |
|---|---|---|---|
| なし | 1.0 | 16 / 16 | 12.8% |
| 1.0 | 1.0 | 16 / 16 | 0.9% |
| 1.2 | 1.0 | 16 / 16 | 1.0% |
| 1.5 | 1.0 | 16 / 16 | 1.4% |
| 1.0 | 1.2 | 16 / 16 | 0.9% |
| 1.0 | 1.5 | 16 / 16 | 0.9% |
どの設定でも透明な結果が得られるため、重要なのは不要な半透明ピクセルの割合です。LoRAなしで12.8%、デフォルトで0.9%です。LoRAを1.5に上げても効果はなく、被写体の周囲に半透明の破片や煙が追加されます。一方トリガー重みを上げても画像とアルファはほとんど変わりません。これは通常の直感とは逆であり、カードもはっきりそう述べています。上げるべきはトリガー重みであり、LoRA強度ではありません。
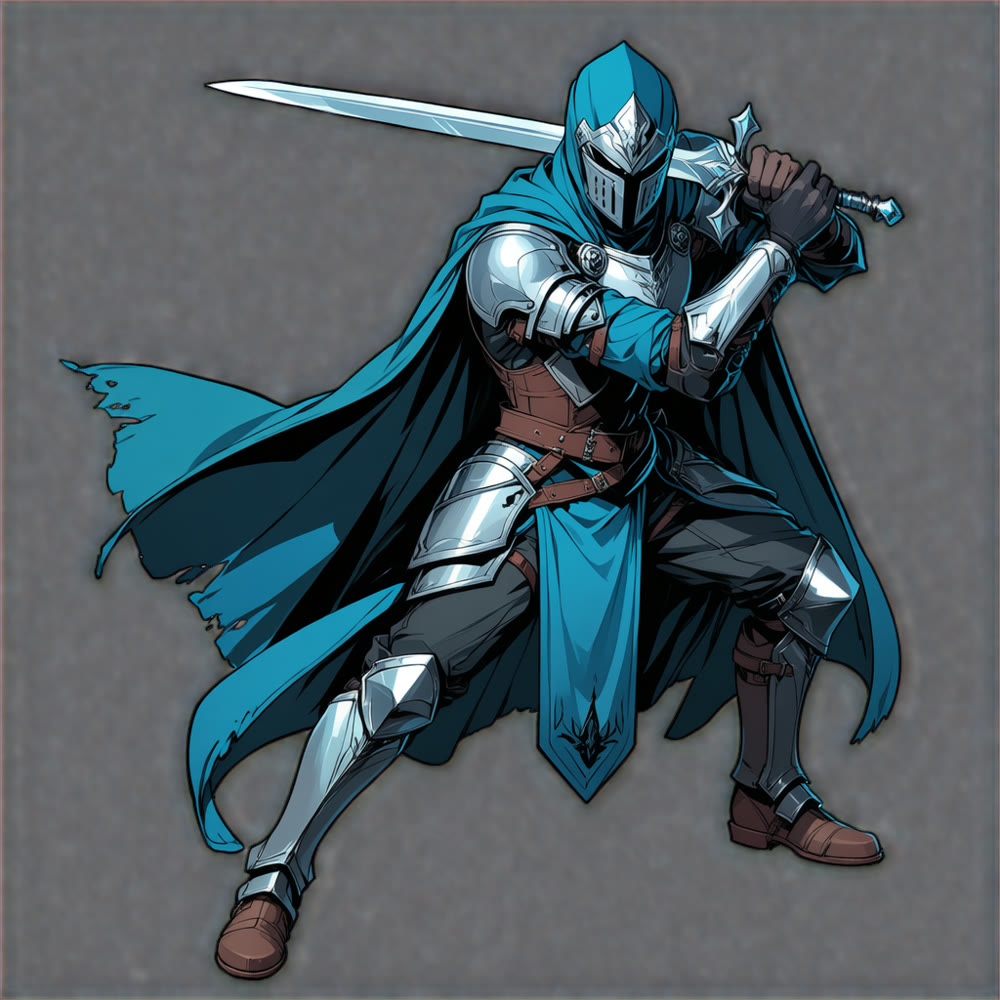
LoRA 1.0、30ステップ、CFG 4.5、simple のer_sdeによる全身キャラクター。
苦手な領域
VAEは512 pxのクロップでトレーニングされ、より高い解像度でもデコードできますが、髪の毛の一房、ガラス、煙といった細かな半透明のディテールが最も苦手な領域です。生成されるアルファはほぼ二値的であるため、透ける衣服はたいてい不透明になります。フレームを満たすようなクローズアップでは、不透明な白背景が残ることがあり、他のLoRAを重ねているとより頻繁に起こります。Animaが描くアニメやイラストのコンテンツ向けに作られています。
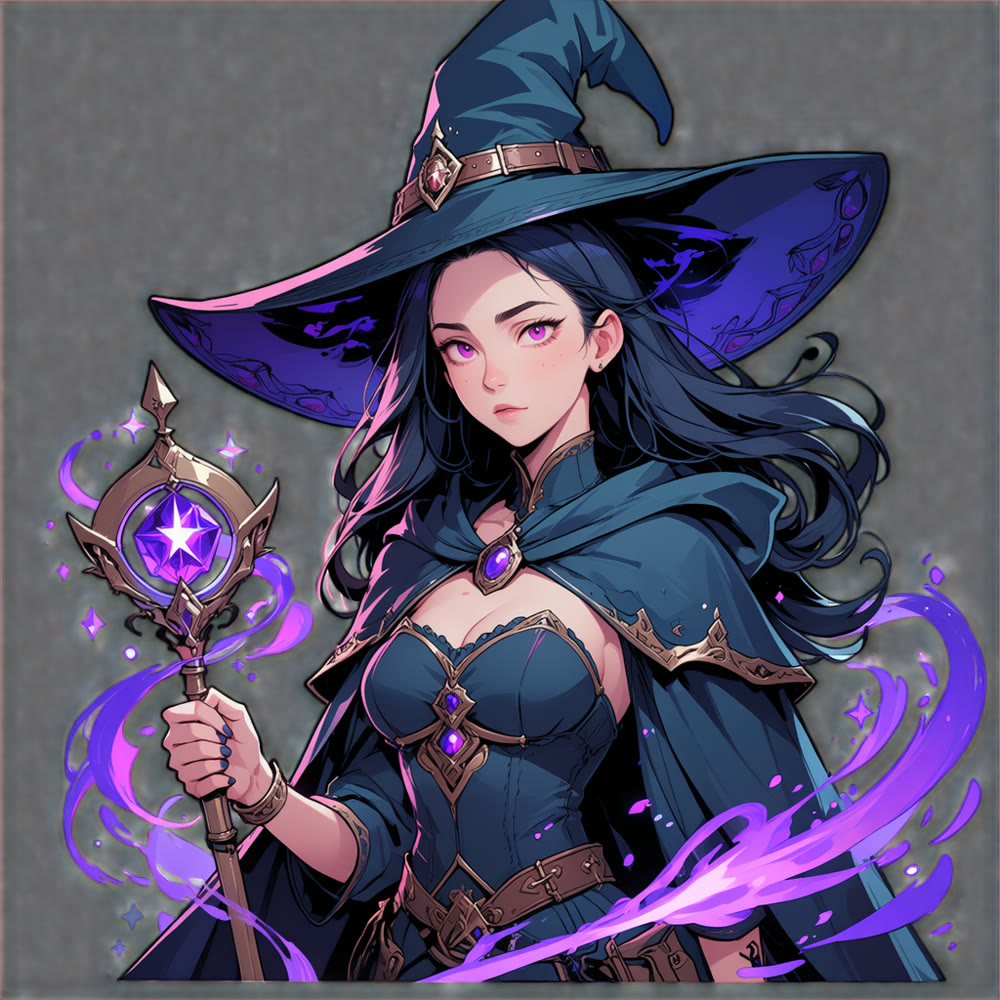
別の被写体に同じレシピを適用したもの。帽子と杖を通してアルファが保持されています。
コメント
GitHubでサインインしてディスカッションに参加しましょう。