Pika H3 Flex Turbo: 2、4、8ステップのH3 LoRAを1ファイルに
akhaliqがPika H3 FlexとH3のfew-step蒸留を融合し、7つの単一ファイルLoRAを作成。2ステップのドラフト、4ステップの高速版、8ステップHD、rank-32のliteビルドを収録。
PikaはFlexをH3ベース上の2つのLoRAアダプターとして提供し、few-stepの世界には同じベース向けのturbo蒸留がすでに存在していました。両方を重ねれば、作者が狙ったとおり、Pikaのポスト学習済みモーションを半分の評価回数で得られます。ComfyUIグラフで2つのLoRAを重ねることは可能ですが、2つのローダー、2つのstrengthウィジェット、そして1つで済むところにファイルのフォルダーが必要になります。そのため、ここにある各ファイルは単一の融合済みアダプターです。
カスタムノードもモデルパッチも不要です。1つのファイルを ComfyUI/models/loras にドロップし、既存のH3ワークフローで LoraLoaderModelOnly に強度1.0で読み込み、そのファイルが想定するステップ数を選びます。
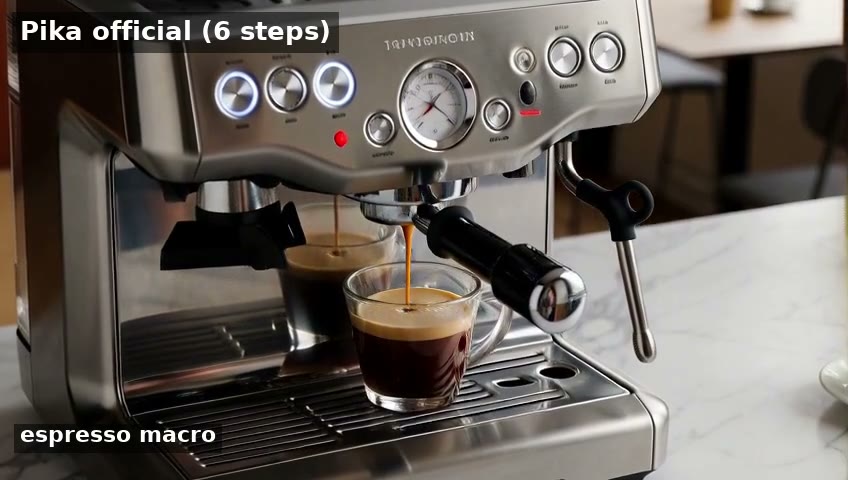 | 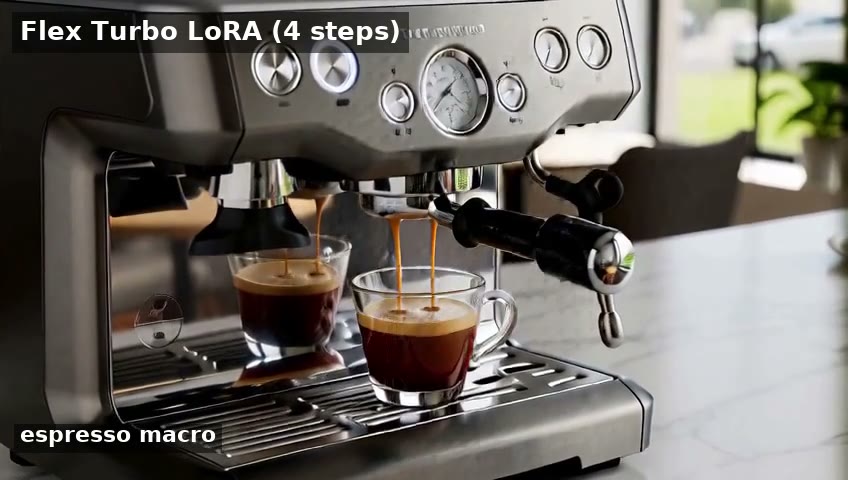 |
|---|---|
| Pika公式アダプター、6ステップ | 4ステップturbo LoRA、同じシード |
プロジェクトの比較クリップから、標準のint8 H3での1プロンプトを2つのパネルに分割したもの。左が公式6ステップ、右が4ステップLoRAです。
5つのプロンプト、同じシード、848x480、ステレオ音声。左が公式6ステップ、右が4ステップLoRAです。
速度ごとに1ファイル
ラインナップはtransformerとステップ数で分かれています。H3の2つの動画transformerは異なる役割を担うためです。参照から動画のファイルは参照ワークフローと品質マージ向けで、FL2VAファイルは標準のテキストおよび画像からのパス向けです。
| ファイル | Transformer | ステップ | サイズ |
|---|---|---|---|
pika_h3_flex_turbo_2step_draft_ref2va.safetensors | Ref2VA | 2 | 3.9 GB |
pika_h3_flex_turbo_4step_fl2va.safetensors | FL2VA | 4 | 3.9 GB |
pika_h3_flex_turbo_4step_ref2va.safetensors | Ref2VA | 4 | 3.9 GB |
pika_h3_flex_turbo_8step_hd_fl2va.safetensors | FL2VA | 8 | 3.9 GB |
pika_h3_flex_turbo_8step_hd_ref2va.safetensors | Ref2VA | 8 | 3.9 GB |
pika_h3_flex_turbo_4step_fl2va_lite_r32.safetensors | FL2VA | 4 | 0.31 GB |
pika_h3_flex_turbo_4step_ref2va_lite_r32.safetensors | Ref2VA | 4 | ~0.3 GB |
4ステップ側は、FL2VA向けがlightx2v v1.2 768p、Ref2VA向けがref2v v0.1です。作者がスタッキングの既知のリグレッションと呼ぶv1.3ではなく、これらが明示的に選ばれています。2ステップファイルでは代わりに pDMD 2-NFE を融合しています。Flexスタイルは2ステップと4ステップのファイルでは0.5、8ステップHDペアでは0.6で焼き込まれており、これはfew-step蒸留の上にスタイルアダプターを重ねる際にH3コミュニティが落ち着いた強度範囲です。
2つの lite_r32 ファイルはrank-32の圧縮ビルドです。正確なQR積の切り詰めにより、**融合後のスペクトルエネルギーの96.1%**を 0.31 GB で保持し、フルサイズの3.9 GBアダプターより12.6倍小さくなっています。
近似マージではなく正確な融合
2つのLoRAを単純に加算マージすると、出力側のB行列で衝突が起きます。作者はこれをLoRA合成に関する2026年の論文から引用しています。連結では衝突が起きないため、各ファイルはレイヤーごとのrank連結です:
B_fused @ A_fused == s·(B_flex @ A_flex) + 1.0·(B_turbo @ A_turbo)これにより、融合ファイルは両方のアダプターを重ねて読み込む場合と機能的に同一になります。フィッティングではなく構成上そうなるからです。作者はアップロード前にレイヤーごとに数値検証し、bf16のラウンドトリップで最悪の相対誤差は約 2.6e-7 でした。その後、以下のクリップを用いてGPU上でエンドツーエンドに再検証しています。
実測速度
同じベース、同じシード、同じプロンプト、CFG 1、848x480、121フレーム、ステレオ音声:
| ハードウェア | 構成 | ステップ | 5秒クリップあたり | 公式比 |
|---|---|---|---|---|
| H200 | Pika公式アダプター | 6 | 60秒 | 1x |
| H200 | このLoRA | 4 | 40秒 | 1.5倍高速 |
| H200 | このLoRA、ドラフト | 2 | 約25秒(サンプリング14秒) | 約2.4倍高速 |
| H200 | このLoRA、HD | 8 | 70秒 | 0.86x、品質最大 |
| A100 | Pika公式アダプター | 6 | 109.3秒 | 1x |
| A100 | このLoRA | 4 | 66.0秒 | 1.66倍高速 |
| Base H3 | アダプターなし | ~40 | ~500秒 | 約8〜12倍遅い |
同じカードでは1ステップあたりのコストは同一で、H200では約7秒/ステップ、A100では12.5秒/ステップです。したがって節約分はすべて、ステップが安くなったのではなく、必要な評価回数が減ったことによるものです。
破綻するケース
- 2ステップファイルはドラフト用ツールです。 作者の最初のテストバッチでは、5件中4件は昇格後も品質を保ちました。フレーミングとモーションの反復に使い、最終レンダーは4または8ステップで行ってください。
- 音声は6ステップ未満で劣化します。 これはすべてのH3 turboに当てはまります。2ステップで最も悪くなるため、サウンドトラックが重要な場合は4ステップ以上でレンダーしてください。
- ステップ数は互換ではありません。 4ステップファイルはちょうど4ステップに調整されており、8ステップHDペアは6〜8ステップで効果を発揮します。
- さらに強いアダプターを重ねないでください。 2ステップと4ステップのファイルに高強度で重いスタイルLoRAやモーションLoRAを追加すると、融合の意味が失われます。
作者はこれらをSingularityなどの品質マージ上でも実行しており、そこでは4ステップのRef2VAファイルが推奨の組み合わせです。以下のクリップでは、この組み合わせが公式Pikaの6ステップより高速で見た目も良いと報告しています。
高アクションのストレステスト。武道とスケートボードのランで、左が公式6ステップ、右が4ステップLoRAです。few-stepモデルは速い動きで最も弱くなるため、判断すべきはこのクリップです。
ComfyUIでの使い方
- transformerに合うファイルを
ComfyUI/models/lorasにコピーします。参照ワークフローと品質マージにはRef2VAファイル、標準のテキストおよび画像から動画にはFL2VAを使います。 - いつものMiniMax H3ワークフローを読み込み、
LoraLoaderModelOnlyを強度 1.0 で追加します。 - ファイルに合わせて 2、4、8ステップ でサンプリングし、CFG 1.0、
euler、lcm、res_multistepのいずれかとsimpleschedulerを使います。Flow shiftはFL2VAで 6.0、Ref2VAで 12.0、audio shiftは 3.0 です。
リポジトリには、比較の生成に使われた5方向レンダーとsamplerスイープのスクリプトを含む scripts/ も同梱されています。特定のパネルを再現したい場合は sampler_sweep_results.json も利用できます。ファイルはH3互換の任意のローダーで読み込めるためDiffusersでも動作し、同じアダプターはint8およびGGUFのH3ビルドでも実行できます。
入手方法
- Hugging Faceのakhaliq/Pika-H3-Flex-Turbo-LoRA。7つのアダプター、6つの比較クリップ、レンダースクリプト入り
- Pika H3 Flex、lightx2v/Minimax-h3-Turbo、pDMD 2-NFEを、MiniMax H3ベースの上に構築
- 本記事のフレームはプロジェクト自身の比較クリップから取得しています
コメント
GitHubでサインインしてディスカッションに参加しましょう。