Krea 2 Turbo 3ステップ蒸留LoRA: 8ステップ教師を上回るディテール
rank-64のLoRAでKrea 2 Turboをcfg 1.0のまま8ステップから3ステップへ短縮。微細テクスチャは教師モデルの1.11倍を計測し、標準ノードのみのComfyUIワークフローも付属します。
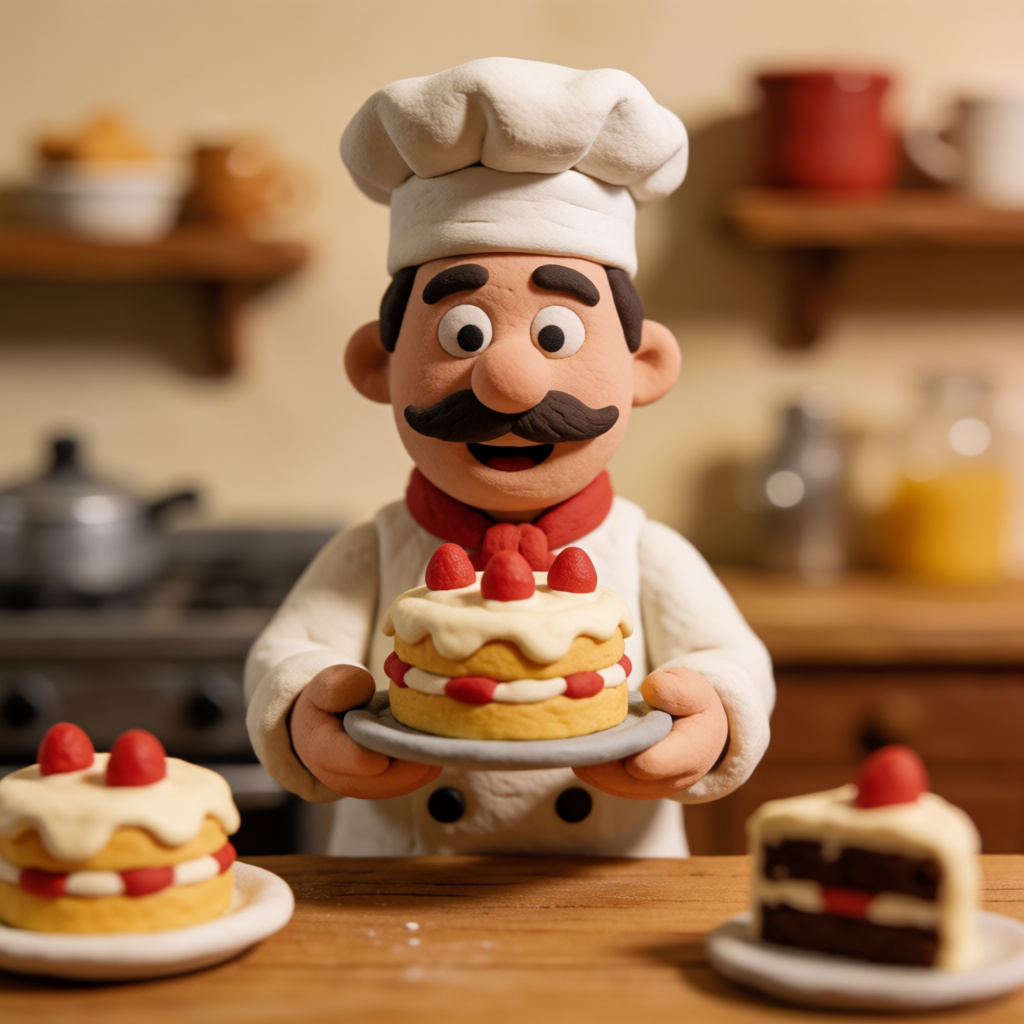
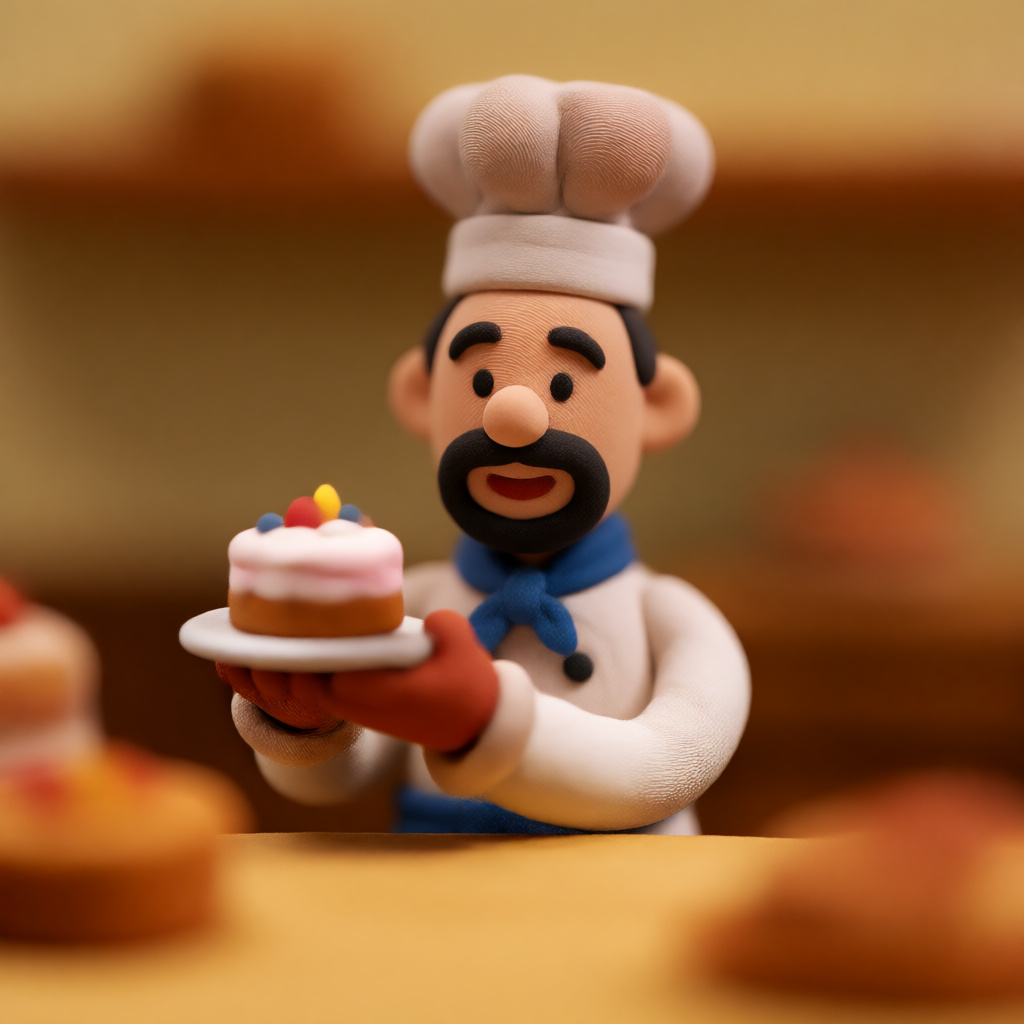
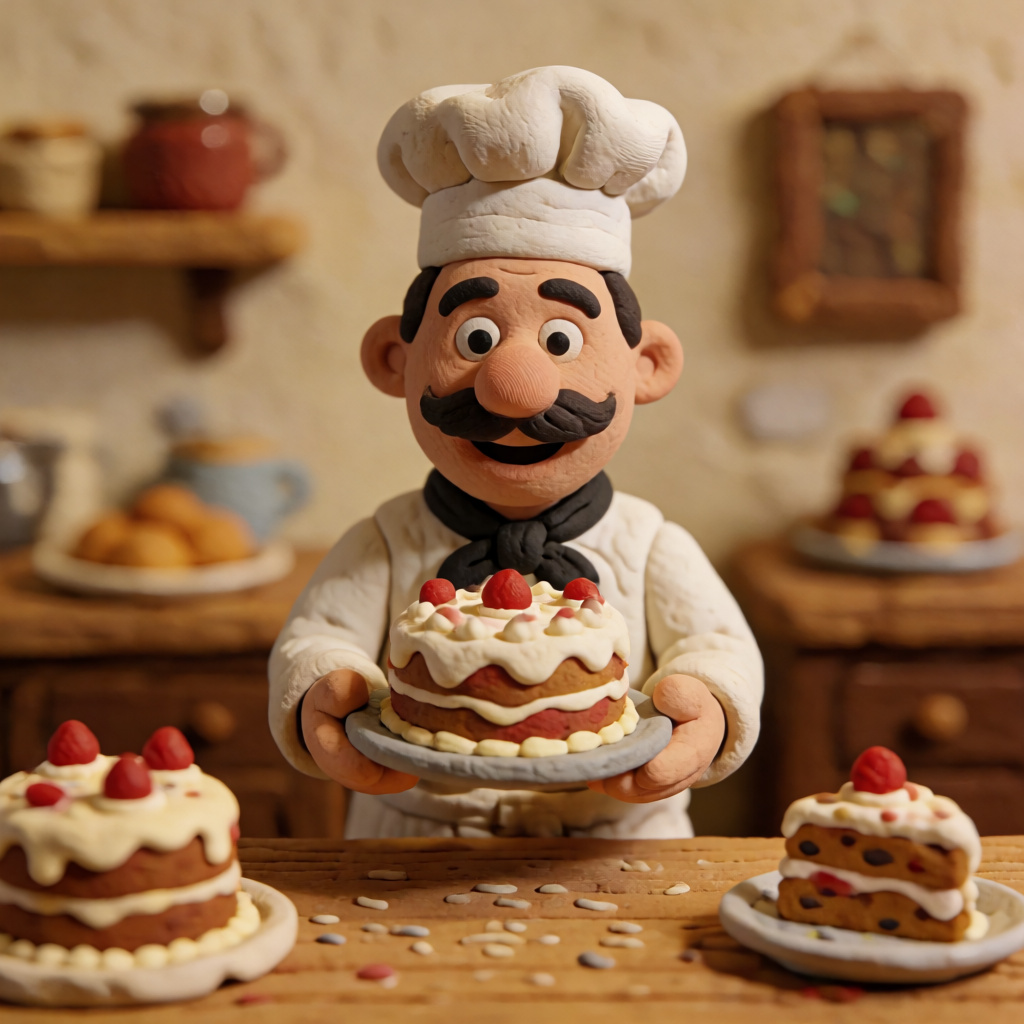
Krea 2 Turboを8ステップから4ステップへ、さらに2ステップへと短縮してきた同じ作者が、その間を埋めました。このアダプターはモデルを3ステップで実行し、denoisingが約2.6倍高速になります(1024x1024、float16、テキストエンコードとVAEデコードを除く条件で65.4秒から24.9秒)。一方、作者の22個のテストプロンプトでは微細テクスチャが8ステップ教師モデルの1.11倍と計測されました(4ステップアダプターは1.04倍)。標準のTurboを3ステップで動かすと0.58倍にとどまり、このLoRAはその差を埋めます。
 |  |  |
|---|---|---|
| Turbo 8ステップ: 品質の基準 | LoRAなしのTurbo 3ステップ: 柔らかく平坦 | LoRAありの3ステップ: ディテールが復元 |
プロジェクトはまだトレーニング中です。今回共有されたチェックポイントは chk00030000 で、最後の600サンプルで学習率をゼロまでアニールした安定した重みから取得されたものであり、作者はさらなるチェックポイントを予定しています。リポジトリ内の2つの重みファイルは、同じチェックポイントをdiffusers用とComfyUI用のキー名で格納したものです。
Turbo本来のスケジュールによる3ステップ
学生モデルは、Turbo自身の3ステップ用シグマ [1.0, 0.8633, 0.6123] に対して3回の呼び出しを行います。モデル固有のmuは1.15で、ガイダンスはありません。トレーニングは公開済みの4ステップアダプターの重みから開始し、その形状を引き継ぎました。同じ228モジュールに対するrank 64です。約30,000サンプルが、11種類の解像度(512x768から1440x1440、1824x1024まで)で記録された教師の軌跡から抽出されました。
以前のアダプターとは2点異なります。ベースは単一のH100/H200上でbf16で実行されました(4ステップと2ステップのプロジェクトはRTX 3090 1台で、重みのみint8のベースに対してトレーニングされました)。30,000サンプルで約91時間です。そして目的関数は依然として軌跡の模倣ではなく分布マッチングです。学生モデルは、凍結されたベース自身の中間ネットワーク特徴に乗った8個のクリティックで評価されます。対象はアーティファクト、実写らしさ、1回目の呼び出しのレイアウト、コンテンツ、プロンプトとの一致、文字、大きな顔、そして3回の呼び出し全体のロールアウトです。教師が生成しそうな結果に合わせること(その正確な経路ではなく)が、3ステップでもぼやけや二重エッジに平均化されない理由です。
計測された帯域もそれと一致します。微細テクスチャは教師の1.11倍、16ピクセル帯と8ピクセル帯は1.10倍と1.12倍、色は教師と同水準です。
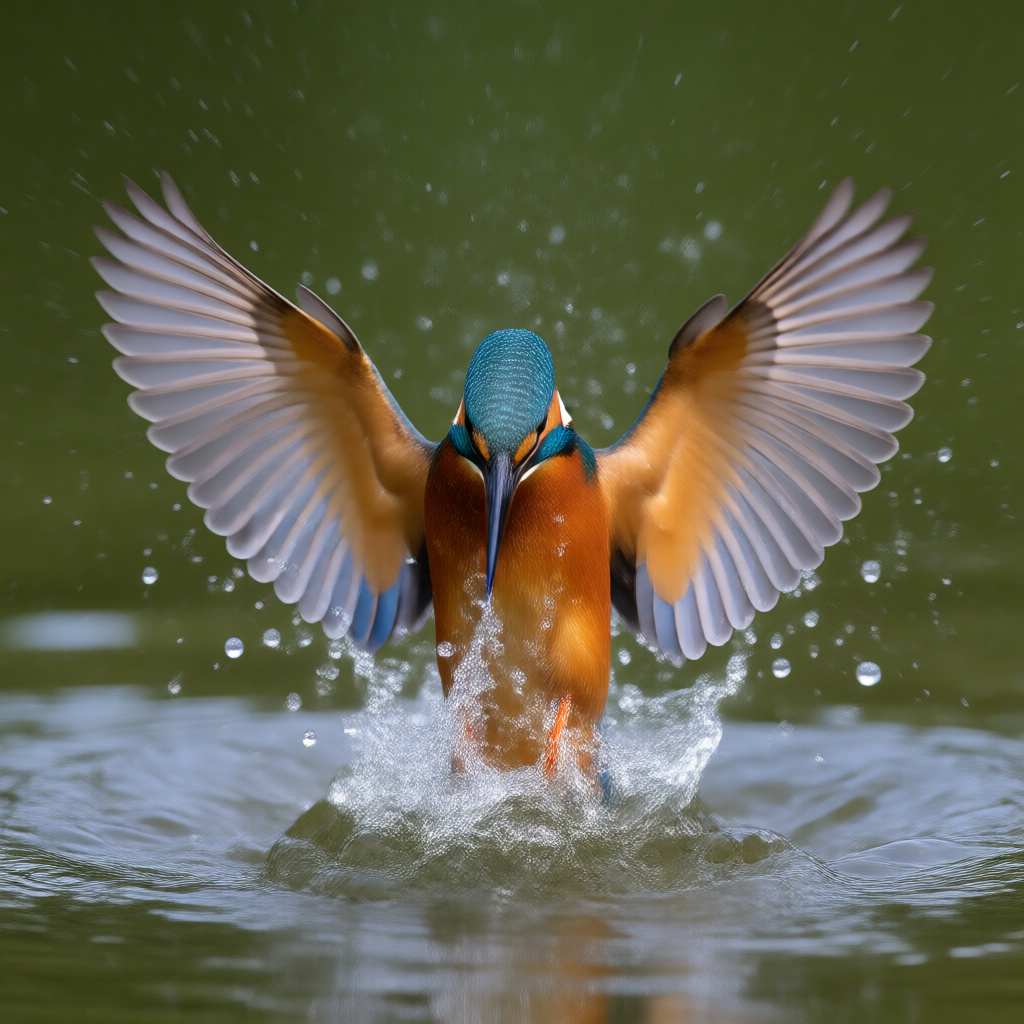
アダプターなしで3ステップ実行したTurboのkingfisherプロンプト。同じシードとプロンプトでLoRAを適用したバージョンがカバー画像です。
トレードオフとなる点
作者は利点とともにコストも公開しており、導入前に読む価値があります。
- 4ステップアダプターよりも教師の画像から離れる: 距離は0.320に対して0.401、ディテール一致度は0.39に対して0.26です。3ステップは同じノイズからのより短い経路なので、同じシードでも構図、ポーズ、あるいは小さな要素が8ステップのレンダーと異なることがあります。教師の画像は品質の参照であり、再現すべきターゲットではありません。
- テクスチャが教師より強くなる: 平坦な領域の粒子は教師の1.57倍で、以前のリリースの1.29倍から増えています。水彩紙、毛穴、フィルムグレインがより顕著に見えます。1.0未満の強度で弱められます。
- かすかな二重エッジが髪、雨の筋、細い手足に出ます。特に768x1024と1024x768で顕著です。ゴースト指数は教師の1.14倍で、4ステップアダプターは1.02倍です。
- 群衆の中の小さな顔は、数ステップのアダプターに共通する弱点として残ります。
実用的なLoRA強度のウィンドウは1.0付近で狭くなります。3ステップでは、粗い呼び出しを完成した画像に変える仕事のすべてをアダプターが担うためです。速度よりも教師自身のレンダーへの近さが重要な場合は、4ステップアダプターのほうが適したツールです。
ComfyUIでの使用方法
リポジトリには、ComfyUIのキー名で krea2_turbo_3step_rank_64_lora_comfyui.safetensors と、標準ノードだけで構築されたワークフロー krea2_turbo_3step_lora_t2i.json が含まれています。
| ファイル | 配置先 |
|---|---|
krea2_turbo_3step_rank_64_lora_comfyui.safetensors | ComfyUI/models/loras/ |
krea2_turbo_bf16.safetensors(Comfy-Org/Krea-2より) | ComfyUI/models/diffusion_models/ |
qwen3vl_4b_bf16.safetensors(同じリポジトリ) | ComfyUI/models/text_encoders/ |
qwen_image_vae.safetensors(同じリポジトリ) | ComfyUI/models/vae/ |
設定: steps 3、cfg 1.0、サンプラー euler / simple、LoRA強度 1.0。
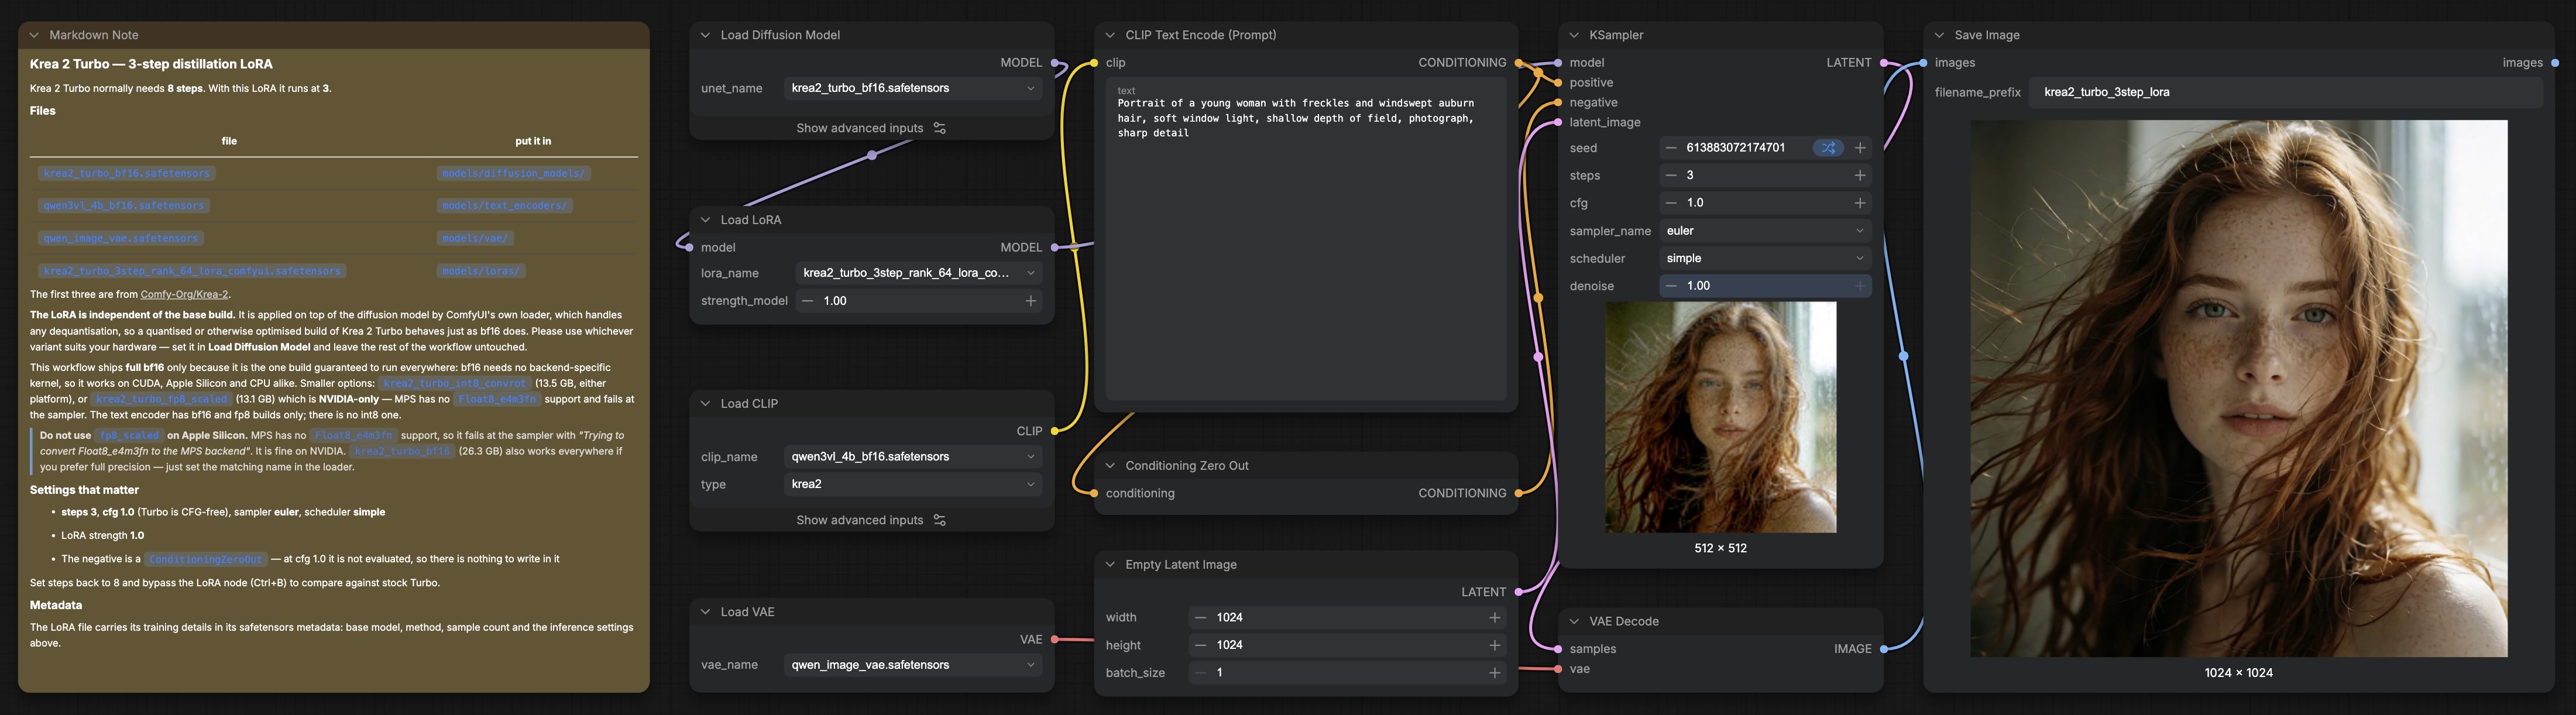
同梱ワークフロー: Krea 2 Turboと3ステップLoRA、標準ノードのみ。
guidance_scale=0.0 は、同じ設定をdiffusers流に書いたものです。
モデルカードから2つの注意点があります。量子化されたベースはメモリと引き換えにディテールを犠牲にします。Comfy Cloudの4-bit(nvfp4)Turboでは、アダプターの微細テクスチャはフルbf16レンダーより約5分の1低く計測されました。またApple Siliconでは、MPSに Float8_e4m3fn がないため fp8_scaled ビルドは読み込まれません。リポジトリには、作者のLVNodes Krea 2 MLXノードを通して同じLoRAを実行する別のMLXワークフローがあります。
おまけとして、同じアーキテクチャを共有するKrea 2 Rawでも読み込めます。Rawを13ステップ、CFG 3.5で実行すると、Rawの構図を保ちつつ、そのステップ数ではRawが失うディテールを追加します。これは未トレーニングの領域であり、サポート対象のモードではないと作者は明言しています。
入手方法
- Hugging Face: lvladikov/Krea2-Turbo-Distill-3step-LoRA、22枚の比較シートと
DETAILED-README.mdに完全なトレーニング記録があります - 4ステップLoRAは引き続きTurboの8ステップ出力に最も近い選択肢です。2ステップLoRAはプレビュー向けの選択肢です
- 上記の計測値はすべて作者自身によるもので、22個のテストプロンプトで取得されています。カードには既知の問題が発生頻度順に記載されています
コメント
GitHubでサインインしてディスカッションに参加しましょう。