Primal VAE: Fluxの潜在形状に一致する2倍ダウンサンプリング
OstrisがPrimal VAEを公開しました。約80Mパラメータのオートエンコーダ2種で、ダウンサンプリングは2倍のみ、8倍のパッチ化はDiTに任せ、スケーリング係数もシフト係数も持ちません。
2x1 は2倍ダウンサンプリングして1チャンネルに、2x2 は2チャンネルにします。
最近のVAEのほとんどは画像を8倍に圧縮し、その後に拡散モデルへ、測定されたスケーリング係数やシフト係数、あるいはバッチノーム統計で再スケーリングが必要な潜在を渡します。Primal VAEは別の道を取ります。VAEは2倍の空間縮小のみを行い、残りの4倍はDiT自身のパッチ化ステップが担います。2倍で1チャンネルの潜在を4通りにパッチ化すると8倍で16チャンネルになり、これはFlux.1 VAEが生成する形状と同じです。2チャンネル版は8倍で32チャンネルとなり、Flux.2 VAEの形状です。
| モデル | 潜在 | パッチ4 | 同じ形状の対象 |
|---|---|---|---|
2x1 | 1 ch @ 2x | 16 ch @ 8x | Flux.1 VAE (16 ch @ 8x) |
2x2 | 2 ch @ 2x | 32 ch @ 8x | Flux.2 VAE (32 ch @ 8x) |
どちらのチェックポイントも約80Mパラメータで、画像の各辺は16の倍数である必要があります。
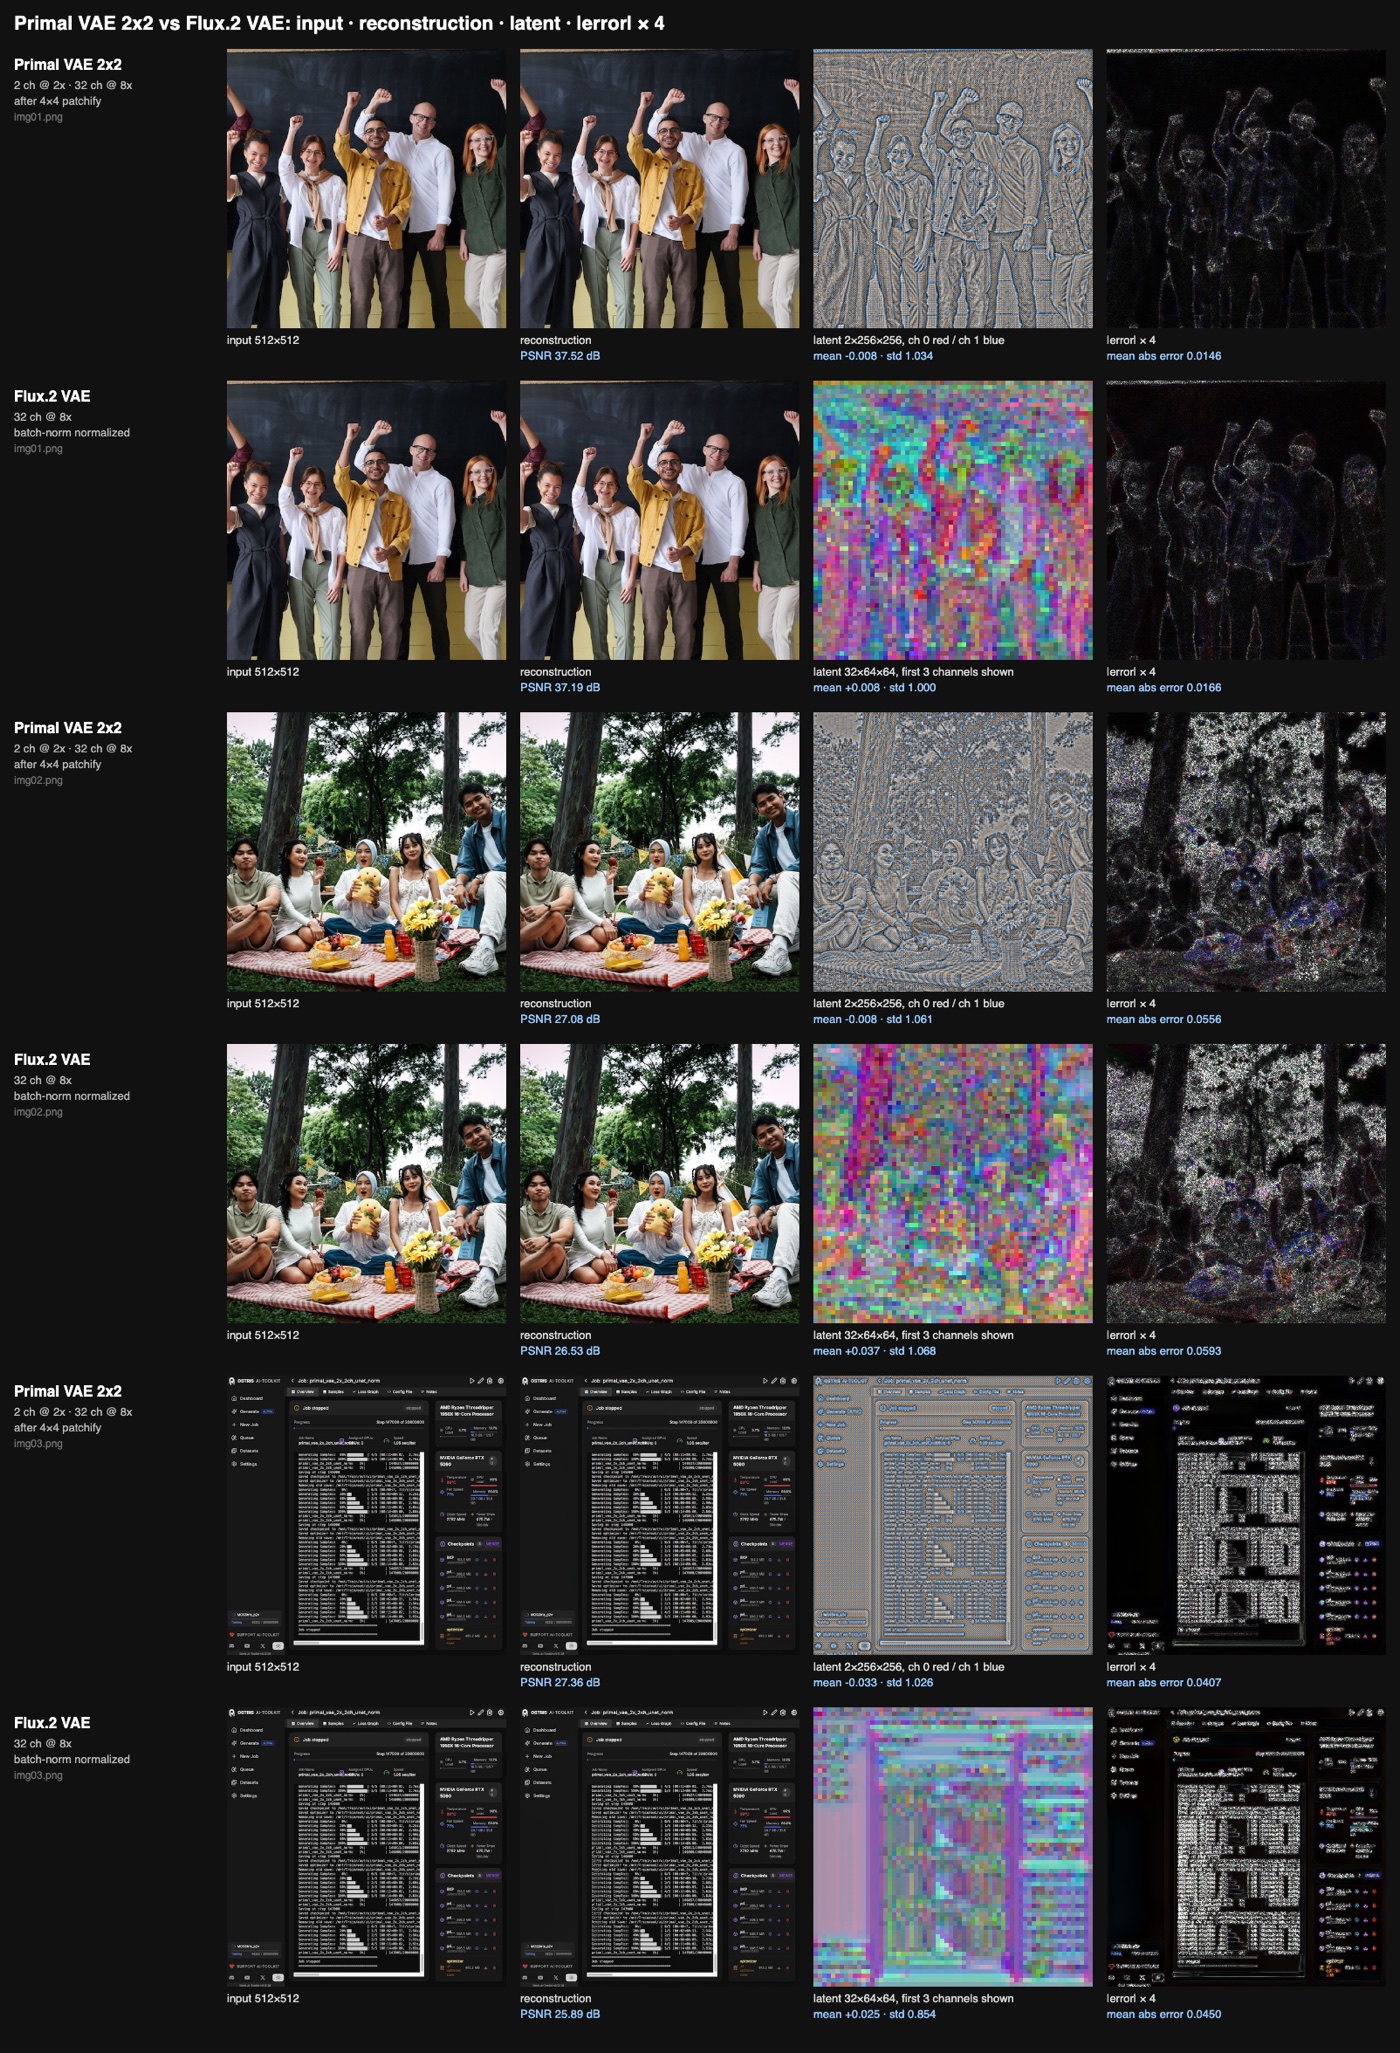
各行は入力、再構成、潜在、|error| x 4 です。各Primal VAEの行の下には、同じ潜在レイアウトを持つFlux VAEが同じ画像に対して並びます。潜在は3シグマで描画され、2チャンネル潜在はチャンネル0を赤、チャンネル1を青で示します。
リポジトリにある3枚の512 px画像での再構成品質(dB):
| 画像 | Primal 2x1 | Flux.1 VAE | Primal 2x2 | Flux.2 VAE | |---|---|---|---| | img01 (人物、スタジオ) | 32.1 | 35.7 | 37.5 | 37.2 | | img02 (ピクニック、木々) | 22.0 | 24.2 | 27.1 | 26.5 | | img03 (UIスクリーンショット) | 21.3 | 24.7 | 27.4 | 25.9 |
作者は、3枚の画像とPSNRはベンチマークではないと率直に述べており、KL VAEはその事後分布のノイズに対して、決定的なVAEが払わない再構成のコストを払うとしています。2x2版は、8x8ピクセルブロックあたり32値という同じ情報量の予算でFlux.2 VAEに匹敵するか上回ります。2x1版はテクスチャのあるコンテンツではFlux.1 VAEに劣ります。2倍での1チャンネルは余裕のない12:1の削減であり、さらに2x2の実行の半分にも大きく満たないトレーニングステップ数しか受けていません(62kに対し147k)。
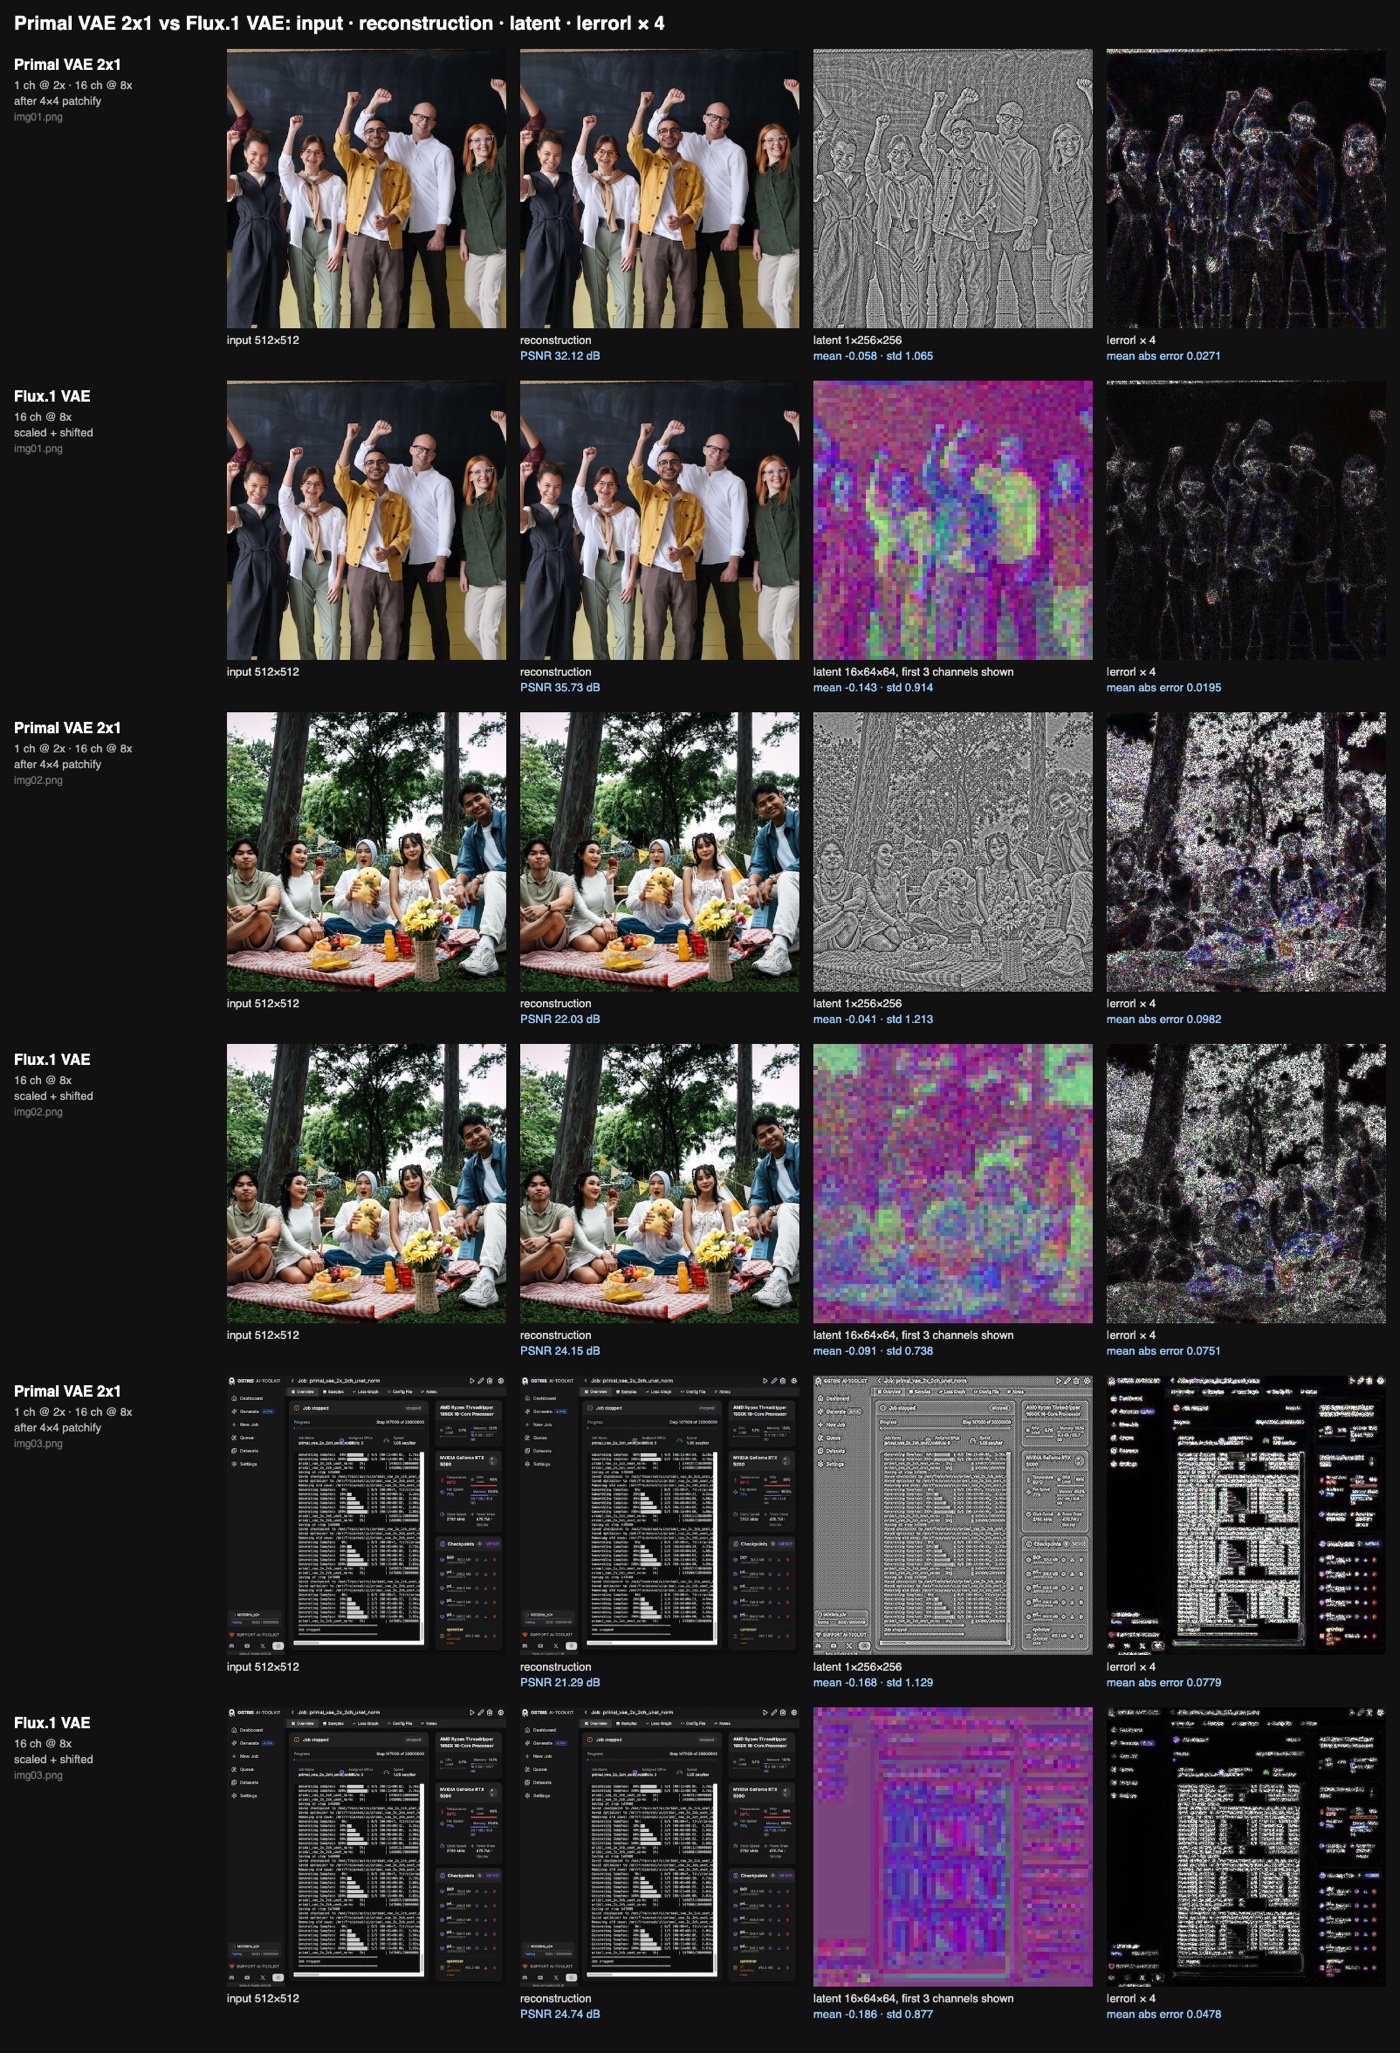
1チャンネルの比較。単一チャンネルの潜在はグレーで示され、その画像ごとの標準偏差は依然として1.07から1.21へと変動します。これは最後の9kステップでしか画像ごとの正規化を受けていないためです。
アーキテクチャ
両方のバリアントは同じネットワークで、出力チャンネルのみが異なります:
- 入力は
pixel_unshuffle(2)を通るため、RGBは半分の解像度で12チャンネルになります。すべては潜在解像度以下で動作し、これにより潜在は画像の空間的に忠実なマップに保たれます。 - エンコーダとデコーダは鏡像の畳み込みU-Netで、画像サイズの1/2、1/4、1/8、1/16の4レベル、幅は96 / 192 / 384 / 384、残差ブロックのダイレーションは1、2、4を循環します。
- 正規化は各位置でのチャンネル方向のRMSNormです。空間統計もアテンションもないため、タイルは(重なりがあれば)全体画像と同じようにエンコード・デコードされます。
- エンコーダは1または2チャンネルへの単純な3x3畳み込みで終わります。事後分布もKL項も量子化畳み込みもありません。
潜在をノイズに整合させる
拡散モデルはガウスノイズを基準にトレーニングされるため、潜在はすでにガウスノイズのように見えるべきです。KL項を追加して後からスケーリング係数を測定する代わりに、統計はエンコーダ出力の損失に直接組み込まれます:
- モーメント損失:
mean^2 + (std - 1)^2を重み0.1で、画像ごと・チャンネルごとに計算するため、データセット全体の平均ではなく、すべての画像が平均0・標準偏差1で出力されます。 - ガウス順序統計損失: 各画像・チャンネルの潜在値はソートされ、同じサイズの標準正規分布の期待順序統計とBlomの近似を用いて照合されます。これにより最初の2つのモーメントではなく分布全体の形状が固定されるため、平坦なグレー画像でも定数ではなくノイズに似たものへとエンコードされます。
そのため、持ち運ぶべきスケーリング係数、シフト係数、潜在の正規化はなく、エンコードは分布ではなく単なるテンソルを返します: encode は .latent_dist もサンプリングステップもなしで [B, 1, H/2, W/2] を返します。
トレーニング
再構成はMAE 0.5とLPIPS 1.0、加えて対数振幅の2Dスペクトルに対する重み0.1のL1項で、正確な位相を要求せずに高周波のエネルギーを押し上げます。さらに、潜在をより拡散しやすくするためのいくつかの工夫があります:
- EQ-VAEから取られた潜在の反転と回転: 50%のステップで潜在は反転または90度回転され、同じ変換を施した画像に対してデコードされるため、潜在は任意のコードではなく画像の写像でなければなりません。
- ノイズ摂動デコード: 20%のステップでデコーダは
z + sigma * noiseを受け取ります。sigmaは画像ごとにU(0, 0.5)から抽出され、それでもクリーンな画像を再構成しなければならないため、デコーダは拡散の誤差を許容することを学びます。 - 画像の5%はランダムな単色に置き換えられます。平坦な領域は画像ごとに正規化された潜在にとって難しいケースだからです。
- 2x1版は最後の9kステップをクリティック付きで過ごしました。凍結されたSigLIP2 NaFlex ViTが、実画像と再構成画像のレイヤー4、8、12からネイティブ解像度でパッチ特徴を供給し、スペクトル正規化された小さな畳み込みヘッドがヒンジ損失とR1でトレーニングされ、デコーダは重み0.1でジェネレータ項を受け取ります。2x2はクリティックなしでトレーニングされました。
公開されている重みファイルはトレーニングチェックポイントそのままで、fp32です。推論時に torch_dtype=torch.bfloat16 で読み込むと約0.05 dBのコストがかかります。
利用可能性
Primal VAEはまだComfyUI内では使用できません。カスタムVAEローダーノードもComfy-Orgによる再パッケージもコアサポートもありません。リポジトリには trust_remote_code=True を用いたdiffusersの AutoModel 実装(modeling_primal_vae.py と config.json)が含まれており、文書化されている手順は AutoModel.from_pretrained("ostris/primal_vae", variant="2x1") の後に patchify / unpatchify を実行してFlux.1またはFlux.2のトークンレイアウトに到達する方法です。
10月31日に開かれたリポジトリのディスカッションでは、ComfyUIで動かせるかどうかが直接問われており、まだ有効な回答はありません。別のコミュニティディスカッションでは、GPUまたはCPUでのローカル推論向けに単一ファイルのRustビルドが提供されています。
それ以外はPythonの領域に留まります: vae.encode(x) は潜在を返し、vae.patchify(latent, compression=8) はそれをFlux.1形状またはFlux.2形状のトークンに変換し、vae.decode(vae.unpatchify(tokens)) で元に戻ります。どちらの側でもスケーリングやシフトは適用されません。アーキテクチャはテンソルの形状から読み取られるため、ai-toolkitからエクスポートされたファインチューンは weights_name="my_finetune.safetensors" で読み込めます。
コメント
GitHubでサインインしてディスカッションに参加しましょう。