RelayVSR X2: H3クリップで学習した2倍動画アップスケーラー
LightX2VチームがRelayVSRをネイティブ2倍動画超解像向けに再学習しました。H100で45 FPS、フリッカー抑制、2つのチェックポイントを備えます。
scripts/relayvsrから実行します。ComfyUIノードはまだありません。
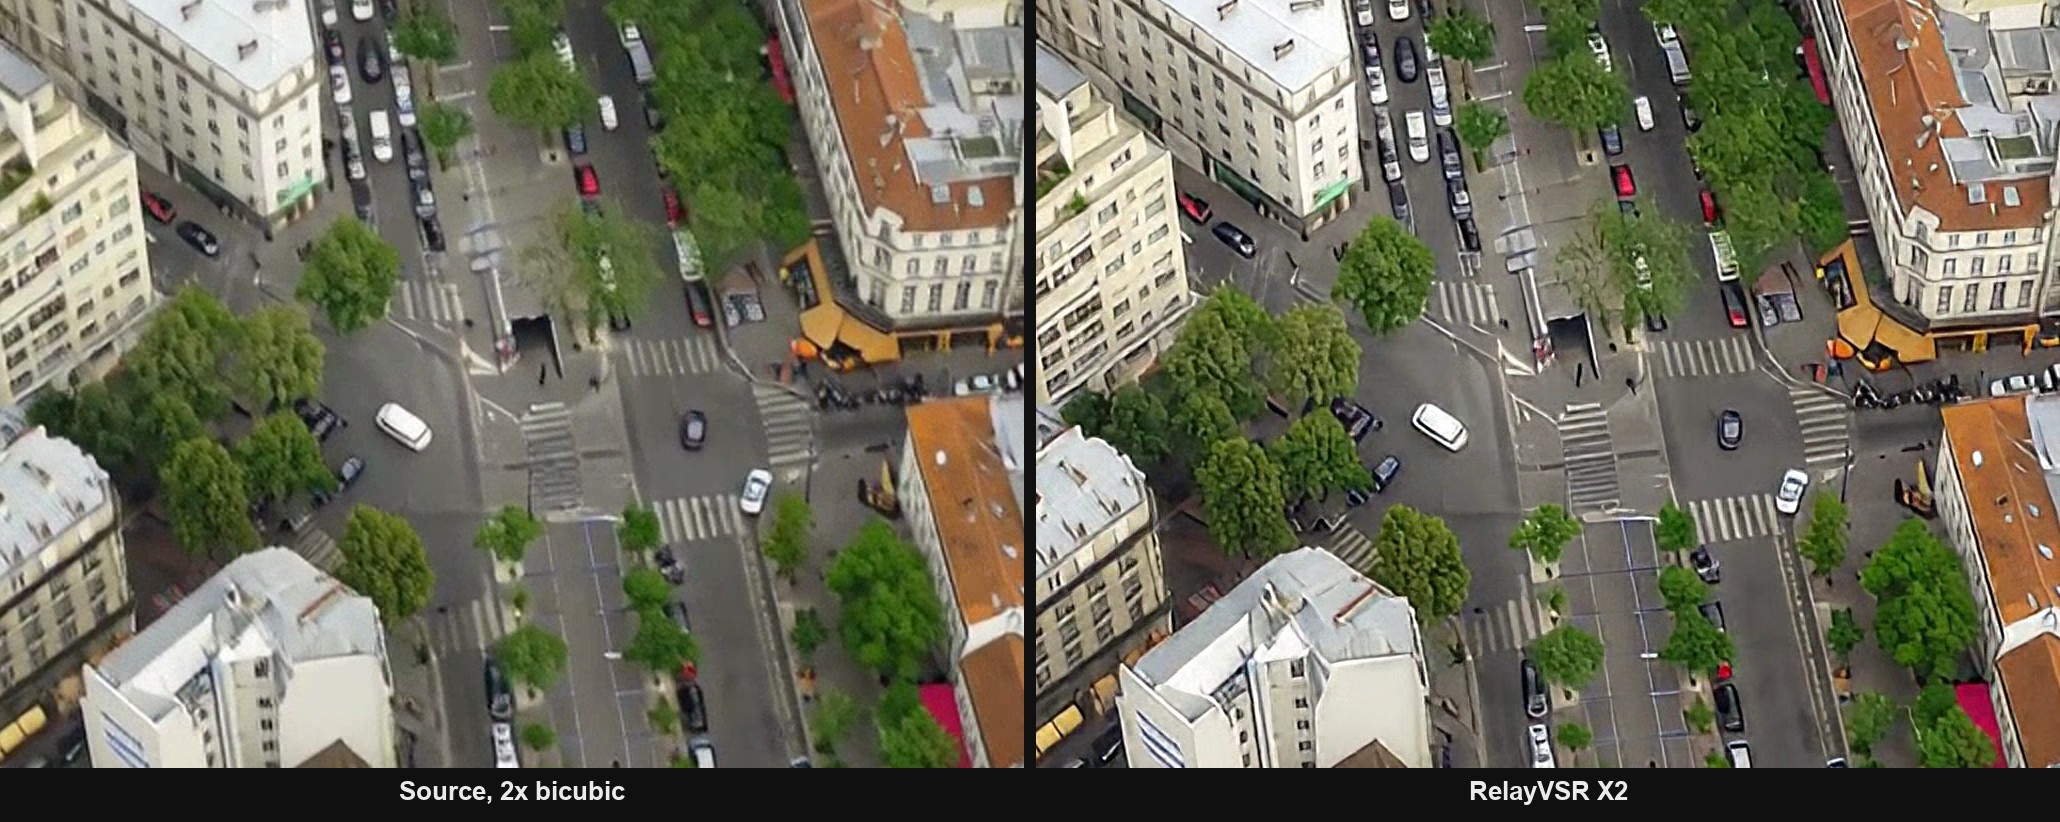
768x1344のH3クリップは1536x2688へきれいに2倍化でき、これは通常の仕上げ解像度です。RelayVSRは4倍しかできなかったため、同じクリップは3072x5376になり、ほとんどのショットで必要としない出力のために4倍のピクセル処理コストを払っていました。X2は4倍で計算して縮小するのではなく、2倍で計算します。
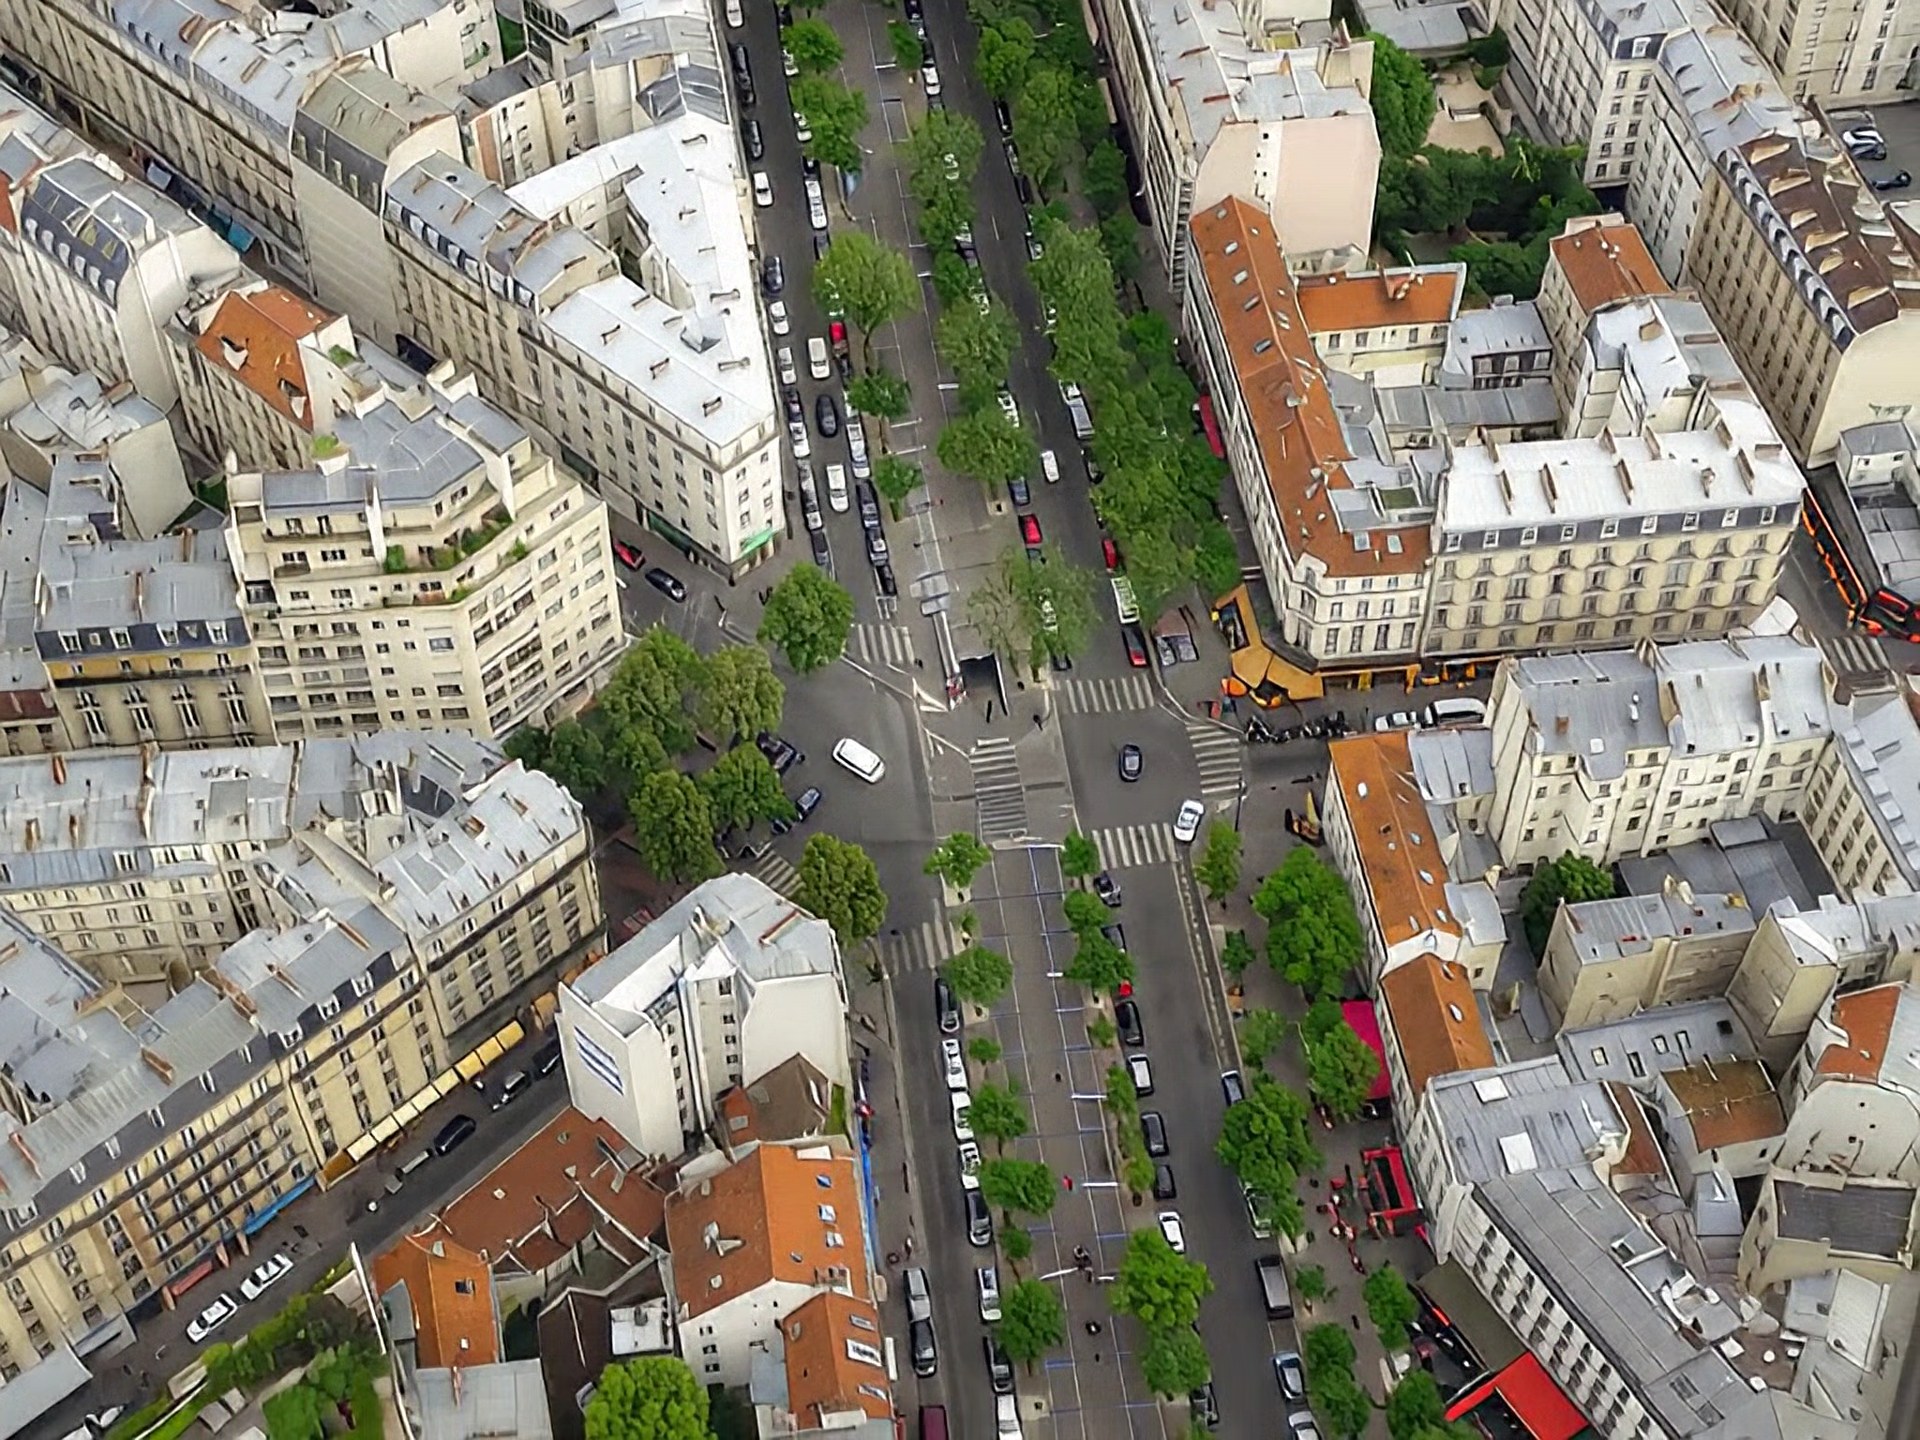
まずフリッカー、次にシャープネス
超解像モデルは、生成済み動画がすでに持つ軽度の時間的フリッカーを増幅しがちです。そのため、アップスケール後のクリップは単一フレームがよりシャープに見えても、動きの中ではソースより悪く見えることがあります。RelayVSRの設計はそこを狙っています。大規模な生成モデルが疎なキーフレームにのみ参照latentを書き、小さなVSRネットワークがその参照を全フレームへ引き継ぎます。LightX2Vの実装では、上限付きのルックアヘッドとフレームリングKVキャッシュを使います。
公開されたベンチマークの入力自体がH3の出力で、わずかなフリッカーが元からある24 fpsの1024x768ドローン屋上クリップです。そのため比較グリッドは、きれいなカメラ映像ではなく、このモデルが学習時に想定したケースを示しています。
2つのチェックポイント、1つのスケール
X2リリースは、同じディレクトリにダウンロードする必要がある2つのファイルとして提供されます:
wan_x2.safetensors(10.1 GB): 疎なキーフレーム参照を生成するWanベースのチェックポイント。flash_x2.safetensors(127 MB): 残りのフレームを超解像するコンパクトな条件付きデコーダー。
LightX2Vのランナーはスケールとアーキテクチャを検証し、2倍と4倍の重みが混在している場合は、不一致な組み合わせを読み込むのではなく拒否します。出力サイズはユーザー設定ではなく、入力サイズとsr_ratioに従います。X2モデルではsr_ratioは2である必要があります。旧4倍チェックポイントもsr_ratio=2を受け付けますが、内部では4倍で計算してから縮小します。これはまさにこのリリースが回避しようとしているコストです。
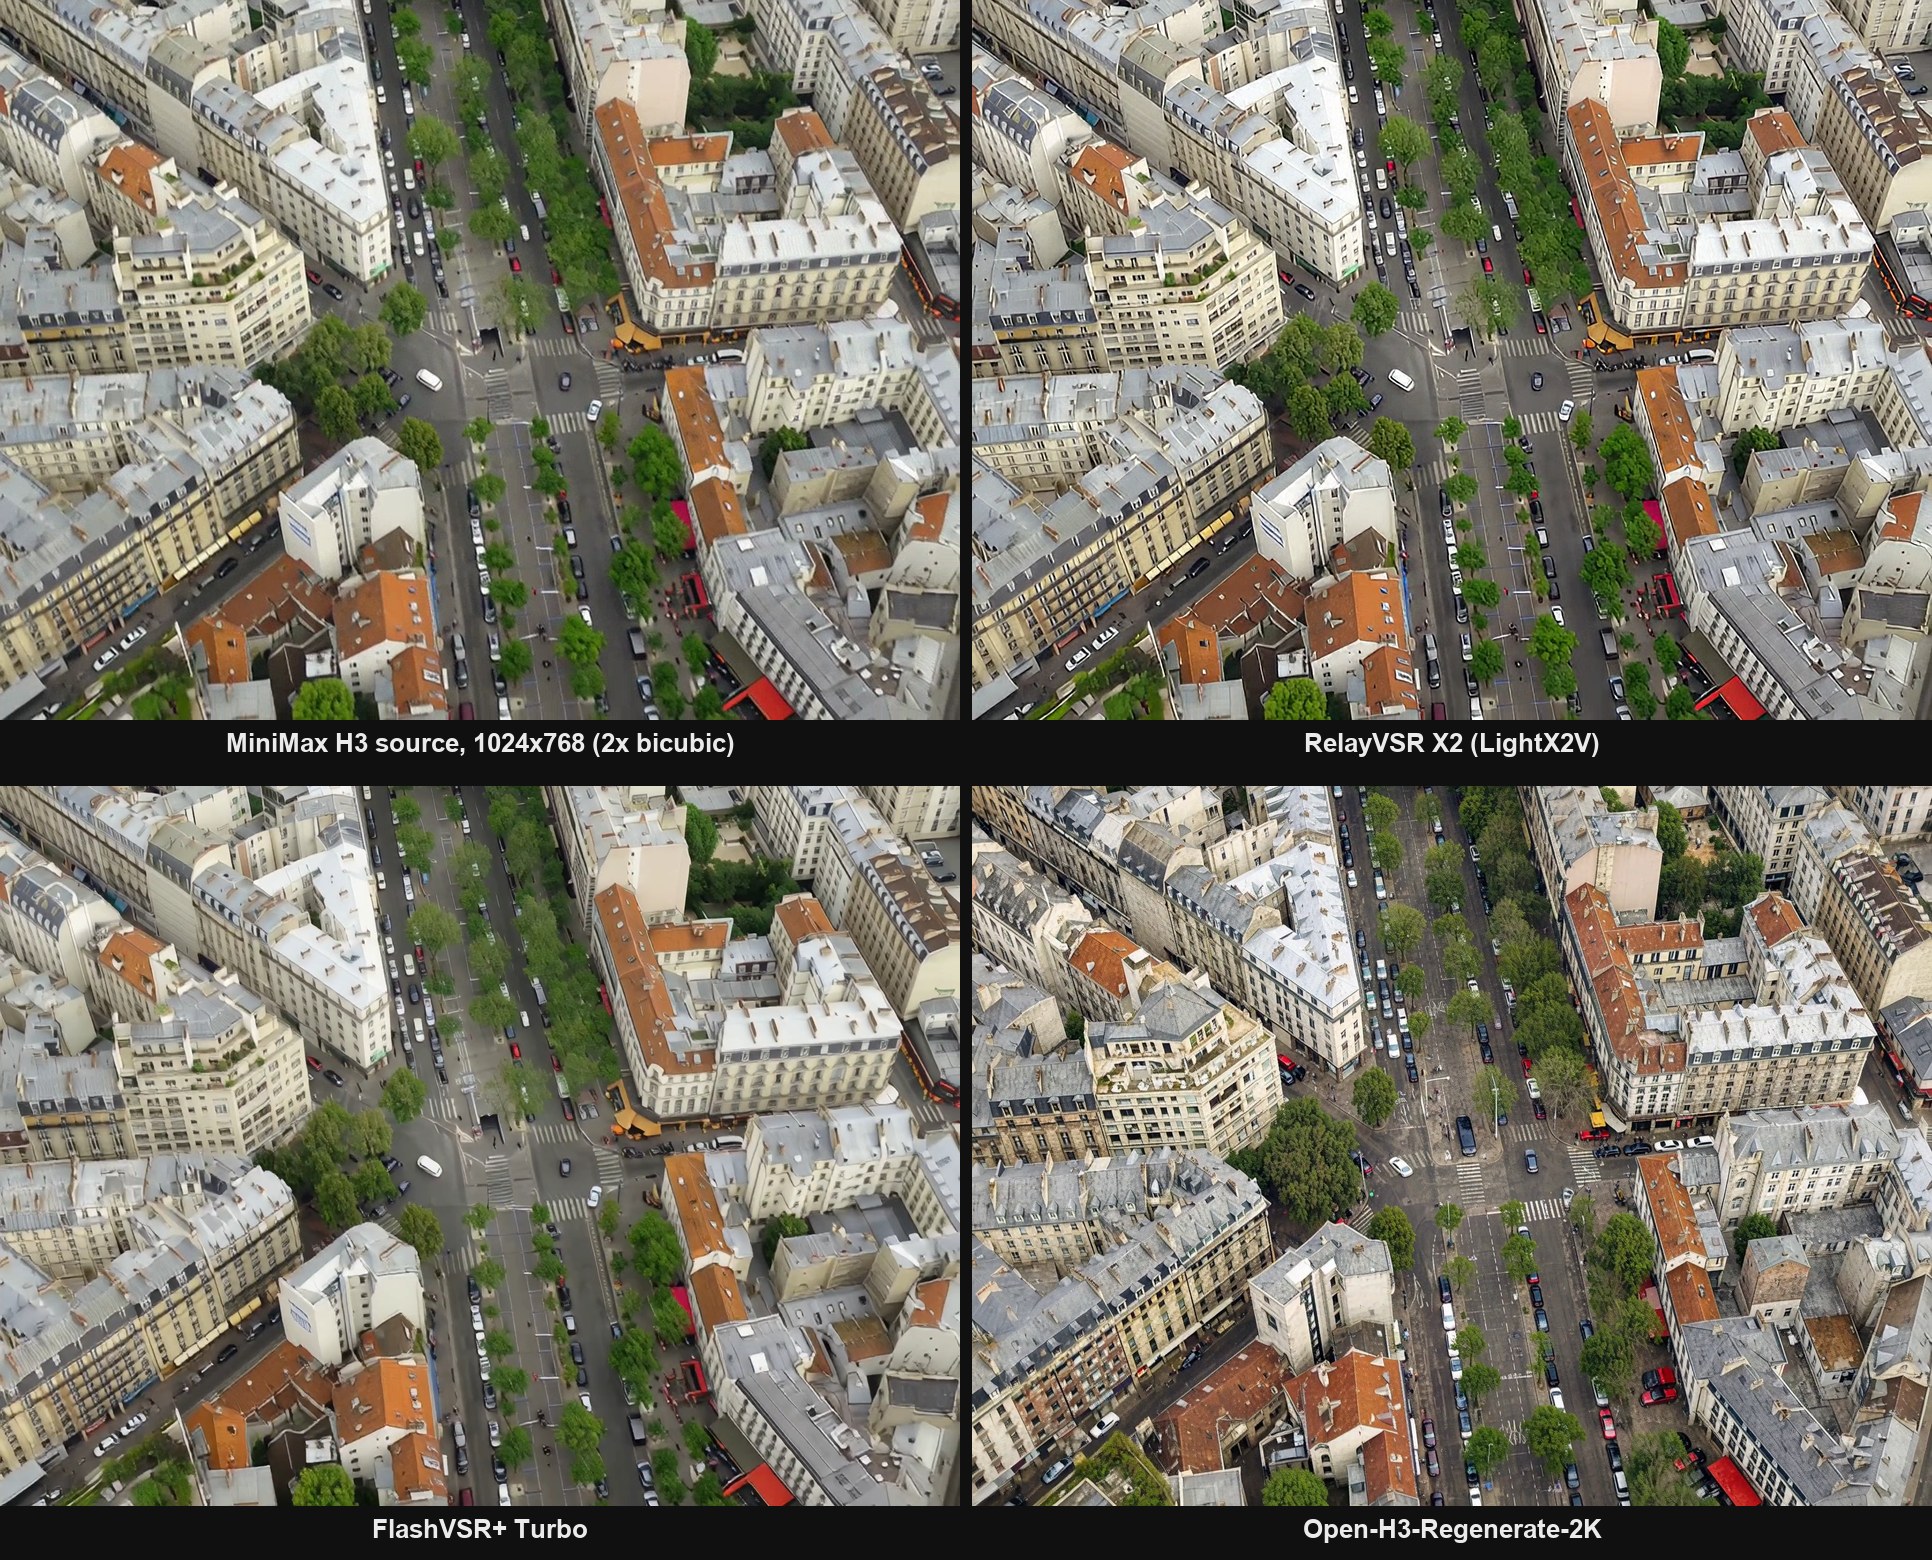
960x720の表示サイズでの同一フレーム: H3ソースをバイキュービックで2倍(左上)、RelayVSR X2(右上)、FlashVSR+ Turbo(左下)、Open-H3-Regenerate-2K(右下)。フレームは公開ベンチマークのクリップから取得。
1台のH100で測定
カードには、同解像度でのウォームアップ後、PyTorch 2.11.0とCUDA 13.0を搭載した単一のH100 80GB上で、1024x768・24 fpsの243フレームを順次処理した各モデル1回分の実測値が記載されています:
- RelayVSR X2(LightX2V): 5.348秒、45.44 FPS、2048x1536出力
- SwiftVR(LightX2V): 6.399秒、37.98 FPS
- SwiftVR: 7.252秒、33.51 FPS
- RelayVSR 4x(LightX2V): 19.304秒、12.59 FPS、4096x3072出力
- RelayVSR 4x: 26.332秒、9.23 FPS、4096x3072出力
- FlashVSR+ Turbo: 54.024秒、4.50 FPS
- SeedVR2-3B: 352.820秒、0.69 FPS
- Open-H3-Regenerate-2K: 784.954秒、0.31 FPS
これらは10秒クリップに対するH100での数値です。オリジナルの4倍モデルの論文では、A100で1080pを29.29 FPS、ピークメモリ13.82 GBと報告されており、FlashVSR-Tinyの7.80 FPS、24.447 GBと対比されています。つまりこのアーキテクチャは、ベンチマーク環境で勝つことよりも、単一GPU内に収まるように設計されています。
Banodocoでの初期ユーザーによる測定でも、コンシューマー向けハードウェアで同程度の差が出ています。JohnDopamineが実行時のタイムスタンプを読み取ったところ、Relayの仕上げステージは約85秒、FlashVSR+は331秒でした(メッセージ)。同じクリップを各自のGPUと環境で実行したものなので、絶対的な速度ではなく比率として読んでください。
実行方法
推論は別パッケージではなくLightX2Vにあります:
git clone https://github.com/ModelTC/LightX2V.git
cd LightX2V
hf download lightx2v/RelayVSR_X2 \
    wan_x2.safetensors flash_x2.safetensors \
--local-dir ./models/RelayVSR_X2scripts/relayvsr/run_relayvsr_x2_sr.shをクローン、重み、入力動画、GPUに向けて設定し、--model_cls relayvsr_x2、--config_json configs/relayvsr/relayvsr_x2.json、--sr_ratio 2を維持したまま、リポジトリのルートから実行します。デフォルト設定では両方のチェックポイントを常駐させ、コンパイルとウォームアップを有効にします。relayvsr_x2_block_offload.jsonはVRAMを節約するためにWanのブロックをオフロードし、relayvsr_x2_sp.jsonは1つのクリップを2台のGPUに分割します。
繰り返し作業向けに常駐サーバーモードもあります。python -m lightx2v.server --model_cls relayvsr_x2 --task srを起動し、クリップごとに入力パス、sr_ratio、出力パス、シードを/v1/tasks/video/へPOSTすれば、重みは一度だけ読み込まれます。
利用可能性
RelayVSR X2はLightX2Vのリリースです。LinuxとNVIDIA GPUが必要で、CLIまたはサーバーから実行します。ComfyUIノードやラッパーはまだ公開されておらず、リポジトリにdiffusersパイプラインもありません。LightX2Vの変更履歴には非同期エンコーディングとソース音声の保持が記載されているため、H3クリップは生成時のトラックをそのまま保ちます。グラフ内で使いたい場合は、現時点では自分でランナーをラップする必要があります。
コメント
GitHubでサインインしてディスカッションに参加しましょう。