Pika H3 Flex: MiniMax H3を6ステップのComfyUI LoRAに変換
PikaはMiniMax H3を追加学習してPika H3 Flexを発表しました。2つのComfyUI LoRA、3つの公式テンプレート、12個の参照ファイル制御を備えた6ステップモデルです。
Pika H3 Flex は、MiniMax H3 に対する Pika の追加学習版です。同じ 33B のオムニモデルを社内の音声+映像コーパスで再トレーニングし、50 ステップの教師モデルから 6 サンプリングステップ まで蒸留したうえで、報酬学習と選好最適化によって仕上げています。Pika は重みを Hugging Face で公開し、推論パッケージを GitHub でオープンソース化し、2026年10月29日に技術解説とローンチ記事を公開しました。
ComfyUI にとって重要なのは、Flex が新しいアーキテクチャではないという点です。ネイティブの MiniMax H3 モジュールレイアウトをとる 2つの LoRA アダプターとして提供されるため、すでに持っている H3 ベースの上に標準の LoraLoaderModelOnly ノードで読み込めます。テンプレートライブラリには公式テンプレートワークフローが3つ用意されています。
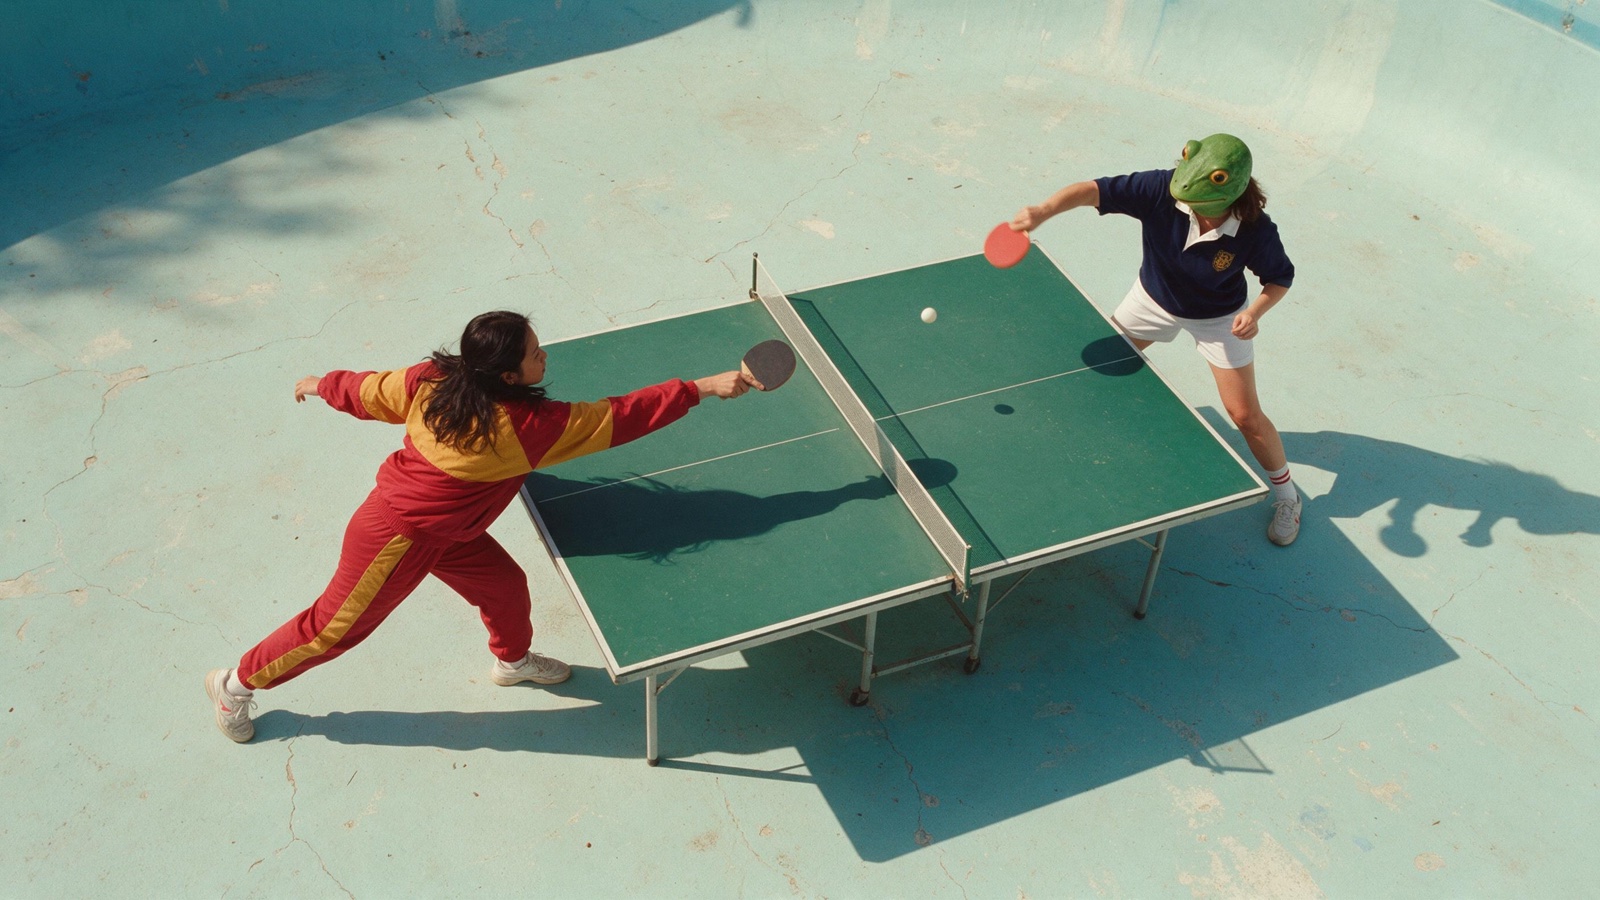 |  |
|---|---|
| 最初のフレーム参照 | 6ステップ出力の1フレーム |
卓球のデモ:静止画を1枚入力し、プロンプトで15秒のワンテイクの中に5つの台本付きカメラワーク(オーバーヘッド、クレーンダウン、ウィップパン、180度のオービット、低いドリー)を指示します。出典: Pika H3 Flex モデルカード
生成されたサウンドトラック付きのカメララリー全編クリップ。モデルリポジトリ内の Pika のショーケースセットより。
2つのアダプター、1つの6ステップスケジュール
Flex は H3 の2つの条件付け経路を別々のアダプターに分割しており、ベースモデル自体の分割に対応しています。
| アダプター | 条件付け | タスク |
|---|---|---|
| FL2VA | テキスト、および任意で最初および/または最後のフレーム | テキストから動画(T2V)、最初のフレーム(I2V)、最後のフレーム、最初と最後のフレーム |
| Ref2VA | テキスト、および順序付けられた画像、動画、音声の参照 | 参照から動画、モーション転送、キャラクタースワップ、参照ガイド付き編集 |
Ref2VA は最大 9枚の画像、3本の動画、3つの単体音声クリップ、合計 12個の参照ファイル を受け付け、少なくとも1つの画像または動画が必須です。各参照動画と単体音声クリップは2〜15秒で、それぞれのグループの合計は15秒までです。動画に含まれる音声トラックはその動画に付随し、追加の音声ファイルとしてはカウントされません。
出力は 480p または 768p ネイティブ、11 のアスペクト比、24 fps、32 kHz ステレオ音声がファイルにミックスされ、要求できる長さは 5〜15 秒です。H3 のフレームグリッドによって切り上げられ、5秒の要求は124フレーム、15秒の要求は362フレームを返します。
1つのプロンプトで、積み重なったバルコニーにいる別々にアニメーションする3人を、オービット、プッシュイン、垂直ブーム、リバースオービットへとカットなしで動かします。
ComfyUI 版のリリース
ComfyUI テンプレートライブラリの Video に3つのテンプレートがあります: video_pika_h3_flex_t2v.json、video_pika_h3_flex_fl2va.json、video_pika_h3_flex_ref2va.json。いずれも ComfyUI チュートリアルページ で説明されています。それぞれ pruned int8 の H3 diffusion model と対応するアダプターを組み合わせ、Pika が公開したスケジュールで実行します。ManualSigmas を使う LCM サンプラーと BasicGuider 経由の CFG 1.0、アダプター強度は 1.0 固定です。
テンプレートを読み込まず自分でグラフを組む場合は、2つの点が重要です。
- シグマグリッドはチェックポイントの契約の一部です。 Pika のマニフェストにはノット
1000/750/500/250/100/40/0、video shift 12、audio shift 3、そして新しい中間ノイズが記載されています。汎用サンプラーで6ステップを選んでもこの契約は再現されません。 - 2つ目の高速化 LoRA を積まないでください。 アダプターはすでに6ステップに蒸留されており、チュートリアルでは turbo や Lightning LoRA を追加すると出力が壊れると述べています。
コネクターは新しいチェックポイントではなく、単純な BF16 変換です。通常のモジュールは rank 128 のまま、融合された Q/K/V プロジェクションは rank 384 に統合され、変換時に SwiGLU の半分を並べ替えてネイティブの H3 レイアウトに合わせています。Pika のアダプター readme は、ファイルの整合性とテンソル変換は検証済みだが、アップロードの一環として ComfyUI でのエンドツーエンドのレンダリングは検証されていないと明言しています。参照用の推論パッケージとは多少のずれが予想されます。
#pika-h3-flex-early からの初期の実機レポートもそれに合致します。テスターの NebSH は 6ステップ 960x544 のパスを潜在アップスケールと 4ステップ 1920x1088 のパスに連結し、2560x1440 の結果を 3分17秒で得ました。一方 WAS は4ステップで遠くの鳥のような高周波ディテールにポップノイズを指摘し、6ステップを維持するよう提案しました。
Pika が6ステップに到達した方法
技術解説 では、公開済みのガイダンス蒸留済み H3 に対して行った3段階のポストトレーニングが説明されています。
- 教師ありファインチューニング:生成と編集タスクにまたがる、美的にキュレーションされた社内の音声+映像データセットで、教師の50ステップのまま実施。
- Projected Distribution Matching Distillation(PDMD、Wang ら 2026)でサンプリングを50ステップから6ステップに削減。Pika によれば、標準の DMD は彼らの実行では不安定で、PDMD はより安定して学習し、出力品質も優れていたとのことです。
- 蒸留後の報酬学習:ReFL(美的感と明瞭さ)と DPO(指示追従、リアリズム、視覚品質)を2つの別々の LoRA として学習し、1つのアダプターにマージすることで、組み合わせた挙動が追加のサンプリングステップを要さないようにしています。
残りは別個のサービングスタックが担います。キャッシュされたタイムステップ依存の AdaLN プロジェクション、融合カーネル、FlashAttention-4、圧縮通信を伴うブロックスパースアテンション。8基の B300 GPU で、音声付き5秒 768p の場合、完全な推論が 3.409 秒から 2.129 秒へ短縮され、1.60倍の高速化となりました。チェックポイントと6ステップスケジュールは固定です。
数値が示すもの、示さないもの
Pika は Flex を公式の MiniMax H3、Fal H3 Max、HeyGen Video(quality)と 768p・同一プロンプトセットで評価し、映像と音声の品質に関する5つの指標すべてで最高スコアを報告しています。
| 指標 | Pika H3 Flex | MiniMax H3 | Fal H3 Max |
|---|---|---|---|
| 映像テクニカル | 12.3 | 11.7 | 10.6 |
| 映像美的 | 5.41 | 5.28 | 5.00 |
| 音声美的 | 7.02 | 6.85 | 6.89 |
| 音声と映像の整列 | 0.212 | 0.208 | 0.216 |
音声と映像、テキストと映像の整列は比較対象とほぼ同等で、数値は Pika 自身の評価です。彼らのブラインドペアワイズ調査では、Flex はテキストおよび画像条件付け生成において人体の解剖学的構造、複雑な構図、音声同期で優位に立ち、参照条件付け生成では視覚スタイル、フレーミング、カメラモーションで優位に立ちます。Pika はまた、物理、マルチシーンのナラティブ、ライティングとマテリアル、アクション中心の参照タスクでは他のシステムが依然として好まれると述べています。
これまでのコミュニティの A/B は小規模ながら、無料の昼食ではなく実用的な6ステップモデルであることと一致しています。Kijai は同じ T2V のサンプルプロンプトを DMAD と Flex で6ステップずつ実行し、DMAD はそのケースで失敗したと報告しました。djbfilmz は6ステップの Flex とアダプターなしの20ステップ実行を比較し、Flex で反復し、最終版はフル20ステップでレンダリングすると述べました。チュートリアル自体の主張は、1枚のカードで5秒 1344x768 のクリップを約1分で生成するというものです。
 |  |
|---|---|
| マルチショットの製品フィルム | キャラクターと環境の参照にモーションクリップを加えたもの |
さらに2つのショーケース:1つの製品参照から作る9ショットのコマーシャルと、振り付けを動画から、アイデンティティとスタイルを2枚の静止画から取るモーション転送。
入手方法
リポジトリには、Pika 推論パッケージ用の2つの FP32 アダプター(fl2va/adapter.safetensors、ref2va/adapter.safetensors、各 2.77 GB)、comfy/loras/ 配下の BF16 ComfyUI 変換版(各 1.96 GB)、そして Pika によれば合計約 210 GB になる Diffusers 形式の H3 ベースコンポーネントが含まれています。各 ComfyUI テンプレートは必要な transformer パーティションのみを読み込みます。
Pika のホスト型拡張機能はダウンロードには含まれません。768p ドラフトからの 1080p、2K、4K アップサンプリング、5つの分離音声ステム(ダイアログ、スコア、SFX、フォーリー、アンビエンス)、プロンプト拡張、高速化サービングスタックはすべて API 機能です。ローカルのオープンウェイト推論は 480p と 768p に対応します。
コメント
GitHubでサインインしてディスカッションに参加しましょう。