ComfyUI コアに H3 潜在アップスケーリングと Sol-H3-VAE サポートが追加
マージされた2つの ComfyUI コア PR が MiniMax H3 潜在アップスケーラーと蒸留版 Sol-H3-VAE デコーダーを読み込み、2K H3 のデコードを 14.5 秒から 0.89 秒に短縮します。
2026年10月28日、ComfyUI は MiniMax H3 の高解像度パスをカスタムノードからコアへ移行する2つのコアプルリクエストをマージしました。PR 17412 は専用の H3 ノードを備えた潜在アップスケーラーモデルのサポートを追加し、PR 17411 は VAE ローダーが NVIDIA の Efficient-Large-Model チームによる蒸留版高速デコーダー Sol-H3-VAE を開けるようにします。どちらも作者は Kijai で、いずれも v0.43.1 タグの後にマージされたため、master とナイトリービルドに含まれ、現在の 0.43.x リリースには含まれません。
この組み合わせは 2K H3 ジョブの高コストな2つの部分、すなわち VAE のラウンドトリップなしで潜在を拡大することと、完成したクリップをデコードすることを対象としています。
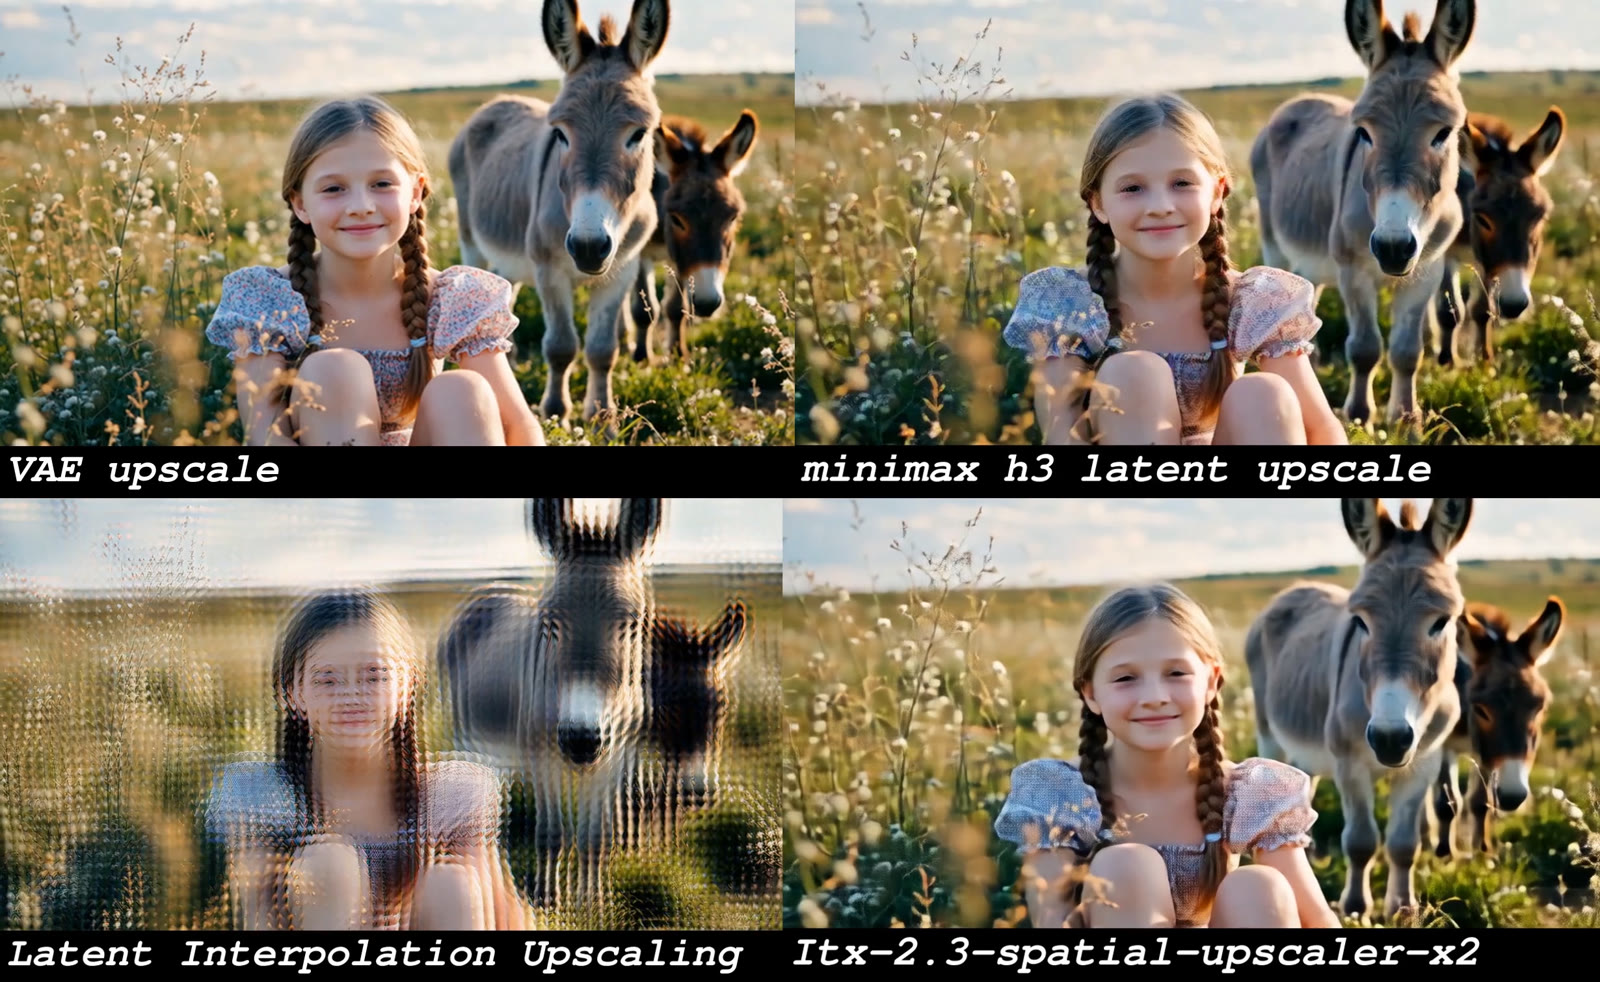
低解像度パスを H3 潜在アップスケーラーで潜在空間内にアップスケールしたもの。モデルカード より。
同じリポジトリの比較動画。
コアに取り込まれた内容
| PR | マージ日時 | 変更内容 |
|---|---|---|
| 17412 | 2026-10-28 20:05 UTC | 新しい comfy/ldm/minimax/latent_upscaler.py モジュール、Load Latent Upscale Model の H3 分岐、新ノード MiniMax H3 Latent Upscale With Model |
| 17411 | 2026-10-28 23:46 UTC | VAE ローダーでの Sol-H3-VAE 検出とキーの再マッピング、非因果デコーダーパス、int8 量子化デコーダーのサポート、デコーダーのメモリ推定 |
どちらの PR もチェックポイントを同梱していません。既存のコミュニティ製の重みを標準のローダーで読み込めるようにするもので、以前はノードパックが必要だった H3 アップスケーラーがコアノードだけで動作するようになります。
潜在空間内でのアップスケーリング
H3 の潜在は24チャンネルと別個の音声ストリームを持ちます。LBH-123-AI の潜在アップスケーラー は 3D 畳み込みバックボーンで動画の潜在を直接処理します。345,280,216 パラメータ、入出力24チャンネル、ベース512チャンネル、入力12ブロック・出力12ブロックで、2ブロックごとにカーネルサイズ5の時間方向畳み込みを持ちます。
狙いは H3 の VAE を介した decode -> pixel upscale -> encode を省略することです。モデルカードではこの VAE は約 5B パラメータと説明されています。作者はまた、H3 潜在を単純なバイリニアやバイキュービックで補間するとゴースティングが発生し、学習済みアップスケーラーはそれを避けるようトレーニングされていると報告しています。トレーニングには約 80,000 組のペアサンプルを使用し、約 70,000 の動画ペアと 8,000 の 2K 画像ペアに分かれ、2倍が中心のスケールとなっています。
コアは state dict からアーキテクチャを読み取るため、ブロック数、チャンネル幅、時間方向カーネルは別途の設定ファイルではなく重み自体から取得されます。ノードの出力は H3 のネストされた潜在を保持するため、音声側はそのまま通過し、生成されたサウンドトラックはアップスケール後も維持されます。入力潜在のノイズマスクは破棄されます。
併用するノードパックとの違いとして、次の2点を知っておく価値があります。
- コアノードは倍率ではなくターゲットサイズを取ります。
MiniMax H3 Latent Upscale With Modelは 2560x1440 がデフォルトで、ステップは 32、通常の解像度上限も適用されます。コミュニティノードは代わりに 1.0x から 4.0x の連続的な倍率を公開しています。 - アップスケールだけではディテールは追加されません。 潜在のサイズを変更するだけなので、新しい解像度での2回目のサンプリングパスがディテールを戻します。そこでステップ数を少なくすると結果はぼやけたものになります。
要求されたサイズが潜在のサイズと一致する場合、コアノードはモデルを実行せずに入力をそのまま返します。
ドロップインで使えるデコーダーとしての Sol-H3-VAE
Sol-H3-VAE は H3 向けの高速動画デコーダーで、標準の 36 層 VAE デコーダーを、そこから蒸留した 24 層・1.62B パラメータの非因果デコーダーに置き換えます。空間タイルではなくウィンドウ付きアテンションでフレーム全体をデコードし、各ネイティブの5潜在ブロックを双方向にデコードします。モデルカード によると、同じ正規化済み潜在を受け取り、H3 VAE デコーダーと同じフレームを返し、音声デコーダーには手を加えません。
| 5秒のクリップ1本 | H3 VAE | Sol-H3-VAE |
|---|---|---|
| 768p、RTX 5090 | 12.5 s | 5.0 s |
| 720p、GB200 | 6.16 s | 0.34 s |
| 2K、GB200 | 14.5 s | 0.89 s |
モデルカードは、720p から 2K にわたるホールドアウト潜在で H3 デコーダーに対して 45.4 dB PSNR、生成された 768p クリップで 38.2 dB を報告しています。GB200 の数値はキャプチャされた CUDA グラフによるもので、RTX 5090 の数値は eager モードです。
そのチェックポイントをコアで開くには、新しいファイル名パターンだけでは足りませんでした。
- 公開ファイルはデコーダーを
decoder.プレフィックスなしで格納しているため、ローダーはその場でキーを再マッピングし、H3 の潜在の平均と標準偏差が存在しない場合には補完します。 - 非因果デコーダーはフレームの計算を変えます。出力は 潜在あたり4フレームで、5潜在ブロックごとに最初の潜在が1フレームを保持します。
t個の潜在に対して4t - 3 * ceil(t/5)フレームとなり、エンコードには対応する逆の式を使います。 - クリップ全体をタイルではなく一度にデコードするため、この PR は別個のメモリ推定を追加し、ローダーがデコード開始前に VRAM を計画できるようにします。
- 量子化された Sol VAE ビルドも読み込めます。ローダーは conv-rotation 重みを持つ int8 を検出し、混合精度の演算に切り替えます。
公開ファイルは fp32 で約 6.5 GB の単一の sol_h3_vae.safetensors です。
グラフへの組み込み
- アップスケーラーのチェックポイントを
ComfyUI/models/latent_upscale_models/に置きます。H3 のリリースには bf16 と fp16 が各約 691 MB、加えて 1.38 GB の fp32.pthが含まれます。 sol_h3_vae.safetensorsをComfyUI/models/vae/に置き、通常の VAE ローダーで読み込みます。Load Latent Upscale ModelをMiniMax H3 Latent Upscale With Modelにチェーンし、低解像度のサンプリングパスと 2560x1440 以上の2回目のサンプラーパスの間に配置します。- 精製された潜在を Sol VAE でデコードします。
アップスケーラーの重みは Apache-2.0 です。ComfyUI のテンプレートライブラリには依然としてホスト版 H3 API テンプレートしかないため、この組み合わせ向けの公式な 2K ローカルテンプレートはまだありません。また上記の時間は ComfyUI のベンチマークではなくモデルカード自身の計測値です。
入手方法
- アップスケーラー: LBH-123-AI/Minimax_h3_latent_Upscaler(Apache-2.0、bf16 / fp16 / fp32 チェックポイント、リポジトリに2つのサンプルワークフローもあり)
- 高速デコーダー: Efficient-Large-Model/Sol-H3-VAE。参照用の Python パッケージは
code/以下にあり、より広いランタイムの ComfyUI ステージは NVlabs/Sana の Sol-Engine ブランチ にあります - コアの変更: PR 17412、PR 17411
コメント
GitHubでサインインしてディスカッションに参加しましょう。